一、一个 Agent 请求,九成时间在等
先算一笔账。一个"帮我规划北京到上海行程"的 Agent,内部大概会这样跑:
| 阶段 | 干了什么 | 在等谁 | 典型耗时 |
|---|---|---|---|
| 第 1 次模型调用 | 理解意图,决定先查天气 | 模型服务 | 1.0 ~ 2.5 s |
| 工具:查天气 | HTTP 请求天气 API | 外部服务 | 0.2 ~ 0.8 s |
| 第 2 次模型调用 | 拿到天气,决定查交通 | 模型服务 | 1.0 ~ 2.5 s |
| 工具:查交通 | 查询班次接口 | 外部服务 | 0.3 ~ 1.0 s |
| 第 3 次模型调用 | 拿到交通,组织答案 | 模型服务 | 1.5 ~ 3.0 s |
加起来 4 到 10 秒,其中真正消耗 CPU 的时间不到 5%。Agent 不是一个计算程序,它是一个 I/O 编排器:把模型调用、HTTP 请求、数据库查询按顺序串起来,中间绝大部分时间都在等对面回话。
这就是同步调用的根本问题。agent.invoke(...) 在等模型返回的那 2 秒里,当前线程被彻底占住:既不能处理下一个用户请求,也不能去查另一个城市的天气。线程在,但什么都没干。
换个角度看更直观。假设一个服务每秒来 20 个 Agent 请求,每个请求平均 6 秒,同步模型下你需要 120 个线程同时在线才能撑住。线程本身不贵,但 120 个线程的栈、上下文切换、连接池占用,都是真实成本。而它们 95% 的时间处于阻塞状态。
异步要解决的就是这件事:把"等"这件事从线程身上摘下来,交给事件循环统一调度。
二、ainvoke 到底做了什么
LangChain 的 Agent 从第一版起就同时提供同步与异步两套入口,接口形状几乎一样:
import asyncio
from langchain.agents import create_agent
from langchain.tools import tool

@tool
def get_weather(city: str) -> str:
    """查询指定城市的天气。"""
    return f"{city}:多云,18°C"

agent = create_agent(
    model=deepseek_llm,
    tools=[get_weather],
    system_prompt="你是旅行规划助手。",
)

# 同步:线程被占住直到返回
result = agent.invoke({
   "messages": [{
   "role": "user", "content": "上海天气"}]})

# 异步:挂起当前协程,把控制权交还事件循环
async def main():
    result = await agent.ainvoke(
        {
   "messages": [{
   "role": "user", "content": "上海天气"}]}
    )
    print(result["messages"][-1].content)

asyncio.run(main())
await 这个词是关键。执行到 await agent.ainvoke(...) 时,Python 不会新开一个线程去跑,而是把当前协程挂起,把控制权交还给事件循环(event loop)。事件循环手里有一张"就绪任务表",它会立刻切到下一个能跑的任务上——可能是另一个用户的 Agent 请求,可能是同一进程里的一批数据清洗任务。
等模型服务的响应回来了,操作系统通知事件循环,事件循环再把刚才挂起的协程恢复,从 await 那一行继续往下走。
整个过程只有一个线程,但同一时刻有很多个"进行到一半"的任务。并发的本质不是同时执行,而是同时未完成。
这带来一个必须记住的结论:异步不会让单个请求变快。 一个请求该等 6 秒还是 6 秒,甚至因为协程调度多出几毫秒。异步换来的是吞吐:同样的进程,能同时扛住几十上百个在等待中的请求。
如果你的场景是"用户点一下,等一个答案",异步几乎没有体感收益;如果是"一批工单要跑 Agent"、"网关后面挂着上千个会话",异步是数量级的差别。下面这张图把两种时间线摆在一起:
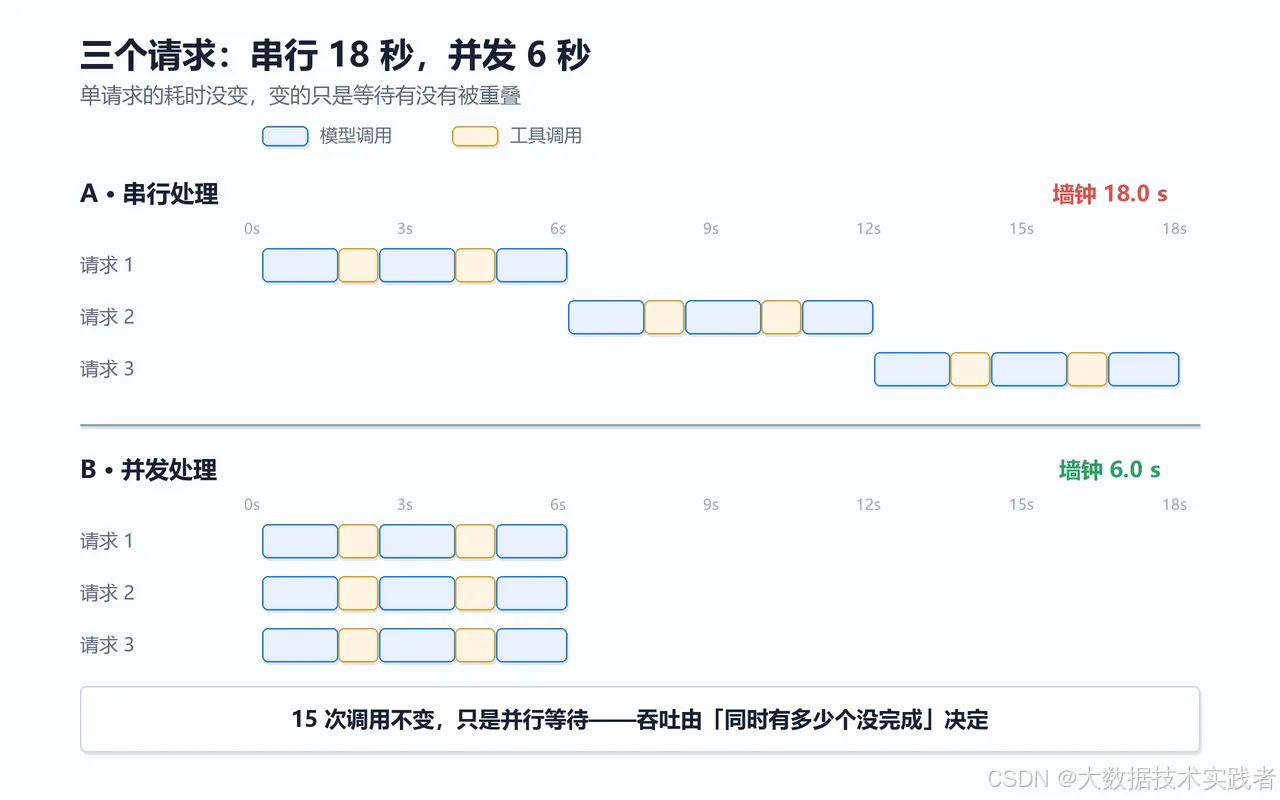
三个请求串行要 18 秒,并发只需要 6 秒——因为每个请求的内部等待被重叠了。注意单条泳道的长度没变,变的只是它们是否叠在一起。
三、三层并发,收益完全不同
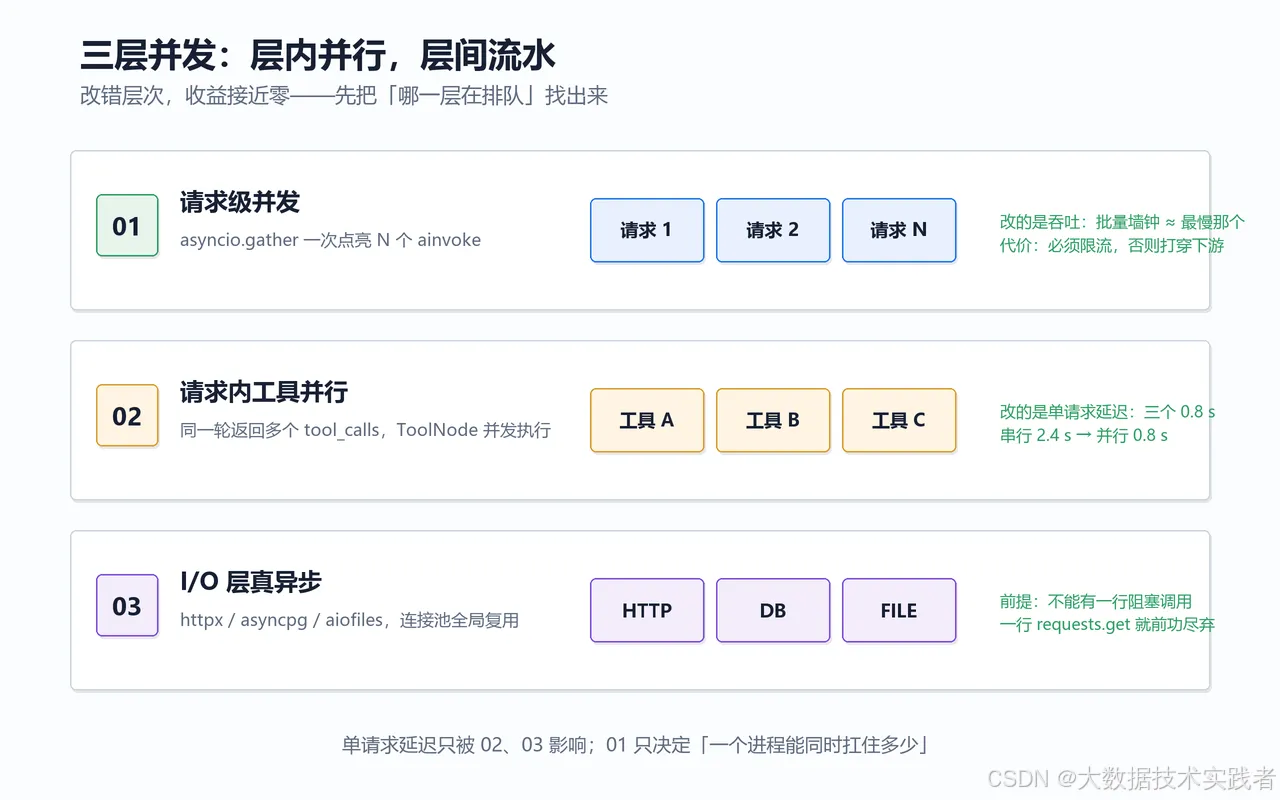
很多人把"异步"当成一个开关,invoke 改成 ainvoke 就以为完事了。实际上并发有三个层次,收益和改造成本都不一样。
第一层:单请求异步。 把 invoke 换成 ainvoke,stream 换成 astream。收益是释放线程,让你能在同一个事件循环里塞进更多请求。这一层不改代码结构,只改调用方式。
第二层:请求内工具并行。 模型在一轮里可能返回多个 tool_calls,比如同时要查北京天气、上海天气、两地交通。LangGraph 的 ToolNode 会把同一轮的多个工具调用并发执行,前提是这些工具是 async def 定义的。这一层收益直接体现在单个请求的延迟上:三个 0.8 秒的工具,串行 2.4 秒,并行 0.8 秒。
第三层:多请求并发。 一批任务同时发起,用 asyncio.gather 把它们叠在一起:
import asyncio

async def run_one(agent, city: str, idx: int) -> str:
    # 并发下每个请求必须有自己的 thread_id,否则 checkpoint 会串台
    config = {
   "configurable": {
   "thread_id": f"trip-{idx}"}}
    resp = await agent.ainvoke(
        {
   "messages": [{
   "role": "user", "content": f"规划{city}一日游"}]},
        config=config,
    )
    return resp["messages"][-1].content

async def main():
    cities = ["北京", "上海", "广州", "深圳", "成都"]
    results = await asyncio.gather(*(run_one(agent, c, i) for i, c in enumerate(cities)))
    for c, r in zip(cities, results):
        print(c, r[:60])
这三层叠起来,一个批次的实际耗时从"求和"变成"求最大值"。但要注意:第三层不是免费的,gather 会把所有任务同时点亮,1000 个任务就是 1000 个并发的模型请求——这是下一节要解决的坑。
| 改造到哪一层 | 单请求延迟 | 单进程吞吐 | 主要代价 |
|---|---|---|---|
全同步 invoke |
6.0 s | 受线程数限制 | 线程贵,扩容靠加机器 |
仅请求异步 ainvoke |
6.0 s | 提升 5 ~ 20 倍 | 一处阻塞调用就前功尽弃 |
| 工具也异步并行 | 3.5 s | 同上 | 工具需改造为 async def |
批量 gather + 闸门 |
3.5 s | 由下游配额决定 | 需处理 429、超时、状态隔离 |
这张表想说明的是:前两层改的是"同时能接多少",第三层改的是"一次能推多少"。单请求延迟只被第二层影响,剩下两层的收益都在吞吐上。评估收益时把这两个指标分开看,才不会被"改完还是 6 秒"的错觉劝退。
四、异步工具怎么写才真的异步
这是最容易翻车的地方。把 @tool 挂在 async def 上只完成了一半,函数体里只要有一行阻塞调用,整个事件循环就被卡住了。
# 错误示范:async 外壳 + 同步 I/O
@tool
async def query_order(order_id: str) -> str:
    resp = requests.get(f"https://api.internal/orders/{order_id}")  # 阻塞!
    return resp.text
requests.get 是同步的,它阻塞的不是"这个协程",而是整个线程——也就是整个事件循环。在这 300 毫秒里,其他 50 个等待中的请求一个都动不了。异步退化成了串行,而且比纯同步更糟:你付出了协程的复杂度,却没拿到任何并发收益。
对照表:
| 阻塞写法(毁掉事件循环) | 异步替代 |
|---|---|
requests.get(...) |
httpx.AsyncClient / aiohttp |
time.sleep(1) |
await asyncio.sleep(1) |
pymysql / psycopg2 同步驱动 |
asyncpg / aiomysql |
open().read() 大文件 |
asyncio.to_thread(...) 或 aiofiles |
| 同步 SDK(如部分云厂商 SDK) | await asyncio.to_thread(sdk.call, ...) |
最后一行是实用的兜底:如果某个 SDK 只有同步版本,别硬改写,用 asyncio.to_thread 把它丢到线程池,让事件循环继续转。
一个真正异步的工具长这样:
import httpx
from langchain.tools import tool

# 全局复用一个 client:连接池、DNS 缓存、keep-alive 都在里面
_client = httpx.AsyncClient(timeout=httpx.Timeout(5.0, connect=2.0))

@tool
async def get_weather(city: str) -> str:
    """查询指定城市的实时天气。"""
    try:
        async with asyncio.timeout(3):          # 工具级硬超时
            resp = await _client.get("/weather", params={
   "city": city})
            resp.raise_for_status()
            return resp.json()["summary"]
    except (asyncio.TimeoutError, httpx.HTTPError) as e:
        # 工具不该把异常原样抛给框架,返回可读的失败原因
        return f"天气服务暂时不可用:{type(e).__name__}"
两个细节值得强调。一是 client 要复用。 每次调用 httpx.AsyncClient() 都会新建连接池,高并发下等于每秒几十次 TCP 握手,延迟和端口占用都会爆。二是超时要给。 模型侧的超时管不到工具内部,一个卡死的下游接口能把整个请求拖到天荒地老。外层再配一层 asyncio.timeout 是必要的双保险。
五、并发控制:别让 gather 把下游打穿
asyncio.gather(*[run_one(i) for i in range(1000)]) 会在几毫秒内发起 1000 个请求。结果通常是三种:模型服务返回 429、连接池排队到超时、或者进程内存被未完成的响应撑爆。
正确的做法是加一道闸门:
import asyncio, random

SEM = asyncio.Semaphore(8)   # 全局并发上限,按下游配额定

async def run_guarded(agent, task: dict, idx: int):
    async with SEM:                       # 拿到令牌才允许发请求
        for attempt in range(3):
            try:
                async with asyncio.timeout(30):
                    resp = await agent.ainvoke(
                        {
   "messages": [{
   "role": "user", "content": task["q"]}]},
                        config={
   "configurable": {
   "thread_id": f"batch-{idx}"}},
                    )
                return {
   "id": task["id"], "ok": True, "data": resp["messages"][-1].content}
            except (asyncio.TimeoutError, RateLimitError) as e:
                if attempt == 2:
                    return {
   "id": task["id"], "ok": False, "err": type(e).__name__}
                await asyncio.sleep(2 ** attempt + random.random())   # 指数退避 + 抖动
            except Exception as e:
                return {
   "id": task["id"], "ok": False, "err": type(e).__name__}

async def main():
    results = await asyncio.gather(*(run_guarded(agent, t, i) for i, t in enumerate(tasks)))
    ok = [r for r in results if r["ok"]]
    print(f"成功 {len(ok)} / {len(results)}")
这段代码里有四个决定成败的细节:
Semaphore必须建在函数外。 建在函数内部,每次调用都是一个新的信号量,限流等于没做。asyncio.timeout要包住整个ainvoke,而不只是工具。 Agent 是循环的,单次工具超时控不住"反复重试十轮"这种病态情况。- 捕获要分层。 可重试的(429、5xx、超时)走退避重试;不可重试的(400 参数错、鉴权失败)立即失败,重试只会放大账单。
gather默认一个异常就整体抛出。 用return_exceptions=True,或者像上面这样在协程内部消化掉,保证单条失败不拖垮整批。
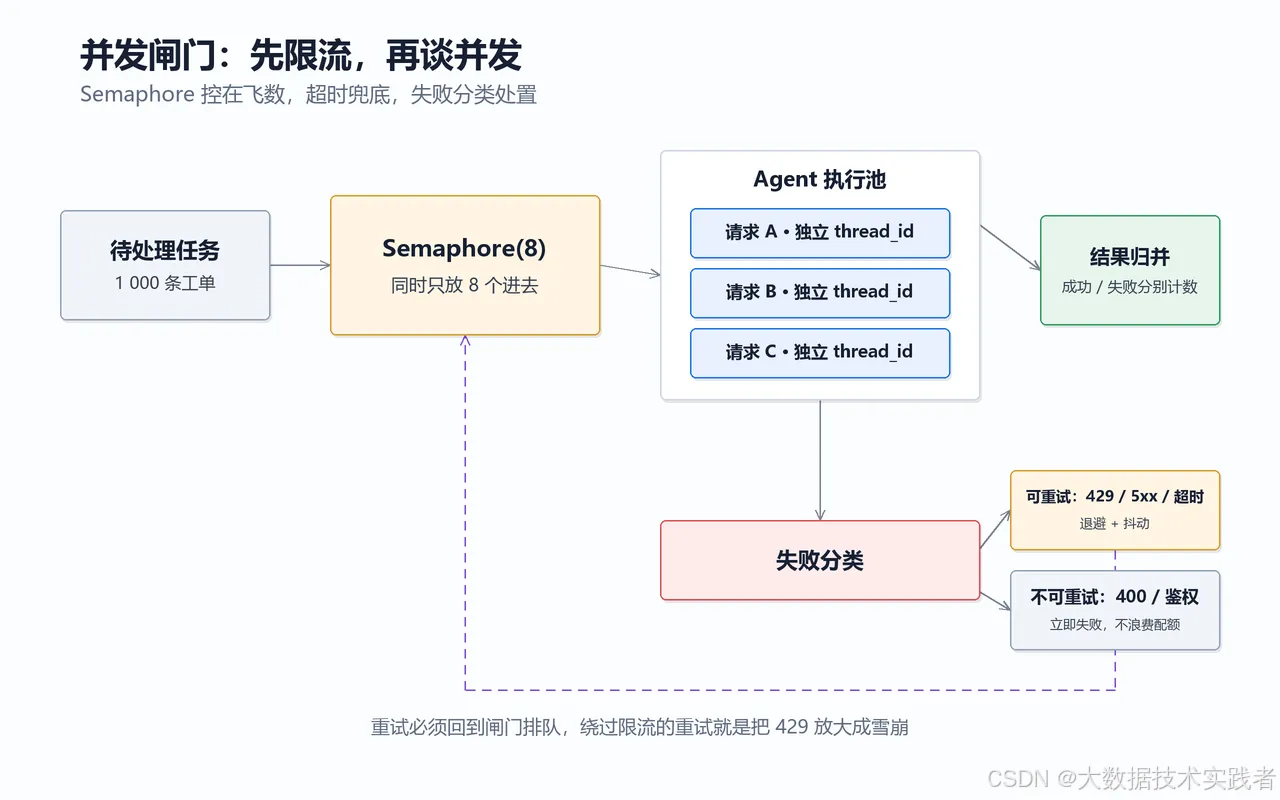
并发数设多少?别拍脑袋。先看下游给多少配额(TPM/RPM),再按 平均单请求耗时 × 目标 QPS 估算在飞请求数,最后留 20% 余量。8 到 16 是多数中小场景的合理起点,压测后再调。
这里有个反直觉的现象值得提前知道:并发调上去,平均延迟可能下降,P99 却会变差。 原因是排队。把下游看成一个服务台,利用率到 70% 时排队还短,到 90% 时队列长度会非线性地飙起来——这是排队论里的经典曲线,不是代码 bug。所以压测时别只看 QPS,要同时看两个数:在飞请求数和排队等待时间。如果前者已经顶到闸门值、后者还在涨,说明瓶颈在下游而不在你的并发度,继续加闸门只会把 429 变成超时。
顺带说一句异步流式。astream 返回的是异步生成器,消费端必须 async for;如果只想读前几个 chunk 就提前退出(比如命中缓存、用户点了停止),记得显式 await gen.aclose(),否则底层连接可能悬着不释放。这是异步生成器比普通函数多出来的一条规矩。
六、生产环境才暴露的四个问题
一、在 FastAPI 里用 asyncio.run。 这是最常见的启动错误:RuntimeError: asyncio.run() cannot be called from a running event loop。Uvicorn 已经跑着一个事件循环了,路由函数里直接 await agent.ainvoke(...) 就行:
@app.post("/plan")
async def plan(req: PlanRequest):
    resp = await agent.ainvoke(
        {
   "messages": [{
   "role": "user", "content": req.query}]},
        config={
   "configurable": {
   "thread_id": req.session_id}},
    )
    return {
   "answer": resp["messages"][-1].content}
顺带一提:别把 async def 路由写成 def。 同步路由会被 FastAPI 丢到线程池,看着也能跑,但一个阻塞调用就会吃掉线程池里的一个坑。
二、并发下 thread_id 复用。 上面代码里 thread_id 来自 session_id。如果大批量任务图省事都用同一个默认值,LangGraph 的 checkpoint 会互相覆盖,出现"用户 A 看到了用户 B 的对话历史"这种事故。并发批处理必须给每个任务独立 ID。
三、取消不等于退款。 客户端断开、asyncio.timeout 触发、task.cancel(),都会让 ainvoke 抛 CancelledError。但已经发出的模型请求不会因此撤销——token 照样计费,只是你不知道结果了。所以超时值要按业务能接受的最坏成本来设,而不是"随便给个 60 秒"。
四、异步栈里没有免费的上下文。 同步代码里常用 threading.local() 存 trace_id、租户 ID。异步下一个线程跑几十个协程,threading.local 立刻串数据。改用 contextvars.ContextVar,它随协程走而不是随线程走;更稳的做法是通过 config 或 ToolRuntime.context 显式传递。
七、换个语言看:Java 与 Flink 的同一件事
对 Java 工程师,ainvoke 对应的是 CompletableFuture:
ExecutorService pool = new ThreadPoolExecutor(
    16, 16, 0L, TimeUnit.MILLISECONDS,          // I/O 密集,别用 commonPool
    new LinkedBlockingQueue<>(1000),
    new ThreadPoolExecutor.CallerRunsPolicy());

List<CompletableFuture<String>> futures = cities.stream()
    .map(c -> CompletableFuture
        .supplyAsync(() -> agent.invoke(buildRequest(c), configFor(c)), pool)
        .orTimeout(30, TimeUnit.SECONDS)
        .exceptionally(e -> "FAILED: " + e.getClass().getSimpleName()))
    .toList();

CompletableFuture.allOf(futures.toArray(new CompletableFuture[0])).join();
三个对照点值得记:asyncio.Semaphore 对应有界线程池 + 有界队列;asyncio.timeout 对应 orTimeout;gather 对应 allOf。区别在于线程模型的成本——Java 一个线程约 1 MB 栈,协程只有几 KB,所以 Python 能靠单线程撑住上千并发,Java 要么控线程数,要么上 JDK 21 的虚拟线程。
对做实时计算的读者,这套东西其实早见过。Flink 的 AsyncDataStream.orderedWait(stream, asyncFunc, timeout, unit, capacity) 就是同一个模型:capacity 是闸门(对应 Semaphore),timeout 是超时(对应 asyncio.timeout),AsyncFunction 里回调 ResultFuture.complete() 对应协程恢复。Flink 当年引入 Async I/O 就是为了解决"每条记录同步查一次维表,吞吐被网络往返锁死"的问题——Agent 的处境一模一样,只不过维表换成了模型服务。
八、小结:先量清楚,再谈并发
异步调用不是一个 API 替换,而是一次执行模型的切换。落地前先回答三个问题:
- 瓶颈在哪一层? 是单请求内部的工具串行(做工具并行),还是整批任务排队(做请求并发)。改错层次,收益接近零。
- 下游能承受多少并发? 闸门值由配额决定,不由代码决定。
- 失败了怎么办? 分类、退避、降级,三件事缺一不可,否则一次 429 就会在重试风暴里变成雪崩。
一份可以直接抄的清单:
- 入口统一
ainvoke/astream,不在 async 代码里调同步版本 - 所有工具
async def,I/O 走httpx.AsyncClient,client 全局复用 - 每个工具内部有超时,每个请求外层有总超时
- 批量任务用
Semaphore限流,值来自下游配额 - 每条任务独立
thread_id,避免状态串台 - 只重试可重试错误,退避带抖动
- 上下文用
contextvars,别用threading.local
Agent 慢,很少是因为模型慢,更多是因为我们把本该重叠的等待排成了队。先把等待叠起来,再谈优化模型。