
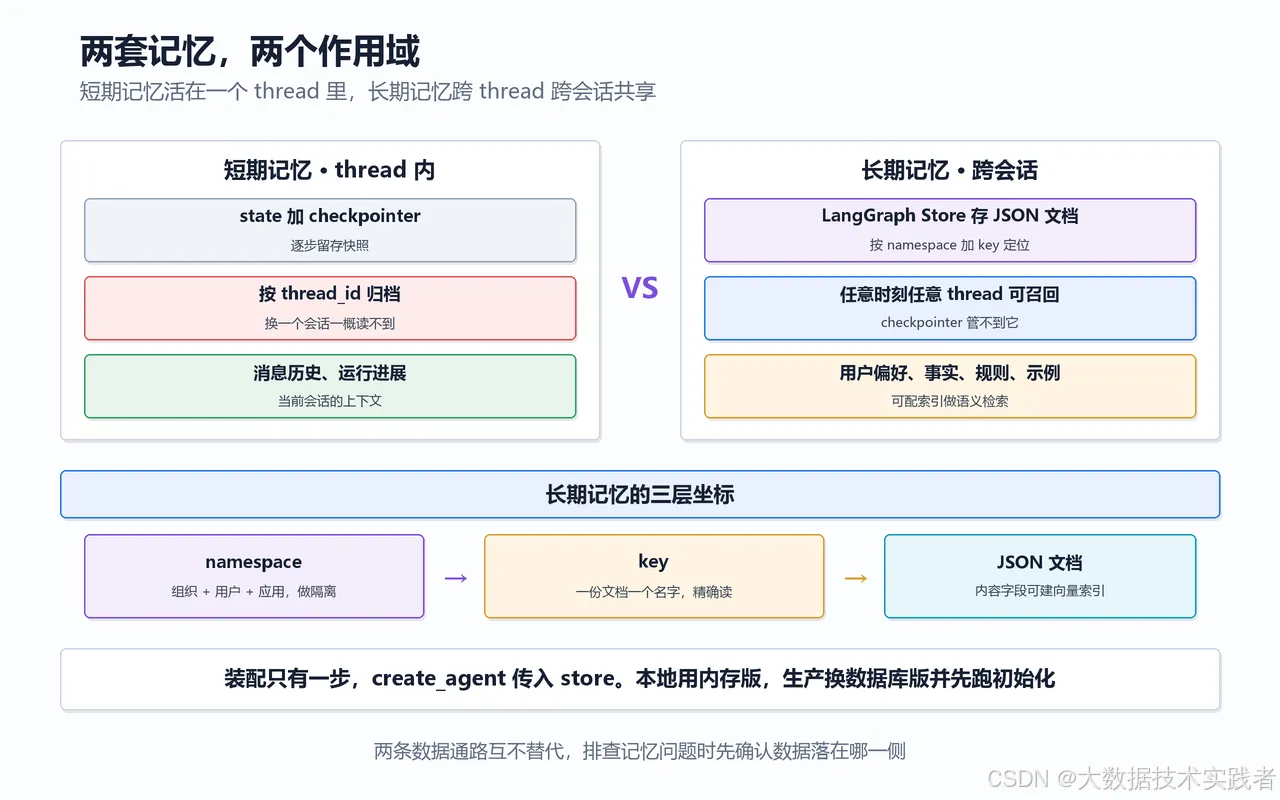
上一篇把 LangChain 长期记忆的边界讲清楚了,Store 存 JSON 文档,namespace 加 key 定位,作用域跨 thread 跨会话。到了落地环节,常见的卡点往往在读这一侧,装配反而简单。有人把 store 传给 create_agent 就以为完事,模型照旧按默认行为回答。也有人给 Agent 挂了一堆记忆工具,每轮多几次工具调用,延迟上去了,记忆还时灵时不灵。
差别在于谁来决定读。本篇按这个角度把长期记忆的使用方式拆成四条路径,配一段能直接跑通的完整示例,最后用换 thread 的实验验证装配是否正确。
一、四条路径,先按谁决定读分类
LangChain 把 Store 挂进 Agent 之后,读写入口其实散落在三处,工具里、中间件里、应用代码里。加上召回侧的语义检索,一共四条路径。它们不是四选一,生产项目里通常同时用两三条。
| 路径 | 读写入口 | 决策方 | 生效时机 | 适合场景 |
|---|---|---|---|---|
| 工具内读写 | ToolRuntime 的 store | 模型 | 模型决定调用时 | 按需查资料、当场纠正偏好 |
| 中间件注入 | dynamic_prompt 或 wrap_model_call | 应用代码 | 每次模型调用前 | 用户偏好、系统指令 |
| 直接 Store API | put、get、search、delete | 应用或后台任务 | 由应用逻辑触发 | 批量归纳、迁移、清理 |
| 语义检索 | search 的 query 与 filter | 应用代码 | 召回阶段 | 从大量条目里取相关的几条 |
判断依据只有一句话,这份记忆是否每一轮都要生效。每轮必用的偏好和规则,交给中间件在模型调用前注入,模型无需感知。按需才用的资料,做成工具由模型自己决定调不调。写入、归纳、清理这类不需要模型参与的动作,直接在应用侧调 Store API。语义检索是召回手段,配合前三者使用,不算独立的写路径。
二、路径一,工具内读写交给模型
工具路径的价值在于灵活,模型可以自己判断这一轮要不要查。代价也清楚,多一次工具调用就多一份延迟,模型还得同时兼顾回答和记忆管理。官方示例把读工具和写工具分开演示,下面给一段能直接放进项目的写法,两件事合在一起,读不到给兜底,写入用 TypedDict 约束字段。
from dataclasses import dataclass
from typing_extensions import TypedDict
from langchain.tools import ToolRuntime, tool

@dataclass
class Context:
    user_id: str

class Preference(TypedDict):
    rules: list[str]

@tool
def save_preference(pref: Preference, runtime: ToolRuntime[Context]) -> str:
    """保存用户偏好。"""
    assert runtime.store is not None
    runtime.store.put(("users",), runtime.context.user_id, dict(pref))
    return "偏好已保存"

@tool
def load_preference(runtime: ToolRuntime[Context]) -> str:
    """读取用户偏好。"""
    assert runtime.store is not None
    item = runtime.store.get(("users",), runtime.context.user_id)
    return str(item.value) if item else "暂无偏好记录"
两处不能省。runtime.store 的类型标注允许为 None,取值前先断言,Store 没传进 create_agent 时工具里拿到的就是空值。用户 id 从 context 取,不交给模型填,避免模型猜错身份,把 A 的偏好写到 B 名下。工具描述也要写清楚,模型靠它判断调用时机。
三、路径二,把记忆自动注入系统提示词
用户偏好这类信息每一轮都要生效,让模型自己记得调查询工具并不可靠。更稳的做法是把召回放到应用侧,用 @dynamic_prompt 在每次模型调用前从 Store 取档案,拼进系统提示词。
官方 reference 写明,dynamic_prompt 是 wrap_model_call 的便捷装饰器。被装饰函数接收 request 这个 ModelRequest 参数,返回一段字符串或一个 SystemMessage,作为本次模型请求的系统提示词。本地 Notion 笔记里的动态提示词案例用 request.runtime.context 判用户角色,这里把同一套机制换到 Store 上。
from langchain.agents.middleware import dynamic_prompt, ModelRequest

@dynamic_prompt
def memory_prompt(request: ModelRequest) -> str:
    """每次模型调用前,把用户档案拼进系统提示词。"""
    store = request.runtime.store
    assert store is not None
    item = store.get(("users",), request.runtime.context.user_id)
    rules = item.value.get("rules", []) if item else []
    preference = ";".join(rules) if rules else "暂无记录"
    return (
        "你是一名面向 Java、大数据与 AI 工程师的技术助手。\n"
        f"当前用户的长期偏好:{preference}\n"
        "回答时遵守上述偏好,除非用户本轮明确要求改变。"
    )
装配时把 store、checkpointer、context_schema 和 middleware 一起传给 create_agent。checkpointer 管短期记忆,store 管长期记忆,两者互不干扰。
from langchain.agents import create_agent
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.store.memory import InMemoryStore

store = InMemoryStore()
store.put(("users",), "user_123",
          {
   "rules": ["回答控制在三行内", "示例用 Java"]})

agent = create_agent(
    "claude-sonnet-4-6",
    tools=[save_preference, load_preference],
    store=store,
    checkpointer=InMemorySaver(),
    context_schema=Context,
    middleware=[memory_prompt],
)
有个细节值得单独说。dynamic_prompt 返回的是整段系统提示词,会替换 create_agent 里 system_prompt 的内容,所以基础指令要写进返回值。如果希望保留原有 system_prompt,只追加一段记忆,改用 wrap_model_call,按官方示例操作 content_blocks。
from collections.abc import Callable
from langchain.agents.middleware import wrap_model_call, ModelRequest, ModelResponse
from langchain.messages import SystemMessage

@wrap_model_call
def append_memory(
    request: ModelRequest,
    handler: Callable[[ModelRequest], ModelResponse],
) -> ModelResponse:
    store = request.runtime.store
    assert store is not None
    item = store.get(("users",), request.runtime.context.user_id)
    rules = item.value.get("rules", []) if item else []
    blocks = list(request.system_message.content_blocks)
    blocks.append({
   "type": "text", "text": "用户偏好:" + ";".join(rules)})
    return handler(request.override(system_message=SystemMessage(content=blocks)))
若运行环境没有把 store 注入 runtime,用闭包引用同一个 store 实例即可,效果一样。关键是三个入口只用一个实例,别在中间件里另建一个内存版。
四、换一个 thread,验证跨会话是否生效
装配对不对,最快的验证方式是切 thread_id 再问一次。下面这段用同一个 store 和用户身份,在两个不同 thread 上各调一次。第二次的短期记忆是空的,长期记忆应当照常生效。
cfg_a = {
   "configurable": {
   "thread_id": "thread-a"}}
cfg_b = {
   "configurable": {
   "thread_id": "thread-b"}}
ctx = Context(user_id="user_123")

r1 = agent.invoke(
    {
   "messages": [{
   "role": "user", "content": "介绍一下流式输出"}]},
    config=cfg_a, context=ctx,
)
r2 = agent.invoke(
    {
   "messages": [{
   "role": "user", "content": "再介绍一下窗口超限"}]},
    config=cfg_b, context=ctx,
)
print("thread-a:", r1["messages"][-1].content)
print("thread-b:", r2["messages"][-1].content)
期望看到两段都遵守三行以内、示例用 Java。第二个会话问的是「再介绍一下」,模型在 thread-b 里读不到上一轮消息,短期记忆确实断了,但偏好仍通过动态提示词进入系统提示词。这条实验把前几篇讲过的 state 与 Store 分工落到了可观察的输出上,比翻文档直观。
| 现象 | 优先检查 |
|---|---|
| 断言在工具或中间件里失败 | store 没有传给 create_agent |
| 取到空值 | namespace 或 key 与写入时不一致 |
| 换用户才出错 | user_id 没放进 namespace 前段 |
| 语义检索结果为空 | 索引未配置,或条目写入时 index 设为 False |
五、路径三,脱离 Agent 直接调 Store API
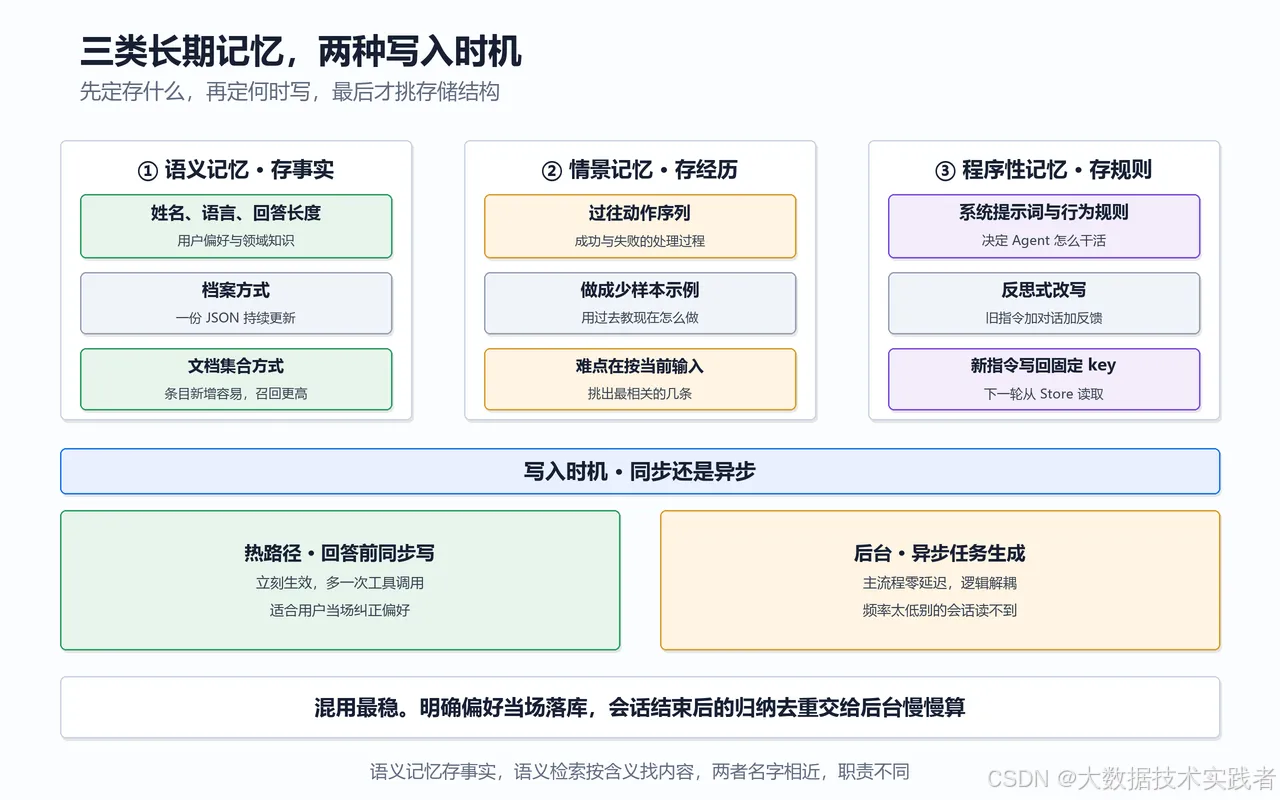
写入不一定非要经过模型。会话结束后的归纳、去重、迁移、清理,交给后台任务更合适,主流程没有额外延迟,业务逻辑与记忆管理也分开。这些场景直接在应用侧调 Store 的同步接口就够了。
from langgraph.store.memory import InMemoryStore

store = InMemoryStore()

# 后台归纳,把一次会话的结论写回固定 key
store.put(("org-42", "user_123", "profile"), "summary",
          {
   "summary": "关注流批一体与状态管理", "source": "thread-a"})

# 分页枚举某个前缀下的全部条目
page_size, offset = 50, 0
while True:
    page = store.search(("org-42", "user_123"), limit=page_size, offset=offset)
    if not page:
        break
    for item in page:
        print(item.key, item.updated_at)
    offset += page_size

# 纠正一条写错的记忆
store.delete(("org-42", "user_123", "profile"), "summary")

# 遍历命名空间,做批量整理
namespaces = store.list_namespaces(prefix=("org-42",), max_depth=3)
Store 的完整接口是 put、get、delete、search、list_namespaces,异步版本对应 aput、aget、adelete、asearch、alist_namespaces。get 按 namespace 加 key 精确取回,查不到返回 None。search 不带 query 也不带 filter 时,等价于枚举一个前缀下的条目。
部署到 LangGraph 平台时 Store 由平台托管,本地代码不必再传实例,但语义检索的索引要在配置文件里声明,否则 query 参数不会按相似度排序。
{

  "store": {

    "index": {

      "embed": "openai:text-embedding-3-small",
      "dims": 1536,
      "fields": ["$"]
    }
  }
}
六、路径四,语义检索的三个参数细节
条目攒到几百条之后,按 key 一个个取就不现实了。给 Store 配索引,search 传 query 才会按向量相似度排序。构造参数有三个,embed 接嵌入模型或自定义函数,dims 必须和模型输出维度一致,fields 决定文档里哪些字段参与嵌入,其中 $ 代表整份文档。
from langchain.embeddings import init_embeddings
from langgraph.store.memory import InMemoryStore

store = InMemoryStore(
    index={

        "embed": init_embeddings("openai:text-embedding-3-small"),
        "dims": 1536,
        "fields": ["rules", "$"],
    }
)
ns = ("org-42", "user_123", "preferences")

# 单条指定嵌入字段,或干脆不参与嵌入
store.put(ns, "p1", {
   "rules": "回答控制在三行内", "origin": "user"},
          index=["rules"])
store.put(ns, "p2", {
   "system_info": "internal"}, index=False)

items = store.search(ns, query="回答要简短", filter={
   "origin": "user"}, limit=5)
for it in items:
    print(it.key, it.value)
index=False 的条目仍可用 get 取回,但不会被语义检索命中。query 负责排序,filter 做内容等值过滤,两者可以同时用。返回的是 Item 对象,常用字段有 value、key、namespace、created_at、updated_at,调用 .dict() 可以转成字典。
真正容易出问题的是下面三个行为,官方文档专门列了注意事项。
| 易错行为 | 实际语义 | 处理办法 |
|---|---|---|
| 前缀匹配 | 传 ("alice",) 会连带返回所有子命名空间条目 | 传完整 namespace,或客户端按 item.namespace 再过滤 |
| 静默截断 | limit 默认 10,超出不报错也不提示 | 用 offset 分页,或把 limit 设到预期上限 |
| 后端排序不同 | 内存版按插入顺序,最新在末尾;Postgres 版按 updated_at 降序 | 客户端按 item.updated_at 自行排序 |
第一条在多租户场景下尤其要留心,本来想查某个用户的档案,结果把该用户下所有子命名空间的条目都捞了回来。第三条影响清洗脚本,同一段分页逻辑从内存版切到 Postgres 版,顺序会反过来,按位置取最新一条的代码会取错。
七、选型表与上线检查清单
把四条路径按需求对号入座,配一张表就够了。
| 需求 | 选哪条路径 | 关键配置 |
|---|---|---|
| 每轮都生效的用户偏好 | 中间件注入 | dynamic_prompt 加 context_schema |
| 按需查询的资料 | 工具内读写 | ToolRuntime 的 store 加兜底 |
| 会话结束后的归纳去重 | 直接 Store API | 后台任务加 namespace 带用户 id |
| 从上千条记忆里取相关几条 | 语义检索 | IndexConfig 加 query 加 limit |
| 保留原有系统提示词 | wrap_model_call | content_blocks 追加新块 |
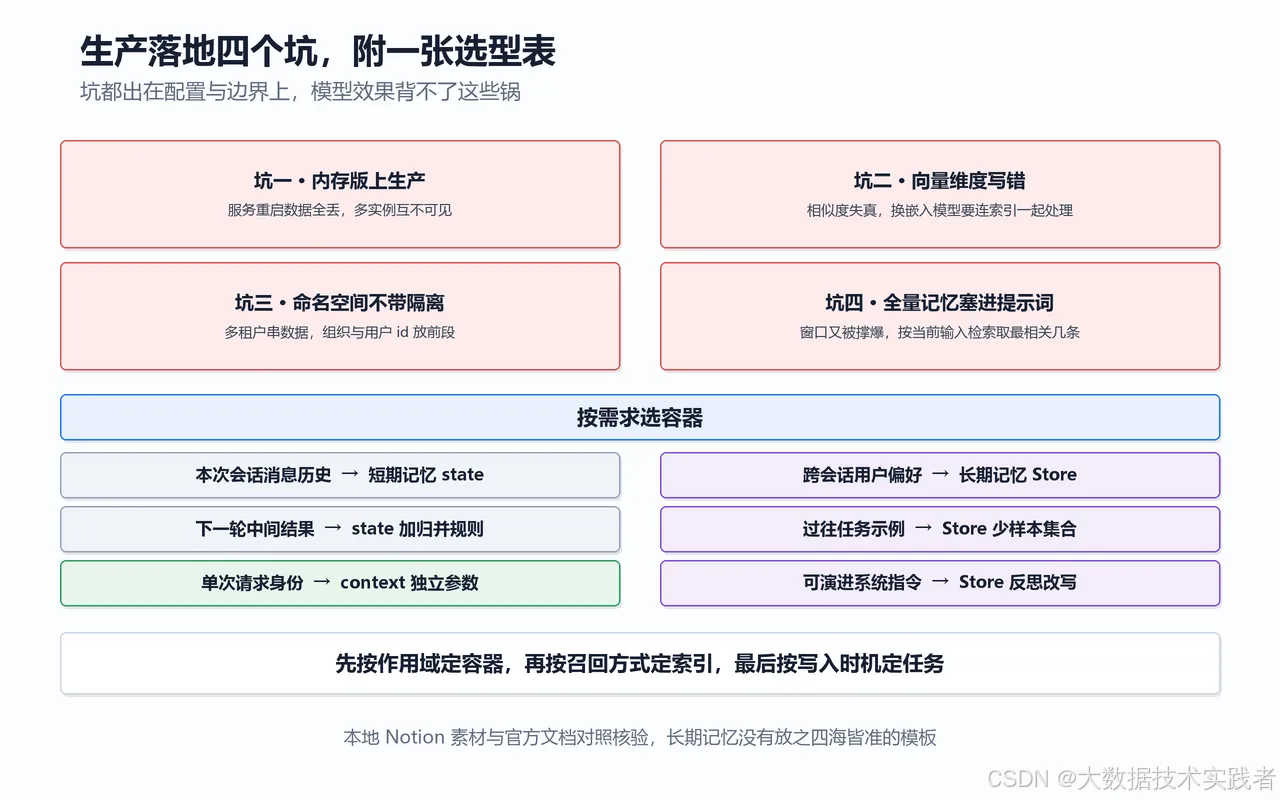
上线前按这份清单逐项过一遍,能挡掉大部分记忆相关的线上问题。
- store 是否是同一个实例,工具、中间件、Agent 三处指向一致。
- context 是否带 user_id,namespace 前段是否包含它,跨用户会不会串数据。
- 生产是否换成 PostgresStore 等数据库后端,启动时是否跑过 setup()。
- dims 是否与嵌入模型输出维度一致,换模型时索引与已有向量是否一起处理。
- dynamic_prompt 是否覆盖了原有 system_prompt,基础指令是否已写进返回值。
- search 的 limit 是否足够,条目增长后是否需要 offset 分页。
- 是否把全量长期记忆塞进提示词,应当按当前输入取最相关的几条。
- 后台写入频率是否够,别的 thread 会不会在一段时间内读不到新内容。
第 7 条和上一篇讲窗口超限时说的是同一件事,长期记忆攒得越多,越要克制注入量。官方文档也提到,长期记忆没有放之四海皆准的方案,按数据的作用域定容器,再按召回方式定索引,最后按写入时机定任务,比一上来套模板稳当。
八、收尾
长期记忆的难点不在存,在谁在读、何时读、读多少。Store 只负责把 JSON 文档放好,让它产生价值的是四条使用路径的选择。每轮必用的交给中间件,按需才用的做成工具,批量动作留给后台 API,规模上来之后再用语义检索收窄召回范围。
把决策方想清楚,再用换 thread 的实验验证一次,Memory 相关的线上问题大半能提前发现。下一篇会接着聊工程侧的观测与调优,把这套做法放到真实流量下看。
