一、散文输出的代价
上一篇把工具比作 Agent 的"手脚",讲的是怎么让它做事。但做事之后还有一环常被忽略:结果怎么交回给程序。
默认情况下,Agent 返回的是一段自然语言。"张三的消费等级是 VIP,最近一次购买在 1 月 15 日,累计消费一万五千美元,建议发送感谢邮件。"——人读着挺舒服,程序读着很痛苦。
于是就有了各种补救手段:正则、json.loads 套一层 try、让模型"请只返回 JSON"、再写一堆 if "```json" in text 的清洗逻辑。这些代码的共同结局是:在 demo 里跑得通,在上线后天天修。模型偶尔多写一句"好的,以下是结果:",正则就崩;字段顺序一变,解析就错;类型从数字变字符串,入库就报错。
LangChain 的答案是 response_format:把"要什么结构"声明出来,让框架去保证输出符合这个结构。Agent 的产出从一段散文,变成一个可以直接 save() 的对象。
对 Java 工程师,这套东西并不陌生:它相当于把 Jackson 反序列化、Bean Validation 校验、失败重试三件事,打包成一次声明。你写 DTO,框架负责让模型按 DTO 说话。
二、一个参数,四种取值
create_agent 的 response_format 支持四种配置:
| 取值 | 含义 | 适用 |
|---|---|---|
ProviderStrategy(Schema) |
用模型厂商的原生结构化输出 | OpenAI / Claude / Grok 等(中转 key 多不支持) |
ToolStrategy(Schema) |
动态创建一个"虚拟工具"接住数据 | 任何支持工具调用的模型,兼容性最好 |
Schema(直接传类) |
按模型能力自动选上面两者 | LangChain 1.2 仍可用,1.0 起官方建议显式指定 |
None |
默认,自然语言回复 | 闲聊、解释类场景 |
无论选哪条路,结果都落在同一个地方:result["structured_response"]。
result = agent.invoke({
   "messages": [{
   "role": "user", "content": "分析客户张三"}]})
analysis = result["structured_response"]   # 已经是 CustomerAnalysis 实例,不是字符串
print(analysis.customer_tier)              # VIP客户
这一行 result["structured_response"] 是本文的关键。它是 Agent 状态里的一个独立键,和 messages 并列——结构化结果不进对话历史,只进状态。想清楚这一点,后面很多坑就通了。
顺带澄清一个常见混淆:很多模型提供 response_format={"type": "json_object"} 这样的 JSON mode,它只保证"输出是合法 JSON",不保证"字段名、类型、枚举值符合你的约定"。JSON mode 解决的是语法问题,response_format=ToolStrategy(Schema) 解决的是语义与结构问题。前者你还要自己校验,后者框架替你校验并重试。这是两件事,别混着用。
三、两条技术路线:约束解码 与 虚拟工具
ProviderStrategy 和 ToolStrategy 的差别,不是"配置写法不同",而是约束发生在哪一层。
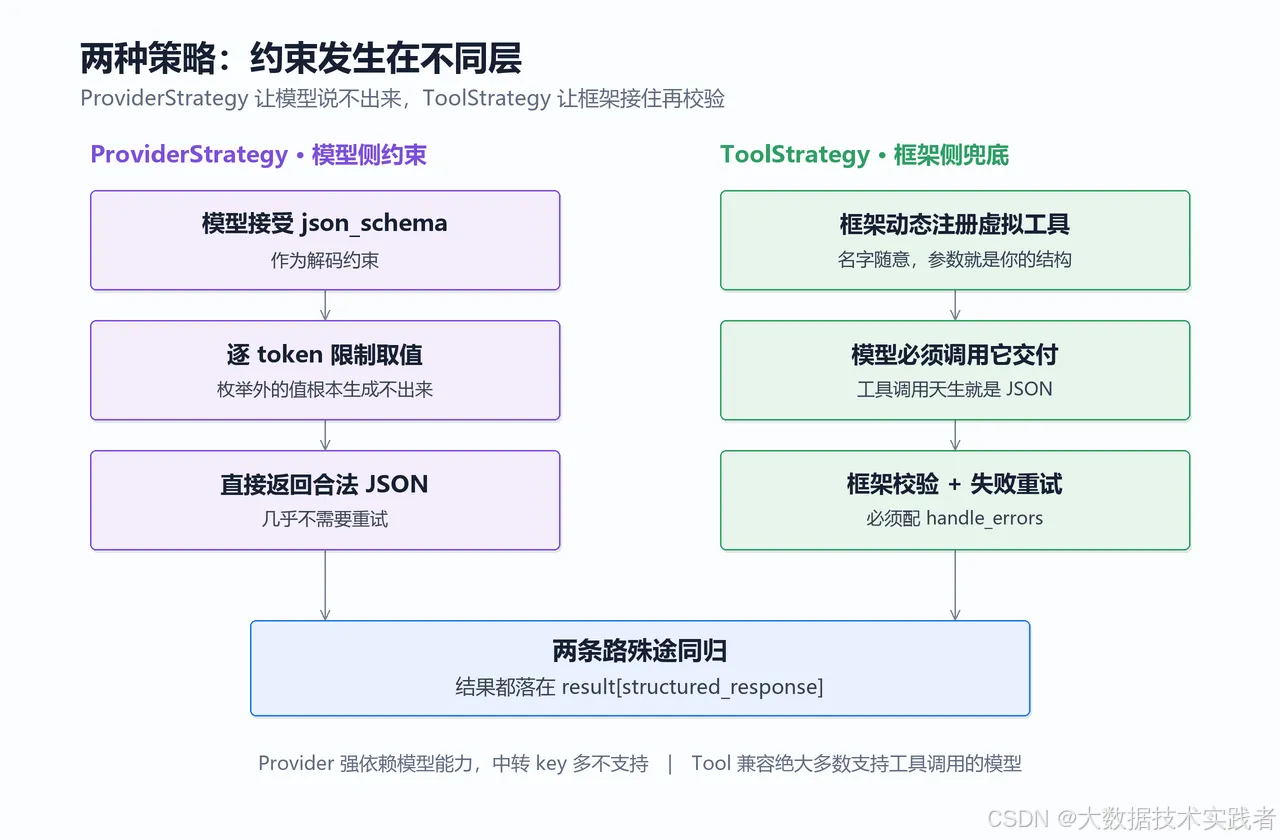
ProviderStrategy 走模型侧。 厂商 API 支持把 JSON Schema 作为解码约束传进去,模型在生成每个 token 时就被限制在合法取值内——customer_tier 只可能吐出枚举里的四个值之一,根本"说不出来"别的。这是最硬的保证,代价是强依赖厂商能力,中转 key、私有化部署的模型基本用不了。
ToolStrategy 走框架侧。 它动态造一个工具,名字随便取,参数 schema 就是你要的结构。模型想交付结果,就必须"调用"这个工具并填参数——而工具调用本来就是结构化 JSON。框架接住这次调用,用 schema 校验,通过就写入 structured_response。
两条路殊途同归,但容错空间不同:Provider 策略下模型几乎不会产出非法结构;Tool 策略下模型仍可能填错类型、漏字段、或者一次返回多个结果——所以 ToolStrategy 才需要 handle_errors 这套重试机制,而 ProviderStrategy 基本用不上。
官方的推荐也很务实:能用 Provider 就用 Provider,用不了就 ToolStrategy,而后者覆盖了绝大多数国产模型和自建模型——这也是本文后续的重点。
四、ToolStrategy 的三个参数与四种 Schema
ToolStrategy 的配置只有三个参数,但每一个都值得说清:
ToolStrategy(
    schema=CustomerAnalysis,          # 必需:结构定义
    tool_message_content="分析完成",   # 可选:写进对话历史的提示语
    handle_errors=True,               # 可选:校验失败怎么办,默认 True
)
schema 支持四种写法,这是最容易选错的地方。
4.1 Pydantic:默认首选
from typing import Literal
from pydantic import BaseModel, Field, field_validator
from langchain.agents import create_agent
from langchain.agents.structured_output import ToolStrategy

class CustomerAnalysis(BaseModel):
    """客户分析报告"""
    customer_name: str = Field(description="客户姓名")
    customer_tier: Literal["潜在客户", "普通客户", "VIP客户", "流失风险"] = Field(
        description="客户等级,只能是这四个值之一"
    )
    recent_activity: str = Field(default="", description="最近一次活动,如 2024-01-15 购买")
    spending_level: Literal["低", "中", "高"] = Field(description="消费水平")
    need_follow_up: bool = Field(default=False, description="是否需要跟进")

    @field_validator("spending_level")
    def check_level(cls, v: str) -> str:
        if v not in ("低", "中", "高"):
            raise ValueError("消费水平必须是 低/中/高")
        return v

agent = create_agent(
    model=deepseek_llm,
    tools=[search_customer_database, send_email],
    system_prompt="""分析指定客户:
1. 先搜索客户数据库获取最新记录
2. 若为 VIP 客户,发送感谢邮件
3. 基于结果输出结构化分析报告
4. 若查不到该客户,返回空对象,不要反复尝试""",
    response_format=ToolStrategy(CustomerAnalysis),
)

result = agent.invoke({
   "messages": [{
   "role": "user", "content": "请分析客户张三"}]})
if "structured_response" in result:
    print(result["structured_response"].model_dump_json(indent=2))
Pydantic 的优势在校验:Literal 把取值钉死,ge/le 能约束数值范围,field_validator 能做业务规则。校验失败时抛的是 StructuredOutputValidationError,会被 handle_errors 接住并回给模型重试——这条回路下一节展开。
4.2 dataclass / TypedDict:轻量但无校验
from dataclasses import dataclass, field
from typing import Optional, Literal

@dataclass
class CustomerAnalysis:
    """客户分析报告"""
    customer_name: Optional[str] = field(default=None, metadata={
   "description": "客户姓名"})
    customer_tier: Literal["潜在客户", "普通客户", "VIP客户", "流失风险"] = field(
        default="潜在客户", metadata={
   "description": "客户等级"}
    )
    spending_level: Optional[Literal["低", "中", "高"]] = field(
        default=None, metadata={
   "description": "消费水平"}
    )
TypedDict 用 Annotated[类型, 默认值, "描述"] 表达同样的东西。两者的共同短板是没有运行时校验:字段类型不对、枚举越界,框架不会拦,直接进你的业务代码。省下的依赖,要用下游的防御代码补回来。
4.3 JSON Schema:跨语言的公共契约
CUSTOMER_SCHEMA = {

    "title": "CustomerAnalysis",
    "type": "object",
    "description": "客户分析报告",
    "properties": {

        "customer_name": {
   "type": "string", "description": "客户姓名"},
        "customer_tier": {

            "type": "string",
            "enum": ["潜在客户", "普通客户", "VIP客户", "流失风险"],
            "description": "客户等级",
        },
        "spending_level": {
   "type": "string", "enum": ["低", "中", "高"], "description": "消费水平"},
    },
    "required": ["customer_name", "customer_tier", "spending_level"],
}

agent = create_agent(model=deepseek_llm, tools=[], response_format=ToolStrategy(CUSTOMER_SCHEMA))
适合 schema 由配置下发、或要和 Java 侧共用一份契约文件的场景。注意 required 要老实填——写成空数组又指望模型别漏字段,是靠运气。
4.4 四种写法怎么选
| Schema 类型 | 运行时校验 | 额外依赖 | 推荐场景 |
|---|---|---|---|
| Pydantic | 完整(类型/枚举/自定义规则) | 需装 pydantic | 生产默认首选 |
| dataclass | 无 | 标准库 | 内部脚本、结构极简 |
| TypedDict | 无 | typing_extensions | 只需类型提示的快速原型 |
| JSON Schema | 按关键字部分生效 | 无 | 配置化、跨语言共享契约 |
一句话:只要数据要入库、要传给下游,就用 Pydantic。校验不是负担,是把错误挡在业务代码之外。
4.5 tool_message_content:顺手省一笔 token
默认情况下,虚拟工具调用成功后,那条 ToolMessage 里装的是完整的数据块:
ToolMessage(content="{'customer_name': '张三', 'customer_tier': 'VIP客户', ...}")
它会原样留在对话历史里。数据小无所谓,字段一多、列表一长,每轮推理都要重读一遍。tool_message_content 允许你换成一句短提示:
response_format=ToolStrategy(
    CustomerAnalysis,
    tool_message_content="客户分析完成",   # 历史里只留这一句
)
两个收益:对话流对最终用户更干净(不会在聊天窗口里蹦出一坨原始 JSON),上下文也省下来了。而无论这里填什么,结构化数据都会完整写进 structured_response——这句话的意思是:tool_message_content 只影响历史里那一条记录,不影响你要的数据。这是个很实用的解耦。
五、校验失败之后:handle_errors 五档
模型不是编译器。它可能把 rating 填成 10(你限的是 1–5)、把枚举值写成"复杂"、或者在 Union 场景下一次返回两个结构。handle_errors 决定这些情况怎么处理:
| 取值 | 行为 | 适用 |
|---|---|---|
True(默认) |
捕获所有异常,用内置错误模板提示模型重试 | 绝大多数场景 |
False |
不捕获,直接抛异常中断 | 希望快速失败、暴露问题 |
"固定字符串" |
捕获所有异常,但用你写的提示语回给模型 | 需要统一话术 |
ExceptionType |
只重试指定异常,其他照抛 | 精准控制 |
callable |
自定义函数,按异常类型给不同提示 | 复杂业务 |
它的工作回路和上一篇的工具错误处理同源:失败 → 生成一条 ToolMessage → 模型读到错误 → 修正参数重来。
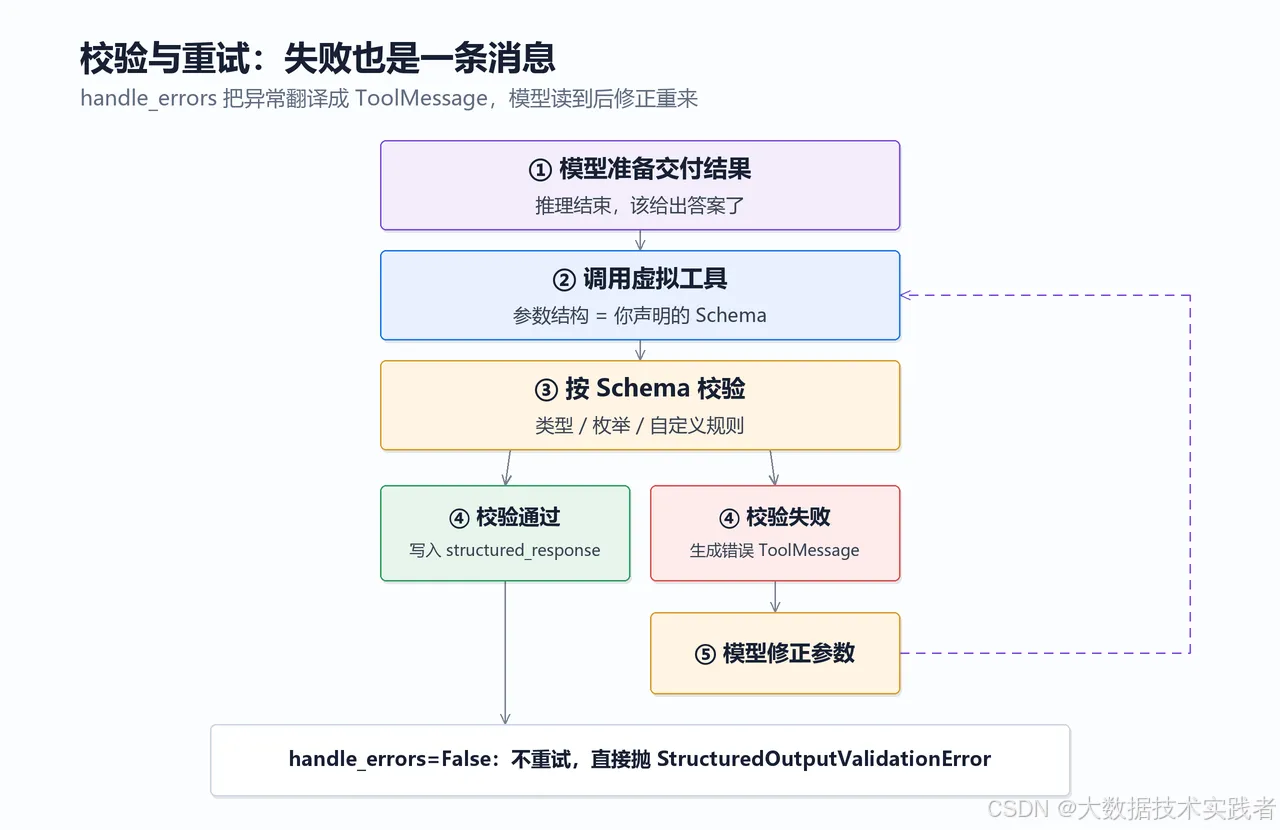
自定义 handler 能拿到具体异常类型,从而给出差异化提示:
from langchain.agents.structured_output import (
    ToolStrategy, StructuredOutputValidationError, MultipleStructuredOutputsError,
)

def custom_error_handler(error: Exception) -> str:
    if isinstance(error, StructuredOutputValidationError):
        return "输出不符合 Schema:rating 必须是 1-5 的整数,sentiment 只能是 正面/负面/中性。请重新分析。"
    if isinstance(error, MultipleStructuredOutputsError):
        return "一次只能返回一个结构,请选择最匹配的那个 Schema 重新输出。"
    return f"结构化输出失败:{error}。请检查字段后重试。"

agent = create_agent(
    model=deepseek_llm,
    tools=[],
    response_format=ToolStrategy(ProductEvaluation, handle_errors=custom_error_handler),
)
MultipleStructuredOutputsError 这个类型值得单独记一笔:它只在 Union[SchemaA, SchemaB] 场景出现——模型同时返回了两种结构,而框架只接受一个。默认的 True 恰好能处理它,一旦你设成 False,这里就会直接崩。
Union 的用法本身很有价值:一次调用同时完成"分类 + 提取"。
from typing import Union

agent = create_agent(
    model=deepseek_llm,
    tools=[],
    response_format=ToolStrategy(
        Union[ContactInfo, EventDetails],
        tool_message_content="提取完成",
        handle_errors=True,
    ),
)
给一段混杂文本,模型自己判断这是"联系人"还是"活动",再按对应结构输出。相当于把路由逻辑塞进了 schema 层,省掉一次分类调用。
但重试是有代价的,这点文档里不会写。每一次校验失败都意味着多一轮完整的模型调用——多付一份 token、多几百毫秒延迟。如果你的 Schema 写得太苛刻(比如要求模型从一段百字文本里提取三个必填字段,还都要精确格式),很容易看到"重试 3 次才成功"的日志。
几条经验:Schema 里必填字段越少越好,能设默认值就别设 required;枚举值给中文标签("已解决")比给英文码("RESOLVED")更容易命中;真遇到反复失败的字段,先改提示词把源数据说清楚,而不是加大重试次数。重试是安全网,不是主力方案。
六、两个上线才会遇到的坑
坑一:提示词里把"输出结构化结果"写太前,工具就不调了。
模型的注意力是有限的。如果 system prompt 开头就强调"请输出结构化报告",它很可能跳过搜索、跳过发邮件,直接凭想象填一份报告——格式完美,数据全是编的。正确做法是把结构化输出的要求放在提示词最后,前面留给流程步骤。
坑二:查不到数据时,Agent 会陷入工具死循环。
用户问"分析客户王五",数据库里没有这个人。模型不甘心,换个关键词再查、再查、再查,直到撞上递归上限。解决办法是在提示词里显式给出兜底路径:
如果查不到该客户信息,直接返回空对象,不要重复调用工具。
配上 required 字段留空、字段给 default="",这条路径才能真正走通。
这两个坑的共同点:它们都不是 API 层面的问题,而是提示词与 Schema 的配合问题。结构化输出降低了"解析"的难度,但没有降低"让模型按流程办事"的难度。
再补一个排查清单:拿到结果发现 "structured_response" not in result,通常是三种原因。一是提示词没有要求"输出结构化报告",模型直接用自然语言答完了,压根没调那个虚拟工具;二是流程里工具调用失败或陷入循环,被 recursion_limit 截断,没走到输出环节;三是 handle_errors=False 且校验失败,异常在 invoke 时就抛了,你根本没拿到 result。三种情况的日志特征完全不同,别一上来就怀疑 Schema 写错了。
七、落地:从一段文本到一条数据
把视角拉远一点。结构化输出真正的价值,不在"少写几行解析代码",而在于它让 Agent 的产出可以直接进入数据管道。
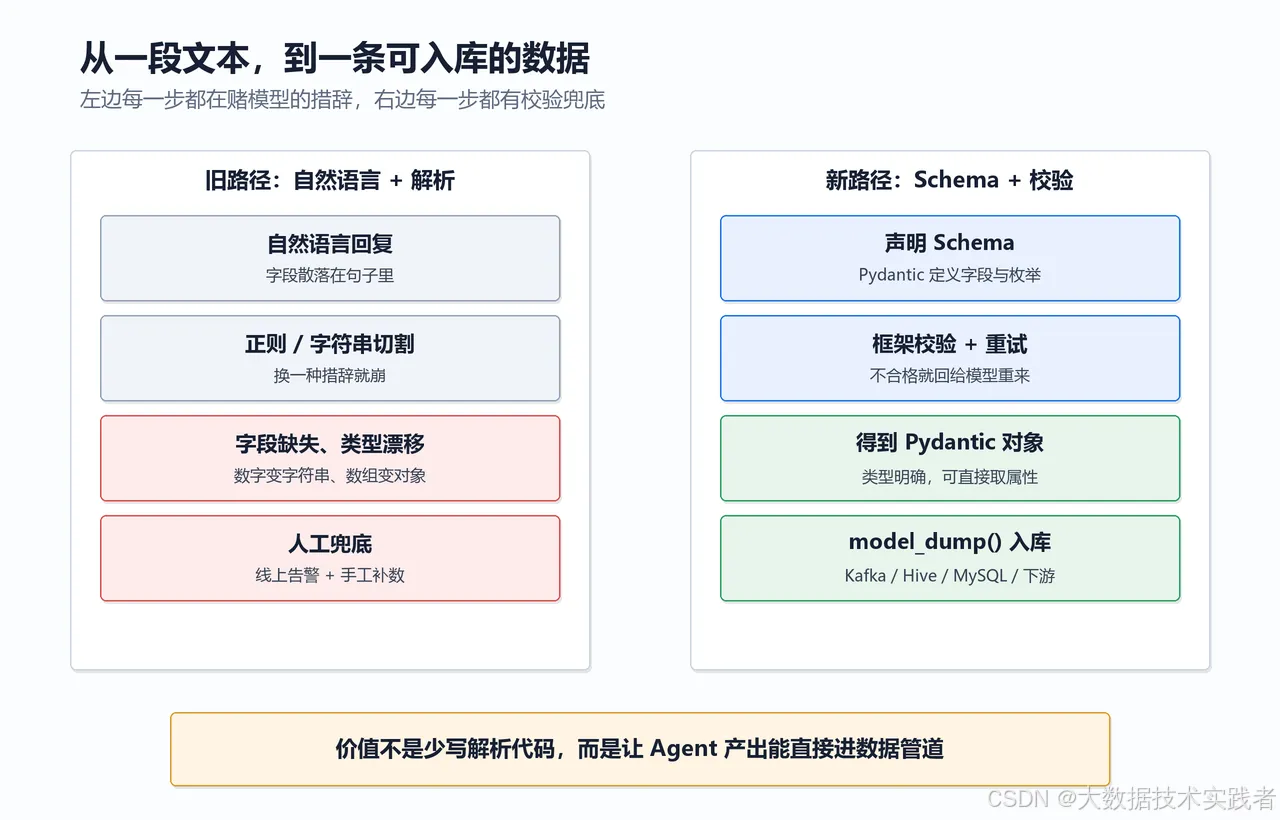
左边是旧路径:自然语言 → 正则/字符串切割 → 字段缺失、类型漂移 → 人工兜底。每一步都在赌模型的措辞习惯。
右边是新路径:声明 Schema → 框架校验 → Pydantic 对象 → model_dump() 成 dict → 写 Kudu/Hive/MySQL、发 Kafka、调下游 API。对大数据工程师,这意味着 Agent 可以直接产出带 schema 的宽表记录;对 Java 工程师,这意味着 Agent 的返回能被 @RequestBody 直接接住。
analysis = result["structured_response"]
record = analysis.model_dump()          # {'customer_name': '张三', 'customer_tier': 'VIP客户', ...}
对应到服务端,就是这样一个 DTO——字段名和类型与 Python 侧一一对应,中间不需要任何字符串解析:
public record CustomerAnalysis(
        String customerName,        // 与 customer_name 对齐(Jackson 命名策略)
        String customerTier,
        String recentActivity,
        String spendingLevel,
        boolean needFollowUp) {
   }

@PostMapping("/agent/customer-analysis")
public CustomerAnalysis analyze(@RequestBody AnalyzeRequest req) {

    return agentClient.invoke(req);   // Python 侧返回的 JSON 直接反序列化
}
Java 侧再叠一层 Bean Validation(@NotNull、@Pattern),就形成了双端校验:Python 保证模型输出合规,Java 保证调用方传参合规。这套组合在生产里很稳。
上线前的检查清单:
- Schema 用 Pydantic,枚举用
Literal,数值用ge/le,业务规则用field_validator; - 字段描述写全,
Field(description=...)是模型填参的唯一依据; handle_errors保持 True,除非你确实想让异常炸出来;- 提示词里给兜底:查不到、无关、超范围时输出什么,必须写明;
- 结构化要求放最后,流程步骤放前面;
- 读取时判空:
result.get("structured_response")可能为None(模型没走结构化路径),别直接下标取值。