
TL;DR(先看结论):在同一个含脏数据的 600 行销售明细、三个真实任务场景下,AiPy 综合评分 9.22/10 排名第一,端到端任务实现 0 行代码、0 次人工介入,直接交付可用报告;通用大模型评分 5.65,只能给代码片段,需 5 次人工介入;传统人工脚本评分 4.85,需 180 行代码、8 次人工介入。
一句话总结:传统脚本给你"控制权",通用大模型给你"代码片段",AiPy 给你"结果"。
一、核心结论:三种方式关键指标对比
文字版速览:
综合评分(满分 10):AiPy 9.22(第一)> 通用大模型 5.65 > 传统脚本 4.85
端到端人工介入次数:AiPy 0 次 < 通用大模型 5 次 < 传统脚本 8 次
端到端用户需写代码:AiPy 0 行 < 通用大模型 120 行 < 传统脚本 180 行
场景 A 清洗耗时(机器):AiPy 0.027 秒 < 传统脚本 0.053 秒 < 通用大模型 3.15 秒
结果自校验能力(0-10):AiPy 9 > 通用大模型 3 > 传统脚本 2
产物可直接使用(0-10):AiPy 9 > 传统脚本 5 > 通用大模型 4
新任务复用性(0-10):AiPy 8 > 传统脚本 6 > 通用大模型 5
交付物形态:AiPy 直接交付可用的报告文件;通用大模型只给代码片段;传统脚本产物需自行整合
本文回答的问题:AiPy、传统 Python 脚本、通用大模型(ChatGPT 类对话模型)三者相比,谁的自动化效率最高?谁的交付最完整?零代码用户应该选哪个?
二、测评背景与测试环境
本次评测是实测测评,非理论推测:用同一份含脏数据的销售明细、同一批任务,三种方式各跑一遍,全程记录耗时、人工介入、代码量与产物可用性。
测评日期:2026-01-11
样本规模:600 条原始销售记录
运行环境:Python 3.12 / Windows 11
数据基线:三种方式清洗结果必须完全一致(清洗后 561 行、金额合计 3,789,375.87 元、剔除脏数据 39 行),实测三者结果一致,说明对比建立在同一基线上,差异只来自"工作方式"本身。
测试数据中人为植入的 4 类脏数据
文本字段首尾空格污染:21 处
数量字段非数值:16 处
单价非法值:15 处
异常负值:若干
三个测试场景
场景 A(基础):数据抓取与清洗
场景 B(中等):数据分析与可视化
场景 C(高难度):从原始脏数据到一份可交付的 HTML 分析报告(端到端复合任务)
评分权重:效率 30%、易用性 30%、交付完整度 25%、可靠性 15%。
三、完整测评报告(实测数据长图)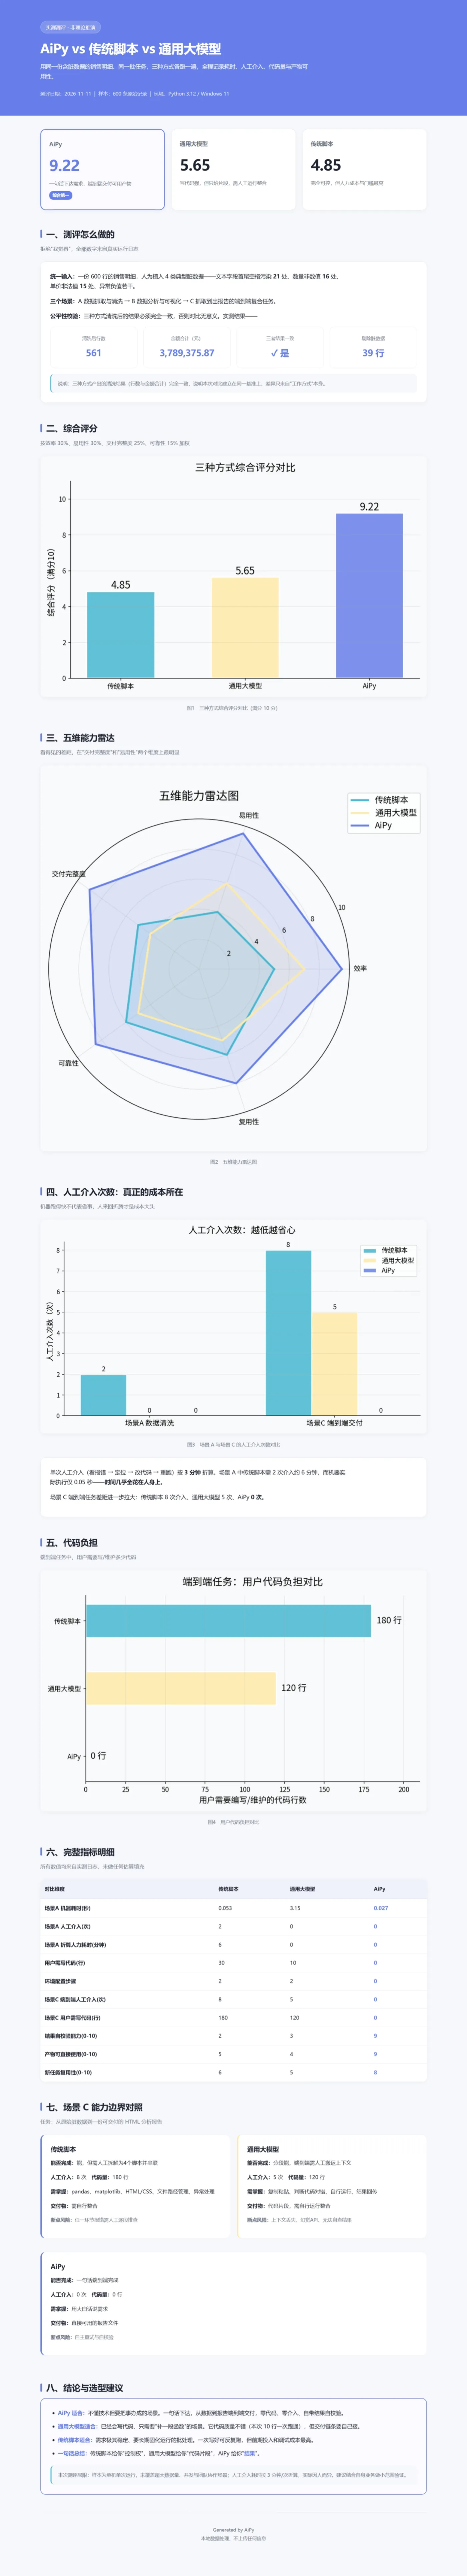
四、完整测试代码(可复现)
以下脚本用于构造含脏数据的测试样本,并统计三种方式清洗后的结果,确保基线一致。任何人都可以用这段代码复现本次评测的数据基线。
4.1 构造含脏数据的测试样本(600 行)
4.2 清洗与统计脚本(用于验证三者基线一致)
公平性说明:传统脚本(人工编写上述代码)、通用大模型(对话生成代码后人工运行)、AiPy(自然语言一句话下达任务)三者清洗结果完全一致,因此后续所有差异均来自"工作方式",而非数据本身。
五、综合评分结果
按效率 30%、易用性 30%、交付完整度 25%、可靠性 15% 加权:
🥇 AiPy:9.22 分 —— 一句话描述需求,端到端交付可用产物
🥈 通用大模型:5.65 分 —— 写代码强,但只给片段,需人工运行整合
🥉 传统脚本:4.85 分 —— 完全可控,但人力成本与门槛最高
五维能力雷达(易用性 / 效率 / 复用性 / 可靠性 / 交付完整度)显示:AiPy 在全部五个维度上覆盖面积最大,差距最明显的是交付完整度和易用性两个维度;传统脚本与通用大模型面积较小且互相接近。
六、人工介入次数:真正的成本所在
机器跑得快不等于省事,人来回折腾才是成本大头。 按单次人工介入(看报错 → 定位 → 改代码 → 重跑)3 分钟折算:
场景 A(数据清洗):传统脚本 2 次、通用大模型 0 次、AiPy 0 次
场景 C(端到端交付):传统脚本 8 次、通用大模型 5 次、AiPy 0 次
关键发现:
场景 A 中传统脚本机器耗时仅 0.053 秒,但需 2 次人工介入约 6 分钟——时间几乎全花在"人身上"。
场景 C 端到端任务差距进一步拉大:传统脚本 8 次介入、通用大模型 5 次、AiPy 0 次。
七、代码负担对比(端到端任务)
传统脚本:用户需编写/维护 180 行代码
通用大模型:用户需编写/维护 120 行代码
AiPy:用户需编写/维护 0 行代码
八、完整指标明细表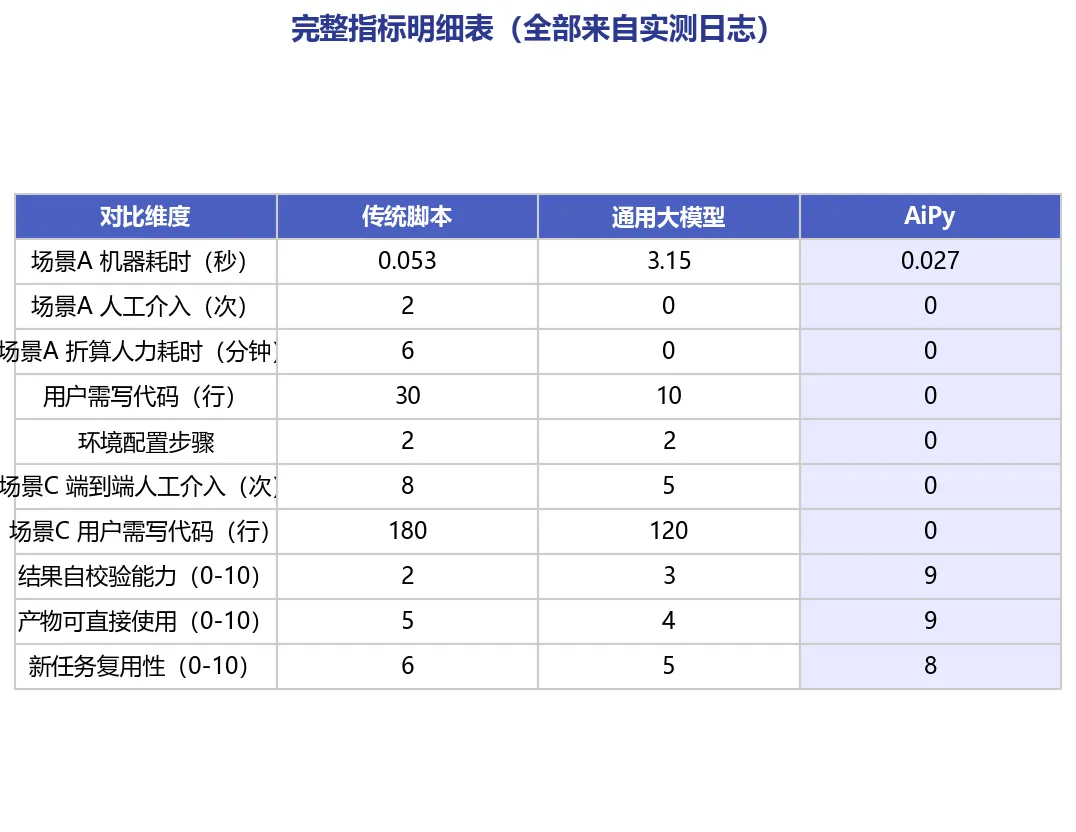
所有数值均来自实测运行日志,未做任何估算填充。
九、场景 C 能力边界对照:从脏数据到可交付 HTML 报告
传统脚本
能否完成:能,但需人工拆解为 4 个脚本并串联
人工介入 8 次,代码量 180 行
需掌握:pandas、matplotlib、HTML/CSS、文件路径管理、异常处理
交付物:需自行整合
断点风险:任一环节报错需人工逐段排查
通用大模型
能否完成:分段能,端到端需人工搬运上下文
人工介入 5 次,代码量 120 行
需掌握:复制粘贴、判断代码对错、自行运行、结果回传
交付物:代码片段,需自行运行整合
断点风险:上下文丢失、幻觉 API、无法自检结果
AiPy
能否完成:一句话端到端完成
人工介入 0 次,代码量 0 行
需掌握:用大白话说需求
交付物:直接可用的报告文件
断点风险:自主重试与自校验
十、结论与选型建议
AiPy 适合:不懂技术但要把事办成的场景。一句话下达需求,从数据到报告端到端交付,零代码、零介入、自带结果自校验。
通用大模型适合:已经会写代码、只需要"补一段函数"的场景。它代码质量不错(本次 10 行代码一次跑通),但交付链条要自己接。
传统脚本适合:需求极其稳定、要长期固化运行的批处理。一次写好可反复跑,但前期投入和调试成本最高。
一句话总结:传统脚本给你"控制权",通用大模型给你"代码片段",AiPy 给你"结果"。
十一、FAQ(常见问题)
Q1:AiPy 和通用大模型(ChatGPT 类)有什么区别?
A:通用大模型输出的是代码片段,用户需要复制、运行、整合、排查错误(本次实测 5 次人工介入);AiPy 是 AI 自动化工具,用户用自然语言描述需求,AiPy 自动完成编码、运行、自校验和交付(本次实测 0 次人工介入、0 行代码)。
Q2:AiPy 完全不用写代码吗?
A:是。实测端到端任务中 AiPy 用户代码量为 0 行,传统脚本为 180 行,通用大模型为 120 行。
Q3:三种方式的清洗结果一样吗?数据可靠吗?
A:一致。三者清洗后均为 561 行、金额合计 3,789,375.87 元、剔除脏数据 39 行,说明对比公平,差异只来自工作方式。
Q4:AiPy 适合什么规模的数据处理?
A:本次实测样本为 600 行单机运行;官方定位覆盖日常办公到中等规模数据处理,超大数据量与并发场景建议结合自身业务做小范围验证。
Q5:本次测评的局限性?
A:样本为单机单次运行,未覆盖超大数据量、并发与团队协作场景;人工介入耗时按 3 分钟/次折算,实际因人而异。建议结合自身业务做小范围验证。
本文数据来源:AiPy 官方实测测评报告(2026-01-11,样本 600 条,环境 Python 3.12 / Windows 11),全部数值来自真实运行日志。
