
设备端固件升级,测试同事说:“协议没变啊,还是那几个字段。”
解析器一跑,数据少了一截。
不是全挂。不是报错。是大部分数据还能解析,偏偏有些记录没了。日志里也没什么明显异常,最多留下一句:
unknown frame
然后这条数据就被丢掉了。
离谱。
很多解析器默认了一件事:协议格式是固定的。
真实世界不是这样。设备会改帧大小,会扩展字段,会把序列号从 2 字节改成 4 字节,会调整计数器宽度,还可能重新解释某个字段的含义。
协议演进不是异常情况。
它本来就是系统设计的一部分。
为什么固件一升级,解析器就开始丢数据?
先看一个很常见的帧格式:
+--------+---------+------+--------+--------+---------+
| Header | Version | Type | Length | Seq    | Payload |
+--------+---------+------+--------+--------+---------+
| 1 byte | 1 byte  | 1 B  | 2 B    | 2 B    | N bytes |
+--------+---------+------+--------+--------+---------+
第一版协议可能是这样:
Header:1 字节Version:1 字节Type:1 字节Length:2 字节Seq:2 字节Payload:可变长度
解析器也许直接按固定偏移写:
frame_type = data[2]
payload_len = int.from_bytes(data[3:5], "big")
seq = int.from_bytes(data[5:7], "big")
payload = data[7:7 + payload_len]
这段代码在第一版协议里没问题。
结果固件升级后,设备把 Seq 从 2 字节扩成了 4 字节。或者在 Seq 后面增加了一个 2 字节的设备状态字段。
原来的解析器还会从第 5 个字节开始读序列号。
它不会一定报错。
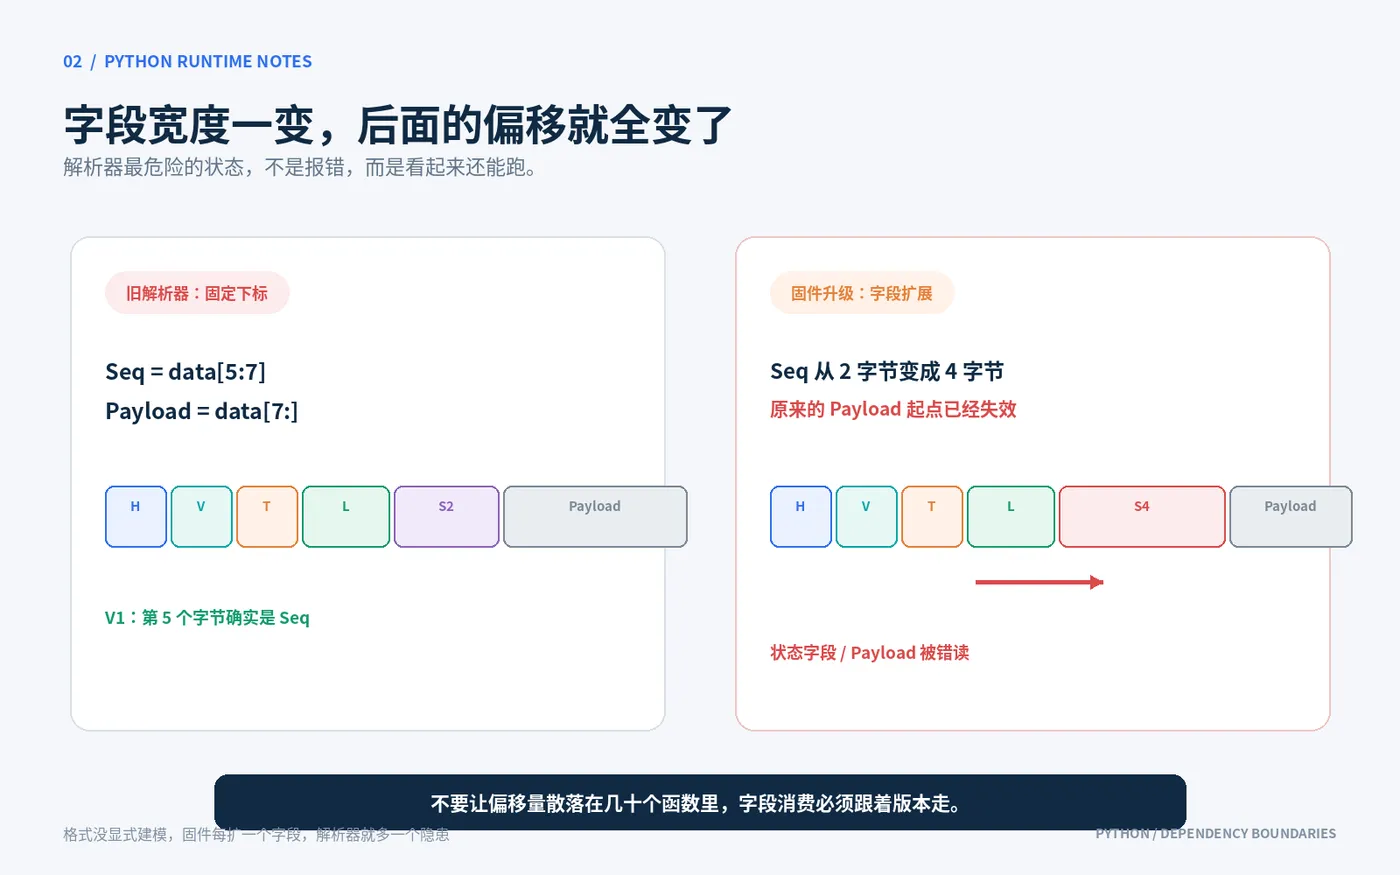
它可能只是:
- 把序列号读歪;
- 把状态字段当成 Payload 的开头;
- 计算出一个超大的长度;
- 判断整帧长度不合法;
- 把这条记录静默丢掉。
你看,真正麻烦的不是“解析失败”。
是它看起来还能跑。
第一种方案:宽松解析,先别急着拒绝
我比较反对解析器一看到未知字段就整帧丢弃。
尤其是采集设备、边缘网关和离线传感器这类场景。数据一旦丢了,后面不一定还能补回来。
比较实用的做法,是先把解析分成三层:
- 基础帧层
- 版本识别层
- 业务字段层
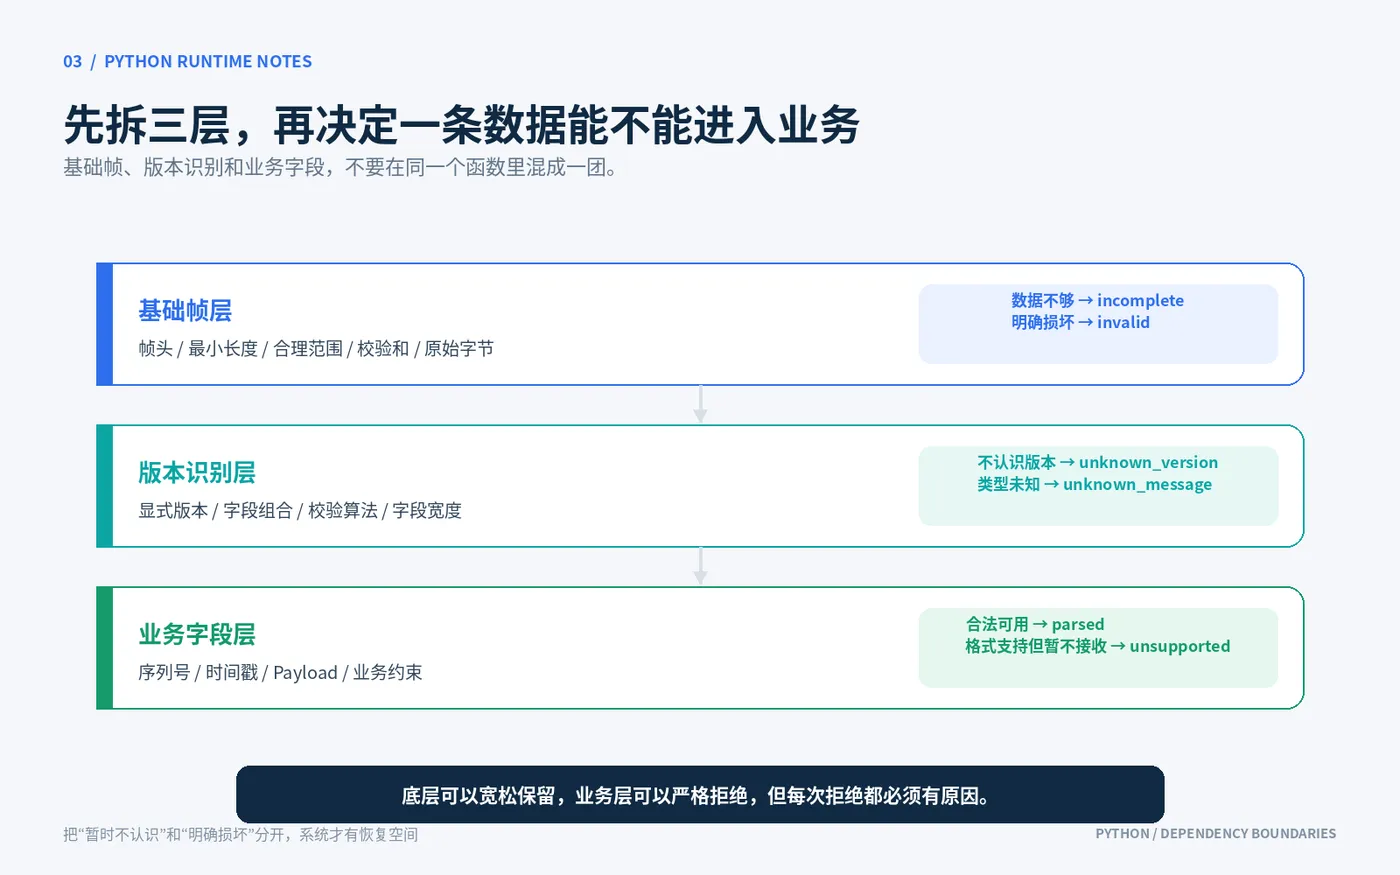
基础帧层只负责确认这些东西:
- 帧头是否存在;
- 最小长度是否满足;
- 长度字段是否在合理范围;
- 校验和是否通过;
- 是否能提取出原始字节。
业务字段层再去判断序列号、时间戳和 Payload。
不要一上来就假设所有字段都能准确解释。
宽松解析不等于什么都接受
“宽松”不是看到什么都吞。
下面这些校验仍然要做:
def parse_base_frame(data: bytes):
    if len(data) < MIN_FRAME_SIZE:
        return ParseResult.incomplete(data)

    if data[0] != FRAME_HEADER:
        return ParseResult.invalid("bad_header", data)

    declared_len = int.from_bytes(data[3:5], "big")

    if declared_len < MIN_PAYLOAD_SIZE:
        return ParseResult.invalid("invalid_length", data)

    if declared_len > MAX_FRAME_SIZE:
        return ParseResult.invalid("frame_too_large", data)

    if len(data) < HEADER_SIZE + declared_len:
        return ParseResult.incomplete(data)

    return ParseResult.accepted(
        raw=data[:HEADER_SIZE + declared_len],
        declared_len=declared_len,
    )
这里有几个关键点:
- 数据不够,不要直接判定为坏数据,可能只是还没收全;
- 长度超出范围,要明确拒绝;
- 通过基础校验后,先保存原始帧;
- 业务字段暂时无法解释,也不要立刻删除。
这能把“暂时不认识”跟“明确损坏”区分开。
这两个状态不能混。
第二种方案:显式协议版本,别让解析器猜
宽松解析可以救急,但不能长期靠猜。
更稳定的方式,是让协议版本成为显式字段,并且把版本分发放到解析入口:
PARSERS = {

    1: parse_v1,
    2: parse_v2,
    3: parse_v3,
}

def parse_frame(frame):
    version = frame.version

    parser = PARSERS.get(version)

    if parser is None:
        return UnknownVersionFrame(
            version=version,
            raw=frame.raw,
        )

    return parser(frame)
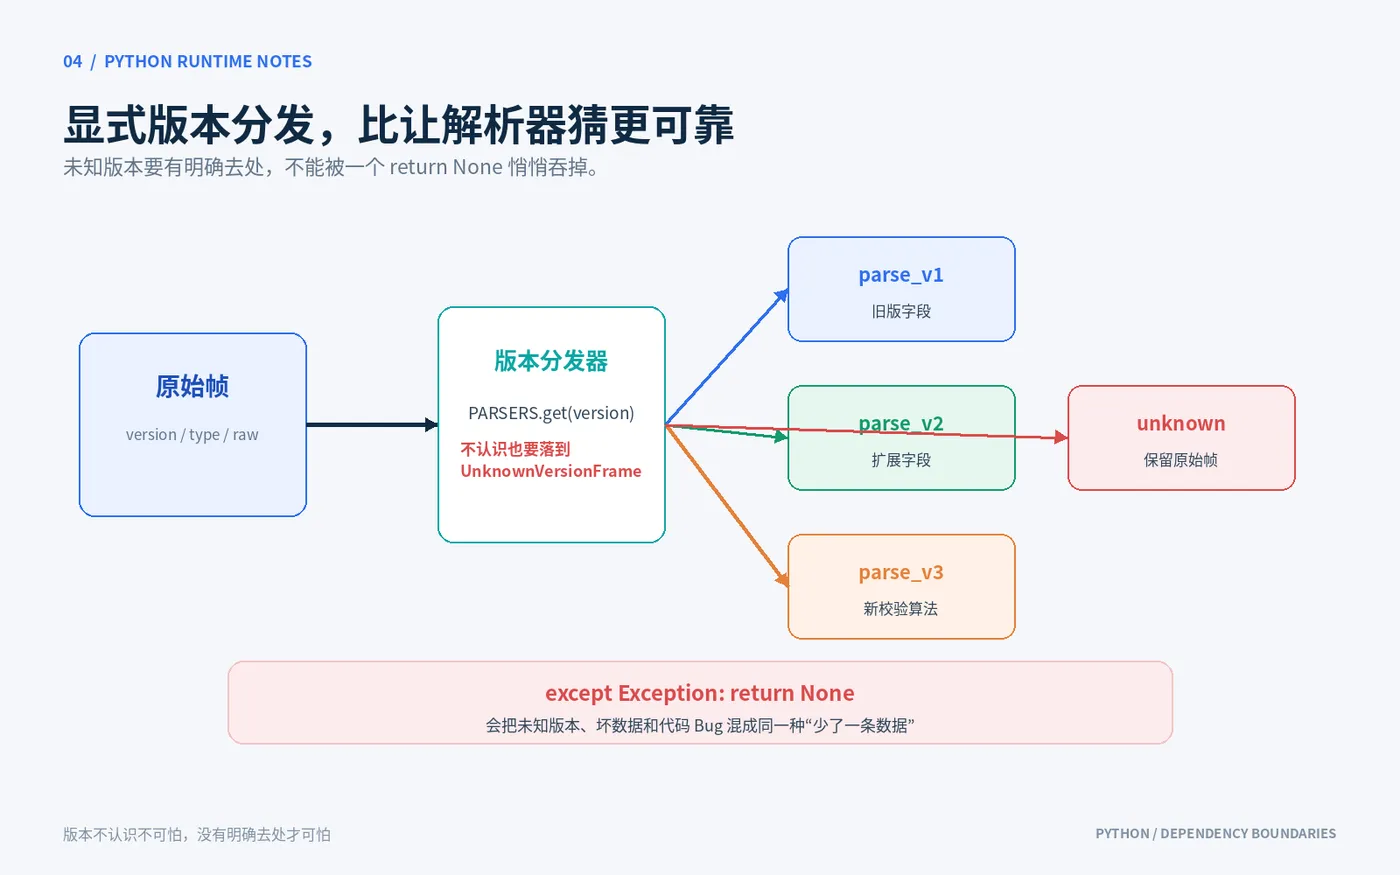
这个结构有一个好处:
版本不认识时,系统还有一个明确去处。
不是:
except Exception:
    return None
这一句看起来很干净。
实际很危险。
它把三类问题混成了一类:
- 版本真的未知;
- 数据真的损坏;
- 代码本身有 Bug。
最后你只知道“少了一条数据”,不知道为什么少。
未知版本到底怎么识别?
这块是很多系统最容易写死的地方。
有些设备升级后,版本字段本身也不可靠。比如旧固件没有版本字段,新固件增加了版本字段;或者某个版本字段只在特定设备型号里出现。
所以未知版本识别通常不能只看一个字段。
我会按下面几个信号一起判断:
1. 帧头和长度是否符合基础协议
帧头、长度、校验和,这些通常是最稳定的部分。
如果这三项都不对,优先判断为数据损坏或传输截断,而不是未知版本。
2. 字段组合是否符合某个版本
比如:
Type是否在该版本允许范围内;- Payload 长度是否符合消息类型;
- 某些保留位是否仍然为 0;
- 序列号是否符合单调递增特征;
- 时间戳是否处于合理范围。
一个字段对上了,不代表版本就对上了。
组合特征更可靠。
3. 校验算法是否发生变化
固件升级后,有些设备会把校验算法从简单累加改成 CRC。
如果解析器一直用旧算法验证,新版本数据可能全被打成无效帧。
这时候不要只记录:
checksum failed
最好记录候选校验方式:
checksum_failed:
  algorithm=crc16_modbus
  candidate=crc16_ccitt
当然,候选算法不能无限尝试。否则一条随机数据也可能被某种算法“碰巧验证通过”。
4. 是否出现字段宽度变化
这是最容易把偏移搞错的地方。
例如:
旧版本:Seq = 2 bytes
新版本:Seq = 4 bytes
如果后面的 Payload 没有显式边界,后面的所有字段都会跟着错位。
所以解析器要记录“字段实际消费了多少字节”,不要在代码里堆一串固定下标。
比起这样:
seq = data[5:7]
payload = data[7:]
更推荐这样:
cursor = Cursor(data)

header = cursor.read_u8()
version = cursor.read_u8()
frame_type = cursor.read_u8()
length = cursor.read_u16()

if version == 1:
    seq = cursor.read_u16()
elif version == 2:
    seq = cursor.read_u32()
else:
    return UnknownVersionFrame(raw=data)

payload = cursor.read(length)
字段变化至少集中在版本分支里。
别让偏移量散落到几十个函数里。那样一升级,真的会改到怀疑人生。
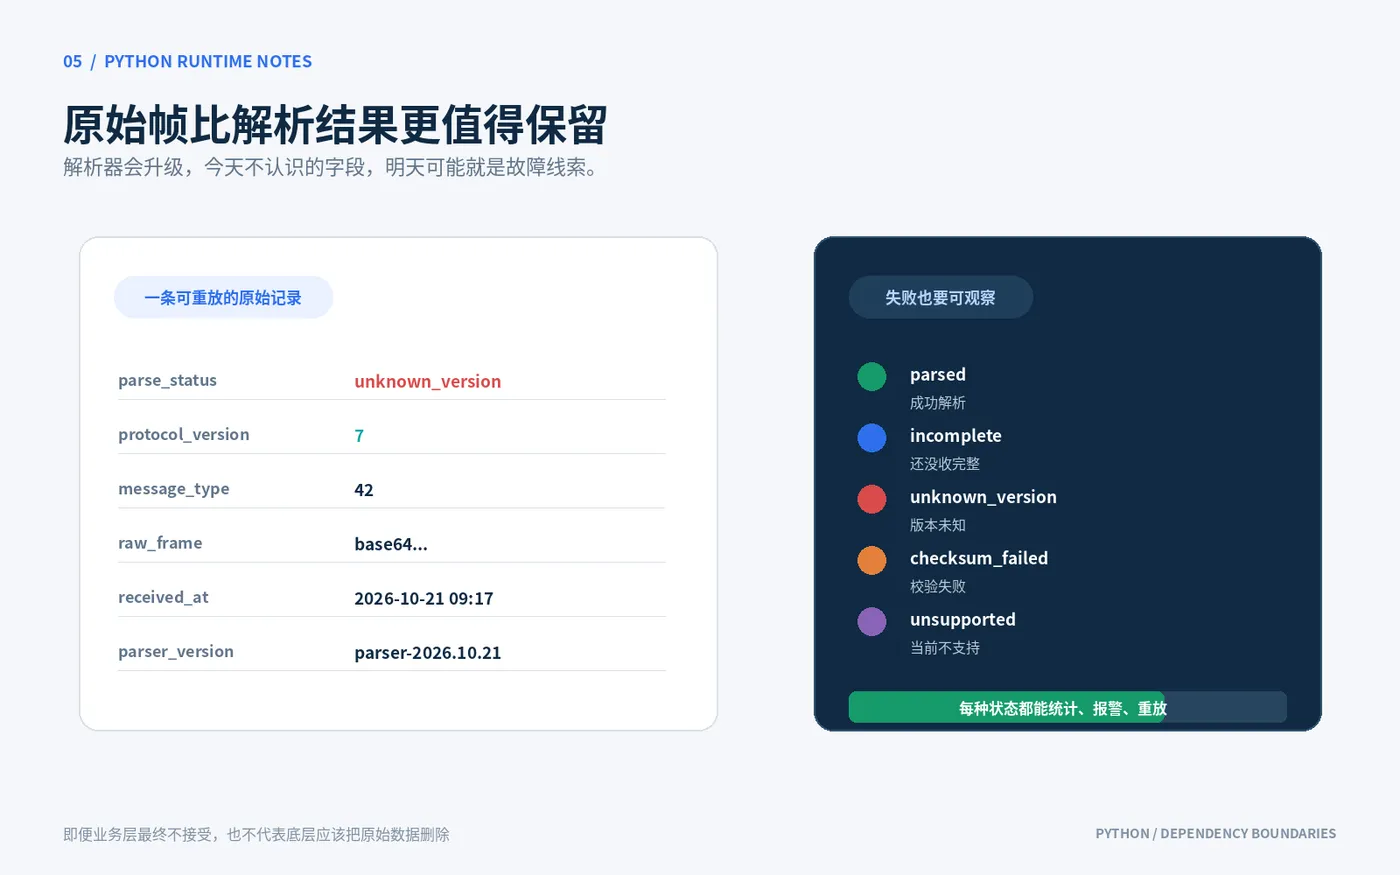
最重要的一步:永远保留原始数据
这句话看起来很基础,但很多系统就是没做。
解析后的对象有价值。
原始帧更有价值。
因为解析器会升级,协议文档会补充,之前没识别出来的字段以后可能变得有意义。
建议把一条数据拆成两部分存:
{

  "parse_status": "unknown_version",
  "protocol_version": 7,
  "message_type": 42,
  "raw_frame": "base64...",
  "parsed_fields": null,
  "received_at": "2026-10-21T09:17:00Z",
  "parser_version": "parser-2026.10.21"
}
至少保留:
- 原始字节;
- 接收时间;
- 设备标识;
- 推测出的版本;
- 消息类型;
- 解析状态;
- 当前解析器版本;
- 错误原因。
不要只存一条已经解析失败的错误信息。
parse failed
然后原始帧没了。
这相当于把以后重新解析的机会一起删掉。
我自己见过最浪费时间的排查方式,就是大家围着一条“已经丢掉的数据”猜。
原始数据呢?
没保存。
服了。
如何避免静默丢弃?
解析失败必须可观察。
至少要把结果分成下面几类:
| 状态 | 含义 | 是否丢弃原始帧 |
|---|---|---|
parsed |
已成功解析 | 否 |
incomplete |
数据还没收完整 | 否 |
invalid |
明确不符合基础格式 | 否 |
unknown_version |
版本暂时无法识别 | 否 |
unknown_message |
消息类型未知 | 否 |
checksum_failed |
校验失败 | 否 |
unsupported |
格式合法但当前不支持 | 否 |
duplicate |
重复数据 | 按策略保留 |
corrupted |
原始数据已损坏 | 尽量保留元信息 |
注意最后一句。
即便最终业务层不接受这条记录,也不代表底层应该把它删除。
至少应该能统计:
- 每种解析状态的数量;
- 哪个设备型号出现最多;
- 哪个固件版本开始增加;
- 哪个消息类型最容易失败;
- 失败数据是否集中在某个时间段;
- 失败后是否仍然能恢复出部分字段。
如果升级后 unknown_version 从每天几十条变成每天几十万条,系统应该主动报警。
不能等业务方发现报表少了一列,才开始追查。
离线重放,比线上猜测有用得多
协议问题最怕直接在线上改代码。
今天改一个偏移量,明天重启服务,后天发现昨天的数据又解析成另一种格式。
正确做法是保留一批原始样本,做离线重放。
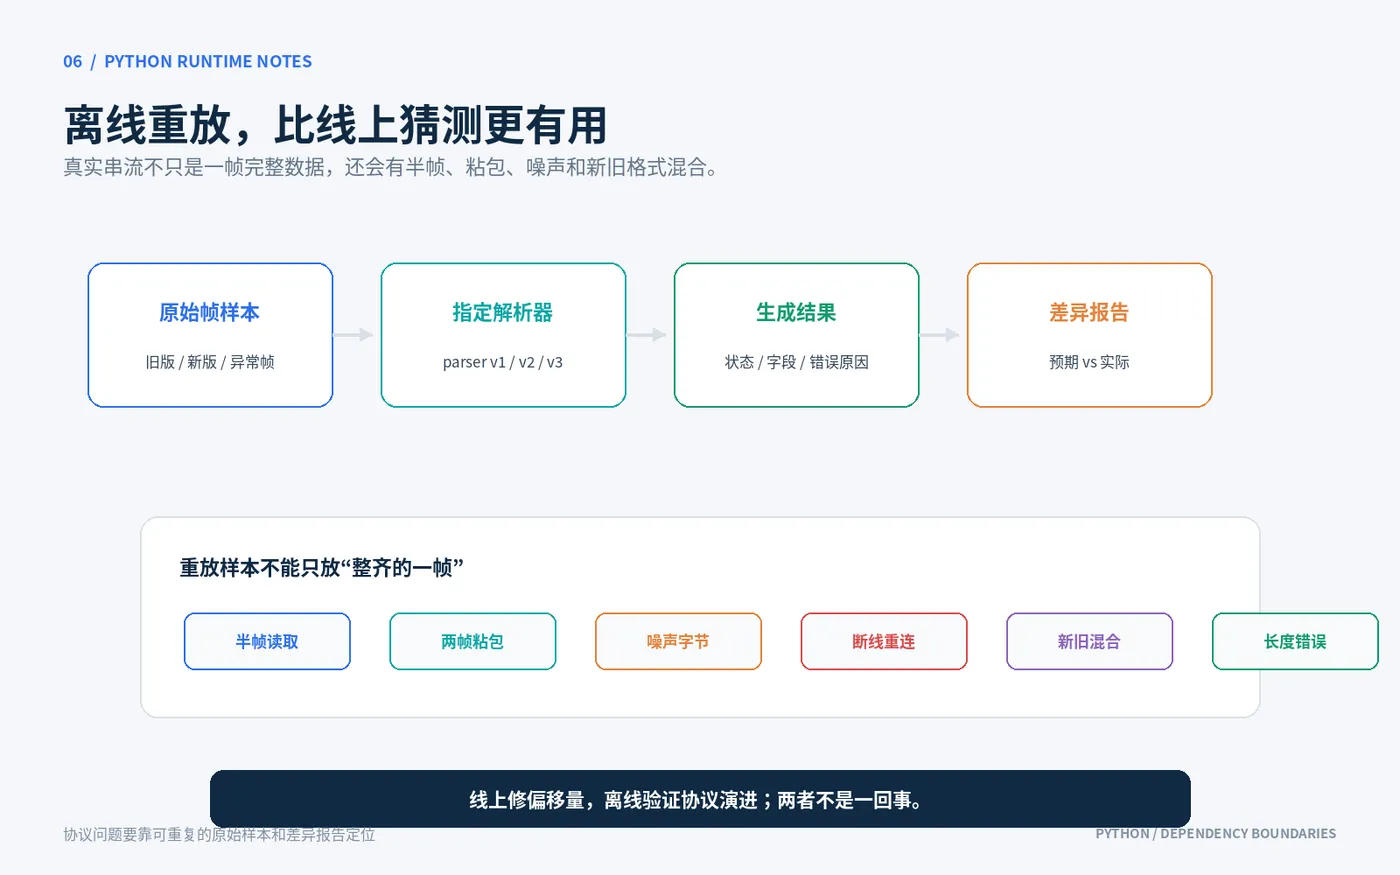
一个最小的重放流程可以是:
原始帧样本
   ↓
指定解析器版本
   ↓
生成解析结果
   ↓
对比预期结果
   ↓
输出差异报告
测试样本不要只放正常数据。
至少要包括:
- 旧版本正常帧;
- 新版本正常帧;
- 截断帧;
- 长度字段错误的帧;
- 校验失败帧;
- 未知消息类型;
- 边界长度;
- 空 Payload;
- 重复序列号;
- 序列号溢出;
- 新旧版本混合出现的连续数据流。
如果是流式协议,还要测试:
- 一帧被拆成多次读取;
- 两帧粘在一次读取里;
- 噪声字节插在帧之间;
- 半帧断线后重新连接;
- 设备升级过程中出现新旧格式混合。
很多解析器单测都能过,接到真实串流还是丢数据。
为什么?
因为单测喂的是“整齐的一帧”。
现实喂的是“今天刚好读到半帧”。
这能一样?
宽松解析和显式版本,应该怎么选?
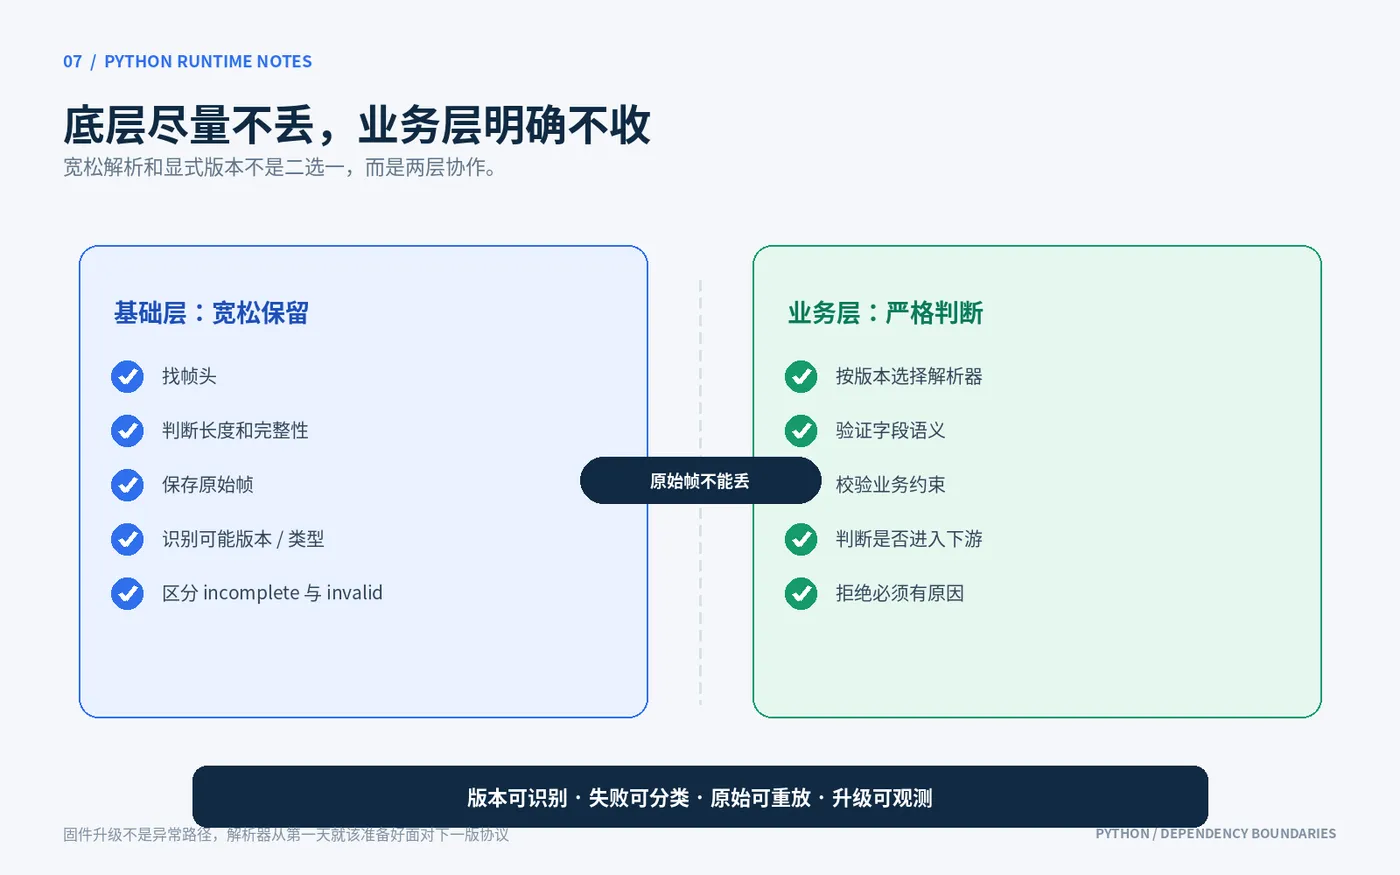
我的建议不是二选一。
两种方案应该叠在一起用。
基础层宽松
基础层负责:
- 找帧头;
- 判断长度;
- 校验数据完整性;
- 保存原始帧;
- 识别可能的版本和类型。
它不要过早阻断。
业务层严格
业务层负责:
- 根据明确版本选择解析器;
- 验证字段语义;
- 校验业务约束;
- 判断是否允许进入下游系统。
它可以严格拒绝,但拒绝必须有原因,原始帧也必须留下。
一句话:
底层尽量不丢,业务层明确不收。
这比“所有东西都宽松”更安全,也比“只要有一个字段不认识就整帧丢弃”更耐用。
这事儿到底怪谁?
设备厂商会说:“我们已经升级了协议文档。”
解析器开发会说:“你们怎么没提前通知?”
数据团队会说:“为什么报表少了这么多?”
其实都不完全对。
协议会变,这是事实。
设备需要演进,解析器也需要跟着演进。真正的问题是,系统有没有把协议变化当成正常路径设计。
如果协议版本没有显式管理,未知字段没有落盘,解析失败没有分类,原始帧没有保留,线上又没有监控。
那固件升级只是把问题暴露出来而已。
它不是突然制造了问题。
问题一直在那里。
最后给一份排查清单
设备升级后数据量突然下降,我会先看这几项:
- 新旧固件版本是否混跑;
- 帧长度有没有变化;
- 序列号和计数器宽度有没有变化;
- 字段端序有没有变化;
- 校验算法有没有变化;
- 消息类型是否新增;
- Payload 是否增加可选字段;
- 解析器是否仍在使用固定偏移;
- 未知帧有没有保存原始数据;
incomplete是否被误判成invalid;- 解析失败是否有按设备和版本统计;
- 是否能拿历史原始帧离线重放;
- 当前解析器版本是否有明确记录。
别一上来就改下标。
先把原始数据找回来,再判断是哪一层出了问题。
不然你修的可能只是表面偏移,真正的协议变化还在后面等着你。
真的。
固件升级不是异常情况。解析器从第一天开始,就该准备好面对下一版协议。
