
上周三晚上十点半,我在群里看到老周转的截图——他的电商库要从自建机房搬到云上 RDS,运维方案写得很豪迈:「周五晚上 22:00 停服,mysqldump 导出,预计 6 小时后恢复。」
我问了一句:这 6 小时里,用户下单怎么办?
他回:公告啊,说系统升级。
一个日均两千单的站,半夜到早上六点,损失的订单加客诉,比一年数据库的钱都多。更要命的是,他那个库 80 多个 G,带十来张千万级大表,mysqldump 跑起来连 IO 都不一定扛得住,6 小时是拍脑袋写的,真跑起来可能 10 小时。
后来他没用停服方案,改成了全量搬一次、增量一直追、最后只停几秒钟切连接串的路子。下面这套东西,就是那次折腾下来攒的。
先说清楚 DTS 到底在干什么
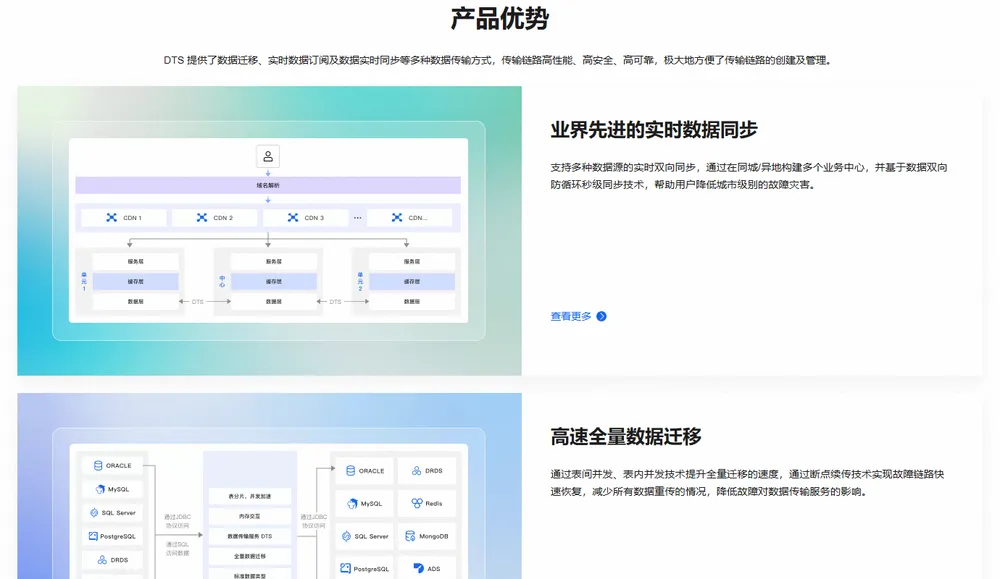
DTS(数据传输服务)听着玄,说白了就三件事:
- 数据迁移:把源库的结构和数据整批搬到目标库,一次性的,搬完这事就结束了;
- 数据同步:两个库之间长期保持同步,可以单向也可以双向,适合多活和容灾;
- 数据订阅:把源库的变更日志变成一条条消息流推出来,缓存失效、审计、下游同步都靠它。
迁移类的任务分三段:结构迁移 → 全量迁移 → 增量迁移。前两段是「搬家」,第三段是「搬家期间新长出来的东西也一并搬过去」。三段全开,业务才能真正不停机——官方页面上写的性能指标是全量迁移最高 100MB/s、增量同步最高 8 万 RPS,实际跑多少看你源库的 IO 和网络,别拿这个当承诺值。
八个坑,按踩到的先后顺序
坑一:预检查点了「跳过」,然后在半夜两点被叫起来
DTS 建任务时会自动跑一遍预检查,很多人看它慢就直接跳过,等任务启动失败了再回头查。这一步必须让它跑完,因为真正卡人的都是它查出来的那几项:
- 源库的
binlog_format必须是ROW,binlog_row_image必须是FULL。不满足的话,增量迁移连启动都会失败,不是慢,是起不来; - 迁移账号需要复制权限(读 binlog 的权限),只给个
SELECT是不够的; - 源库和目标库的 MySQL 版本差异、字符集、时区,都要对一遍。
这三项在预检查里都是明码标红的,认真看一眼,能省掉一晚上的睡眠。
坑二:binlog 保留时间没调,全量还没跑完,日志已经被清了
这是最容易忽略的一条,也是最阴的一条。
增量迁移要靠源库的 binlog 一条条往下追。而源库的 binlog 是有过期时间的,默认可能只留几天;如果全量迁移数据量大、跑得慢,等你全量跑完准备追增量的时候,最早那批 binlog 已经过期删掉了——增量接不上,任务直接失败。
官方文档里的要求是:只做增量迁移,源库本地 binlog 保留 24 小时以上;全量加增量一起做,至少保留 7 天。而且 DTS 自己本地只循环缓存源库近 24 小时或 50GB 的日志,超过就清,指望它替你兜底不现实。
所以开跑之前先去源库把 binlog 保留时间拉长,等任务稳定了再调回来。
坑三:表没有主键,目标库悄悄多出一堆重复数据
官方限制写得很克制:「待迁移的表需具备主键或唯一约束,否则可能会导致目标库出现重复数据」。
「可能导致」这四个字,翻译过来就是:全量迁移是并发 INSERT,没有主键兜底,同一条记录插两遍没人拦你;增量阶段也一样,定位不到唯一行,更新就变成了新增。
搬之前把库里所有无主键表拉出来数一遍。有业务意义的补上主键或唯一索引,纯日志型的表考虑干脆不迁、留档。这一步花半小时,能省掉后面查数据对不上的三天。
坑四:全量迁移跑到一半,有人手滑执行了 ALTER TABLE
结构迁移和全量迁移这两个阶段,官方明确要求不要在源库做 DDL。哪怕加个索引看起来人畜无害,也可能让整个任务失败,然后你得从头再来一遍——大库重跑一次,等于又是一个通宵。
规矩很简单:迁移窗口期,所有发布、所有建表、所有加字段,全部冻结。别只通知 DBA,得通知到写代码的人。
顺带说一句增量阶段的 DDL:这块能力是有前提和限制的,别默认「它会自动同步」。比较稳的做法是先在目标库手动执行、再在源库执行同样的语句,两边对齐了再让业务往下走。
坑五:外键级联和浮点精度,属于「不报错但数据不对」那一类
DTS 在全量和增量过程中,会以会话级别暂时禁用约束检查和外键级联操作。这意味着源库上一条 ON DELETE CASCADE 能带走的子表数据,迁移期间可能带不走;源库上的级联更新同理。搬完核对的时候发现子表多了一堆孤儿行,别怀疑人生,就是这个原因。
第二个是精度:FLOAT 和 DOUBLE 类型的列,DTS 会按 ROUND(COLUMN, PRECISION) 的方式读取,精度是否符合你的业务预期,要提前确认。金额字段这类老实说就不该用浮点,但如果老库已经用了,搬之前先做一轮样本比对。
坑六:切换顺序错,最后几分钟的订单没了
这个是流程问题,不是产品问题,但死的人最多。
常见的错误顺序是:业务先改连接串指向新库,然后回头再看增量延迟——这时候延迟可能还有几十秒,这几十秒里写进老库的数据,新库根本没收到。
正确的顺序只有一条线:
- 让增量延迟追到接近 0,稳定观察一段时间;
- 业务侧短暂停写(几十秒到几分钟),别停读;
- 确认延迟为 0,跑一次数据校验;
- 改连接串、重启应用、开写;
- 观察一段时间没问题,再停掉迁移任务。
停写的窗口能压到多短,取决于前四步准备得多细。老周那次最后停了 40 秒,比原计划的 6 小时体面太多。
坑七:迁完不校验就宣布成功,一周后对账才发现少了行
DTS 有数据校验的任务类型,可以在迁移后对源和目标做全量或抽样的行数、内容比对。很多人嫌它慢、嫌它占资源,直接跳过,然后在一周后的财务对账上翻车。
校验这件事,宁可慢一点。真出问题时,知道「哪张表、哪几行」和只知道「总数不对」,排查成本差着一个数量级。
坑八:任务跑完忘了停,账单按月小时往上加
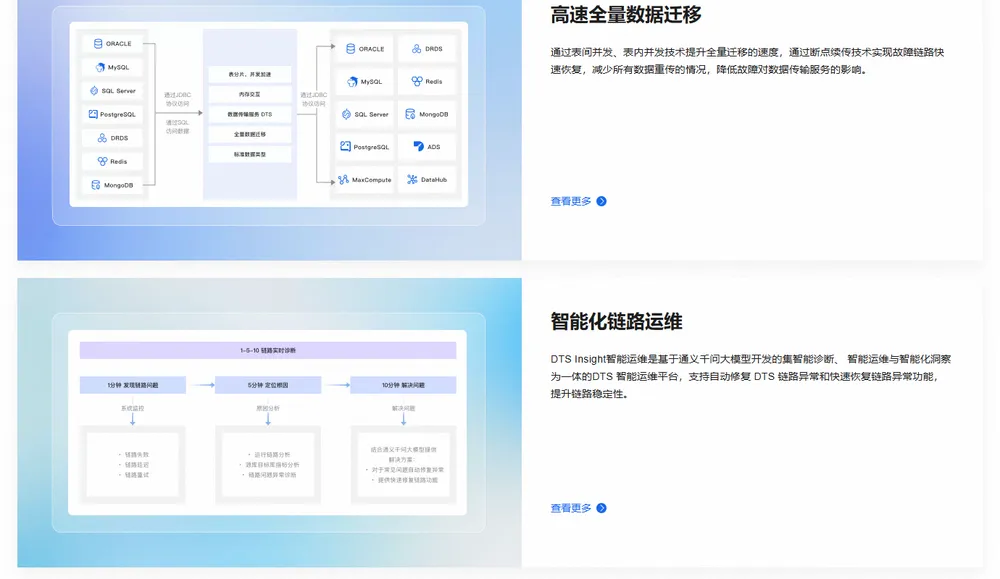
DTS 是按链路规格加运行时长计费的,不是买断。数据同步的链路常年挂着,费用就常年挂着;迁移任务切完流量、校验完,就该把它停掉或释放。
官方页面上现在能看到一些规格的折扣价,比如 micro 规格的数据同步链路按小时计价、双向同步的 medium 规格按月有明确的起步价,具体数字以官方页面实时展示为准,而且活动一直在变。我想提醒的是计费口径:它按时间算,不按数据量算,跑完不收工,等于给云厂商捐款。
一张表,把迁移当天的时间线钉死
| 时间点 | 要做的事 | 谁负责 |
|---|---|---|
| T-3 天 | 拉无主键表清单、补主键;确认字符集/时区;版本对齐评估 | DBA |
| T-1 天 | 调大源库 binlog 保留时间(≥7 天);建 DTS 任务跑预检查;全量试跑一次估时 | DBA |
| T-0 上午 | 通知全员冻结 DDL 与发布;确认目标库空间充足(要比源库大,全量并发写入会产生碎片) | 运维 + 研发 |
| T-0 低峰 | 启动全量 + 增量,盯延迟曲线;别在源库跑大查询抢 IO | DBA |
| 切换前 30 分 | 延迟追平、稳定观察;准备回滚方案(老库保持可写可读) | DBA |
| 切换 | 停写 → 确认延迟归零 → 校验 → 改连接串 → 开写 | 运维 + 研发 |
| T+1 | 校验报告归档;停任务释放链路;binlog 保留时间调回 | DBA |
还有两个容易被忽略的上限:单次表级迁移任务最多支持 1000 张表,超了要么拆任务、要么按整库迁移;MySQL 8.0.23 之后如果表里有不可见的隐藏列,可能会因为取不到该列而丢数据,搬之前先把这些列设成可见。这些都是文档里写着、但没人在动手前翻的那几页。
最后说句实在话
数据库迁移这件事,技术难度其实不高——DTS 把脏活都包了,点几下就能出一条链路。真正让人栽跟头的,全是「准备阶段偷的懒」和「切换阶段抢的那几分钟」。
停服六小时不叫稳妥,叫把风险转移给用户;不停机也不叫激进,前提是你把上面这八件事一条条对完了。真要动手,建议把 DTS 的产品页和帮助中心的限制说明并排打开看一遍,比我在这儿念叨管用:
老周那个库最后是周三凌晨两点切完的,他自己盯的延迟曲线,切换窗口 40 秒,第二天早上照常发货。他后来在群里说了句话我记到现在:搬库这活儿,功劳不在切得多快,在于没人发现你切过。
