摘要:
LOAD DATA是 Hive 最常用也最容易被误用的数据入库方式。本文结合官方语法与实战案例,讲清LOCAL与集群路径的本质区别——本地加载是「复制」、集群加载是「移动」,并梳理文件位置、速度、源文件去留等关键差异,附 5 个高频避坑点与 LOAD 和 INSERT 的选型建议。
关键词:Hive LOAD DATA, LOAD DATA LOCAL INPATH, HDFS 加载, 数据入库, 复制 vs 移动, Hive DML, beeline
在 Hive 里,数据操作语言(DML)主要就是 LOAD 和 INSERT 两类——数仓场景下并不鼓励 UPDATE/DELETE。其中 LOAD DATA 是日常把文件搬进表最顺手的方式:一行命令,数据就进表了。但很多人在用的时候,其实没搞清「本地加载」和「集群加载」到底差在哪,结果要么源文件神秘消失,要么把文件放错了机器。
这篇就用 Notion 里整理的真实案例,把 LOAD DATA 的语法、语义和坑一次讲透。
一、语法与三个关键参数
LOAD DATA 的完整语法并不长:
LOAD DATA [LOCAL] INPATH 'filepath' [OVERWRITE] INTO TABLE tablename [PARTITION (partcol1=val1, partcol2=val2 ...)]
方括号里的都是可选,但每一个都有讲究:
- LOCAL:指定它,表示加载的是 Hive 服务端本地文件;不指定,表示加载的是 HDFS 上的文件。这是整条语句最关键的区别,下文单独展开。
- OVERWRITE:加了它,会先清空目标表(或分区)再写入;不加则追加。
- PARTITION:把数据直接加载到指定分区,仅对分区表有效。
二、核心:本地加载是「复制」,集群加载是「移动」
这是 LOAD DATA 最容易被忽略、也最影响结果的一点。Hive 在处理两种路径时,底层动作完全不同:
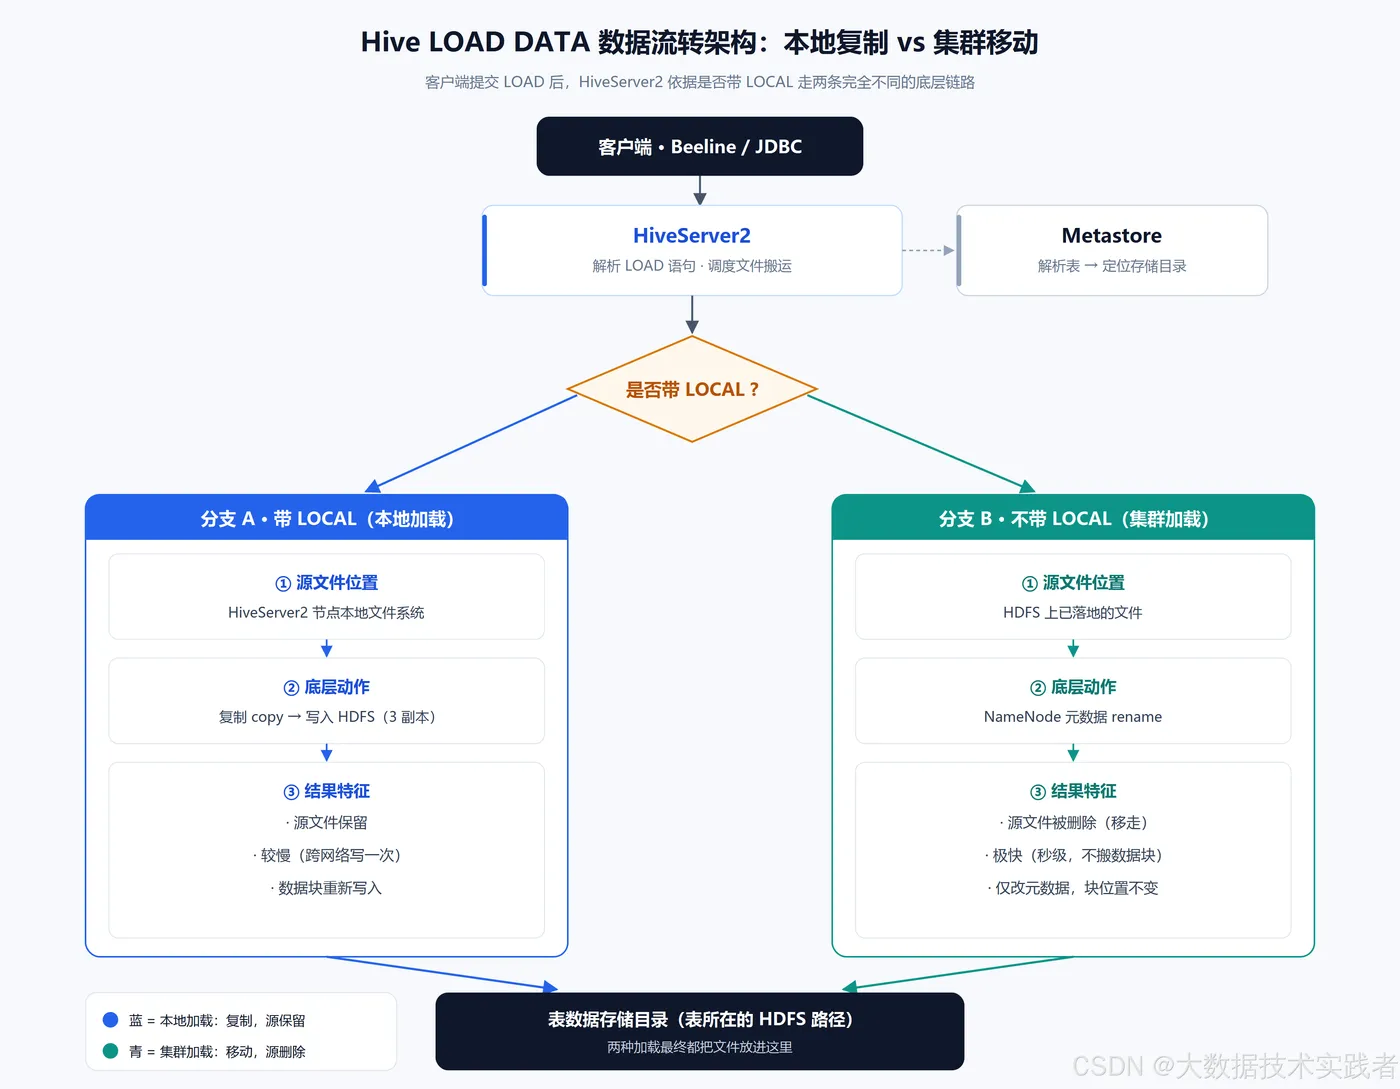
不带 LOCAL(集群路径):filepath 是 HDFS 路径。Hive 只是让 NameNode 把文件做一次元数据层面的重命名(rename/mv),把它挪到表对应的存储目录。数据块根本不发生迁移,也不会产生新副本,所以通常是秒级完成;代价是——源路径上的文件被「搬走」了,原位置不再有它。
带 LOCAL(本地路径):filepath 是 HiveServer2 所在节点的本地文件系统路径。Hive 会把这个文件复制到表的 HDFS 存储目录(写入时照常生成 3 副本),源文件保留在本地。因为要走网络写一次 HDFS,所以比集群加载慢。
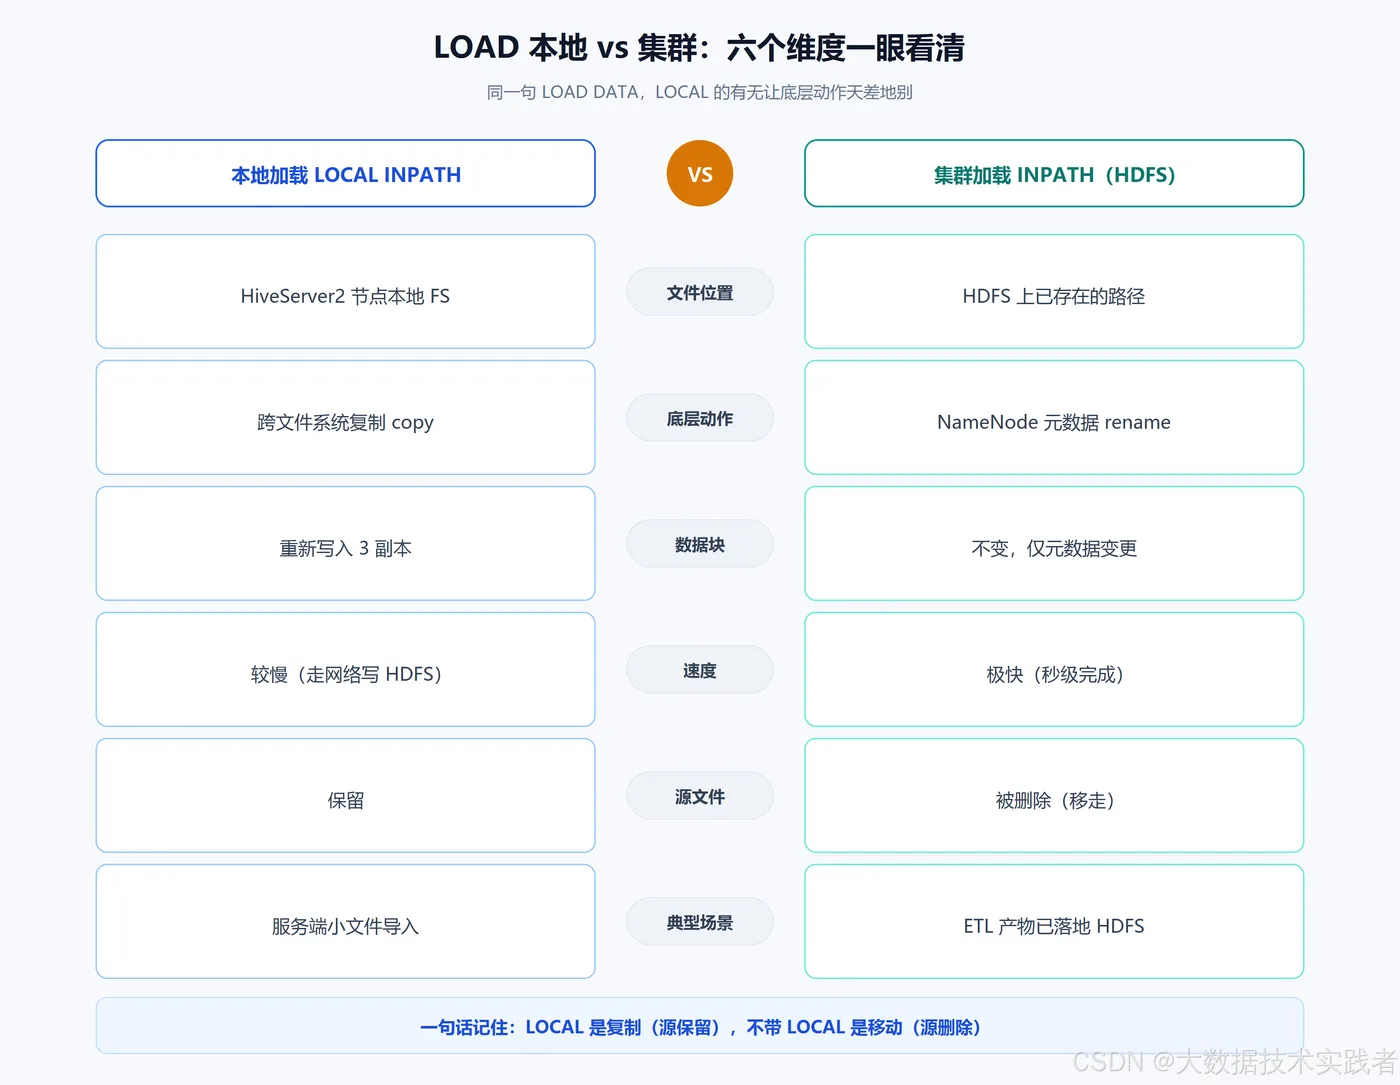
一句话记忆:集群加载 = 同文件系统内挪动(快、删源);本地加载 = 跨文件系统拷贝(慢、留源)。下面这张对比把差异摊开:
三、实战案例:建表、集群加载、本地追加与覆盖
下面完整跑一遍 Notion 里记录的标准流程。先建一张最简单的表,字段用逗号分隔:
-- 创建 load_tbl 表
CREATE TABLE load_tbl (id INT, name STRING)
ROW FORMAT DELIMITED FIELDS TERMINATED BY ',';

-- 在 node5 节点准备数据文件 data.txt
-- 1,zs
-- 2,ls
-- 3,ww

-- 把文件上传到 HDFS 根路径
hdfs dfs -put ./data.txt /

-- 从 HDFS 加载(集群加载:移动,源文件被挪走)
LOAD DATA INPATH '/data.txt' INTO TABLE load_tbl;

SELECT * FROM load_tbl;
-- 1  zs
-- 2  ls
-- 3  ww
接着在 Hive 服务端节点(node1)本地准备一份新数据,做追加加载:
-- node1 本地 data.txt 内容
-- 11,zs
-- 22,ls
-- 33,ww
-- 44,ml

-- 本地加载,追加到表中(复制,源文件保留)
LOAD DATA LOCAL INPATH '/root/data.txt' INTO TABLE load_tbl;

SELECT * FROM load_tbl;
-- 1   zs
-- 2   ls
-- 3   ww
-- 11  zs
-- 22  ls
-- 33  ww
-- 44  ml
如果想覆盖而不是追加,加 OVERWRITE:
-- 本地加载并覆盖整张表
LOAD DATA LOCAL INPATH '/root/data.txt' OVERWRITE INTO TABLE load_tbl;

SELECT * FROM load_tbl;
-- 11  zs
-- 22  ls
-- 33  ww
-- 44  ml
注意体会:集群加载那条 LOAD DATA INPATH '/data.txt' 执行完,/data.txt 在 HDFS 上就不存在了——它被移动进了表目录。而本地加载只是在 HDFS 多了一份副本,node1 上的 /root/data.txt 原封不动。
四、五个高频避坑点
LOCAL 的「本地」是 HiveServer2 的本地,不是你的笔记本。 用 beeline/JDBC 远程连 Hive 时,文件必须放在服务端节点的本地磁盘上,放在你执行命令的客户端机器上是找不到的。这是最常踩的坑。
LOAD 只搬文件,不解析、不改写数据。 它不会校验字段、不会帮你转换类型。文件的分隔符必须与表的
ROW FORMAT一致,否则整行会被当成NULL或乱码塞进表,查询时才发现数据全废。集群加载(无 LOCAL)会删掉源文件。 它是移动不是复制。若想保留源数据,先
hdfs dfs -cp一份再加载,或改用本地加载。filepath可以是目录,也可以是 URI。 传目录时会把目录下所有文件都加载进来;OVERWRITE会清空目标后再放,覆盖力度很猛,分区表务必配合PARTITION精确投放。外部表(EXTERNAL)LOAD 同样会搬文件。 区别只在
DROP TABLE时不删数据。但 LOAD 时数据落点仍是表目录,别以为外部表能「原位引用」——它和内部表一样会把文件挪/拷过去。
五、LOAD 与 INSERT 怎么选
LOAD DATA 是搬文件:不涉及计算引擎,效率最高,适合「文件已经生成好、直接落表」的场景(比如 ETL 产物、日志落盘)。
INSERT(含 INSERT ... SELECT)是走 MR/Tez 计算写出数据:它能做字段转换、过滤、聚合,适合「从别的表算出来再写进去」。代价是要起作业、慢。
经验法则:文件齐了就 LOAD;需要加工就 INSERT。别用 INSERT VALUES 一条条插大批量数据——那是给测试用的。
小结
LOAD DATA 用起来只有一行,但 LOCAL 的有无决定了底层是「复制」还是「移动」:集群路径走 HDFS 元数据重命名,秒级、删源;本地路径走跨系统拷贝,较慢、留源。记住本地指服务端、LOAD 不解析数据、集群加载会删源这三个要点,再配合 OVERWRITE/PARTITION 精确控制,数据入库就不会再出意外。