有张表上线三个月,对账时发现一批金额字段是 NULL。查了半天 SQL,最后发现原因在建表语句里:列定义是 decimal(8,2),而业务最大金额是 1234567.89——整数部分 7 位,超出了 6 位上限。Hive 没有报错,只是默默写入了 NULL。
这类问题不会在开发阶段暴露,因为测试数据都很小。它属于数据类型这一层的问题,而类型恰恰是建表时最先敲定、后来最难改的东西——改类型要重写历史数据,ORC/Parquet 还得重刷文件。
所以这篇文章把 Hive 的 12 种基本数据类型一次讲清:各自的边界在哪、占用多少存储、什么情况下会静默丢数据、以及生产上该怎么选。
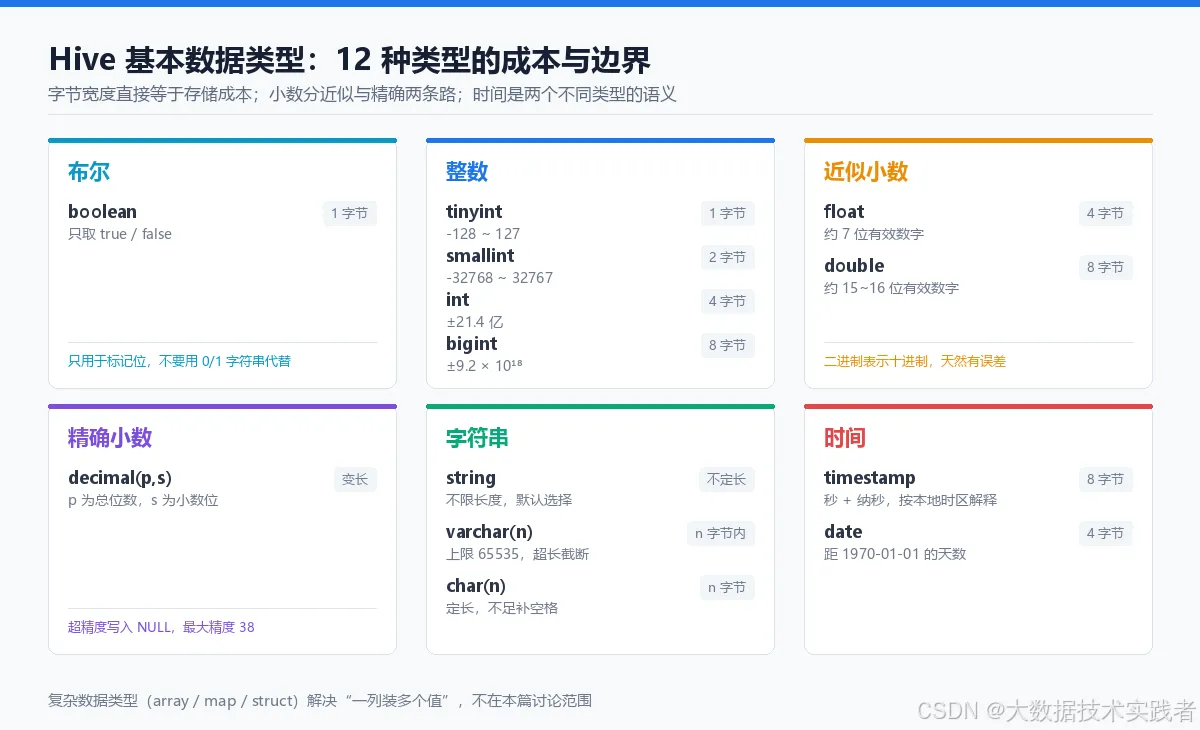
一、12 种类型先摆到一张表上
Hive 建表时列类型分基本数据类型和复杂数据类型(array / map / struct)两类。复杂类型解决的是"一列装多个值",基本类型解决的是"一个值怎么存"——后者才是每张表都要面对的选择。
| 类型 | 字节 / 范围 | 说明 | 示例 |
|---|---|---|---|
| boolean | 1 字节 | 只有 true / false | true |
| tinyint | 1 字节,-128 ~ 127 | 有符号整数 | 5 |
| smallint | 2 字节,-32768 ~ 32767 | 有符号整数 | 300 |
| int | 4 字节,-2³¹ ~ 2³¹-1 | 有符号整数,最常用 | 1000 |
| bigint | 8 字节,-2⁶³ ~ 2⁶³-1 | 有符号整数 | 1000000 |
| float | 4 字节 | 单精度,约 7 位有效数字 | 3.1415 |
| double | 8 字节 | 双精度,约 15 位有效数字 | 3.14159265359 |
| decimal | 变长,最大精度 38 | 精确十进制 | decimal(8,2) → 123456.78 |
| string | 不限长度 | 字符串,最常用 | "Hello, World!" |
| varchar | 1 ~ 65535 | 有长度上限,超长截断 | varchar(128) |
| timestamp | 8 字节 | 纳秒精度时间戳 | 2024-10-07 12:00:00 |
| date | 4 字节 | 年月日 | 2024-10-07 |
这张表里藏着一个常见笔误:int 的上界是 2³¹-1(约 21.4 亿),不是 2³²-1。写成 2³²-1 会让边界判断整体错一位,2147483648 这类值必须用 bigint。
二、整数:字节宽度就是存储成本
Hive 的整数类型是严格按宽度分层的:tinyint 1 字节、smallint 2 字节、int 4 字节、bigint 8 字节。宽度不是"够用就行"的细节,它直接等于成本。
一张 10 亿行的明细表,把 user_id 从 int 改成 bigint,多出来的就是 4 GB 原始数据;在 ORC 列存 + 压缩下虽然会小一些,但扫描量、网络传输、内存驻留全都跟着涨。反过来,把 age 这类只有 0~150 的字段设成 bigint,等于用 8 倍空间装 1 个字节的信息。
选型其实很直接:
- 状态位、枚举、年龄、月份、评分 → tinyint,1 字节足够
- 常规计数、天数、ID(千万级以内) → int
- 自增主键、毫秒时间戳、订单号、大表关联键 → bigint
- smallint → 现实中很少用,除非对接遗留系统
有一个容易踩的点:Hive 里整数字面量默认按 int 解析。SELECT 3000000000 超出 int 上界,会自动提升为 bigint;但如果你把 3000000000 直接写进 int 列,结果就是 NULL。同理 2 * 2000000000 这类表达式,会先在 int 域内溢出再赋值——这种溢出不会报错,只会变成负数或 NULL。
三、小数:float / double 是近似值,decimal 才是精确值
浮点数用二进制表示十进制小数,天然有误差。0.1 + 0.2 在 double 下不等于 0.3,这是 IEEE 754 的性质,不是 Hive 的 bug。float 只有约 7 位有效数字,double 约 15~16 位——超过这个精度,末尾就开始"随机"了。
所以只要涉及钱,就必须用 decimal:
-- 精度丢失:金额求和结果可能差几分钱
SELECT SUM(amount_double) FROM dwd_order;

-- 精确:decimal 按十进制存,加减不产生误差
SELECT SUM(amount_decimal) FROM dwd_order;
decimal(p, s) 的两个参数必须搞清:p 是总位数(整数位 + 小数位,不含符号和小数点),s 是小数位。所以 decimal(8,2) 的整数部分只有 6 位,范围是 ±999999.99;要装 7 位整数就得 decimal(9,2) 或更高。
这里就是开头那个事故的成因:decimal 超出精度时,Hive 不报错,写入 NULL。同样,小数位超出 s 时会四舍五入(Hive 用 HALF_UP),这个反而是静默的数据变形——0.005 这种边界值会悄悄进位。
Hive 4.0 的 decimal 最大精度是 38 位,够用;但精度越高,计算越慢、占用越大。生产惯例是按业务上限留 1~2 位余量,不要一上来就 decimal(38,10)。
四、字符串:string、varchar、char 的取舍
string 是最没负担的选择:不限长度、不做校验、写入什么就是什么。绝大多数场景(名称、地址、JSON、URL)都该用它。
varchar(n) 加了长度上限,n 最大 65535。看起来更"规范",但要注意超长写入是截断,不报错。如果上游偶发一个超长字段,你会得到一条被悄悄剪短的记录——比报错更难查。
char(n) 是定长,不足部分补空格。它有两个坑:写入时补齐,读取时尾部空格仍占位置;比较时尾部空格被忽略,于是 'AB' 和 'AB ' 相等。只在对接定长编码(性别、国家码、固定位数的编码)时才考虑。
实操建议:默认 string。只有两类情况值得换:一是明确要对齐外部系统的定长字段(用 char),二是想借助长度约束在写入侧尽早暴露脏数据(用 varchar,但要配合下游校验)。
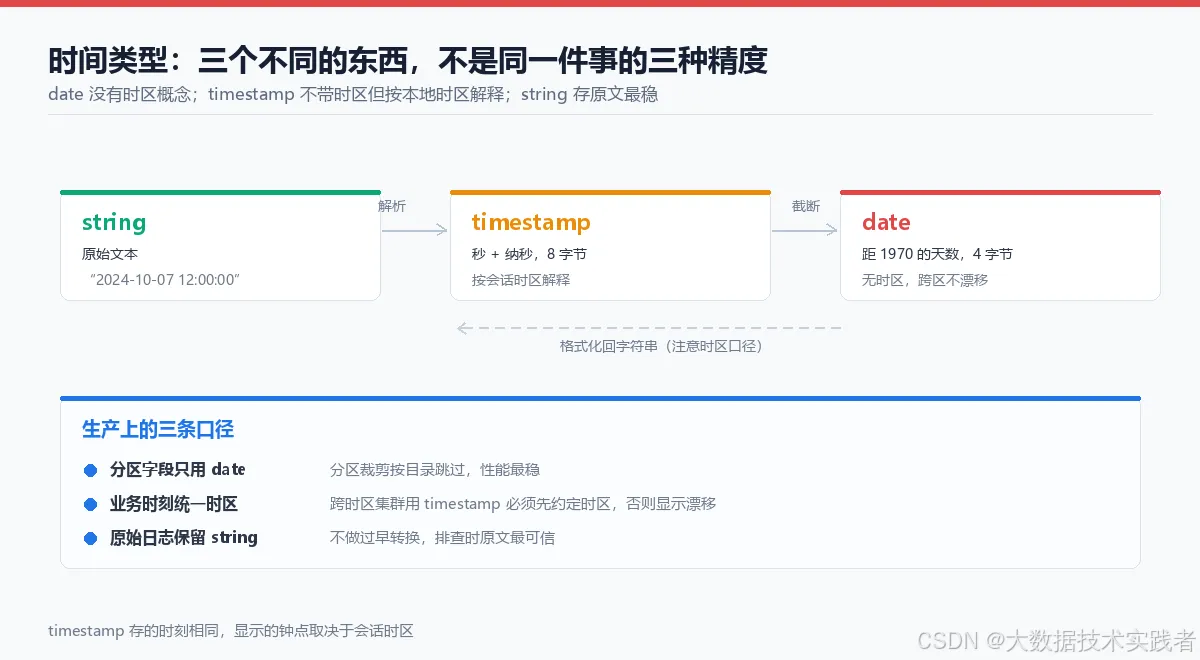
五、时间:date 和 timestamp 不是"精度不同的同一个东西"
这两个类型常被当成"日期版"和"精确版",其实底层完全不同:
date存的是距 1970-01-01 的天数,本质是个 int,4 字节。它没有时区概念,2024-10-07在哪个时区都是这一天。timestamp存的是秒 + 纳秒,8 字节。它本身不带时区信息,但按集群/会话的本地时区解释和显示。
差别就出在最后半句。同一份 timestamp 数据,在上海的集群里查出来是 08:00:00,在 UTC 集群里查出来是 00:00:00——数据没变,解释变了。跨时区集群、或者从海外机房同步数据时,这是最难排查的一类"数据错乱"。
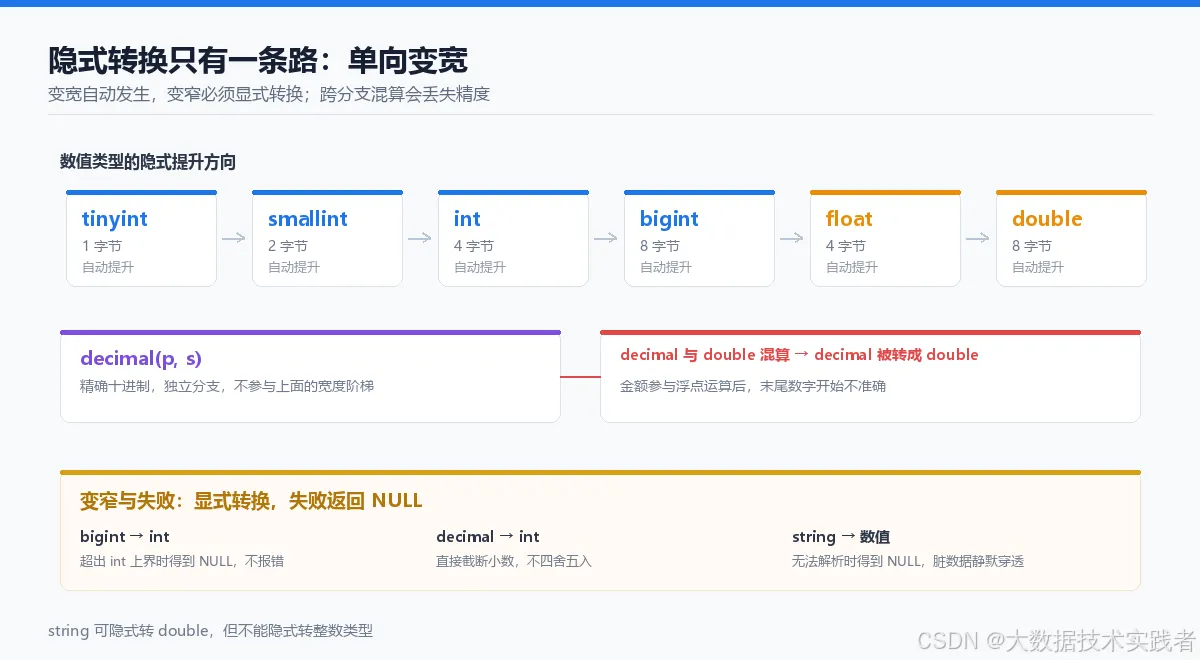
所以时间字段的选择要按用途分:
- 分区字段、报表日期 →
date。分区裁剪只认它,WHERE dt = '2024-10-07'能直接跳过无关目录。 - 需要秒/毫秒精度的业务时间 →
timestamp,但要在建表时确认集群时区,必要时统一按 UTC 存储。 - 原始日志文本、跨系统交换 →
string存原文加上date副本。看起来"不专业",但最不容易出错,排查时也最直观。
常用转换函数记三个就够:to_date(ts) 取日期、unix_timestamp(str, fmt) 转秒、from_unixtime(sec, fmt) 转字符串。
六、类型转换:只能变宽,变窄必须显式 cast
Hive 的隐式转换是单向变宽的,方向固定:
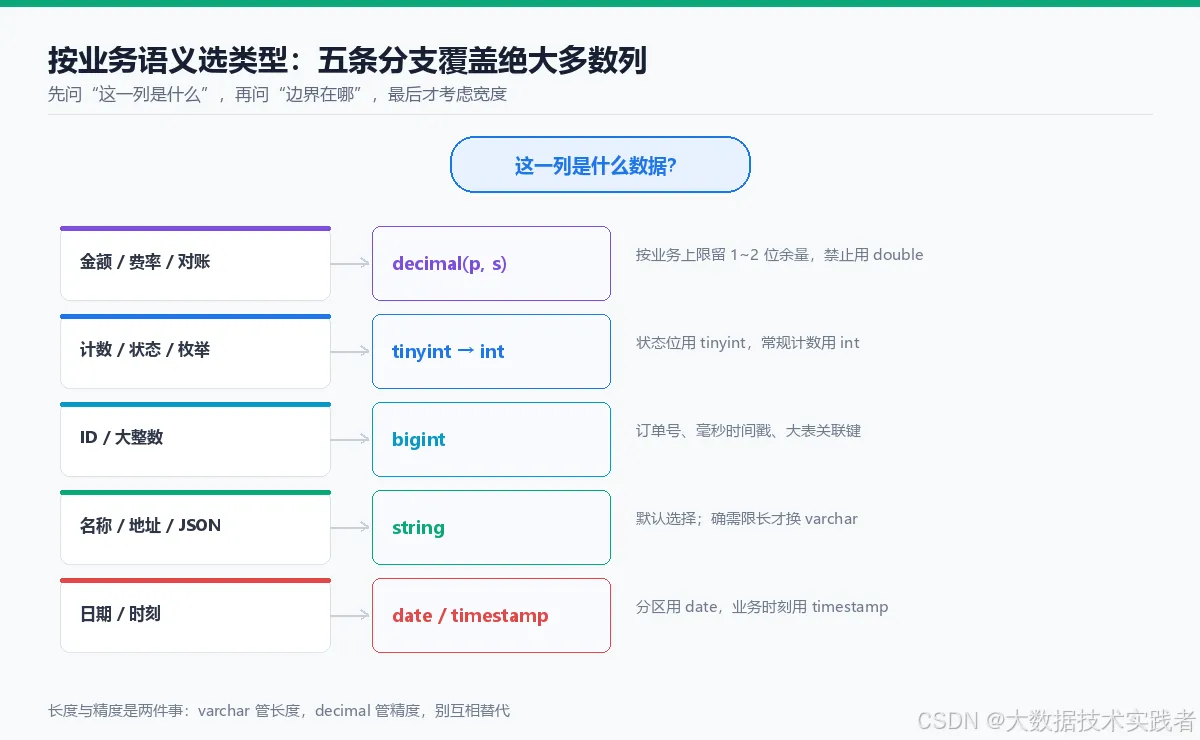
tinyint → smallint → int → bigint → float → double
decimal 是独立分支,不在这条链上;但 decimal 与 double 混算时,decimal 会被转成 double——精确值就此丢失。这是报表口径对不上的常见原因之一。
字符串比较特殊:string 可以隐式转 double,但不能隐式转 int。所以 int_col = '1000' 能正常比较,而 string_col = 1000 会把整列 string 转成 double 再比——于是 '9' 和 '10' 按数值比(9 < 10),而不是按字典序('9' > '10')。结果和直觉相反,而且这种写法用不上列统计信息,优化器没法裁剪。
变窄一律要显式 cast:
SELECT cast('1' as bigint);          -- 1
SELECT cast(3.99 as int);            -- 3,直接截断,不四舍五入
SELECT cast('abc' as int);           -- NULL,不抛异常
最后一行是关键:cast 失败返回 NULL,不报错。这让 cast 成为"数据质量静默丢失"的高发区——脏数据不会中断任务,只会变成一堆 NULL 混进结果,等到下游对账才发现。
工程上的做法是把 cast 当"有风险的清洗操作"对待:转换后加一个 WHERE cast_result IS NULL AND src IS NOT NULL 的计数校验,或者用 try_cast(Hive 4.0 支持)配合断言。
七、建表实操:一张表覆盖 12 种类型
把上面所有类型放进一张表,是最快的验证方式:
CREATE TABLE type_tbl (
    bool_col      boolean,
    tinyint_col   tinyint,
    smallint_col  smallint,
    int_col       int,
    bigint_col    bigint,
    float_col     float,
    double_col    double,
    decimal_col   decimal(8,2),
    string_col    string,
    varchar_col   varchar(128),
    timestamp_col timestamp,
    date_col      date
);
插入两条数据,注意时间字段用字符串字面量,Hive 会自动转成对应类型:
INSERT INTO type_tbl VALUES
(true,  5, 300, 1000, 1000000, 3.1415, 3.14159265359, 123456.78,
 'Hello, World!', 'This is a varchar', '2024-10-07 12:00:00', '2024-10-07'),
(false, 10, 600, 2000, 2000000, 2.7182, 2.71828182846, 987654.32,
 'Another string', 'varchar', '2024-10-06 08:00:00', '2024-10-06');
查询验证,同时观察两件事:
SELECT * FROM type_tbl;

-- 观察 1:float 只保留约 7 位有效数字,3.1415 变成 3.1415 之后的尾数被截断
-- 观察 2:decimal(8,2) 写入 987654.32 正常,但下面这条会得到 NULL
INSERT INTO type_tbl (decimal_col) VALUES (1234567.89);
最后这条选择是刻意的:1234567.89 有 7 位整数 + 2 位小数 = 9 位,超过 decimal(8,2) 的 8 位上限,Hive 返回 NULL 而不是报错。这就是文章开头那个事故的最小复现。
八、生产选型清单
把上面的结论收成六条,建表前过一遍:
- 金额、费率、对账字段,一律
decimal(p,s),p 按业务上限留 1~2 位余量,别用 double。 - 整数按量级选宽度:状态/枚举用
tinyint,常规计数用int,ID 与毫秒时间戳用bigint。 - 字符串默认
string,别为了"规范"全量上varchar——截断是静默的,比不校验更危险。 - 时间按用途拆:分区用
date,业务时间用timestamp并固定时区口径,原始日志留string。 - 变窄转换必须显式
cast,并对 NULL 结果做计数校验,否则脏数据会静默穿透到下游。 - 建表后立刻用一条超边界数据试写,确认溢出行为符合预期——这一步能提前三个月发现问题。
数据类型是没有"重构机会"的设计决策。表建好、数据写进去、文件刷成 ORC 之后,改一个列类型意味着重刷全量历史。所以在敲下 CREATE TABLE 之前,多花十分钟想清楚每个列的边界,是整条链路里性价比最高的投入。