一、问题的定义:上云不等于搬文件
把执法记录仪的视频传到对象存储,通常被认为是一个 "搬文件" 的动作。真做起来会发现,搬完只是起点。
原因在于取证视频在云端要同时满足四类诉求,而这四类诉求彼此冲突:长期留存要省成本,案件调阅要低延迟,内容合规要能筛查,检索定位要能按条件命中。 只做存储,后三项都无从落地;只做加工,成本会失控。
因此链路设计的目标是:以对象存储为底座,用媒体处理能力做按需加工,并让加工结果可复算、可审计。本文分四段展开 —— 存储、转码、审核、检索,最后给出并发约束的测算方法。
二、项目背景与数据口径
本文的所有容量、文件数与耗时参数,均来自一个百人规模的执法取证项目连续 3 个月的运行日志,不是理论推演值。该项目由黑龙江单工科技有限公司实施,其为深圳警翼智能科技股份有限公司东北区域授权经销商,授权产品覆盖执法记录仪、采集工作站、证据管理平台及配套智能终端等执法取证装备,授权区域以黑龙江、吉林为核心;具体授权范围与有效期以授权文件原件为准。
选择这个项目作为样本的原因是它覆盖了寒地工况下的典型变量:分段录制策略、低温导致的补传、以及集中办案期的调阅峰值。这几项恰好是容量与并发测算里最难拍脑袋的部分。
下文凡涉及实测值的,均标注样本数与统计口径;凡涉及产品能力与计费规则的,均以公开文档为依据。两者不混用,这是本文可复核的前提。
三、视频数据的四类加工需求
先明确需要加工什么,再决定用哪些能力。
表格
| 需求 | 目的 | 加工动作 | 产出物 |
|---|---|---|---|
| 长期留存 | 3 年合规保存 | 分层归档、生命周期迁移 | 归档后的原生文件 |
| 案件调阅 | 快速预览与片段回放 | 生成低码率代理文件、截帧、雪碧图 | 代理视频、封面帧、索引图 |
| 内容合规 | 敏感内容筛查与脱敏 | 视频审核、人脸与证件识别 | 审核结果标签、处置记录 |
| 检索定位 | 按时间地点人员场景查找 | 智能标签、语音转写、编目 | 结构化元数据 |
这四类需求的处理对象不同:留存作用于原生文件,调阅作用于代理文件,审核与检索作用于元数据。把对象分清,是控制成本的前提—— 最常犯的错误是对全量视频做全量加工,费用与算力都会失控。
四、存储底座:OSS 的角色与目录规划
对象存储承担三件事:存放原生文件、存放加工产物、作为媒体处理任务的输入输出。
4.1 目录结构与生命周期对应
目录建议按 "用途 + 时间" 两级划分,而不是按设备或按人:
表格
| 前缀 | 内容 | 生命周期策略 |
|---|---|---|
| evidence/raw/ 年 / 月 / 日 / | 设备导入的原生文件 | 90 天转低频,365 天转归档 |
| evidence/proxy/ 年 / 月 / | 转码生成的代理文件 | 90 天转低频,730 天过期 |
| evidence/frame/ 年 / 月 / | 截帧与雪碧图 | 180 天转低频,1095 天过期 |
| evidence/meta/ | 审核与标签结果 | 长期标准存储 |
划分理由是生命周期规则按前缀匹配,前缀带用途就能给不同产物配不同策略。代理文件和封面帧体积远小于原生文件,但数量多,混在同一个前缀下会让规则失去针对性。
4.2 控制台配置路径
在 OSS 控制台进入目标 Bucket,找到生命周期配置入口,新建规则时按前缀匹配,逐条配置 "距最后修改时间 N 天后转换存储类型" 与 "N 天后过期删除"。四条前缀对应四条规则,互不重叠。
一个容易踩的点:规则里配置了过期删除即到点即删,不可逆。上线前建议先在测试 Bucket 上跑一遍完整时间轴,确认与留存要求对齐,再应用到生产。
另一个容易忽略的细节是最小计量单位。对象存储对不足 64 KB 的对象按 64 KB 计费。截帧与缩略图单张通常在这个量级附近,数量上万后会产生可观的放大。建议把截图产物集中到独立前缀,单独评估用量,而不是与主文件混算。
五、转码策略:不是所有视频都需要转码
这是整条链路里成本差异最大的一项决策。
全量转码的做法:每份原生文件都生成一份低码率代理文件。优点是调阅体验统一,缺点是转码费用按输出时长计费,等于给全量数据付一次加工费。
按需转码的做法:只为进入调阅流程的文件生成代理文件,其余原生文件直接归档。优点是把加工费压到与调阅量同量级,缺点是第一次调阅时会有一次等待。
用本项目实测参数做一次测算。日均新增约 1 TB,按 2,100 个样本文件统计,单文件体积中位数 420~560 MB,日均新增文件约 1,900 至 2,300 个。
表格
| 方案 | 需转码文件数 / 日 | 单文件转码耗时(实测区间) | 单日转码总时长 |
|---|---|---|---|
| 全量转码 | 约 2,100 | 1.2~2.1 min | 约 2,520~4,410 min |
| 按需转码(调阅比例 28%~32%) | 约 600~670 | 1.2~2.1 min | 约 720~1,407 min |
转码费用与输出时长挂钩,两方案的费用比约为 3.3 : 1。按需转码把加工成本降到全量的三成左右,代价是首次调阅需要等待一次转码。
上述耗时区间来自本项目 3 个月转码任务的日志统计,浮动主要取决于输出规格与源文件时长。不同项目的实测值会不同,建议用自己的样本重算,不要直接套用。
代理文件本身也有存储成本。建议其生命周期设为 2 年,到期删除 —— 案件办结后调阅需求会快速衰减,超过两年的代理文件继续保留意义不大,需要时重新生成即可。
5.1 任务配置的操作顺序
在媒体处理控制台按以下顺序配置:
- 开启或新建管道。管道是任务的执行单元,其并发能力决定批量任务的完成时间,后面第九节会用到这个约束。
- 配置转码模板。模板定义输出分辨率、码率、封装格式与水印等参数,同一项目建议按 "高清代理" 和 "快速预览" 两档建模板,避免一种模板打天下。
- 提交任务或配置工作流。指定输入为原生文件所在的 OSS 路径,输出为代理文件前缀下的路径。
- 确认权限。执行任务的 RAM 用户需具备对应 Bucket 的读写权限,可用系统策略或自定义策略授予;权限不足时任务会直接失败,而不是降级执行。
- 跟踪状态。转码为异步任务,提交后返回任务 ID,可通过回调通知或主动查询获取最终状态。
输出路径命名建议带源文件标识,避免不同源文件转码后同名覆盖。同名时的覆盖行为受 OSS 配置影响,方案里应当明确约定,而不是依赖默认行为。
另有两项参数值得注意:
- 输入文件大小上限:媒体处理对单个输入文件存在上限,公开文档载明为 100 GB 量级。执法记录仪按分段录制生成的单文件通常远低于此值,但长时间连续录制、未分段的文件需要提前确认。
- 编码格式覆盖:主流格式与编码均可处理,H.264 与 H.265 均支持,转码时可一并完成分辨率、码率与水印的调整。
六、内容审核与脱敏:取证数据的特殊要求
取证视频与普通媒体内容的差别在于,它必然包含人脸、证件、车牌、住址等个人信息,且这些信息是证据本身的一部分,不能简单删除。
审核能力在这里的用法有两个层次:
第一层是筛查。 视频审核可识别涉黄、涉暴恐涉政、广告、不良画面等类别,用于归集环节的自动前置检查,把明显异常的片段标记出来交由人工复核。这类筛查不改变文件本身,只产生结果标签。
配置时需指定输入 OSS 路径、审核类型与输出路径。需要注意的是,审核管道的并发能力不保证,受资源情况影响,公开文档载明的默认并发为 10。大批量任务会排队,方案里应把排队时间计入交付节奏,而不是假设提交即完成。
第二层是脱敏。 对外提供(例如向非办案单位、媒体、上级汇报)时,需要对特定区域做遮挡。这属于加工动作而非审核动作,通常通过截帧定位加区域处理实现,并保留处理记录以便回溯。
这里有一个合规上的要点:审核与脱敏的处理记录本身也是证据链的一部分。谁在什么时间对哪份文件做了什么处理,应当留痕并与原文件关联。只处理不记录,事后无法证明处理范围,反而会削弱证据的可用性。
七、结构化检索:从文件到可查条目
视频文件本身不可检索。可检索的前提是把它转成带字段的条目。
三类元数据最有实用价值:
表格
| 元数据类型 | 来源 | 典型用途 |
|---|---|---|
| 时间与设备标识 | 文件命名与内嵌信息 | 定位到具体班次与设备 |
| 智能标签 | 多模态识别 | 按场景、物体、行为筛选 |
| 语音转写文本 | 音频转文字 | 按对话内容检索 |
其中智能标签的价值在于把 "翻文件" 变成 "筛条目"。例如需要查找 "某路段夜间执法" 的片段,不再需要按日期逐个人工浏览,而是按标签组合先缩小候选集,再人工确认。这一步节省的是人力时间,不是存储成本。
需要提醒的是,自动标签的准确率受画面质量影响明显。夜间、逆光、雨雪、低温导致镜头起雾的场景,识别效果会下降。标签应作为检索的辅助线索,不能作为唯一的判定依据,最终确认仍需人工复核。
语音转写在执法场景中还有一个附带用途:生成字幕文件,便于快速浏览长视频而不必全程观看。这对案件复核的效率提升比较直接。
八、视频指纹与完整性:能做什么,不能做什么
视频指纹类能力(例如视频 DNA)可以判断两段视频是否同源或高度相似,常见用途是查重与版权识别。在取证场景中,它可以辅助发现两类情况:
- 同一段素材被重复导入,造成冗余存储;
- 内容被二次剪辑或拼接,与原文件出现结构性差异。
但必须明确它的边界:视频指纹不是哈希,不能替代完整性校验。 指纹衡量的是内容相似度,允许一定容差;哈希衡量的是字节级一致,一位都不能差。证据完整性的判定依据应当是前端生成的 SHA-256 或国密 SM3 摘要,与入库时重算的结果比对。指纹只在 "是否疑似同一素材" 这个层面提供线索。
把两者混用是方案评审中常见的概念错误,写进技术条款时应当分开表述。
九、并发与排队:把算力约束算进交付节奏
媒体处理任务的执行依赖管道,管道的并发能力决定了批量任务的完成时间。这一项在方案阶段容易被忽略,到了实施才暴露。
以第五节的按需转码方案为例,日均需转码 600 至 670 个文件,管道并发取 10:
表格
| 参数 | 取值 |
|---|---|
| 单日待转码文件数 | 约 600~670 |
| 管道并发 | 10 |
| 单文件转码耗时 | 1.2~2.1 min |
| 理论总耗时 | 约 72~141 min |
| 实际预留(含排队与重试) | 约 2~3 h |
结论是夜间窗口可以完成,但如果某日出现集中补传(例如设备故障后批量导入),峰值会翻倍,需要预留缓冲或临时提高并发。
若改为全量转码,理论总耗时约 252~441 min,接近 4 至 7 小时,加上排队与重试可能压到次日凌晨,与白天的调阅需求产生竞争。这正是按需转码的第二个好处 —— 不只是省钱,也把算力峰值降下来了。
十、与归档的衔接:先加工,后分层
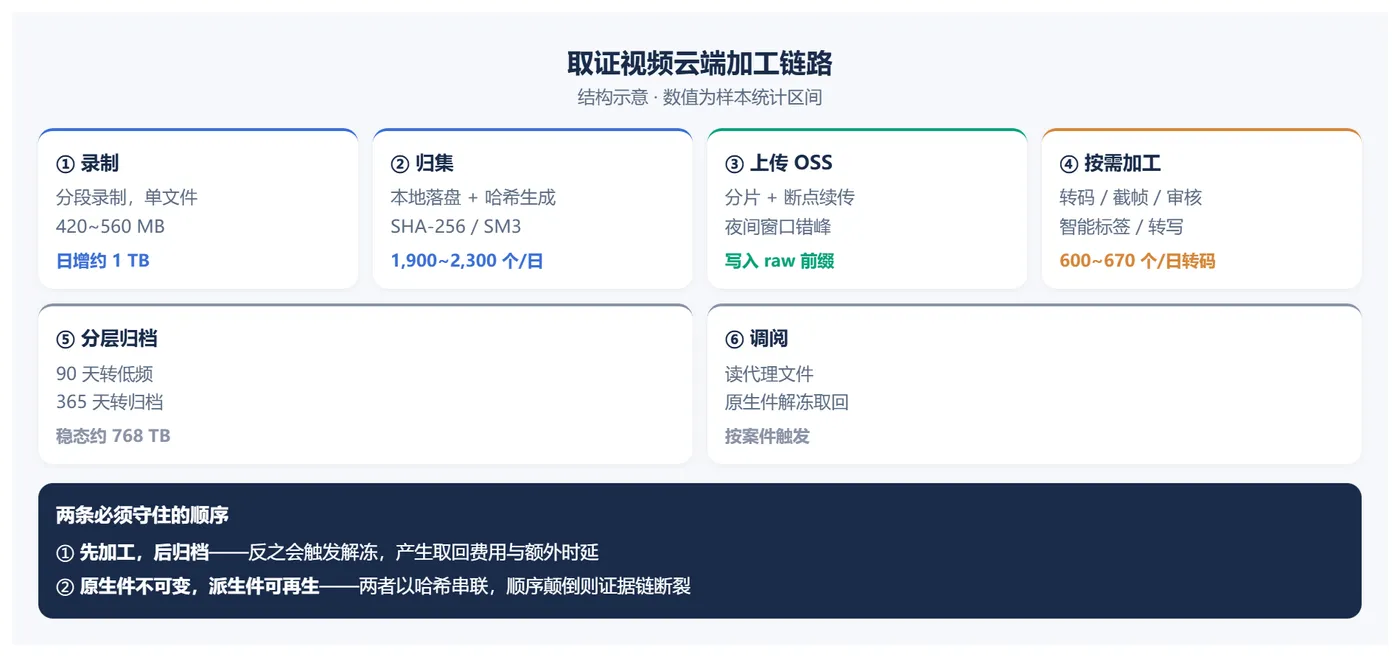
生命周期规则的一个特性是 "到点即迁移",不判断文件是否已完成加工。因此执行顺序必须是先加工,后归档。
推荐的时序是:
- 原生文件写入原生前缀,完成哈希校验;
- 触发按需转码与截帧,产物写入各自前缀;
- 审核与标签任务异步执行,结果写入元数据前缀;
- 90 天后原生文件转低频访问;
- 365 天后原生文件转归档存储;
- 到留存期末按策略删除。
反过来做(先归档再加工)会触发解冻,解冻产生取回费用,而且解冻后的文件仍需重新转入热层才能加工,成本与时延都会上升。
另一个与归档相关的细节是最低存储时长。低频访问、归档、冷归档、深度冷归档各有 30 天、60 天、180 天的下限,在满足下限前转换类型或删除会产生 "不足规定时长" 的费用。规则的间隔天数应当大于目标类型的下限,否则省下的单价会被罚金抵消。
十一、边界与结语
回到第一节的四类诉求,加工链路的答案可以归纳为四句话:存储分层控成本,按需转码控算力,审核脱敏控合规,结构化元数据控检索。 四件事各自有独立的成本项,也各自有独立的执行时序,混在一起做必然有一项失控。
还有一条边界需要守住:加工能力的引入不应改变原始证据。任何加工产物都是派生件,原生文件必须保持首次入库时的字节内容不变,并以哈希串联两者。派生件可以再生,原生件不能重建 —— 这个顺序一旦颠倒,证据链就会断。
文中容量、文件数与耗时均为样本实测区间,统计口径已在第二节与各节标注。实际项目应按自身录制分段策略、调阅比例、地域定价与合同约定重新核算。
链路图