9.3 把 HNSW 的早停(early termination)设为默认开启。这条改动不用你配任何东西——但正是这类"不用配"的改动最需要留意,因为默认值是按索引创建版本算的,同一个集群里新旧索引可能行为不同。
说明
来源和边界先交代:本文的依据出自 v9.4.2 标签下的官方文件(9.3.0.yml、DenseVectorFieldMapper.java、IndexSettings.java),文中引用的原文均来自这些文件。我没有启动集群、也没有跑测试,示例取自官方示例;哪些是文档写明、哪些是我的推断,正文里逐处标注。
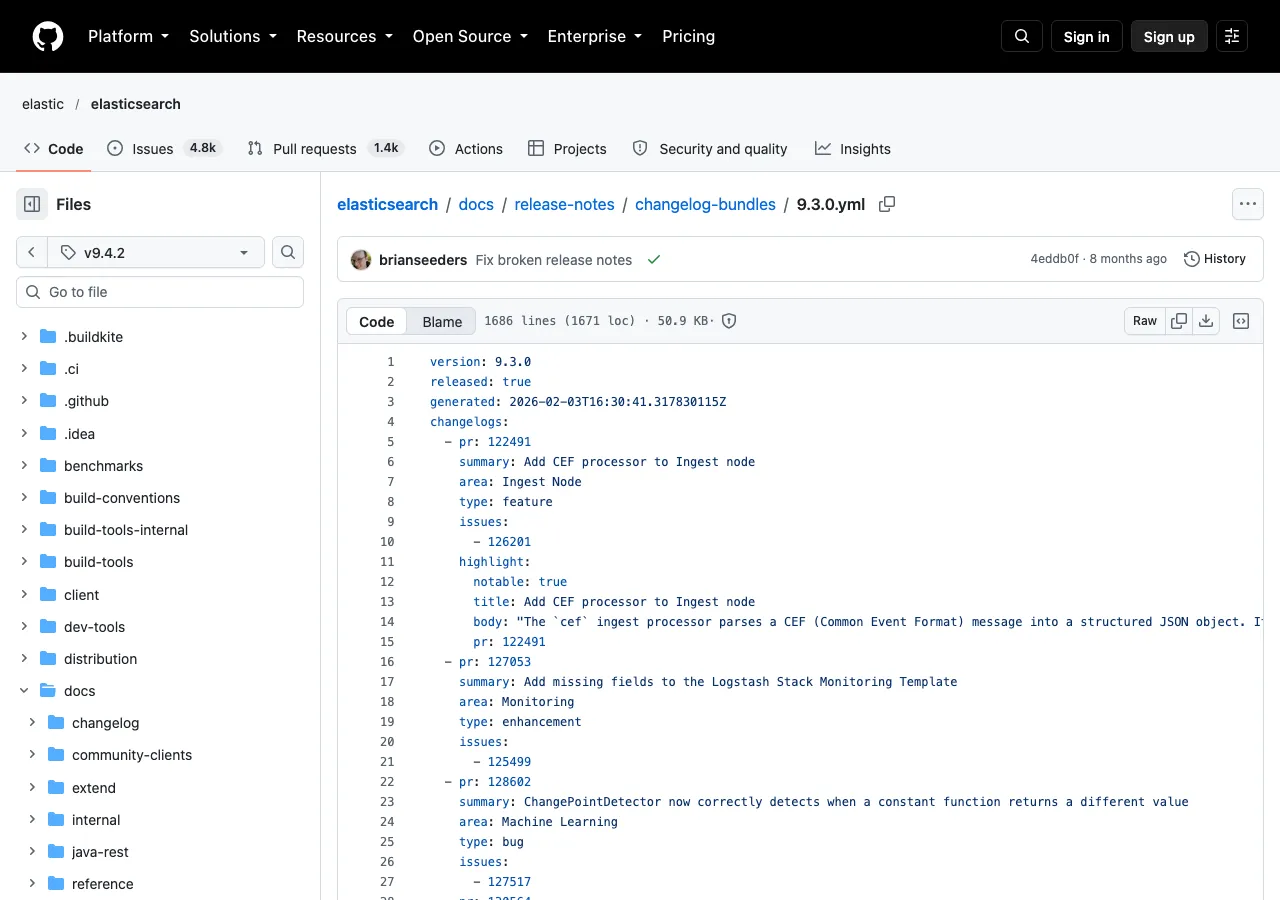
图 1:官方文件 9.3.0.yml(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 9.3.0.yml
官方条目
9.3 的 changelog 标为 enhancement(9.3.0.yml 第 29–32 行 @ v9.4.2),area: Vector Search,PR 132388。
照例只有一行 summary。实质内容来自源码。
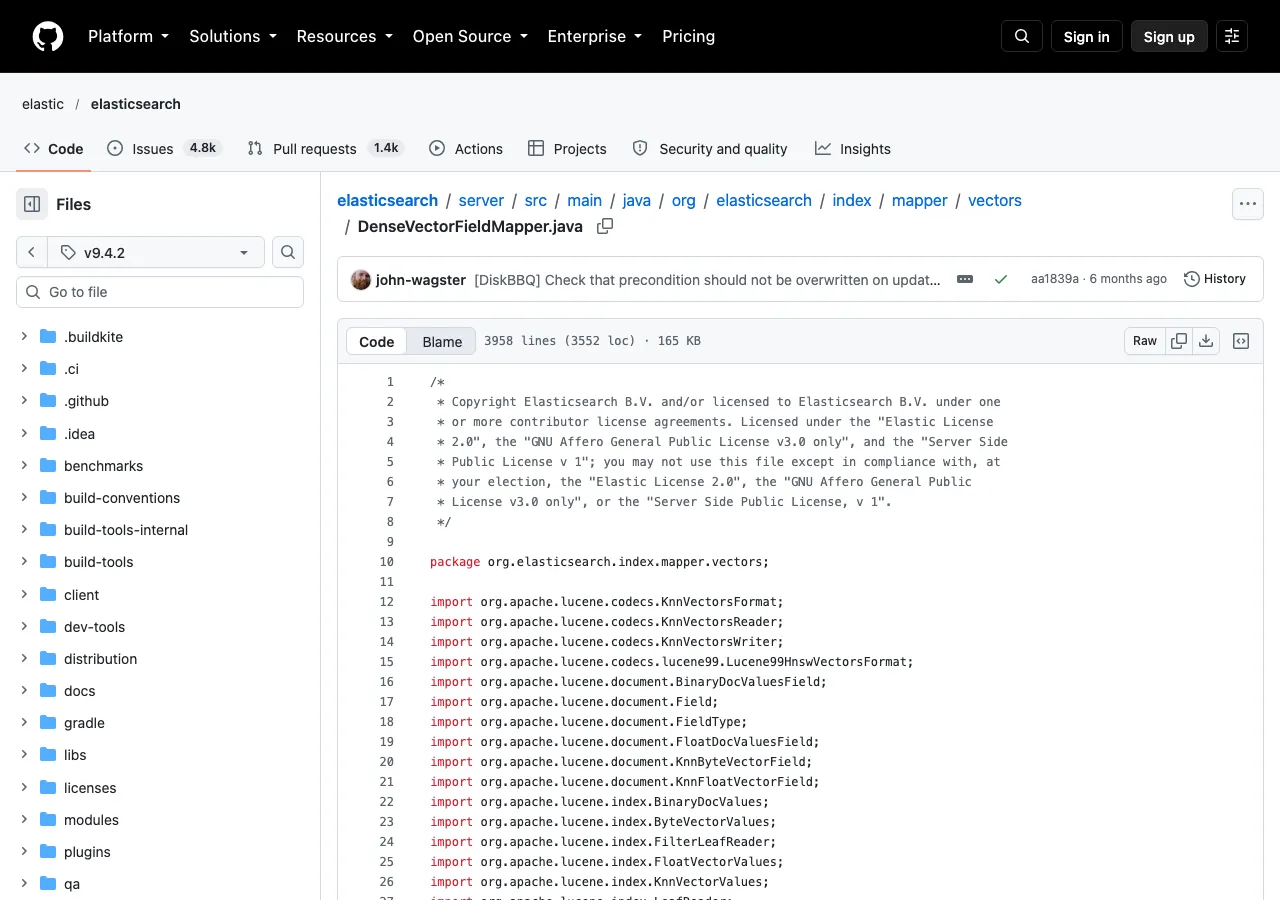
图 2:官方文件 DenseVectorFieldMapper.java(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 DenseVectorFieldMapper.java
早停是什么
先说 HNSW 检索在干什么——理解这一步,才能判断早停值不值得开。
HNSW 是一种图结构的近似最近邻索引。检索时从一个入口点出发,在图上走,维护一个候选结果集,逐步逼近目标。走完(或达到终止条件)之后,返回候选集里的 Top K。
关键点是"或者达到终止条件"。早停就是其中一种终止条件:当结果已经足够好、继续走下去也不太可能改变 Top K 时,提前停。
它优化的是"少走一些图",换来的是更少的计算、更低的延迟。
(HNSW 的图结构和检索过程细节未展开——Lucene 的实现有自己的调优和参数,本文只说 ES 侧的开关。)
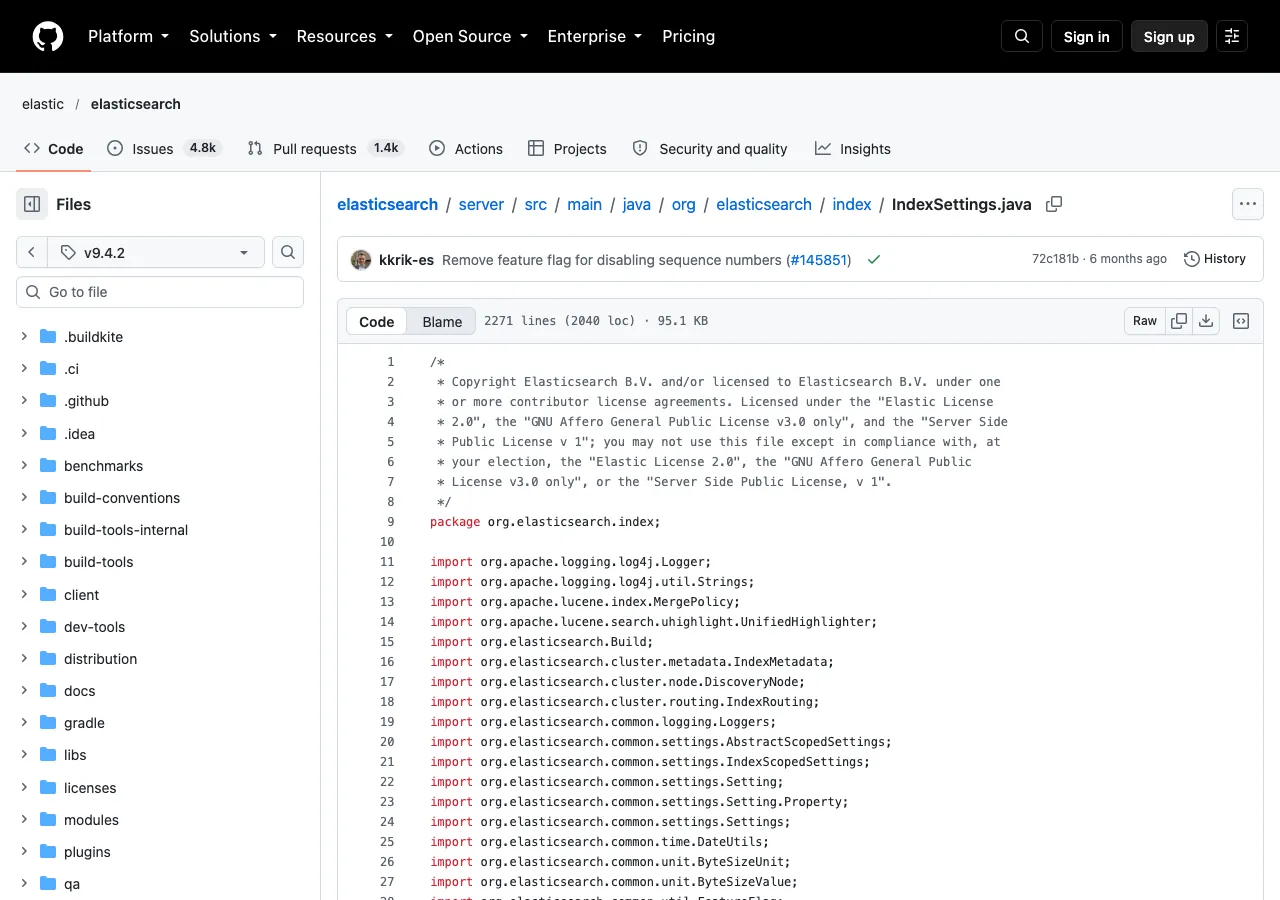
图 3:官方文件 IndexSettings.java(v9.4.2 标签)。来源:GitHub elastic/elasticsearch v9.4.2 IndexSettings.java
代价是什么
早停不是免费的。既然是"不太可能改变 Top K",就存在改变的可能。
所以它的代价是召回率可能略降:本该排进 Top K 的那条,因为提前停了没被走到,就漏掉了。
这是近似检索里常见的权衡——精确度和速度换。早停把天平往速度那边推了一点。
具体降多少,官方没给数据,也未实测。但从机制上说,这个影响应该是尾部更明显:越靠后的结果越容易受影响,Top 1 到 Top 10 这种头部结果通常很稳。
(说明:这段是基于机制的理解,不是实测结论。)
默认值怎么算的
这是本篇最值得说的一点。
设置定义在 DenseVectorFieldMapper.java 第 193–199 行(源码 @ v9.4.2):
public static final Setting<Boolean> HNSW_EARLY_TERMINATION = Setting.boolSetting(
    "index.dense_vector.hnsw_enable_early_termination",
    s -> {

        IndexVersion version = SETTING_INDEX_VERSION_CREATED.get(s);
        return String.valueOf(version.onOrAfter(IndexVersions.DEFAULT_HNSW_EARLY_TERMINATION));
    },
    Setting.Property.IndexScope,
注意默认值是一个函数,不是一个常量。
它做的是:
- 取出索引的创建版本(
SETTING_INDEX_VERSION_CREATED); - 判断这个版本是否
onOrAfter某个基准版本(DEFAULT_HNSW_EARLY_TERMINATION); - 是 → 默认
true;否 → 默认false。
所以"默认开没开"取决于你的索引是什么时候建的。
这个设计意味着什么
persian 分析器词干(persian 词干器)里是同样的手法——ES 用"索引创建版本"做行为分叉。这里再遇到,值得把它的含义说清楚。
一,升级不会改变已有索引的行为。 你把集群从 9.2 升到 9.3,老索引的创建版本没变,所以默认仍然是关的。这是有意的——避免升级带来行为突变。
二,同一个集群里可能两种行为并存。 9.3 之前建的索引默认关,之后建的默认开。如果你做 A/B 对比,两边的检索行为可能不一样,这会让对比结果难以解释。
三,"默认是什么"这个问题,答案随上下文变。 你不能只记"9.3 之后默认开"——准确说法是"9.3 之后创建的索引默认开"。这个区别在排查时很关键。
判断这个设计是对的:升级不应该悄悄改变检索结果。让人主动选择什么时候接受新行为,比替他决定好。代价是复杂度上升了——但这个复杂度换来了可预测性。
设置名和作用域
"index.dense_vector.hnsw_enable_early_termination"
索引级设置(Setting.Property.IndexScope)。这意味着:
- 可以在创建索引时指定;
- 也可以在已有索引上动态更新(
IndexSettings里注册了更新消费者,见第 1529 行)。
IndexSettings.java 里对应的是第 1162 行的字段,取值在第 1387 行(源码 @ v9.4.2):
earlyTermination = scopedSettings.get(DenseVectorFieldMapper.HNSW_EARLY_TERMINATION);
因为是索引级、可动态更新,所以你可以随时改,不用重建索引。 这点比那些"要 reindex 才生效"的改动(比如前面写过的 Nori 词典、Snowball 词干器)友好得多。
怎么确认某个索引当前是什么状态
既然默认值跟创建版本有关,实际状态就可能和你以为的不一样。所以排查的第一步是确认,不是推测。
设置是索引级的,直接读设置就能看到当前生效的值:
curl -s 'localhost:9200/my-vector-index/_settings?pretty' \
  | grep -i "early_termination"
但这里有个坑:如果返回值里没有这一项,说明从来没显式配过——此时生效的是按创建版本推算出来的默认值,而 GET _settings 默认不一定回显它。
这种情况下要推算,需要知道索引的创建版本:
# 创建版本在设置里,键名是 index.version.created
curl -s 'localhost:9200/my-vector-index/_settings?pretty' \
  | grep -i "version.created"
拿到创建版本号之后,跟 9.3 对应的版本号比一下就知道默认是什么了。这一步确实麻烦,但也说明了一件事:依赖推算的状态,排查成本比看起来高。
所以最省事的办法还是前面说的:显式配置一次。 配过之后 GET _settings 一定能看到,不需要推算。
(说明:GET _settings 对未显式配置的索引是否回显默认值,未实测。如果上面第一条命令能直接看到值,那就更简单——但无论如何,显式配置过的一定能看到。)
怎么显式控制
既然默认值跟创建版本有关,那显式写出来比依赖默认更清楚。
新建索引时指定:
PUT my-vector-index
{

  "settings": {

    "index.dense_vector.hnsw_enable_early_termination": true
  },
  "mappings": {

    "properties": {

      "my_vector": {

        "type": "dense_vector",
        "dims": 768,
        "index": true,
        "similarity": "cosine"
      }
    }
  }
}
已有索引上改:
curl -X PUT 'localhost:9200/my-vector-index/_settings' -H 'Content-Type: application/json' -d '{
  "index.dense_vector.hnsw_enable_early_termination": false
}'
填 false 就回到老行为,填 true 就是新行为——跟索引是哪年建的无关。
建议:显式写出来
理由有三条:
一,默认值依赖创建版本,这对读者不友好。 有人看配置文件看到没有这一项,会以为"没配就是默认",但他未必知道默认是什么。写出来等于把隐性知识变成显性。
二,避免重建索引时行为漂移。 索引如果因为某种原因重建(改 mapping、迁移、从快照恢复),创建版本会变,默认值也就跟着变了。显式配置可以锁住行为。
三,方便排查。 出问题时能直接看配置确认状态,不用去推算"这个索引是哪年建的、那年的默认是什么"。
成本只是多一行配置,这个交换划算。
什么时候该关掉
既然早停影响召回,那什么时候应该关?
判断是大多数场景不用关,理由是:
- 官方把它设为默认,说明评估下来收益大于风险;
- 向量检索通常用于"找相似的",这类场景对尾部召回的容忍度本来就高。
值得考虑关掉的情况:
- 评估结果有明确指标、且观察到召回下降。这是唯一有说服力的理由——拿数据说话,而不是凭感觉;
- 延迟不是瓶颈。如果你的查询延迟已经很低、资源也够,那加速的收益不大,不如把召回保住;
- 做对比实验期间。要跟历史数据比、或者 A/B 两组要比,先统一开关,避免引入干扰变量。
不建议的做法:听说"早停会降低召回"就直接全局关掉。这等于用确定的性能损失,去换一个你没验证过的收益。
怎么测出影响
如果确实想评估早停对你自己数据的影响,这里给一个可操作的做法。
第一步:准备一批有标准答案的查询。 这是整个测试里最难的一步。理想情况是有一批"已知相关文档"的查询集;没有的话,可以用全量精确检索的结果当基准——把早停关掉跑一遍,认为那是最优解。
第二步:同一批查询跑两遍。
# 开早停
curl -X PUT 'localhost:9200/my-vector-index/_settings' -H 'Content-Type: application/json' \
  -d '{"index.dense_vector.hnsw_enable_early_termination": true}'

# 关早停
curl -X PUT 'localhost:9200/my-vector-index/_settings' -H 'Content-Type: application/json' \
  -d '{"index.dense_vector.hnsw_enable_early_termination": false}'
第三步:比较 Top K 结果的重合度。 关注的是有多少条掉出去了。
第四步:同时记录延迟。 拿到延迟差之后,才能判断这个召回损失值不值。
能把这两组数字摆出来,决策就有依据了。只测召回不测延迟,会让你倾向于关掉;只测延迟不测召回,会让你倾向于开启——两个都要。
还有一个容易忽略的变量:K 的大小。K 越大,早停能省下的路越多,但漏掉尾部结果的概率也越高。所以测试要在你实际使用的 K 上做,不能拿 K=10 的结论去指导 K=100 的场景。
把这个流程写下来,是因为"该不该开"没有通用答案。它取决于你的数据分布、K 的大小、对延迟的敏感度。别人的结论搬不过来,只能自己测。
和别的向量检索优化放一起看
9.x 在向量检索上做了不少优化,前面写过几篇:
| 篇 | 优化 | 解决什么 |
|---|---|---|
| 低内存下的向量检索 | 低内存模式、字段级 rescoring | 向量放不进内存 |
| GPU 向量索引 | GPU 加速向量索引 | 索引构建慢 |
| 本篇 | HNSW 早停 | 查询时多走了路 |
| doc_values skippers | doc values skippers | 不过滤字段的扫描慢 |
方向各不相同,但有个共同点:都是在近似检索的框架内做权衡,而不是改变近似这个前提。
早停是这个思路的典型——它承认"已经找到足够好的了,不追求最优"。接受这一点,才能理解为什么近似检索能快。
顺着这点再想一层:为什么向量检索普遍接受"近似"? 因为精确的最近邻检索在高维空间里代价太高,而大多数业务场景(推荐、语义搜索、以图搜图)本来就不需要严格的最优——用户看不出排名第 3 和第 5 的差别,但能感知到 200ms 和 800ms 的差别。
早停把这个取舍做成了一个开关,而不是硬编码。这是对的:取舍该由使用者决定,不该由实现者替他决定。它只是把默认值定在了"多数人想要的那一边",同时留了改回去的路。
写在最后
这条改动很小:一个布尔设置,默认从"按版本算成 false"变成"按版本算成 true"。
一,早停是"结果够好就提前停",加速但可能略降召回。 具体降多少官方没给数据,也未实测——要用就自己测,测法写在正文里了。
二,默认值按索引创建版本算,升级不改变已有索引。 所以准确的说法是"9.3 之后创建的索引默认开"——这两句话的区别在排查时会很关键。
三,可以动态改,不用重建索引。 这点比那些要 reindex 的改动友好——想试错随时能改回来。
建议是显式写出来,不管要开还是关。理由是:默认值依赖"创建时间",对后来读配置的人不友好。多一行配置,省掉一次推算,也能让索引重建后的行为保持稳定。
另外诚实标注两点:早停对召回的影响幅度没有实测数据,正文里"尾部影响更明显"的说法基于机制理解;DEFAULT_HNSW_EARLY_TERMINATION 这个版本常量对应的具体版本号未逐个查证,只确认了它是 onOrAfter 的判断基准。
参考
- changelog 9.3.0:Enable early termination for HNSW by default(第 29–32 行)@ v9.4.2
DenseVectorFieldMapper.java:设置定义,默认值由索引创建版本动态计算(第 193–199 行)@ v9.4.2IndexSettings.java:取值(第 1387 行)与动态更新注册(第 1529 行)@ v9.4.2- PR 132388
本文对照 Elasticsearch
v9.4.2标签的 changelog 与源码核对,引文与代码逐字取自原文。早停对召回率的影响幅度官方未提供数据、未实测;影响集中在尾部是基于 HNSW 检索机制的推断,已在正文标注;DEFAULT_HNSW_EARLY_TERMINATION对应的具体版本号未逐个查证。撰写时未启动集群、未运行测试。