Elasticsearch 是一个非常强大的搜索引擎。
Elasticsearch简介
Elasticsearch是什么
Elasticsearch 是一个非常强大的搜索引擎。它目前被广泛地使用于各个 IT 公司。Elasticsearch 是由 Elastic 公司创建,同时,Elastic 公司也拥有 Logstash 及 Kibana 开源项目。这个三个项目组合在一起,形成了 ELK 软件栈。他们三个共同形成了一个强大的生态圈。简单地说,Logstash 负责数据的采集、处理,Kibana 负责数据展示、分析、管理。Elasticsearch 则处于最核心的位置,它可以帮我们对数据进行快速地搜索及分析。
Elasticsearch应用场景

Elasticsearch核心概念
1)索引
一个索引就是一个拥有几份相似特征的文档的集合,跟我们熟悉的关系型数据库比较的话,一个索引就相当于一个数据库。 2)索引类型(已被废弃)
索引类型相当于数据库中的表,一般同类数据会写入到同一个索引类型下面。由于多类型这个特性的收益较小,且增加了复杂度,所以已在6.0中废弃多索引类型,7.0彻底废弃自定义索引类型,仅支持默认类型"_doc"。
3)文档
是一个可以被索引的基础信息单元,相当于数据库表中的一条数据。 4)节点
ES节点主要有主节点、数据节点、协调节点,所有节点默认都是候选协调节点,协调节点的主要作用是接收请求,并转发请求到其他节点,汇总各个节点返回数据的功能。ES扩展节点很方便,一个节点可以通过配置集群名称的方式来加入一个指定的集群。这意味着,如果你在你的网络中启动了若干个节点,并假定它们能够相互发现彼此,它们将会自动地形成并加入到一个集群中。这其中没有依赖Zookeeper等外部组件,而是利用了ZenDiscovery内置模块,ZenDiscovery是ES自己实现的一套用于节点发现和选主等功能的模块。
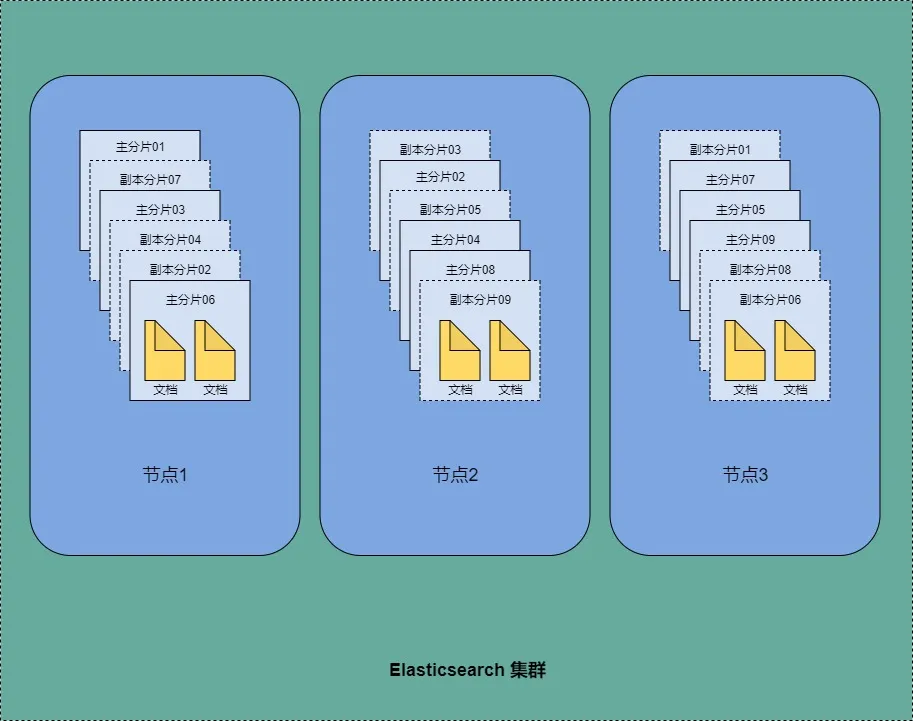
5)主分片
将索引切分,分布地放在每个分片上,分片又被放到集群的节点上,每个分片都是独立的,这样即使某个分片坏了,也不影响其他分片的查询。
6)副本分片
ES允许创建分片的一份或多份拷贝,这些拷贝就叫做副本, 他不仅可以避免单点故障问题,还可以扩展搜索量/吞吐量,因为搜索可以在所有的副本上并行运行。
ES全文搜索为什么快?
采用倒排索引(Inverted index)的概念
1)在传统数据库中,如果我们想要根据某一关键字,去查询相关的数据,往往采用模糊查询like的方式,而模糊查询会导致查询引擎放弃索引,进行全表扫描,在数据量大的情况下,查询效率是非常低下的;
2)传统数据库根据正向索引,通过主键ID找到内容,再去匹配关键字,而ES采用倒排索引的概念来存储和查询数据,通过关键字找到主键ID,再去查找文章内容,查询效率是比较高的。
正排索引:
| ID | content |
|---|---|
| 1 | hello |
| 2 | hello Data |
倒排索引:
| keyword | ID |
|---|---|
| hello | 1,2 |
| data | 2 |
分布式查询
ES的分布式检索查询分为两个阶段:查询阶段和取回阶段。
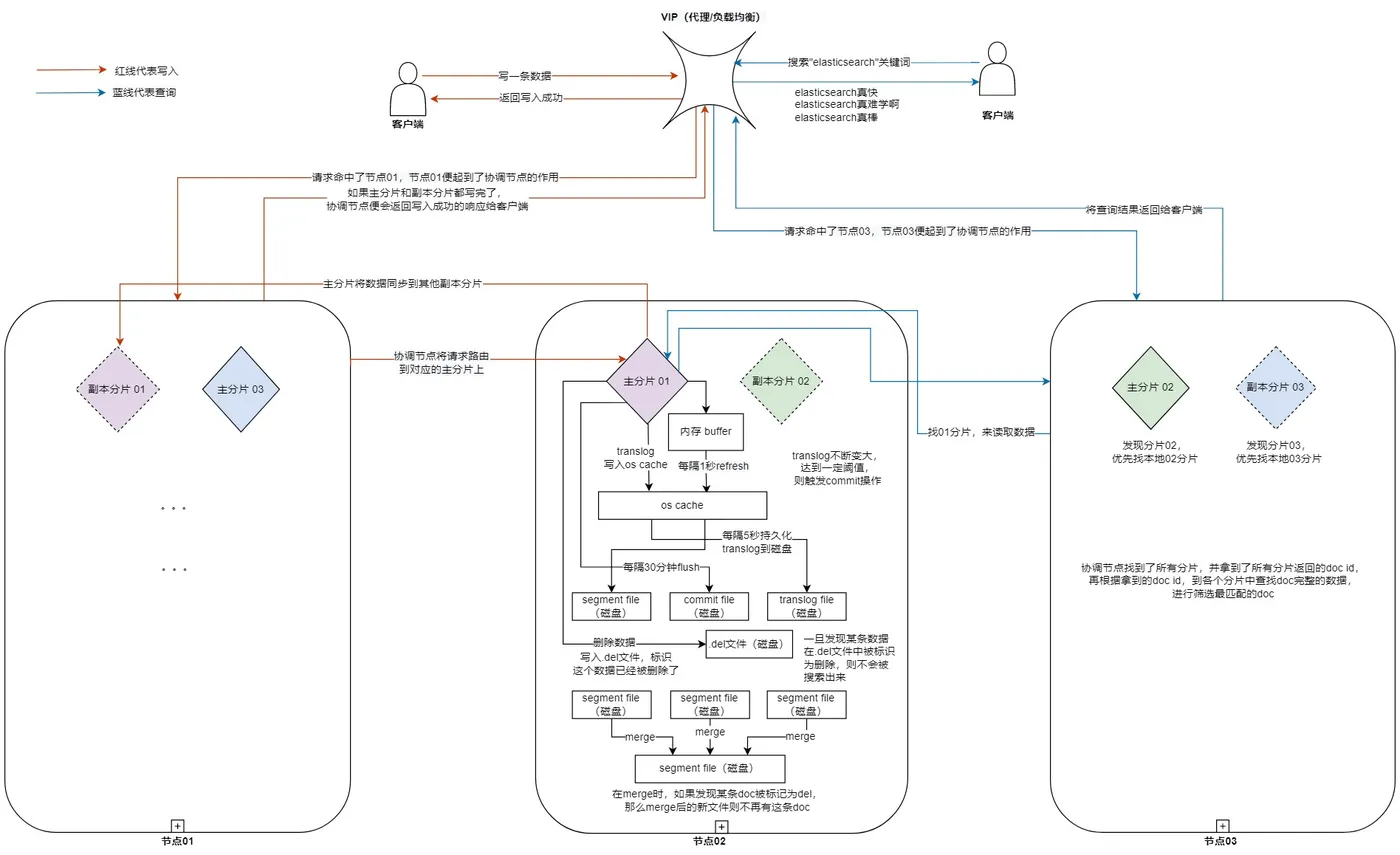
1)客户端向任意节点发送请求,比如node3节点(node3节点成为了协调节点),协调节点会对文档进行路由,将请求转发到相应的node; 2)对应的node会执行查询请求,分别查询一个索引的全部分片,并返回数据给协调节点,Node3将数据排序处理返回给客户端。
ES读写原理介绍
写入
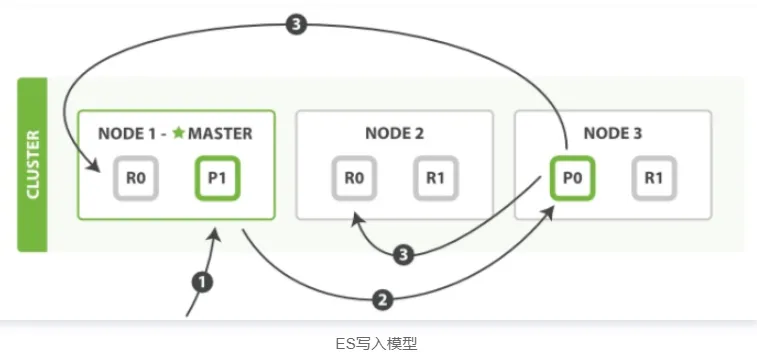
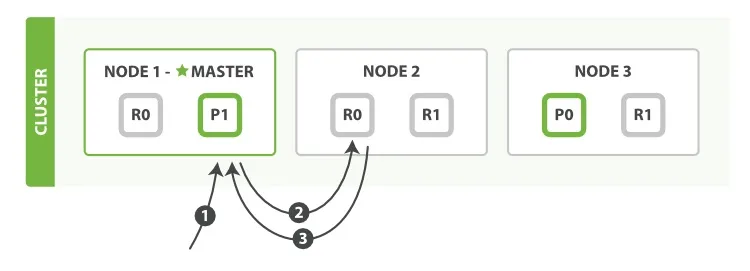
1)客户端给 Node 1 发送新建、索引或删除请求。
2)节点使用文档的 _id 确定文档属于分片 0 。它转发请求到 Node 3 ,分片 0 位于这个节点上。
3)Node 3 在主分片上执行请求,如果成功,它转发请求到相应的位于 Node 1 和 Node 2 的复制节点上。当所有的复制节点报告成功, Node 3 报告成功到请求的节点,请求的节点再报告给客户端。replication为sync,同步复制。
查询
1)对于读请求,为了平衡负载,请求节点会为每个请求选择不同的分片——它会循环所有分片副本。
2)可能的情况是,一个被索引的文档已经存在于主分片上却还没来得及同步到复制分片上。这时副本分片会报告文档未找到,主分片会成功返回文档。一旦索引请求成功返回给用户,文档则在主分片和复制分片都是可用的。
ES语法(DSL)简介
DSL语法介绍移步:Elasticsearch DSL 基本语法
- 全文检索 2. 查询指定字段 3. 排序 4. 分页查询 5. 多条件查询 6. 过滤器的使用 7. 聚合查询
ES分片调优
分片规模评估
单节点shard总数需要按照单节点JVM*60进行评估:
比如集群4个节点,64G内存规格,JVM就是32G,则为 32 60 4 = 7680。64G规格的4节点集群,理论上分片数不宜超过8000。
分片设计原则
1)主 shard 数与副 shard 数之和需要是集群数据节点的整数倍; 2)分片容量,主要分为写入和查询两个场景 (写多读少场景)索引单分片10g~20g,多分片有利于写入; (读多写少场景)索引单分片20g~40g,尽量减少分片数,可以降低热点,因为当分片数过多时,就容易出现长尾子请求,即有可能部分子请求因节点异常或 Old GC、网络抖动等延迟响应,导致整个请求响应缓慢。另一方面,拆分过多的子请求无法提升数据节点请求吞吐,不能充分利用 CPU。在尽量减少主分片数的情况下,同时也可以适当增加副本数,从而提升查询吞吐; 3)在遵循单分片设计原则的前提下,预测出索引最终大小,并根据集群节点数设计索引分片数量,使分片尽量平均分布在各个节点。
定时合并segment
一般存在更新+查询的场景,会产生很多的deleted docs以及零碎的段文件,一定程度上会增加CPU开销,可以定期做一下合并。按照每个segment 5GB 来评估 max_num_segments,根据实际情况,比如 索引A 最大的分片5gb,max_num_segments就是1
建议每天业务低峰进行一次: POST index_name/_forcemerge?max_num_segments=1