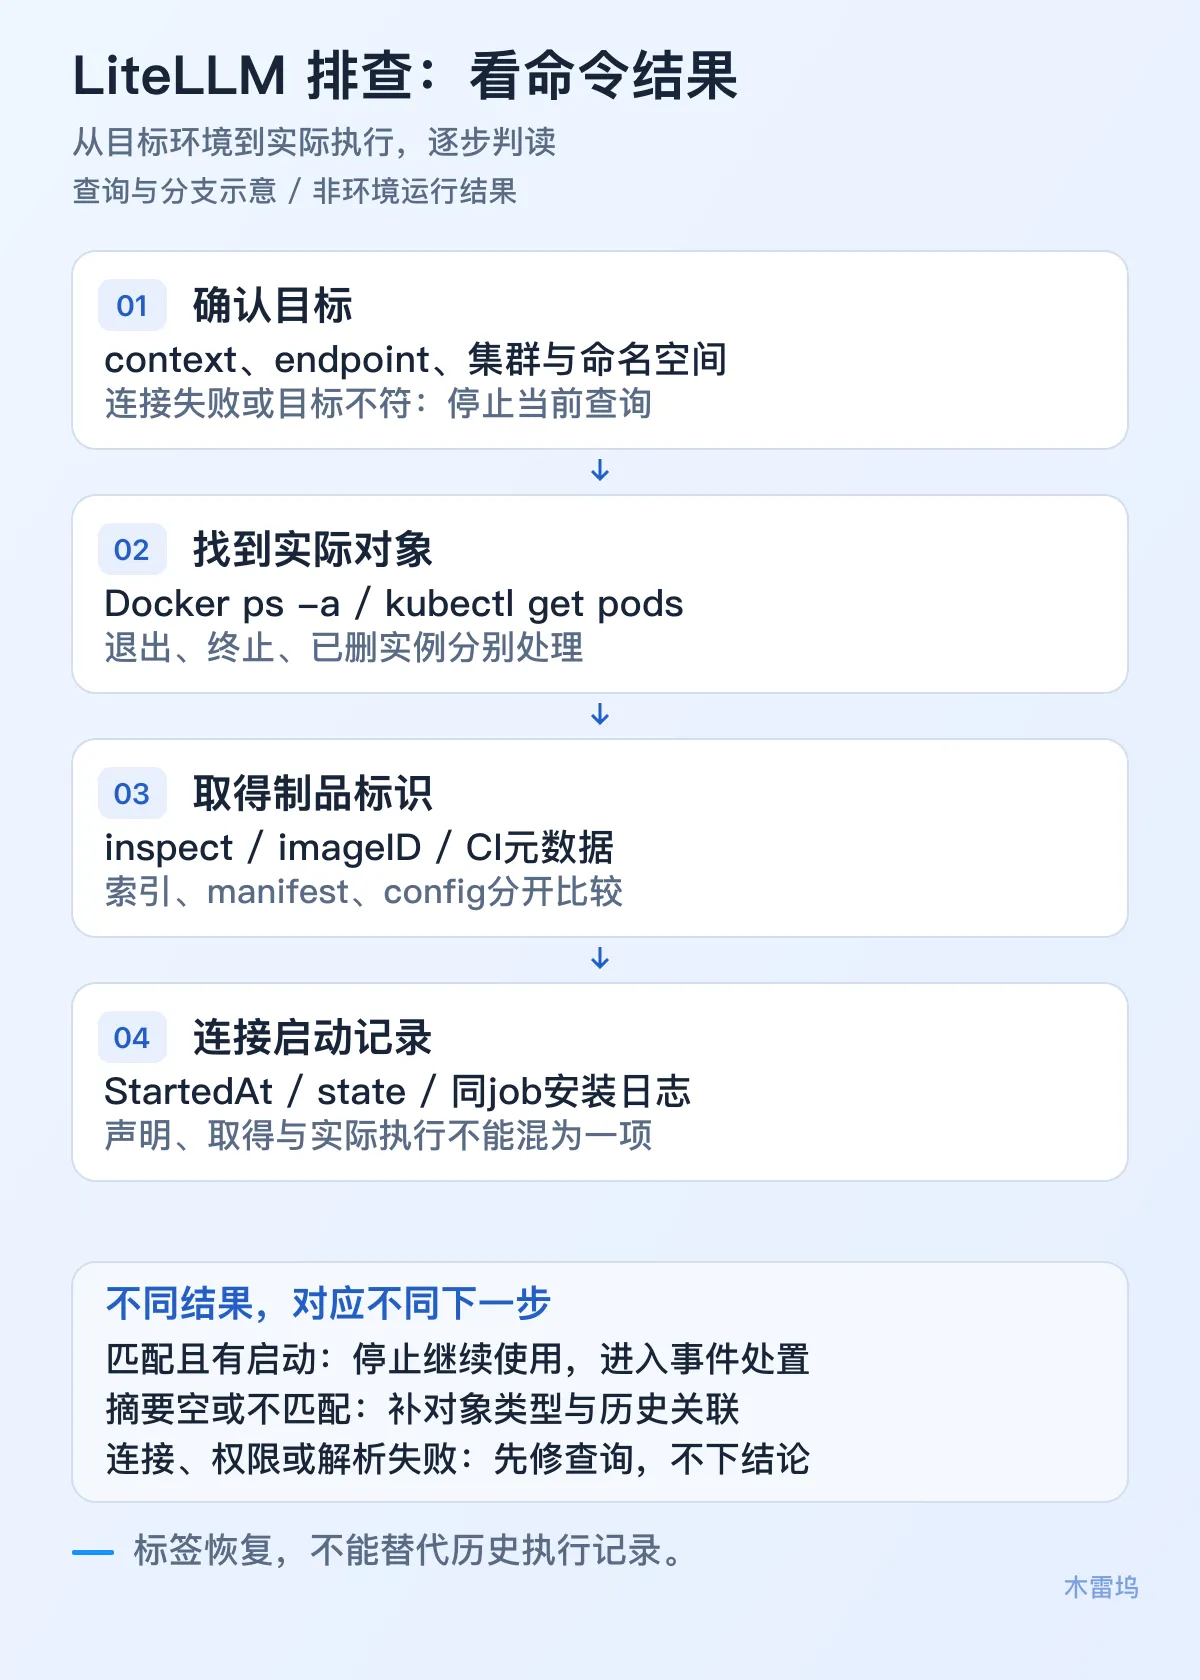
这篇直接从已有K8s部署开始:确认集群,列出Pod,逐容器核对声明和状态,再沿owner UID追旧ReplicaSet。下文所有输出均为“结构示意/非真实输出”,不是云上实测。只从可信管理终端读API,使用已有RBAC权限;不exec、debug、读取kubectl logs、运行Python或pip,不拉取镜像、不重启或滚动发布。没有权限就停止交给已有权限的管理员。
1.确认context,发现目标Pod
先查看已有上下文,再填入管理员已核实的命名空间与标签选择器。标签来自当前部署配置,不能猜一个名称当全部范围。
kubectl config get-contexts
CTX='REPLACE_CONFIRMED_CONTEXT'
NS='REPLACE_VERIFIED_NAMESPACE'
SEL='REPLACE_VERIFIED_LABEL_SELECTOR'
kubectl --context "$CTX" get pods -n "$NS" -l "$SEL" -o wide
示意输出:
NAME             READY  STATUS       RESTARTS  AGE  NODE
litellm-7c8-a1    1/1    Running      0         2d   worker-a
litellm-6b9-b2    0/1    Terminating  1         2d   worker-b
保留两行,终止中的旧副本也查。No resources found先核NS和SEL;确实无匹配时,没有POD变量,不执行第2—5步中依赖POD的命令。如果已有发布记录给出Deployment UID,可直接用第4步最后一条查询仍保留的RS;否则停止,向管理员补历史部署记录,不写“未使用”。Forbidden停止该请求,不用集群管理员权限试探;context不符先改本文CTX变量,不执行全局切换。
若仅怀疑选择器写错,可在已授权且已确认的命名空间内去掉筛选看标签,再由发布配置确认SEL;不要扩大到所有命名空间:
kubectl --context "$CTX" get pods -n "$NS" --show-labels
示意输出末列可能是app=litellm,track=stable。看到标签只能帮助定位,不能自行断言它覆盖全部历史批次;NS也不确定则停止,先核发布配置。
从输出复制一个Pod名进入第2步;第一步每个Pod都要重复第2—5步,不能只检查Running的最新一行。
2.列三类容器,先知道应该查几个
需要本地已有jq。下面从声明输出类型、容器名、镜像引用,不输出环境变量或Secret。
POD='REPLACE_POD_NAME_FROM_STEP_1'
kubectl --context "$CTX" get pod "$POD" -n "$NS" -o json |
jq -r '
  .spec as $s |
  ["initContainers","containers","ephemeralContainers"][] as $k |
  ($s[$k] // [])[] |
  [$k,.name,.image] | @tsv'
示意输出:
initContainers       prepare  example/prepare:42
containers           proxy    ghcr.io/berriai/litellm:main-stable
ephemeralContainers  diag     example/diag:3
这是待核容器名单,不是已执行证明。下一步按“类别+名称”逐个对照状态;初始化与临时容器不能漏。某类没有行,只表示当前声明没有该类对象。若Pod已NotFound,记录它已删除,停止该Pod后续查询,按第5步补历史;不要拿同名新Pod续填。
示例有三个容器,就需要三条对应状态或明确缺口。若镜像是业务方自建名称,仍追该构建批次的依赖记录;只看名称没有litellm不够。配置写了固定tag也只固定一个名字,不能代替当时取得的制品摘要。
3.取状态imageID,缺状态就保留缺口
kubectl --context "$CTX" get pod "$POD" -n "$NS" -o json |
jq -r '
  ["initContainerStatuses","containerStatuses",
   "ephemeralContainerStatuses"][] as $k |
  (.status[$k] // [])[] |
  [$k,.name,.image,(.imageID // "—"),
   ((.state | keys[0]) // "—")] | @tsv'
示意输出,摘要仅为缩写:
initContainerStatuses       prepare  example/prepare:42  containerd://sha256:aaaa…  terminated
containerStatuses           proxy    ghcr.io/berriai/litellm:main-stable  containerd://sha256:bbbb…  running
ephemeralContainerStatuses  diag     example/diag:3      —                          waiting
prepare虽已结束仍要核;proxy的镜像标识待关联制品;diag没有imageID,不能判未运行过。若第2步有容器而这里没有对应行,标“状态未取得”,不可从名单中删掉。状态image与声明也可能不同,保留原值,不用一个覆盖另一个。
如果看到waiting,下一步只读等待原因,不尝试重新拉取:
kubectl --context "$CTX" get pod "$POD" -n "$NS" -o json |
jq -r '
  ((.status.initContainerStatuses // []) +
   (.status.containerStatuses // []) +
   (.status.ephemeralContainerStatuses // [])) |
  .[] | select(.state.waiting != null) |
  [.name,(.state.waiting.reason // "—")] | @tsv'
示意输出为diag ImagePullBackOff,说明当前等待分支;不是历史从未执行。若无等待行,回到已取得的状态逐条核对,不追加调试容器。
继续读取选定Pod节点与平台;尚未调度时明确停止节点查询:
if ! NODE=$(kubectl --context "$CTX" get pod "$POD" -n "$NS" \
  -o jsonpath='{.spec.nodeName}'); then
  printf '%s\n' '节点字段查询失败:停止,保留错误类别'
elif [ -n "$NODE" ]; then
  kubectl --context "$CTX" get node "$NODE" \
    -o custom-columns='NODE:.metadata.name,ARCH:.status.nodeInfo.architecture,RUNTIME:.status.nodeInfo.containerRuntimeVersion'
else
  printf '%s\n' '尚无节点:平台和运行时待取得'
fi
示意输出:
NODE      ARCH   RUNTIME
worker-a  amd64  containerd://2.x
节点Forbidden只记平台未知,不能由其它节点代填。imageID的含义依运行时与后端确认,不直接等于公告index;缺失、不匹配、不同架构都不能直接排除风险。需要同仓库、同摘要对象或已建立父子映射才比较,不下载恶意制品补映射。
到这里按三类结果继续:tag命中公告名单,保留声明与状态,继续第4—5步追批次和运行时间,不能只看今天tag;digest已核为同仓库同对象或可关联子对象,命中受影响制品就停止现场验证、交接响应,不匹配仍核历史;旧Pod或RS已删,不再对失效名称重复查询,转第5步的历史补证分支。自建tag则补CI中的wheel和基础镜像输入,不能拿业务镜像ID直接排除。
4.沿owner UID找到控制器,别只看名字
kubectl --context "$CTX" get pod "$POD" -n "$NS" -o json |
jq -r '.metadata.ownerReferences[]? |
  select(.controller == true) | [.kind,.name,.uid] | @tsv'
示意输出:
ReplicaSet litellm-7c8 rs-uid-7
若为ReplicaSet,取其名称继续;其它控制器按输出类型交给对应负责人追溯,不能硬套RS。空结果说明未取得控制器关联,停止自动串联。
RS='REPLACE_REPLICASET_NAME_FROM_STEP_4'
kubectl --context "$CTX" get replicaset "$RS" -n "$NS" -o json |
jq -r '
  (["SELF",.metadata.name,.metadata.uid] | @tsv),
  (.metadata.ownerReferences[]? | select(.controller == true) |
   [.kind,.name,.uid] | @tsv)'
示意输出:
SELF        litellm-7c8  rs-uid-7
Deployment  litellm      deploy-uid-1
SELF UID必须与上条owner UID一致。不同就停止关联:同名对象可能重建;NotFound表示RS已删除,按第5步补记录。确认Deployment owner后,把它的UID代入下条,列仍保留的新旧RS:
DEPLOY_UID='REPLACE_DEPLOYMENT_UID_FROM_PREVIOUS_OUTPUT'
kubectl --context "$CTX" get replicasets -n "$NS" -o json |
jq -r --arg uid "$DEPLOY_UID" '
  .items[] |
  select(any(.metadata.ownerReferences[]?;
    .controller == true and .uid == $uid)) |
  [.metadata.name,.metadata.uid,.metadata.creationTimestamp,
   (.spec.replicas | tostring),
   ([((.spec.template.spec.initContainers // []) +
      (.spec.template.spec.containers // []))[] |
      .name + "=" + .image] | join(","))] | @tsv'
示意输出:
litellm-7c8  rs-uid-7  2026-10-21T12:00:00Z  2  proxy=example/litellm:42
litellm-6b9  rs-uid-6  2026-10-21T11:50:00Z  0  proxy=example/litellm:41
最后一列是模板中的初始化和普通容器引用,仍不是实际运行证据。旧RS副本0只说明当前期望数量,不能证明它未运行过;用旧引用接着查对应构建与发布批次。结果为空或Forbidden,停止“历史完整”的判断;旧RS也可能已被清理。
示例的新旧RS都关联同一个Deployment UID,才能归到同一控制器历史;名字相近但owner UID不同的对象不能合并。若发现旧模板仍用浮动tag,保留原引用,向该批次补当时解析摘要,不拿今天同名tag的结果覆盖。
5.看终止记录,再对回事件
kubectl --context "$CTX" get pod "$POD" -n "$NS" -o json |
jq -r '
  .metadata.uid as $uid |
  ["initContainerStatuses","containerStatuses",
   "ephemeralContainerStatuses"][] as $k |
  (.status[$k] // [])[] |
  [$uid,$k,.name,
   (.state.running.startedAt // .state.terminated.startedAt // "—"),
   (.state.terminated.finishedAt // "—"),
   (.lastState.terminated.finishedAt // "—")] | @tsv'
示意输出:
pod-uid-1 containerStatuses proxy 2026-10-21T13:11:00Z — 2026-10-21T13:10:00Z
后三列分别为当前状态启动、当前终止、上次终止时间;空值不能补“从未退出”。lastState不是完整重启史。Pod已删时,当前API无法补回它:向管理员取得当时保留的审计、发布或集中采集记录,按Pod UID关联;没有记录就止于“历史证据缺失”,不以当前新Pod证明旧Pod安全。记录中可能有秘密,仅保留镜像、UID、时间等必要字段。
LiteLLM通告的北京时间窗口均在10月21日:PyPI七个1.107.0 wheel为19:39:51—21:23;Hub四tag为19:46:56—22:20;GHCR同tag自19:46:56起、至21:51已不可用。四tag为v1.107.0、latest、main-latest、main-stable。Hub受影响index为:
sha256:1bbcb1443bc962e45f5aad53fe3d2c30600e0379715fb6c664cdd3ac126c339e
GHCR的database与non_root变体须分别核摘要。Pod创建与RS创建都不是拉取时间;窗口内取得的制品可以晚些才执行。确认历史制品或相关wheel命中,就停止现场试跑,交接事件响应;当前tag干净、Pod Ready不能排除过去暴露。凭据处理由所有者确认范围,本文不自动删证据或轮换。
示例当前启动13:11Z即北京时间21:11,在Hub窗口内;上一条终止13:10Z也不能补出更早每次执行。应把时间、Pod UID、容器名和已核摘要对象一并关联。只有运行时间没有制品映射时,保留待核行;有确切关联再升级为受影响处置,不能把两种结论混在一起。
依据:LiteLLM 10月21日官方通告、Kubernetes官方容器状态与owner、镜像及Pod生命周期资料;核验日期2026年10月23日。调查仍在进行,示例没有在真实集群运行。