在企业数据平台中,Schema、SQL 查询日志、数据处理代码和业务文档记录了大量与企业数据相关的信息。当中,Schema 负责描述表结构和字段类型,历史 SQL 用来反映常见的查询方式,业务文档则记录指标口径、数据限制和使用规范。一般来说,这些企业数据会分散在不同的系统中,由数据研发人员在开发和分析过程中分别查找数据来源。
随着 Agent 开始参与企业数据查询与分析,如何将这些已有信息整理成可供 Agent 使用的上下文,成为数据平台的一项工程任务。除了数据集和字段信息,Agent 还需要获取表之间的关联关系、业务定义以及特定的查询约束。
上周 LinkedIn 公开了内部的 Data Context Layer 工程实践。它通过自动化的流水线从 Schema、SQL 日志、源代码等来源提取数据知识,结合人工维护的业务规则,构建了统一的数据上下文,并通过索引和 MCP 提供给 Agent。
借此机会,我们来讲讲数据工程的事情。
(小字)注:下文将会以 LinkedIn 的实现为主线,结合 Uber、Snowflake 等企业的工程实践,介绍数据上下文的生成、维护、索引和检索机制,以及这些机制如何支撑 Agent 对企业数据的理解与使用
构建数据上下文:从元数据到使用知识
数据平台通常维护了大量元数据,包括表名、字段类型、分区信息、数据血缘以及资产归属。但这些信息未必能够完整地说明应该如何使用数据。
例如,某张事实表可能包含 user_id、event_date、event_type 等字段。Agent 可以根据字段名称构造查询语句,却无法仅凭这些信息确定哪些事件属于有效活跃行为,以及查询时是否需要排除重复记录。
为此 LinkedIn 设计了 AI Enrichment Pipeline,定期处理数据资产的相关信息,为数据集生成基础上下文。
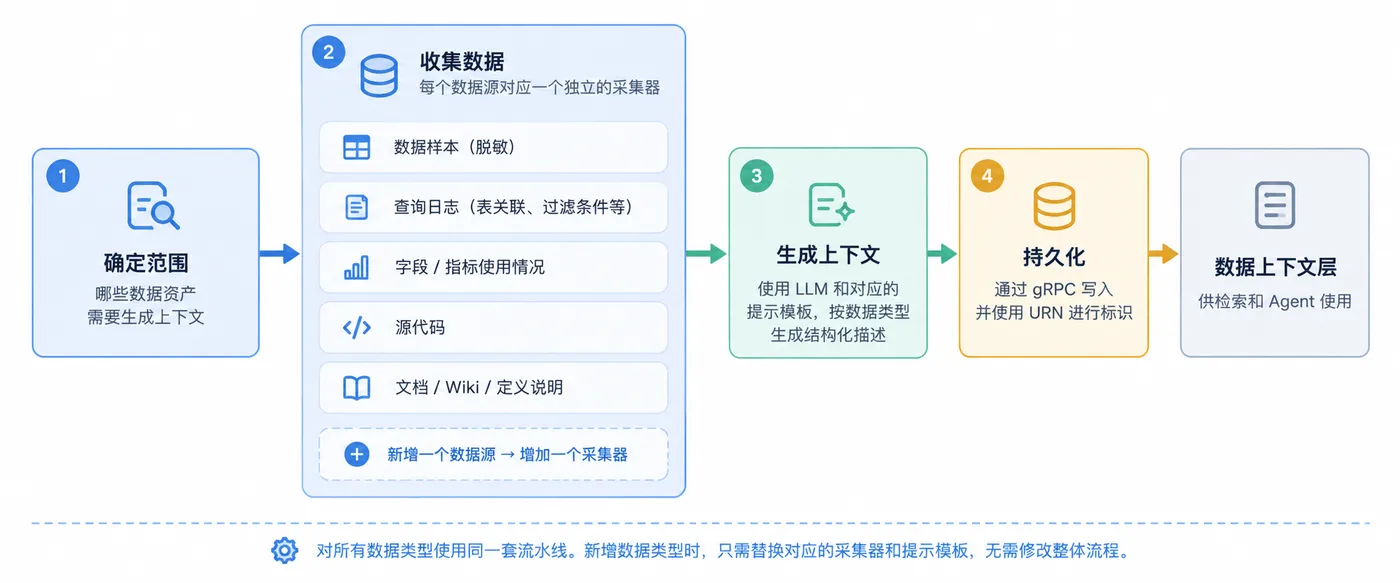
图注:AI Enrichment Pipeline 的四阶段流程图,原图源@Linkedin
整个流程分为四个阶段:
Nomination(资产筛选):确定需要生成或更新上下文的数据资产。
Collection(信息采集):通过不同的 Collector,收集数据样本、SQL 查询日志、字段与指标使用情况、源代码及相关文档。
Generation(上下文生成):根据数据资产类型,使用对应的 Prompt 模板,由 LLM 将采集的信息整理成结构化的数据集描述。
Persistence(持久化):通过 gRPC 将生成结果写入数据上下文层,并使用 URN 标识对应的数据资产。
数据资产如何进入处理流程
先利用数据目录中的标签筛选需要处理的资产,包括业务关键数据集、跨组织共享的数据集,以及支撑重要仪表盘的数据集。各团队也可以通过 DataHub 主动提交资产,或提供需要优先处理的数据集清单。
正式采集前,系统会检查这些资产是否已有上下文,以及是否需要更新。对于已有且无须更新的内容,可以直接跳过;如果团队明确提出刷新请求,则重新执行生成流程。
通过这种筛选和更新机制,LinkedIn 可以避免反复处理无需更新的数据资产,减少不必要的数据采集和模型调用开销。对于拥有大量数据集的企业数据平台,这也有助于将计算资源优先分配给业务重要性更高、更新需求更迫切的数据资产。
从多个来源收集上下文
进入 Collection 阶段后,通过可扩展的 Collector 采集不同来源的信息,包括提供表结构和字段类型的 Schema、反映字段使用及关联方式的历史 SQL,以及 Spark、Airflow、dbt 等数据处理代码。此外,Wiki 和指标定义也会被纳入采集范围,用来补充数据的业务含义。
此外,这里还可以采集少量经过脱敏的数据样本(可以默认获取 5 行数据),并对部分维度的字段统计常见取值及其出现频率。例如,某个字段名为 status,仅凭 Schema 很难判断其具体含义,但结合 completed、cancelled、pending 等实际取值,模型就能更准确地理解该字段的用途。对于涉及敏感信息的字段,系统可以结合字段级注释、安全分类及其他保护措施进行脱敏,避免将原始敏感数据直接传入模型。
数据采集完成后,LLM 会综合这些信息,生成包含数据集用途、字段解释、关联键和代表性查询的数据集描述。整个流程支持扩展 Collector,并针对不同资产类型配置相应的 Prompt 模板,方便后续接入新的数据来源和资产类型。
SQL 模式挖掘:从查询历史中提取隐含规则
在数据上下文生成机制中,SQL 日志分析是一个值得关注的环节。许多数据使用规则不一定直接体现在表结构中,例如查询时需要添加特定的分区过滤条件、关联维度表时需要使用指定字段,或计算某项指标时需要进行去重等查询细则。虽然细则不会体现在表结构中,但这些规则往往可以从历史 SQL 的使用模式中发现蛛丝马迹。
因此,我们可以从共享查询引擎的历史日志中提取 SQL,同时借助日志记录的输入表信息,确定每条查询涉及哪些数据集。不过,同一种查询可能因为日期、用户 ID 等参数不同,产生大量文本各异的 SQL。如果直接统计原始的查询文本,其实很难识别出当中重复出现的查询模式。
SQL 规范化与模式聚合
这里需要对 SQL 执行规范化处理,包括:
删除 SQL 注释;
将 SQL 中的具体值替换为统一占位符;
将不同长度的 IN 列表统一为相同结构;
规范化空白字符;
以以下两条 SQL 为例:
SELECT COUNT(DISTINCT user_id)
FROM feature_events
WHERE event_date = '2026-10-18'
  AND is_valid = 1;
SELECT COUNT(DISTINCT user_id)
FROM feature_events
WHERE event_date = '2026-10-19'
  AND is_valid = 1;
两条 SQL 仅有日期参数不同。规范化后,可以得到相同的查询语句结构:
SELECT COUNT(DISTINCT user_id)
FROM feature_events
WHERE event_date = ?
  AND is_valid = ?;
随后,系统按照规范化后的 SQL 结构统计执行次数,并根据出现频率对查询模式进行排序。这样,即使同一种查询使用了不同参数,也能被归为同一模式,进而识别出常见的查询方式。
这些信息可以用于补充数据集描述,帮助 Agent 了解常用的聚合方式、过滤条件和查询模式。
补充源代码中的数据使用信息
仅分析共享查询引擎的日志,其实是难以覆盖所有的数据使用场景。当中有部分数据集主要通过离线任务、定时 Pipeline 或应用代码访问,相关的数据使用方式未必会完整地记录在查询日志中。
为补充这部分信息,数据系统还得通过其他 Collector 搜索 Spark 作业、Airflow Pipeline、分析脚本、dbt 文件和指标定义,从中识别数据集在 ETL 流程中的作用、常见的表关联关系,以及查询日志中较少涉及的数据资产及其使用方式。
此外,还要区分临时查询和仪表盘自动生成的查询,避免将不同来源的使用行为混在一起分析。
高频查询与正确查询的边界
SQL 模式挖掘能帮助系统识别常见的数据使用方式,但查询频率并不能直接反映业务规则的正确性。
例如,某条 SQL 虽然业务过滤条件是错误的,但由于它被定期执行,这类查询会在历史日志中高频出现。如果仅根据执行频率判断查询模式是否可靠,就可能将错误的过滤条件纳入数据上下文。
因此,历史 SQL 可以作为生成数据上下文的参考依据,而涉及具体业务口径的规则,还需要结合指标定义、数据所有者的审核或经过验证的查询示例进行确认。
针对这一问题,LinkedIn 引入人工维护的业务知识,补充自动生成的上下文中可能缺失的指标定义、使用限制等信息。具体的管理与更新机制将在下文展开。
Snowflake Cortex Analyst 则提供了另一种处理方式:将经过验证的自然语言问题与对应 SQL 保存到 Verified Query Repository(VQR)中。当 Agent 遇到相似问题时,可以参考这些已验证的查询,减少对未经验证的历史 SQL 的依赖。
这两种实践都涉及一个问题:如何从历史查询中提取可复用的数据知识,并确保其中的业务规则能够得到验证和持续维护。
上下文管理:自动生成与人工维护分层
LinkedIn 将数据上下文分为两类:自动生成的上下文和人工维护的上下文。
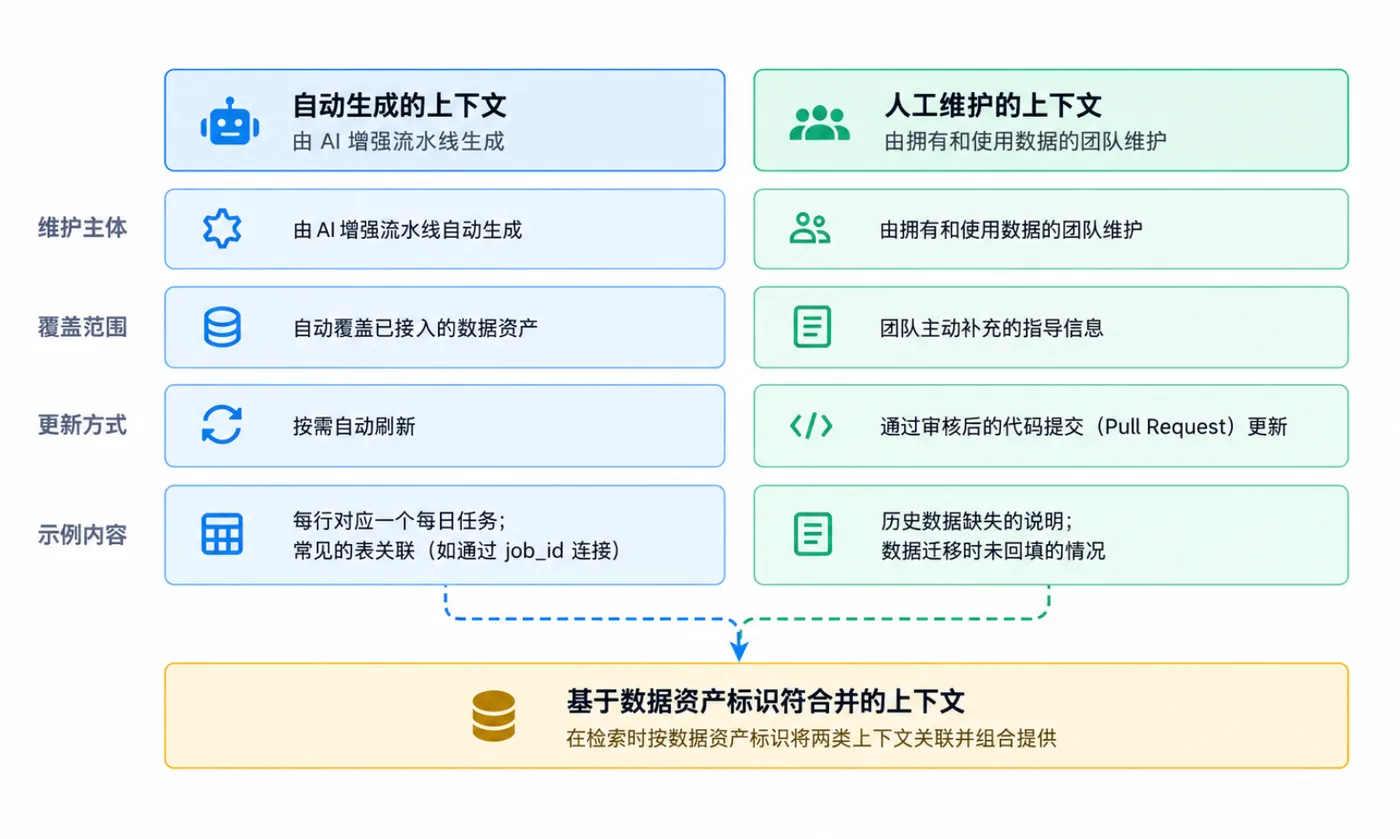
图注:上下文管理示意图,原图源@Linkedin
自动生成的上下文由流水线生成,并根据数据资产的状态及刷新需求进行更新,主要记录数据集的基本结构、常见使用方式和代表性查询。人工维护的上下文则由相关团队负责,补充业务定义、特殊使用条件、已知的数据质量问题,以及对自动生成内容的修正和说明。
两类上下文分别存储,通过数据资产标识符建立关联。当 Agent 查询某项数据资产时,系统会将对应的自动生成内容与人工维护内容合并返回。这样既能持续更新数据集的基础信息,也能保留数据研发人员积累的业务规则和使用经验。
Context as Code
LinkedIn 使用 Git 管理人工维护的上下文。开发者将相关知识写入 Markdown 文件,通过 Pull Request 提交修改,再根据内容的作用范围,由对应的数据资产所有者或团队进行审核。系统还会通过自动化检查,识别缺失或重复的内容。
上下文文件由 Markdown 正文和 YAML Frontmatter 组成。其中,正文记录具体的数据使用知识,Frontmatter 则保存 summary 等元数据,供后续构建索引使用。
例如,一份数据集使用说明可以采用以下格式:
---
summary: "用户行为事件表的查询规则和已知限制"
---
正文可以记录数据粒度、常用关联键、必要的过滤条件及特殊限制。通过这种方式,数据上下文可以像代码一样进行版本管理,规则变更能够通过提交记录追溯,并在审核后发布到上下文系统。
三种不同作用域
人工维护的上下文有三个主要作用域:
Global Context:记录公司范围内共享的数据集和指标定义,由数据目录中对应的资产所有者负责审核。
Team Context:保存团队内部的领域知识、操作手册、已知问题和数据使用说明。
Analysis Context:保存经过审核的历史分析结果,包括分析结论、方法、假设、数据来源及使用的 SQL。
其中,Analysis Context 尤其值得关注。在实际数据分析中,复杂问题往往需要经过多轮探索才能得出结论,但其他人员遇到类似问题时,通常只能找到最终的报表或 SQL,难以了解当时的分析过程及相关约束。
将这些经过审核的分析过程保存为可复用的上下文,可以帮助 Agent 在处理类似问题时参考已有的分析方法、结论和查询依据。
版本发布与资产关联
每份上下文文件都有唯一的 URN,其他文件可以通过 URN 引用已有内容,避免重复维护。
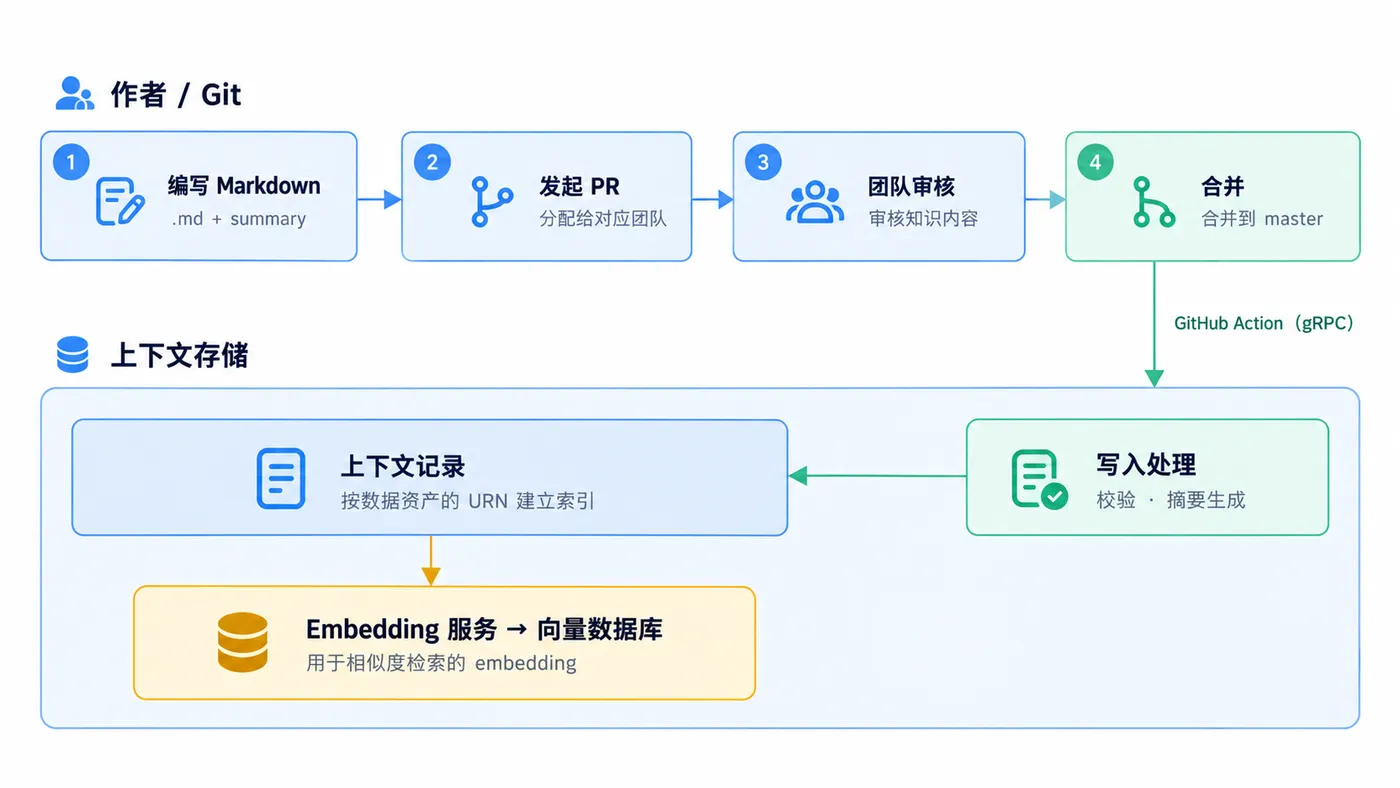
图注:从 Pull Request 到 Data Context Layer 的发布与索引流程图,原图源@Linkedin
Pull Request 合并后,自动化工作流会将变更同步到 Data Context Layer,保存完整内容及摘要,并更新相关检索索引。此外,系统还支持读取 Pull Request 分支中尚未合并的上下文,方便开发者提前测试修改后的内容能否被 Agent 正确检索和使用。
上下文检索:如何向 Agent 提供所需信息
完成数据上下文的生成与维护后,还需要考虑如何高效检索这些信息。企业内部积累了大量数据集描述、业务规则和历史分析记录,如果每次查询都加载全部内容,不仅会增加 Token 开销,还可能引入与当前任务无关的信息。
这里可以采用渐进式加载机制,让 Agent 根据任务需求,逐步定位并读取所需的上下文。
分层索引与按需加载
系统按照组织、团队和内容分类构建树状索引,每个索引节点记录子节点的名称和摘要,帮助 Agent 判断下一步需要读取哪些内容。
索引采用自底向上的方式构建,先整理具体文档的摘要,再逐层生成上级索引。当文档发生变化时,只需更新受影响的节点及其上级索引。
Agent 检索时则从顶层开始,逐步缩小搜索范围。例如,查找某个营收指标的定义时,可以先定位相关业务团队,再进入指标分类,最后根据文档摘要找到目标内容。LinkedIn 在原文中给出了一个示例:Agent 只需经过四次索引读取,就能定位目标文档,避免加载大量无关信息。
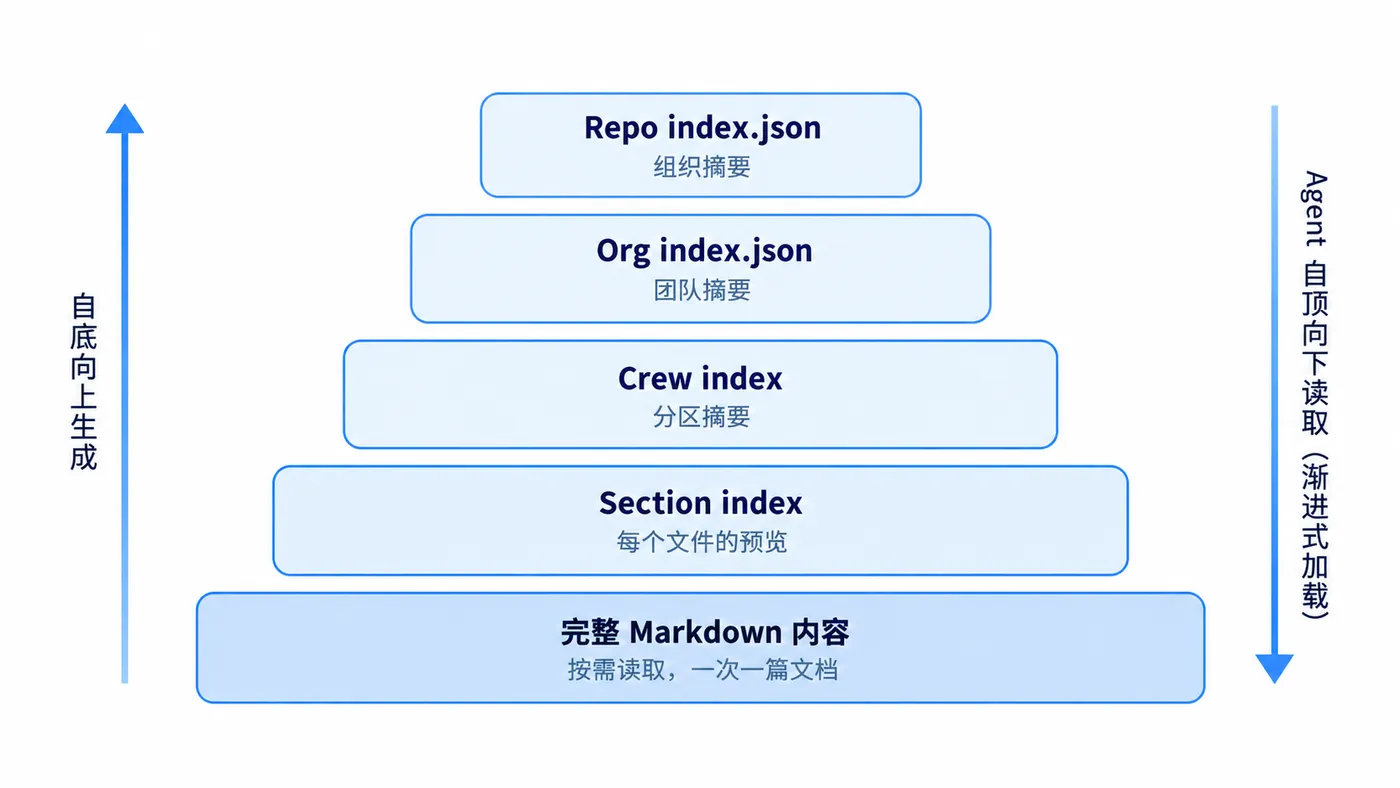
图注:Progressive Disclosure 分层索引示意图
类似的上下文筛选思路也出现在 Uber 早期的 QueryGPT 实践中。它通过 Intent Agent、Table Agent 和 Column Prune Agent,依次确定业务范围、选择数据表并裁剪字段,减少进入模型的 Schema 内容。
通过 MCP 提供统一访问入口
除了分层索引,LinkedIn 还支持通过 Embedding 进行语义检索。Agent 可以根据问题搜索相关知识,也可以沿着索引逐层导航;如果已经知道目标文档的 URN,还可以直接读取对应内容。
这些能力通过 MCP 提供给 Agent,其他应用则可以通过 gRPC API 接入。对于内部员工,DataHub 仍然是查看数据资产及相关上下文的入口。
这样一来,Agent 可以先发现相关数据资产,再按需读取数据集描述、业务规则和历史分析记录,无须在任务开始时就加载全部上下文。
实践效果与工程取舍
LinkedIn 公布了两组早期评估结果。在某个业务领域的基准测试中,接入 Data Context Layer 后,经过权限调整的 Agent 可接受答案率从 25.9% 提升至 79.5%。另一项比较显示,Agent 完成问题回答的端到端耗时中位数从 10.7 分钟降至 4.7 分钟。
从工程角度看,这套方案还面临上下文准确性、更新及时性和检索质量等问题。例如,自动生成的描述可能继承历史 SQL 中的错误规则,人工维护的业务知识也可能随着数据模型变化而过时。
LinkedIn 已通过人工审核、按需刷新和索引更新处理了其中部分问题,后续还将继续完善搜索、评估和 Agent 集成机制。
结语
LinkedIn 的 Data Context Layer 将数据上下文的生成、维护和检索连接成了一套工程流程。从 Schema、SQL 日志和源代码中提取数据使用知识,再通过人工审核补充业务规则,最终利用分层索引、语义检索和 MCP 向 Agent 提供相关内容。
其中,SQL 模式挖掘、Context as Code 和渐进式加载是比较值得关注的三个设计。它们分别处理数据使用知识的提取、业务规则的持续维护,以及 Agent 如何按需获取上下文的问题。
对于已经建立数据目录和元数据管理系统的团队,这套实践提供了一个参考方向:利用现有的数据资产、查询历史和业务文档,逐步构建可维护、可检索的数据上下文,让 Agent 在分析任务中能够获取更完整的数据使用依据。