这期的「周一上线」,Agent 继续往更长的任务和更具体的工作里走。SWE-2 开始压缩 Agent 的无效探索,Muse 会自己在后台持续工作,DeepSeek V4.1-Flash 则继续从长上下文成本下手。
Agent 的工作边界也在继续外扩:HyperFrames 把视频交给 Agent 来“写”,Marketing Skills 又把 Skill 推进营销流程。另一边,Astra 的需求让 OpenAI 暂停 200 美元 Pro 新订阅,DeepSeek 开始集中补工程岗,Cognition 新一轮融资超 20 亿美元。
开发者朋友们还是照常整活:让果蝇写汇编、把 250 万行代码摊成地图,再用 280 个字符点一把火……
下面,开始一周回顾。
有点新鲜
「有点新鲜」收录本周 AI / 开发者圈里那些不算大新闻,但挺值得看一眼的新鲜事。
Gemini:别管走了多少步,你就说到没到吧
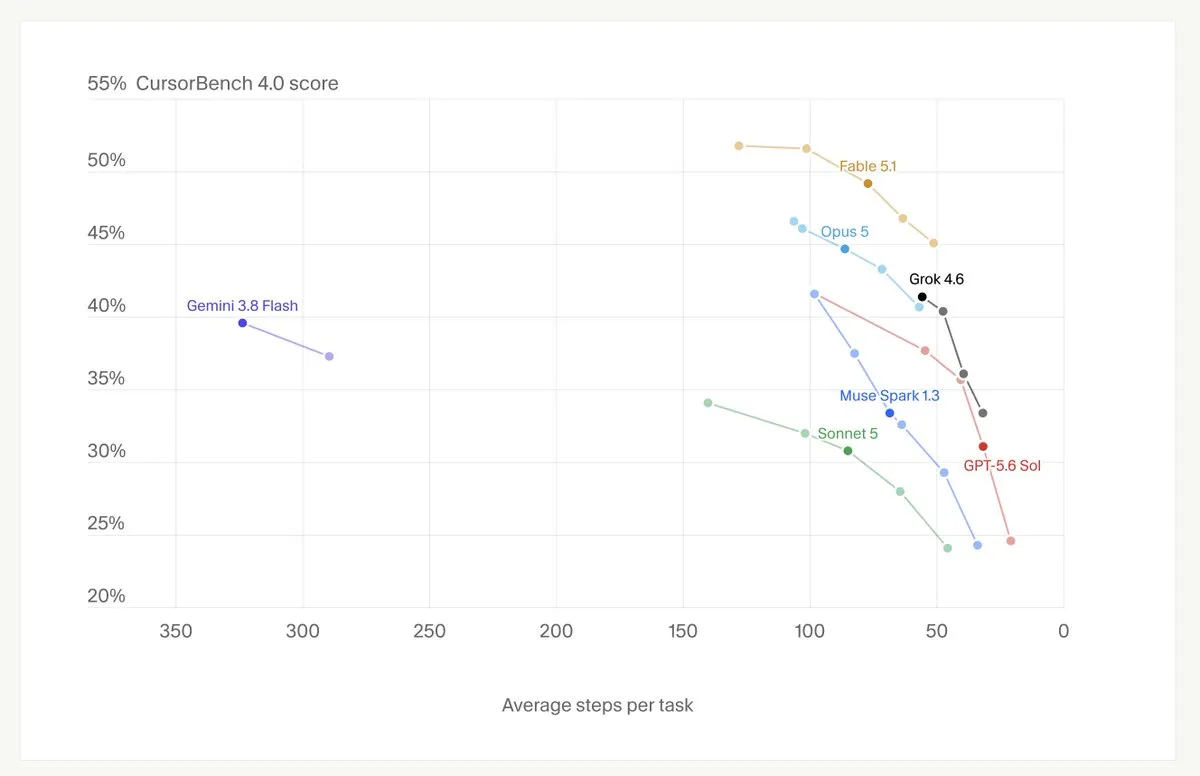
Cursor 更新了 CursorBench 4.0,结果 Gemini 3.8 Flash 跑到了图的最左边。别人完成一个任务大多几十到一百多步,Gemini 3.8 Flash High 平均要走 324 步,最后拿到 39.6% 的成绩。
Google:最近还得靠果蝇撑场面
Google 刚用 AI 拼出雄性果蝇的完整脑图谱,网友已经顺手把它捧成了新顶流:一会儿让它解魔方、写 x86-64 汇编、管 Kubernetes……
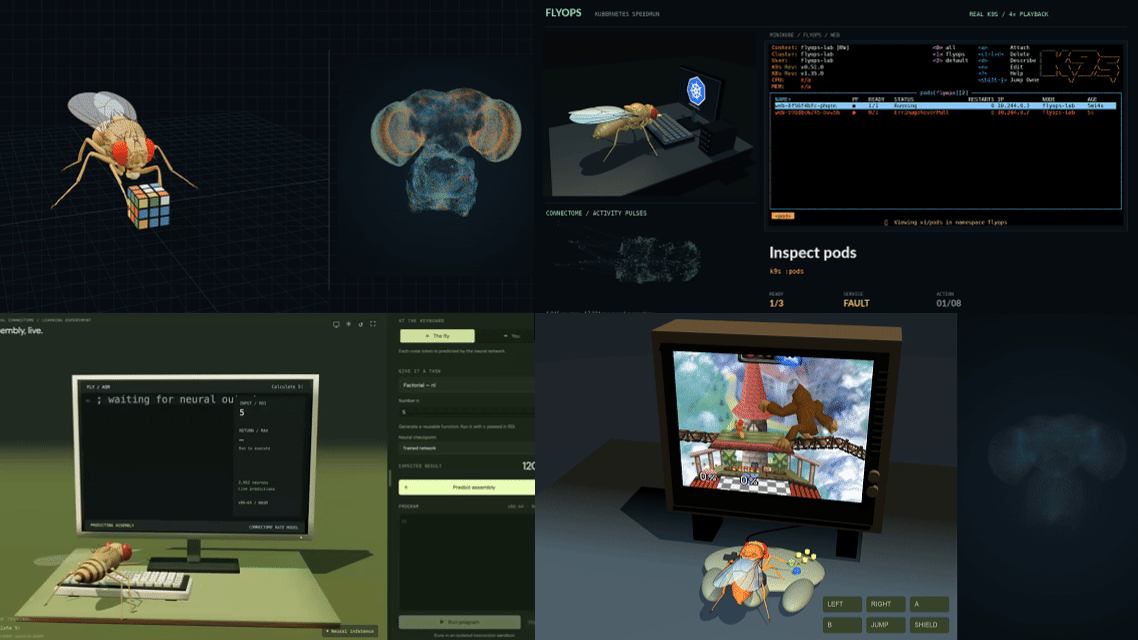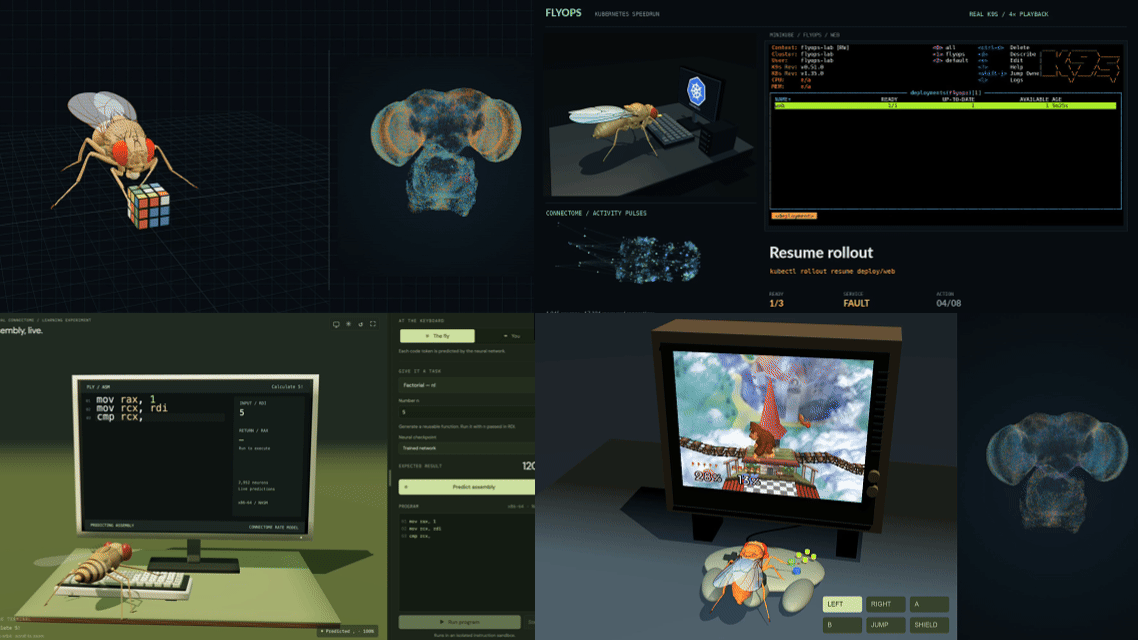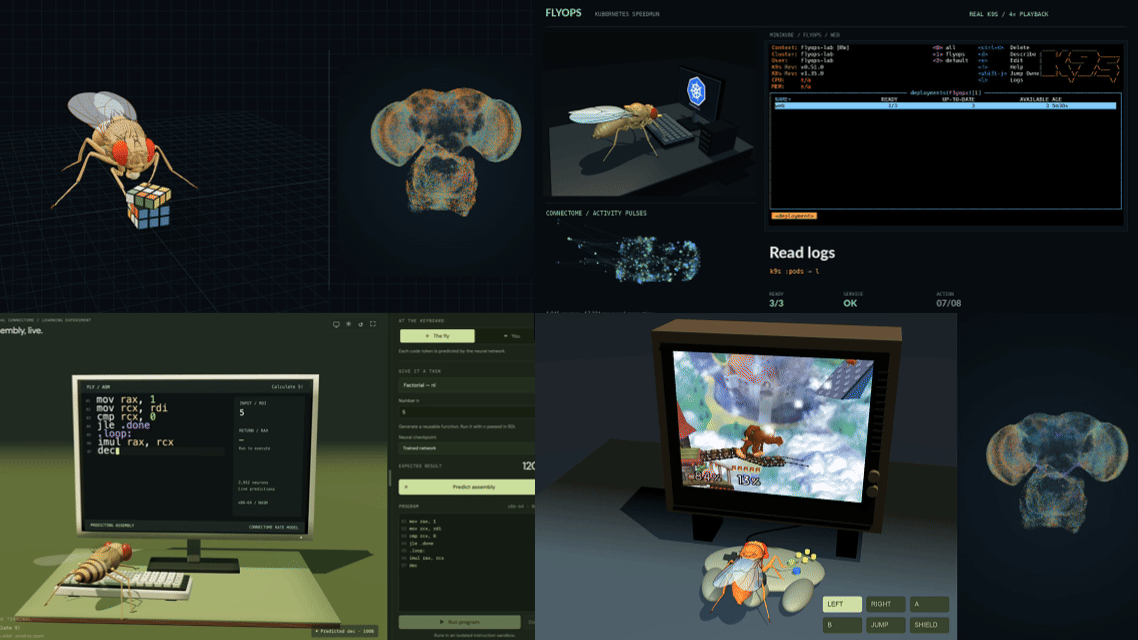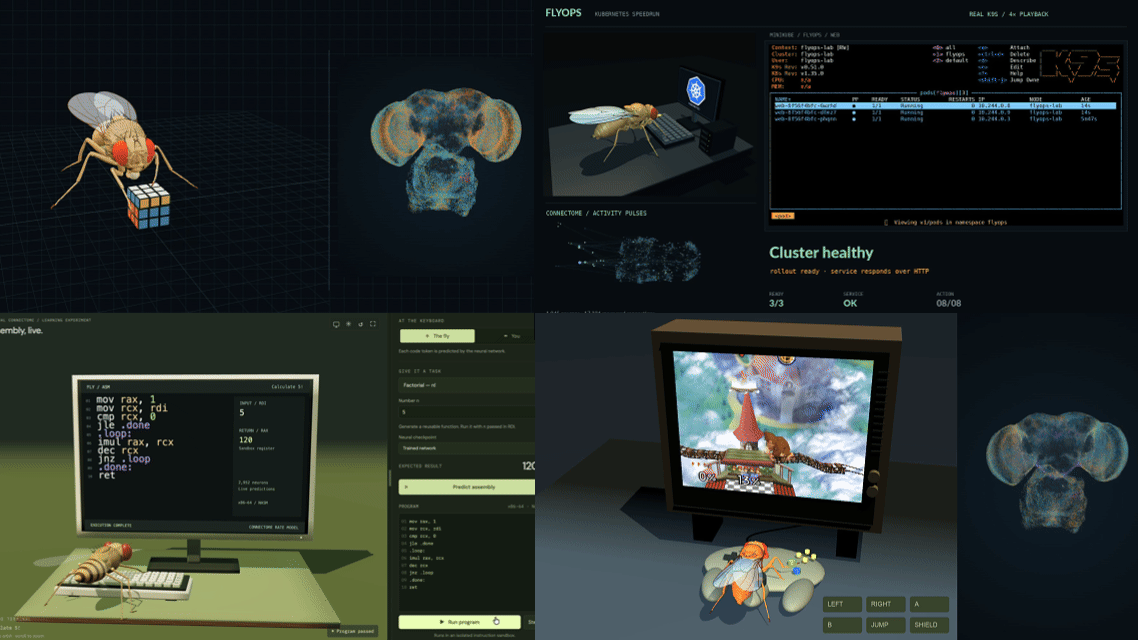
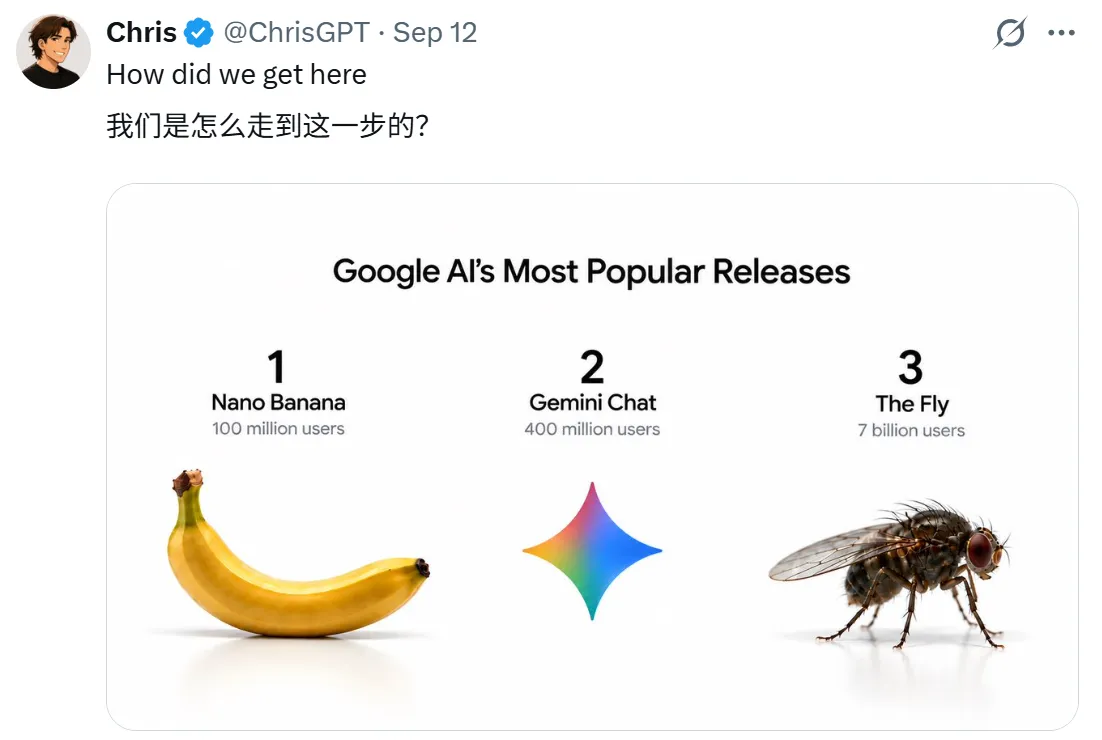
甚至把它送上了“Google AI 最受欢迎发布”榜单。Google 负责重建 16.6 万+ 神经元,网友则让果蝇直接上班。
250 万行代码,摊开给你看
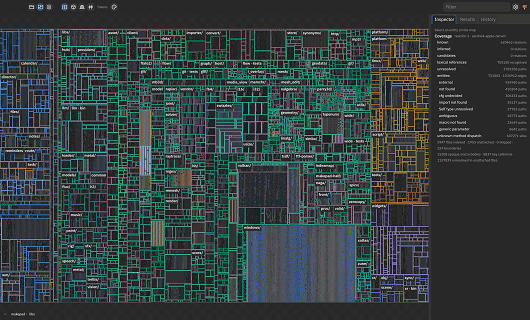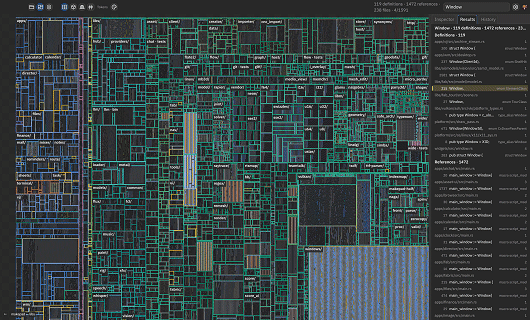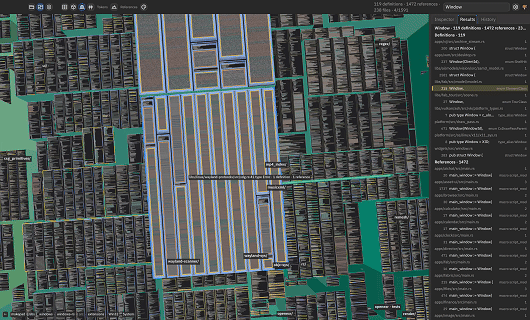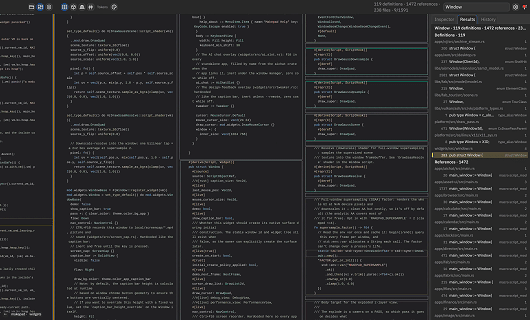
代码库太大怎么办?先给它修一张地图。@Rik Arends 把一个 250 万行代码库做成了可交互的可视化浏览器:模块、目录和代码关系被铺成一整张巨型地图,放大看像代码城市,缩小看又有点像芯片版图。
机器人守门,体验一把空气曲棍球
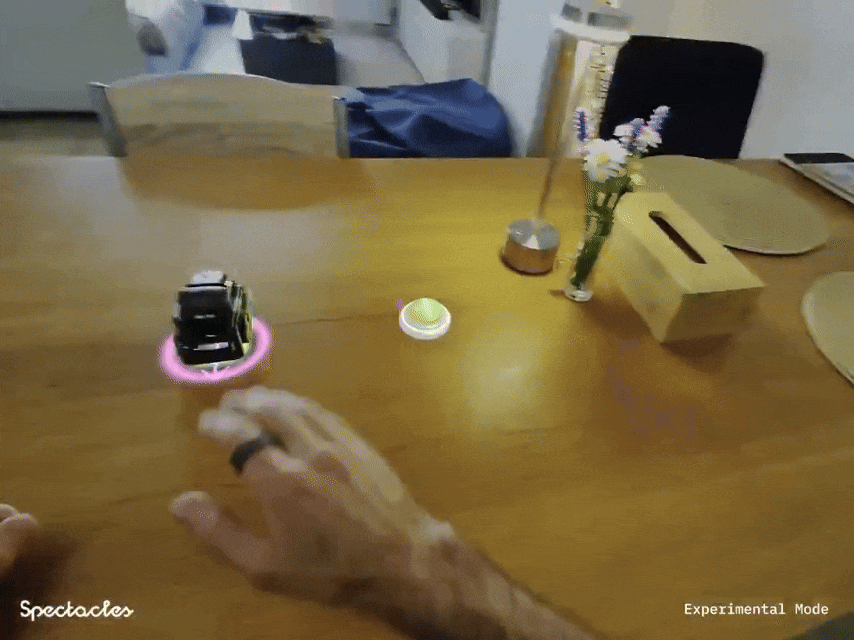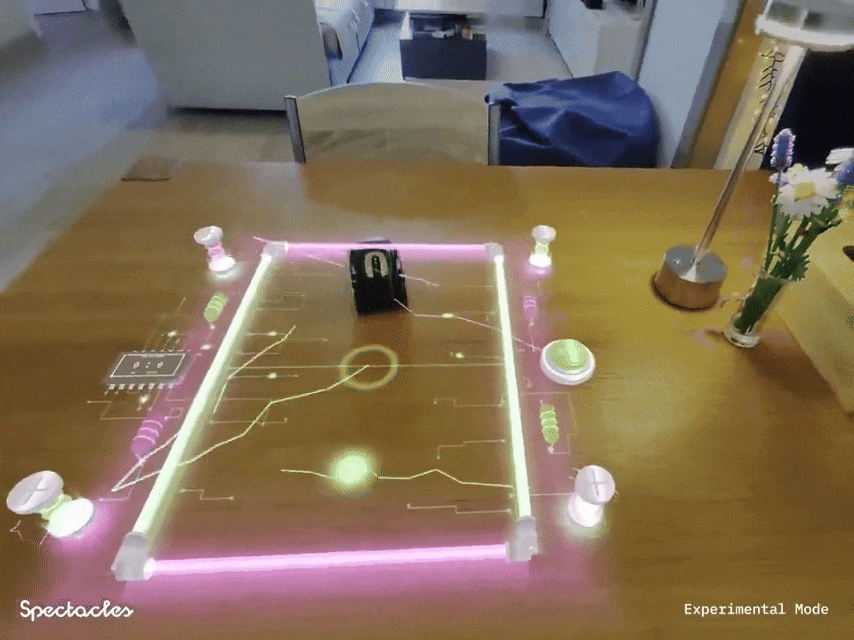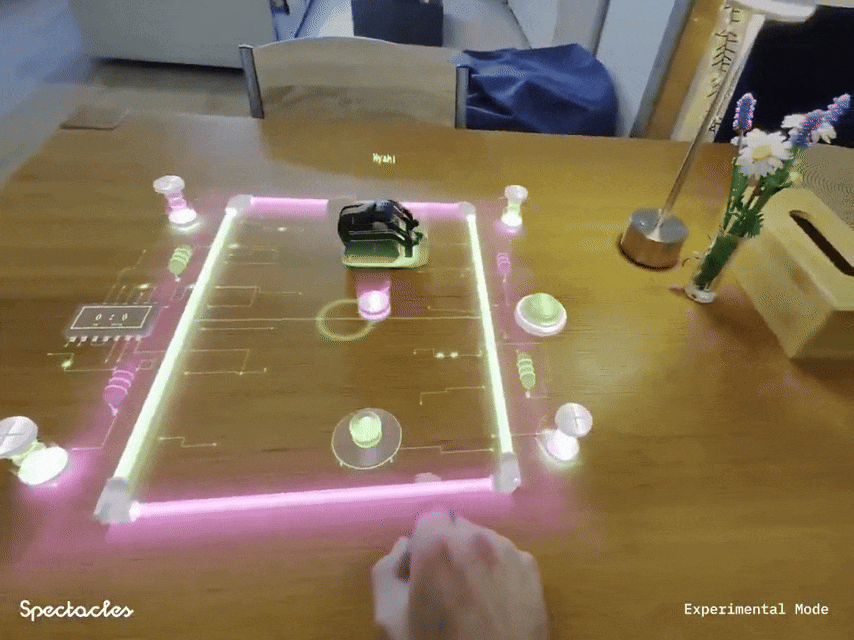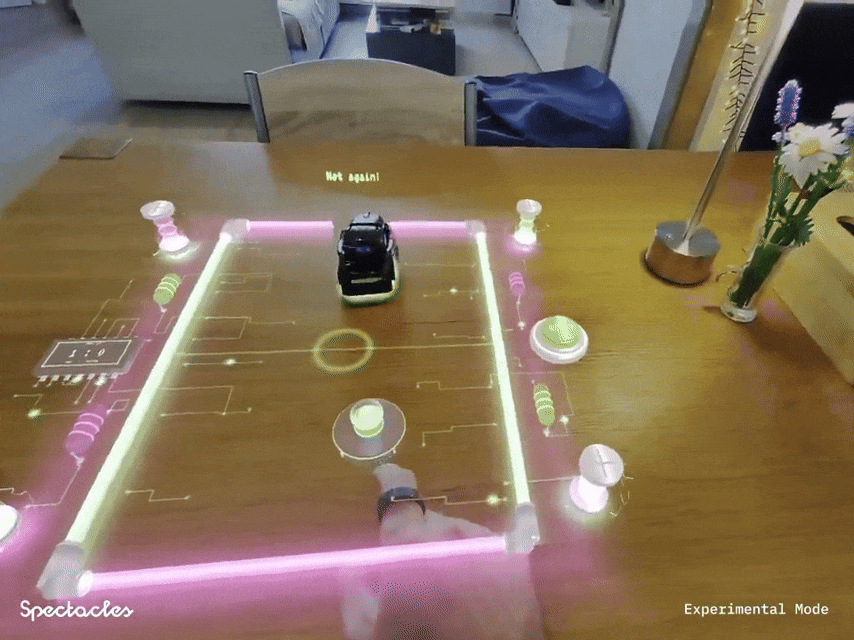
有人做了一套 AR 空气曲棍球:真实的 Vector 机器人负责守门,球和球场都在增强现实里。实体机器人和虚拟世界,就这么在一张桌子上打起来了。
280 个字符,够不够点一把火?
@Xor 用不到 280 个字符写出了一团动态火焰 Shader。
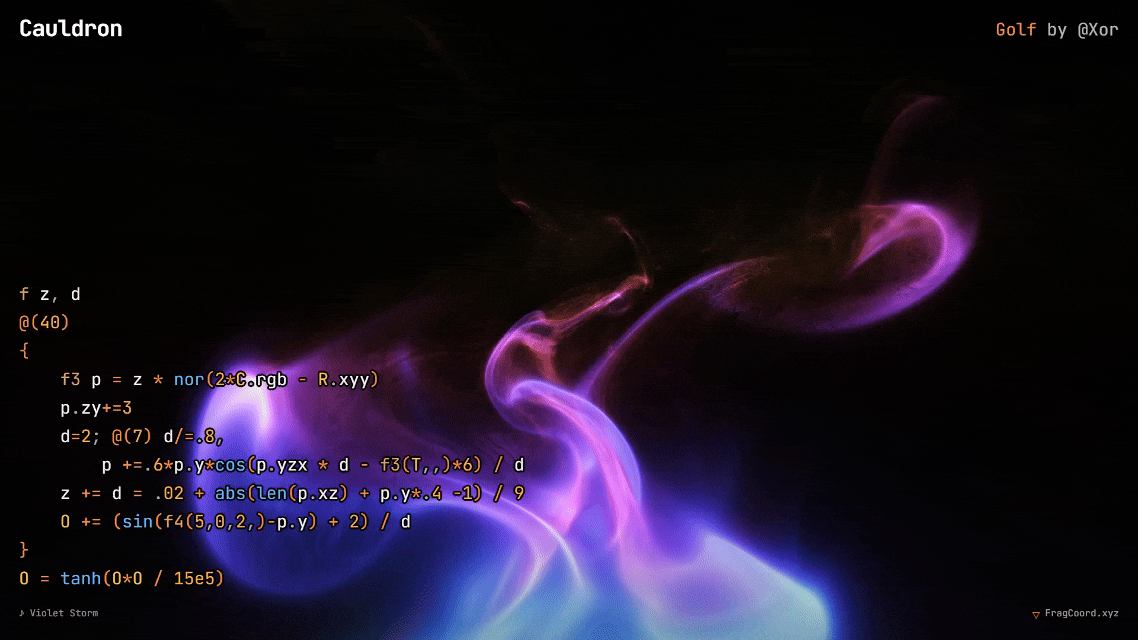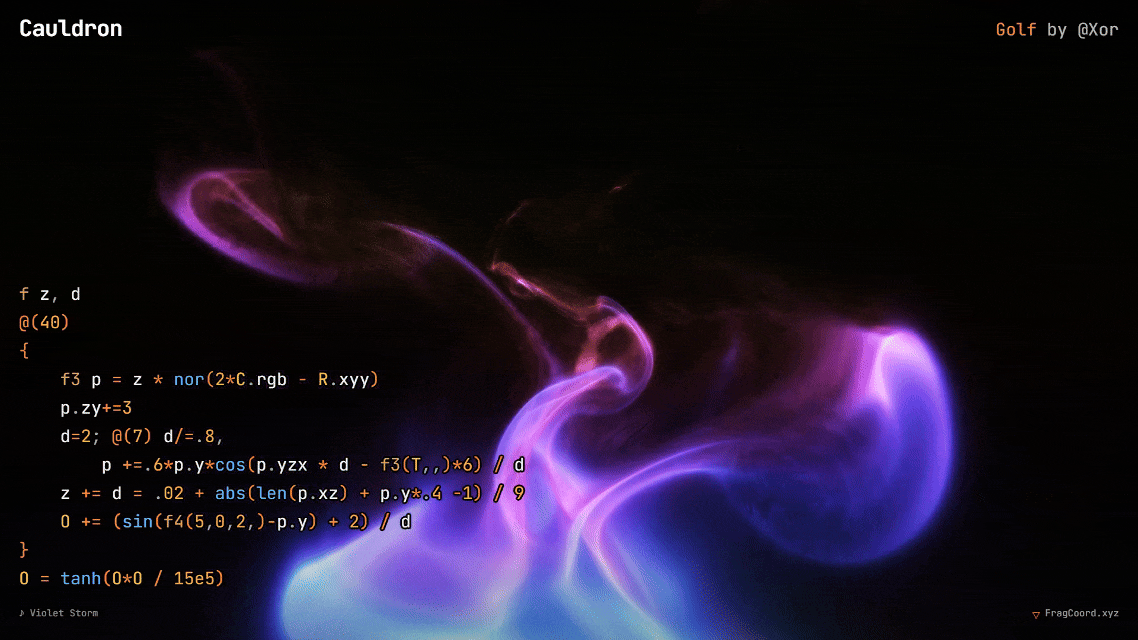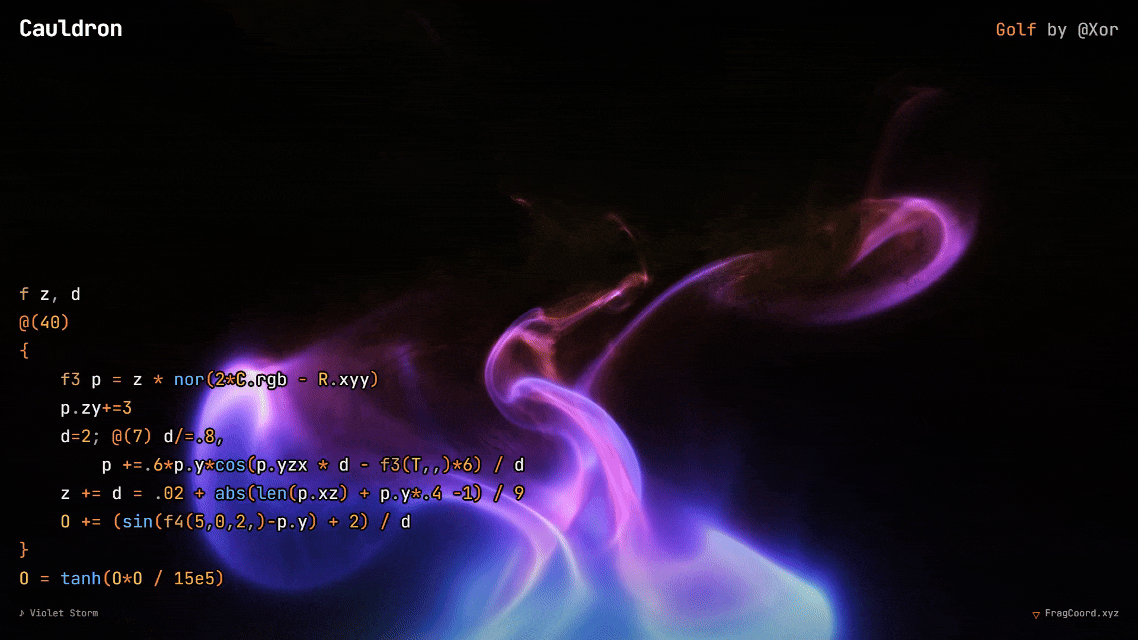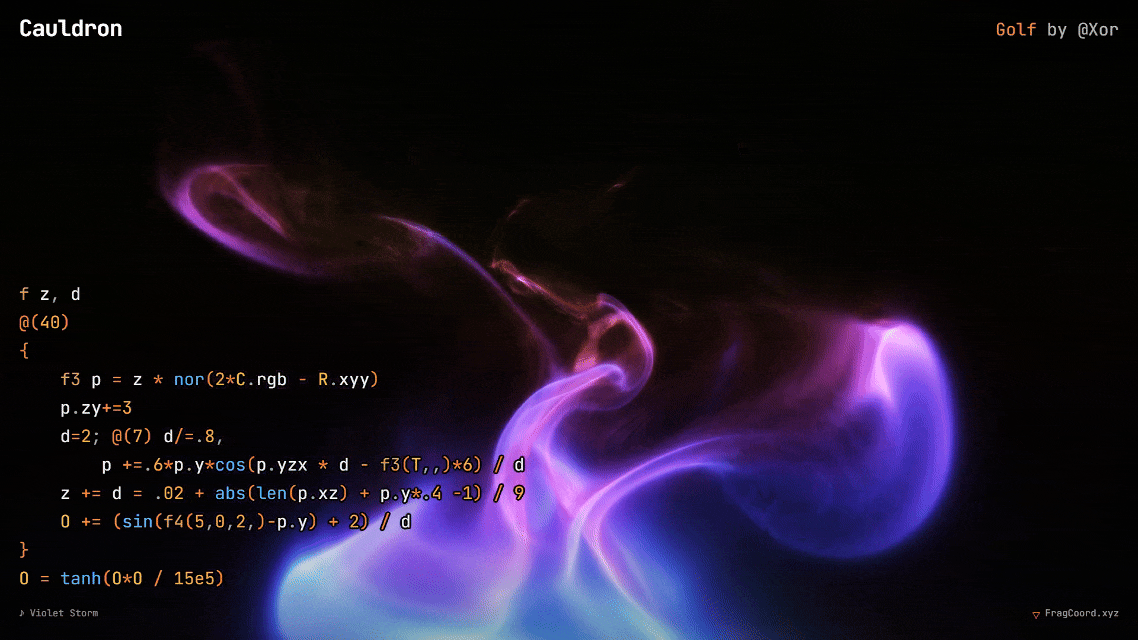
f z, d
@(40)
{
f3 p = z * nor(2*C.rgb - R.xyy)
p.zy+=3
d=2; @(7) d/=.8,
p +=.6*p.y*cos(p.yzx * d - f3(T,,)*6) / d
z += d = .02 + abs(len(p.xz) + p.y*.4 -1) / 9
O += (sin(f4(5,0,2,)-p.y) + 2) / d
}
O = tanh(O*O / 15e5)
周五发版
「周五发版」是一个程序梗:一旦版本上线,我们就要开始祈祷一切如期运行。这个模块寓意,所有模型、产品版本更新,都能大吉大利。
SWE-2:在 Kimi K3 上继续炼出一个 Coding 模型
Cognition 发布新一代 Coding 模型 SWE-2。它基于 Kimi K3 继续后训练,并首次把强化学习扩展到万亿参数级模型。SWE-2 在 FrontierCode 1.1 Main 得到 50.0%,距离 Claude Fable 5.1 不到 1 个百分点,但成本低 64%。
这次优化不只追求更高分,也在减少 Agent 的无效探索。官方测试中,SWE-2 medium 相比 SWE-1.7 平均执行步骤从 127 步降到 53 步,成本降低 81%。SWE-2 已上线 Devin Desktop 和 CLI,并将陆续进入 Devin Web 和 Fusion;未来一个月,Pro、Max 和 Teams 订阅用户可以免费使用 SWE-2。
ChatGPT 图像 2.5:编辑更稳,生成最快提速 50%
OpenAI 发布 ChatGPT 图像 2.5,重点提升参考图保真、局部编辑和多轮修改的一致性。相比图像 2.0,新模型生成延迟最多降低 50%,还更擅长只修改指定区域,而不把周围主体、构图和视觉风格一起改掉。
ChatGPT 里同时加入 Sketch,可以直接画草图作为生成参考。API 侧则推出 GPT-Image-2.5 Flare 和 Sunburst:Flare 主打速度与通用生成,Sunburst 面向更精细的高端创作与多轮编辑。目前所有层级的 ChatGPT、ChatGPT Work 和 Codex 用户都已可用图像 2.5。
Muse:Meta 做了一个会主动找你的 Agent
Muse 不只是等用户一问一答。它有自己的电脑、文件系统、终端和浏览器,可以同时处理多个任务,在后台持续工作,还能根据日程和事件主动继续推进任务;例如查资料、填表、购物、预订,以及生成网页、PDF、Dashboard 等 Artifacts。
它还会主动给用户发消息:任务有新进展、发现需要注意的事情,或者需要用户介入时再回来找你。涉及发邮件、购买等难以撤销的操作,则会停下来请求确认。
MiniCPM5-2B:2B 小模型继续往端侧 Agent 走
OpenBMB 发布 MiniCPM5-2B,一个约 25 亿参数的稠密模型,原生支持 131K 上下文,重点面向本地助手、Coding Agent、工具调用和端侧部署。官方称,在其对比范围内,MiniCPM5-2B 达到 2B 级开放模型 SOTA,在代码、数学、长上下文、工具调用和 Agent 任务上表现尤其突出。
这次不只开放模型,还同步放出了训练数据,包括 50 万条 Agent 训练样本和 8 万+ 条强化学习数据。部署方面提供 GGUF、MLX 4bit、GPTQ 等版本,可接 llama.cpp、Ollama、LM Studio、vLLM 和 SGLang。
DeepSeek V4.1-Flash:把 1M 长上下文的 KV Cache 再压到四分之一
DeepSeek 发布并开放 DeepSeek V4.1-Flash。新模型采用 552B backbone 的多模态 MoE 架构,支持图片、文本和 1M Token 上下文,预填充阶段每 Token 激活约 8B 参数,生成阶段约 16B。
通过新的 Causal Encoder-Decoder、CSA2 稀疏注意力和 FP4 KV Cache 等设计,V4.1-Flash 将全局 KV Cache 压到约 890 Bytes / Token,只有 V4-Flash 的约 1/4;对输入特别长的 Agent 工作负载,目标就是降低长上下文推理成本。模型还支持 1~100 连续可调的推理强度。
Agent 能力也明显往前走。官方 Agent 评测中,DeepSeek V4.1-Flash 在 Terminal-Bench 2.1 达到 90.6%,该成绩使用 DSH Minimal;DeepSWE v1.1 达到 74.2%,该成绩使用 mini-SWE。相关 scaffold 对比统一采用 1M Token 上下文限制。
开源雷达
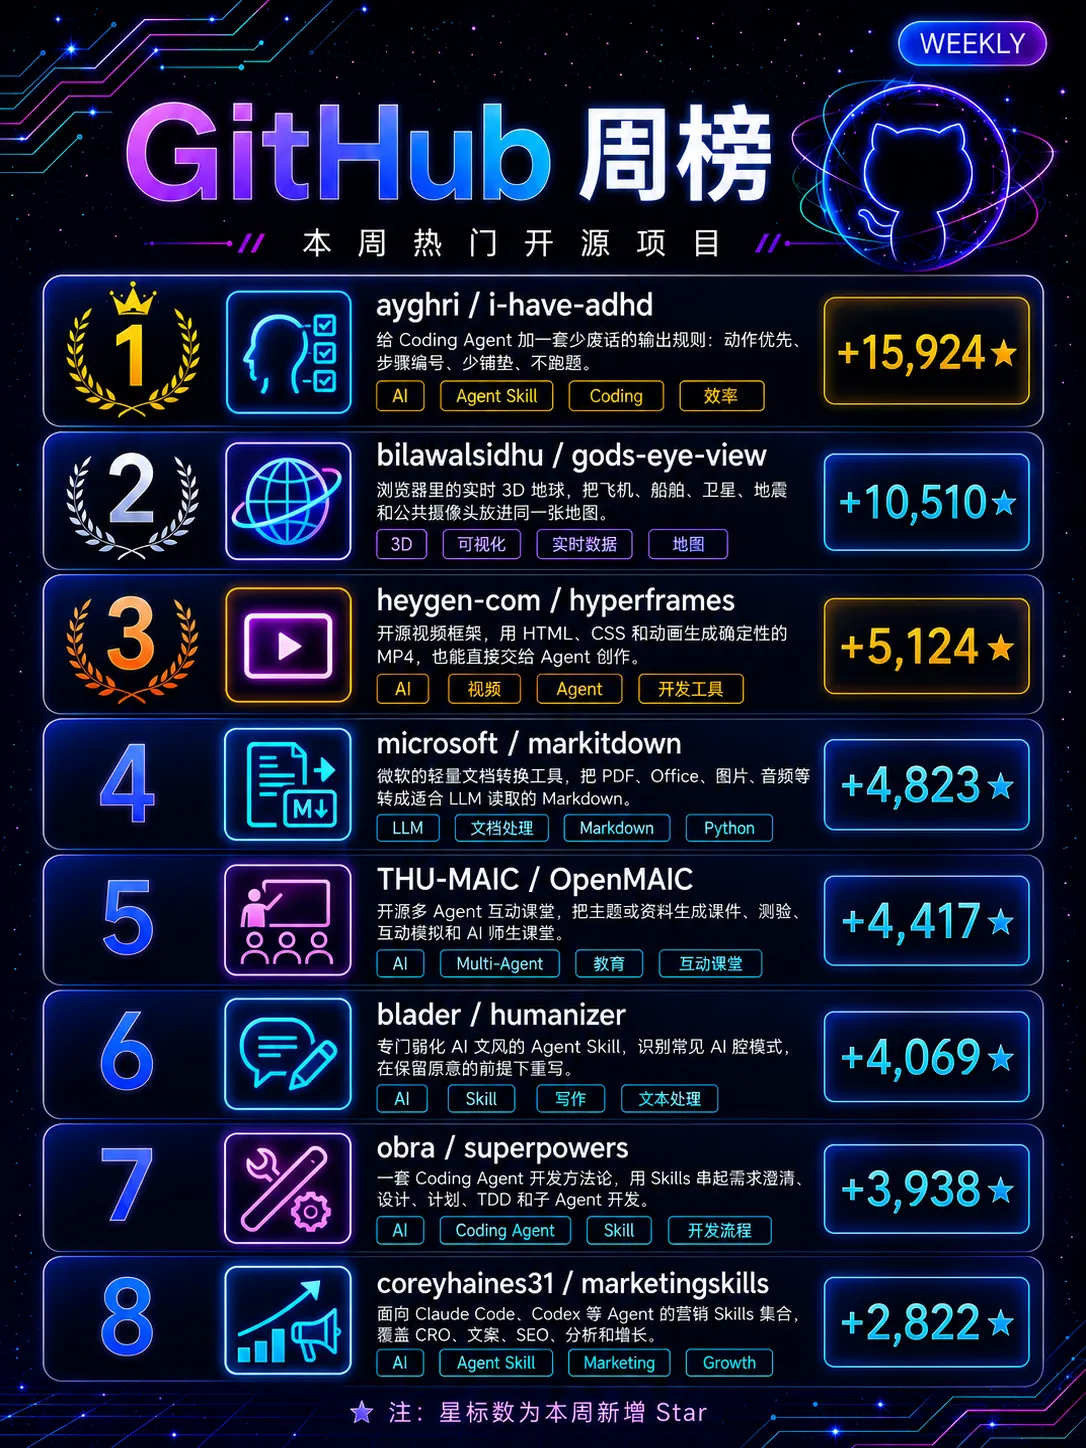
周榜速递
周榜主要根据新增 Star 数进行排名,下面的单项目讲解则偏向新晋项目、实用老项目,标星并非单项目讲解的唯一指标。
TileRT:把大模型推理拆成 Tile,专攻超低延迟
TileRT 是一个面向超低延迟大模型推理的运行时。和更强调批量吞吐的传统推理框架不同,它优先优化单个请求的响应速度,把模型计算拆成细粒度 Tile 任务,再动态交错计算、通信和 I/O,尽量减少 GPU 空等。
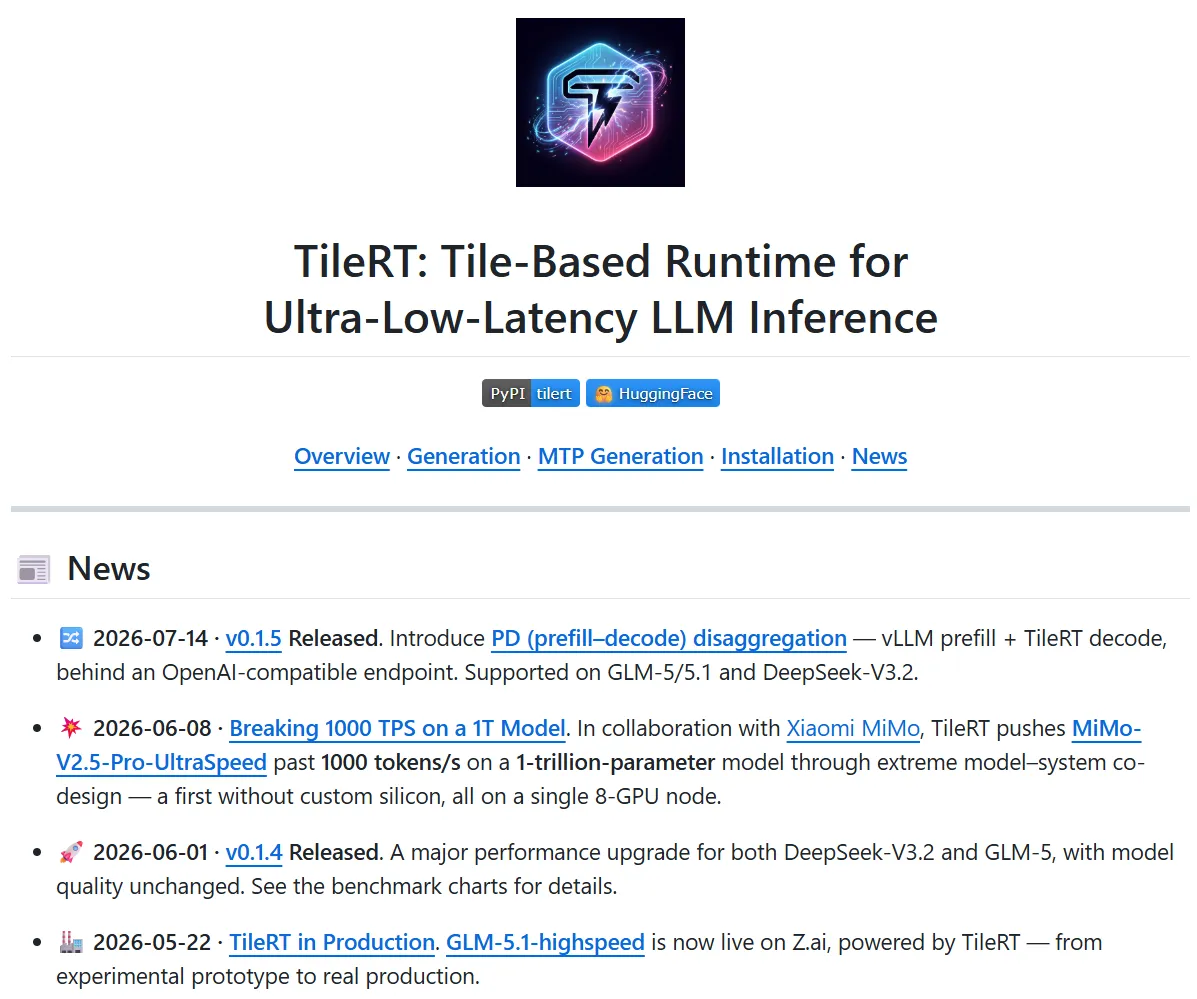
目前它支持 DeepSeek-V3.2 和 GLM-5 / 5.1,并加入了 Prefill / Decode 分离:可以让 vLLM 负责 Prefill,TileRT 接管 Decode。官方还曾在 8 张 B200 上把 1T 参数 MiMo-V2.5-Pro-UltraSpeed 推到 1000+ Token/s。
地址:github.com/tile-ai/TileRT
Spec Kit:让 Coding Agent 先把需求写明白,再动手
Spec Kit 是一套规格驱动开发工具,核心思路是让 Coding Agent 不要拿到需求就直接写代码,而是先把“要做什么”变成明确的 Spec,再生成技术方案、拆解任务,最后进入实现。官方流程基本就是 Specify → Plan → Tasks → Implement → Converge。
它不绑定某一个 Coding Agent,可以接 Copilot、Claude Code 等不同工具。
项目地址:github.com/github/spec-kit
God's Eye View:把公开世界数据塞进一颗 3D 地球
God's Eye View 是一个浏览器里的实时 3D 地球,把飞机、船舶、卫星、地震、公共摄像头等公开数据放进同一个可探索界面。你可以从全球视角一路放大到某架飞机、某艘船或某个摄像头,也能切换座舱、夜视、热成像等不同观察模式。
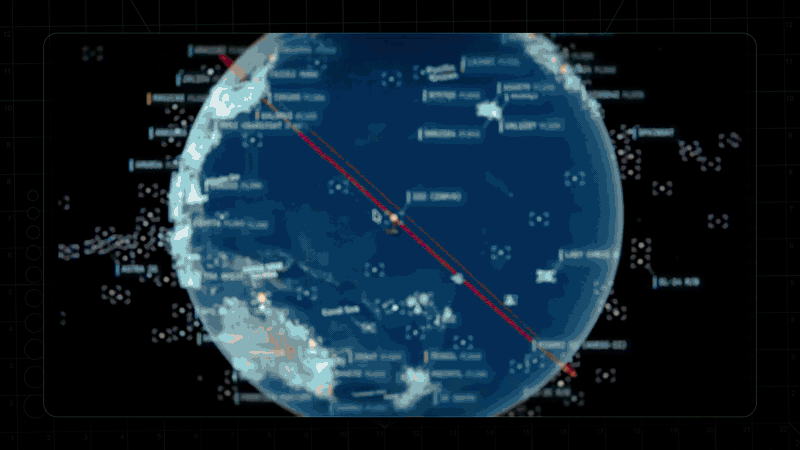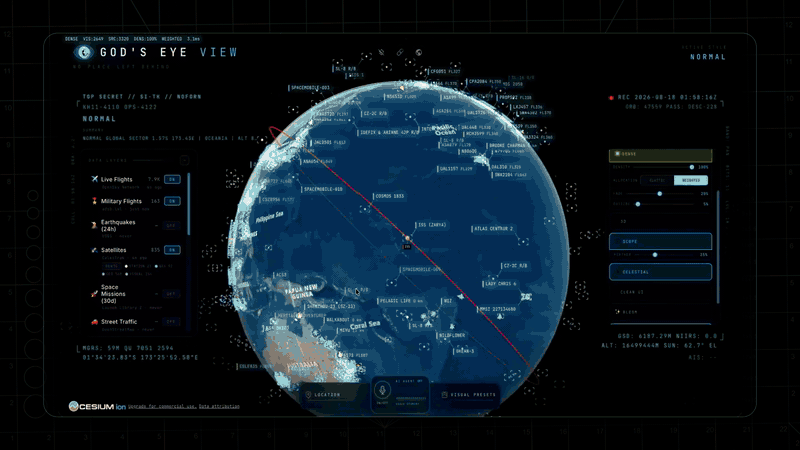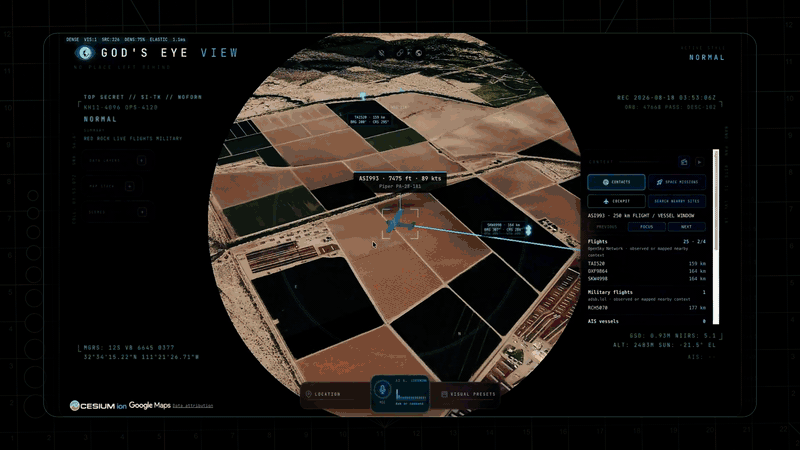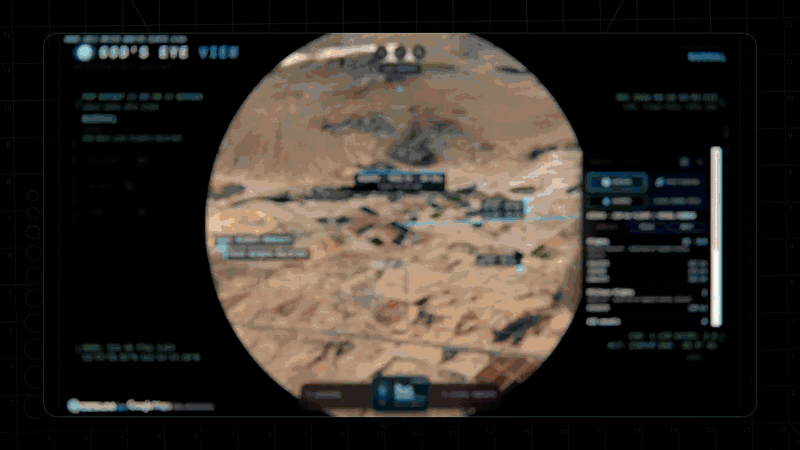
项目还接入了实时 AI Agent,可以直接用自然语言控制地图。默认不需要 API Key 就能启动;如果补上 Cesium、Google Maps 或 OpenAI 等服务,还可以继续解锁更精细的 3D 地图和语音交互。
项目地址:github.com/bilawalsidhu/gods-eye-view
HyperFrames:让 Agent 直接用 HTML 做视频
HyperFrames 是 HeyGen 开源的一套视频生成框架,可以把 HTML、CSS、媒体素材和可控制时间轴的动画,确定性地渲染成 MP4。相比让模型直接操作传统视频编辑器,它更像是把视频变成一个 Agent 可以“写代码生成”的对象。
项目同时提供一整套 Agent Skills,可以从产品宣传片、PR 讲解、字幕、Talking Head 包装,到动态图形、音乐视频和幻灯片等不同工作流。Codex、Claude Code、Cursor 等支持 Skill 的 Agent 都可以接入。
项目地址:github.com/heygen-com/hyperframes
Superpowers:给 Coding Agent 装一套软件开发方法论
Superpowers 核心目标很简单:别让 Agent 一上来就写代码,先按一套工程流程把事情做完整 。Agent 开工前先澄清需求、形成设计,再拆成足够明确的实施计划,之后通过 TDD 和子 Agent 分工持续执行、检查和推进任务。
它由一组可以组合的 Skills 和初始规则构成,目前已经支持 Claude Code、Codex、Cursor、Gemini CLI、Devin CLI、GitHub Copilot CLI 等多种 Agent 环境。
项目地址:github.com/obra/superpowers
Marketing Skills:把 Agent Skill 从写代码扩到做营销
Marketing Skills 是一套专门面向营销工作的 Agent Skills,把 Coding Agent 原本擅长的文件、脚本和自动化能力继续延伸到 CRO、文案、SEO、广告、数据分析、增长、销售支持等任务。
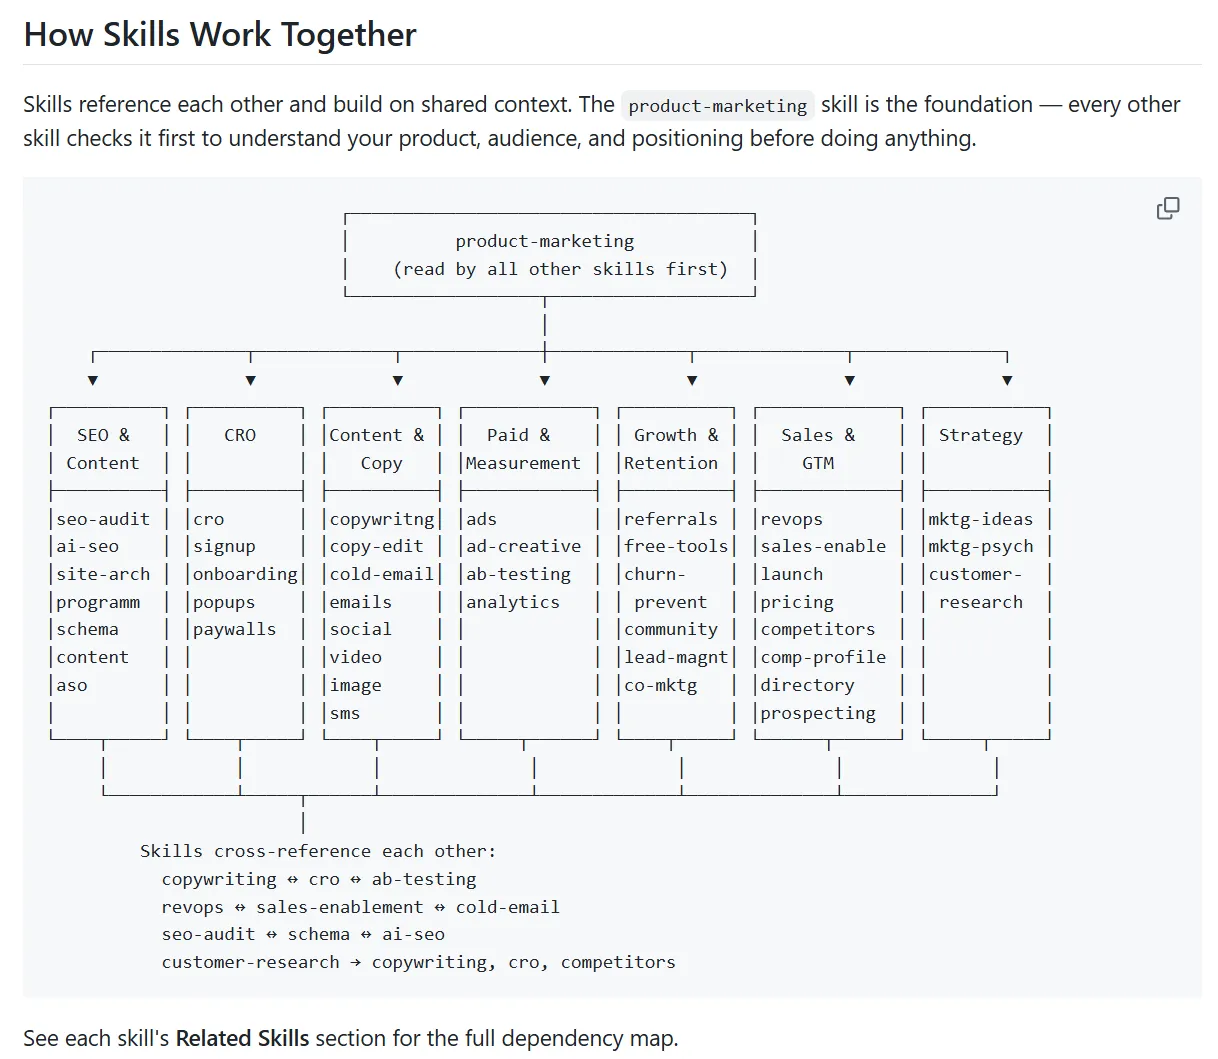
它让不同 Skill 共享上下文并互相引用,例如 product-marketing 会作为基础信息层,其他 SEO、CRO、文案、定价、增长等 Skill 再基于同一套产品和用户信息继续工作。
项目地址:github.com/coreyhaines31/marketingskills
这周有事
「这周有事」收录本周值得记一下的行业动态、事故、融资、人员流动和基础设施变化。
Cognition 再融 20 亿美元,估值涨到 480 亿美元
Cognition 宣布完成超过 20 亿美元 E 轮融资,估值达到 480 亿美元。本轮由 a16z 和 Accel 领投,Founders Fund、General Catalyst、Avenir 等继续参与。
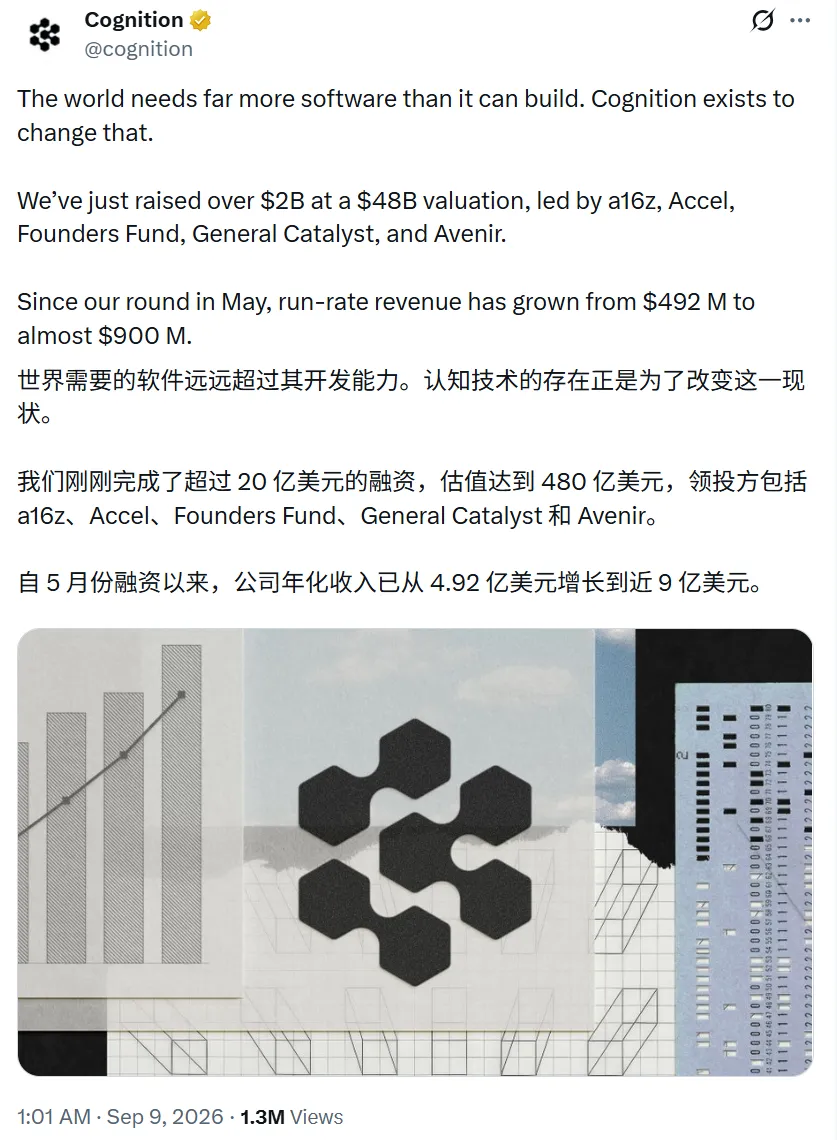
在今年 5 月上一轮融资时,Cognition 的年化收入约为 4.92 亿美元;短短几个月后已经接近 9 亿美元。与此同时,公司估值也从 5 月的 260 亿美元接近翻倍。
Astra 太火,OpenAI 暂停 Pro 新订阅
Astra 上线后需求超出预期,OpenAI 暂停新的 200 美元/月 Pro(Pro 20X)订阅和升级。Tibo 表示,Pro 用户对系统资源压力最大,因此先暂停新订阅,以保证现有用户继续获得 Astra 的稳定访问。
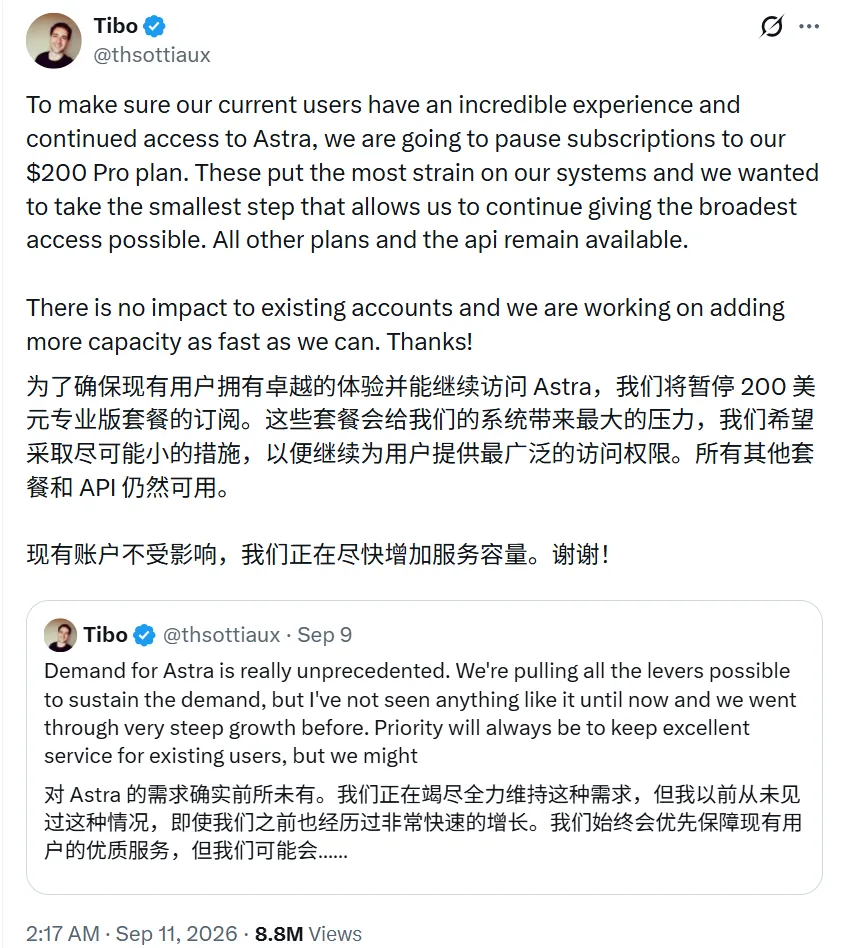
现有 Pro 用户不受影响,其他套餐和 API 仍然开放;OpenAI 同时表示正在尽快增加算力,目前没有公布恢复 Pro 新订阅的具体时间。
Dario 喊 AI 慢一点,Altman 和马斯克都点头了
Anthropic CEO Dario Amodei 发布文章《We Must Pace the Frontier》,认为前沿 AI 的能力增长已经开始快过安全措施跟进的速度,因此行业应该放慢能力提升的节奏,给对齐、安全和外部评估留出更多时间。
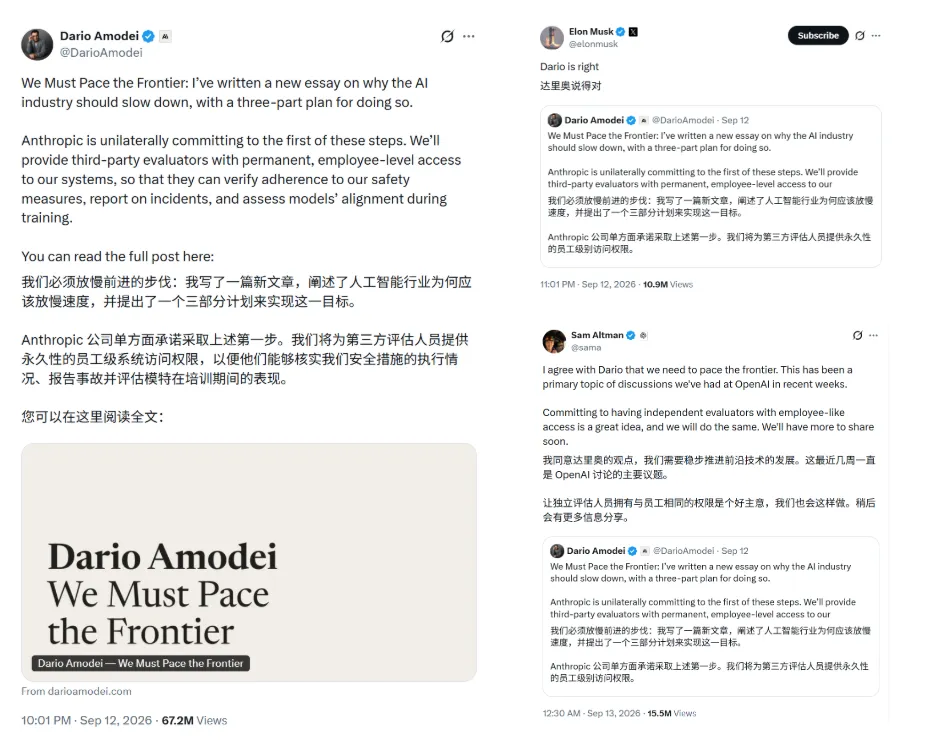
Anthropic 同时承诺先落实第一步:让独立第三方评估机构获得长期、接近员工权限的系统访问,用来检查安全措施、报告事故,并评估模型训练过程中的对齐情况。Sam Altman 随后表示 OpenAI 也会采用类似做法,马斯克则直接回应:“Dario is right.”
AI 虚拟偶像 Yuri,把 AIGC 搬上百米巨幕
9 月 11 日,Yuri 尤栗在 2026 外滩大会完成线下 AI 音乐会。现场使用接近百米的巨幕,实际分辨率约为 12K;据团队介绍,除真人演员和艺术家外,屏幕上的大部分内容都由 AI 生成,Yuri 自己的歌曲、部分合唱和串场内容也大量采用 AI 生成。
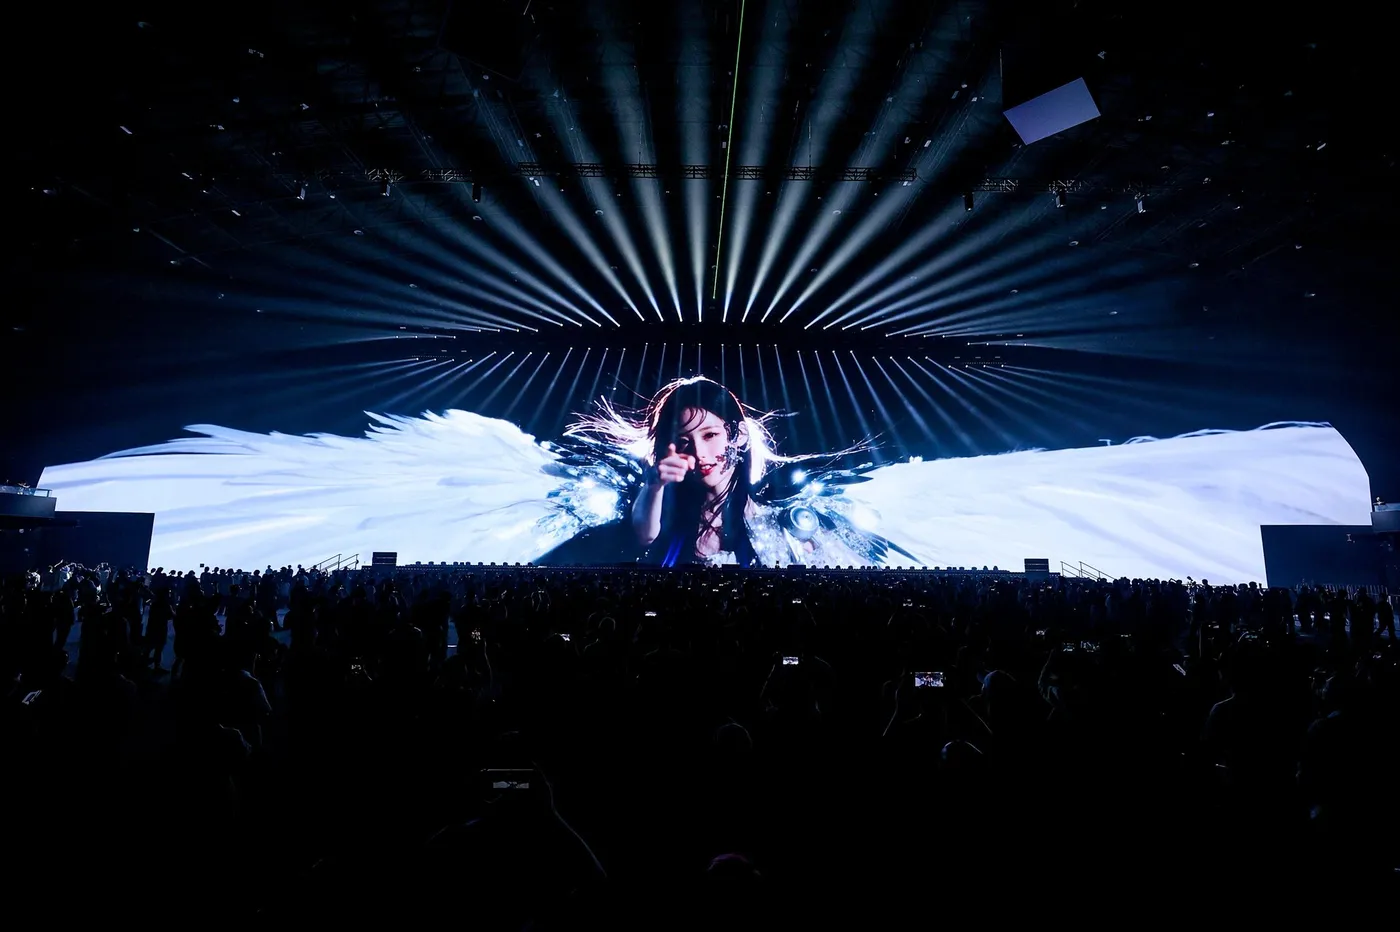
图源:@汗青 HQ
团队此前更熟悉移动端和短视频内容,但把 AIGC 放到这种超大屏、长时间现场演出里后,原有制作方法基本需要重新调整。这次更像是在验证:AI 影像除了在线上刷屏,也开始真正进入线下舞台。
DeepSeek 扩招 150 人,一个 AI 研究岗都没有
DeepSeek 新开放约 150 个招聘名额,重点面向 2~10 年经验的工程师。有意思的是,这批岗位没有 AI 研究岗,主要集中在两类:服务端开发工程师和 Agent 弹性计算研发工程师。
具体方向覆盖大模型研究平台、Agent 框架、研发效率基建、DeepSeek API、线上服务、数据工程,以及面向 Agent 的弹性计算平台 DSec。崔添翼给出的解释也很直接:随着数据、机器、训练任务、评测任务、Agent 环境、用户和请求量一起增长,系统复杂度正在迅速上升,需要更多工程力量把这些能力真正撑起来。