
藻类检测数据集 | 34000张YOLO水质监测数据集
适用于水华预警、水质监测与目标检测研究
一、数据集概述
本数据集面向 计算机视觉 目标检测任务,专为水体浮游藻类目标检测模型训练、验证与测试设计,共包含约34000张高质量标注图像,覆盖11类常见淡水与水体有害/指示藻类。该数据集可广泛应用于水质监测、水华预警、生态环境评估、水产养殖管理及淡水/海洋生态研究等场景,适用于YOLOv5/v7/v8/v10/v11/v12等主流检测框架。
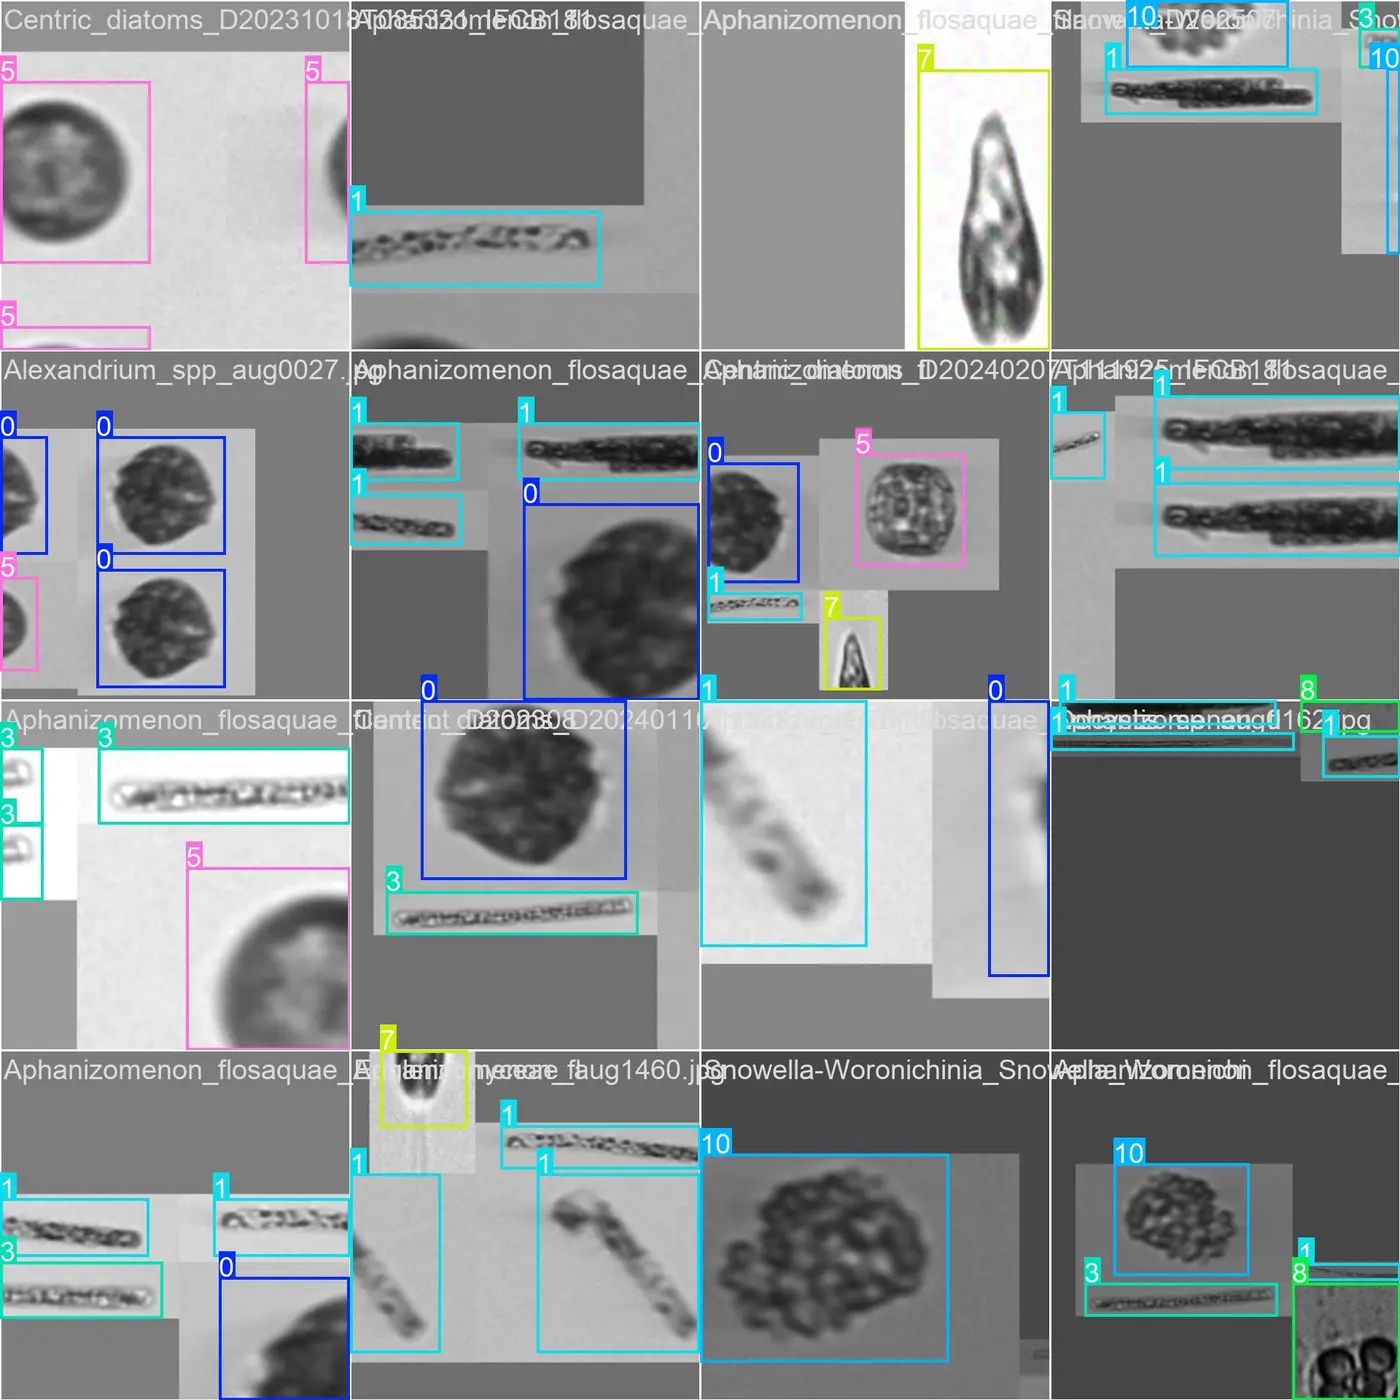
随着水环境监测需求的不断提升和智慧环保技术的快速发展,利用计算机视觉技术实现浮游藻类的自动检测与分类已成为水华预警、水质评估与生态监测的重要手段。本数据集针对藻类检测场景中目标微小、形态多样、密度变化大等问题进行专项构建,可为水质智能监测系统与藻类预警平台提供高质量数据支撑。
数据集下载
通过网盘分享的文件:藻类检测数据集-11类
链接: https://pan.baidu.com/s/1aKSKHzY-zbCqGO7SaUcCLQ?pwd=gzs8
提取码: gzs8
二、数据集基本信息
| 项目 | 内容 |
|---|---|
| 数据集名称 | 藻类检测数据集 |
| 数据规模 | 约34000张高质量标注图像 |
| 任务类型 | 目标检测(Object Detection) |
| 检测目标 | 11类浮游藻类 |
| 类别数量(nc) | 11类 |
| 标注方式 | Bounding Box目标框标注 |
| 数据格式 | YOLO标准格式 |
| 数据来源 | 真实水体样本显微/水体图像采集 |
| 数据划分 | Train / Val / Test |
| 适配模型 | YOLOv5、YOLOv7、YOLOv8、YOLOv10、YOLOv11、YOLOv12、Faster R-CNN等 |
三、数据集类别说明
本数据集为多类别目标检测数据集,共设置11个检测类别,覆盖常见淡水与水体有害/指示藻类,细分束丝藻不同形态,满足藻类细分识别需求。
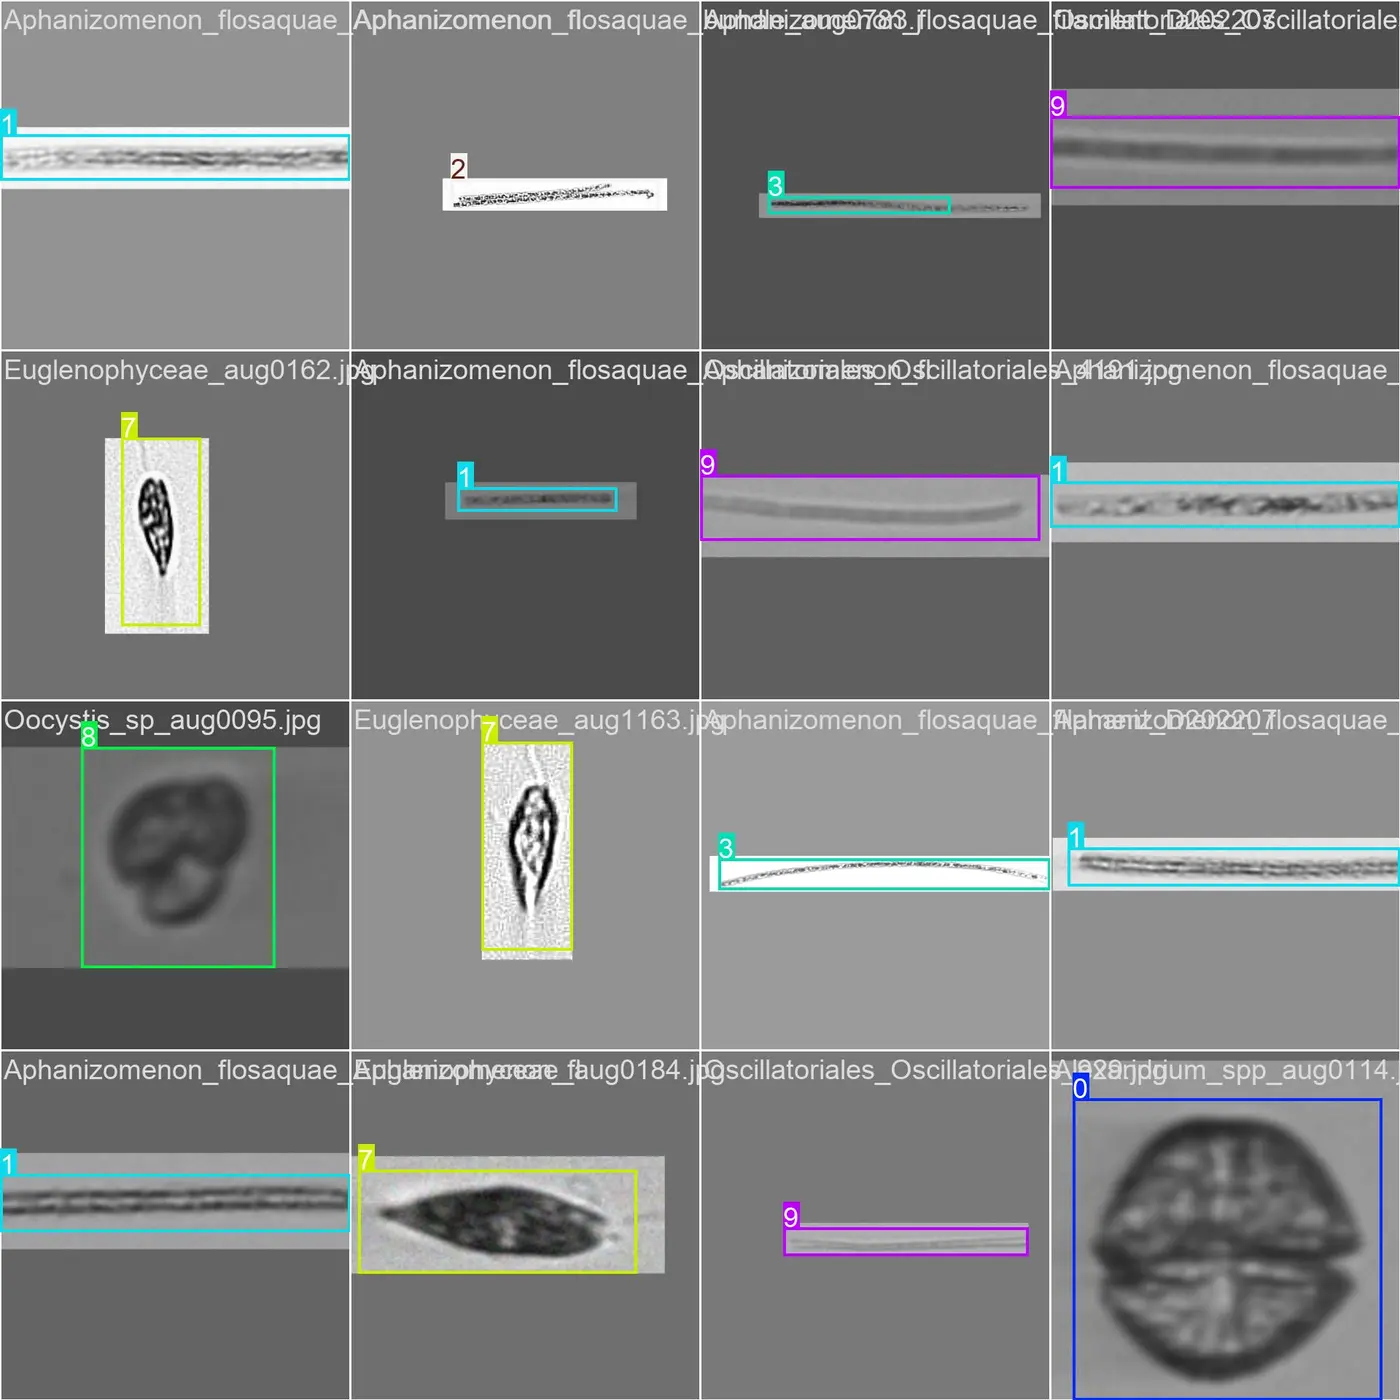
类别配置
nc: 11

names:
  - alexandrium
  - aphanizomenon
  - aphanizomenon_bundle
  - aphanizomenon_filament
  - merismopedia
  - centric_diatom
  - cryptomonas
  - euglena
  - oocystis
  - oscillatoria
  - snow_algae_ulothrix
类别详情
| 类别ID | 类别名称 | 英文名称 | 类别说明 |
|---|---|---|---|
| 0 | 亚历山大藻 | alexandrium | 甲藻类,部分种类可产生麻痹性贝毒,赤潮预警指示种 |
| 1 | 束丝藻 | aphanizomenon | 蓝藻类,常见水华藻种 |
| 2 | 束丝藻-束状 | aphanizomenon_bundle | 束丝藻的束状聚集形态 |
| 3 | 束丝藻-丝状 | aphanizomenon_filament | 束丝藻的丝状分散形态 |
| 4 | 平列藻 | merismopedia | 蓝藻类,群体呈平板状排列 |
| 5 | 中心硅藻 | centric_diatom | 硅藻类,中心纲种类 |
| 6 | 隐藻 | cryptomonas | 隐藻类,水体常见鞭毛藻 |
| 7 | 裸藻 | euglena | 裸藻类,有机污染指示生物 |
| 8 | 卵胞藻 | oocystis | 绿藻类,常见淡水浮游藻 |
| 9 | 颤藻目 | oscillatoria | 蓝藻类,丝状群体 |
| 10 | 雪藻-乌龙藻 | snow_algae_ulothrix | 丝状绿藻,雪藻/乌龙藻类 |
十一类设计覆盖蓝藻、硅藻、甲藻、绿藻、隐藻、裸藻等主要浮游藻类门类,其中束丝藻细分束状与丝状两种形态,满足藻类细分识别与形态学分析需求,可支撑水华预警与水质评估等多场景应用。
四、数据集结构说明
数据集采用标准YOLO 目录结构 组织,已按训练集、验证集、测试集进行科学划分,结构清晰,便于直接接入主流检测框架。
藻类检测数据集-11类/
├── images
│   ├── train
│   ├── val
│   └── test
├── labels
│   ├── train
│   ├── val
│   └── test
└── data.yaml
各数据集作用如下:
- images/train & labels/train:训练集图像与标签,用于模型参数学习与特征提取;
- images/val & labels/val:验证集图像与标签,用于超参数调优、早停监控及防止过拟合;
- images/test & labels/test:测试集图像与标签,用于最终模型性能评估与泛化能力测试。
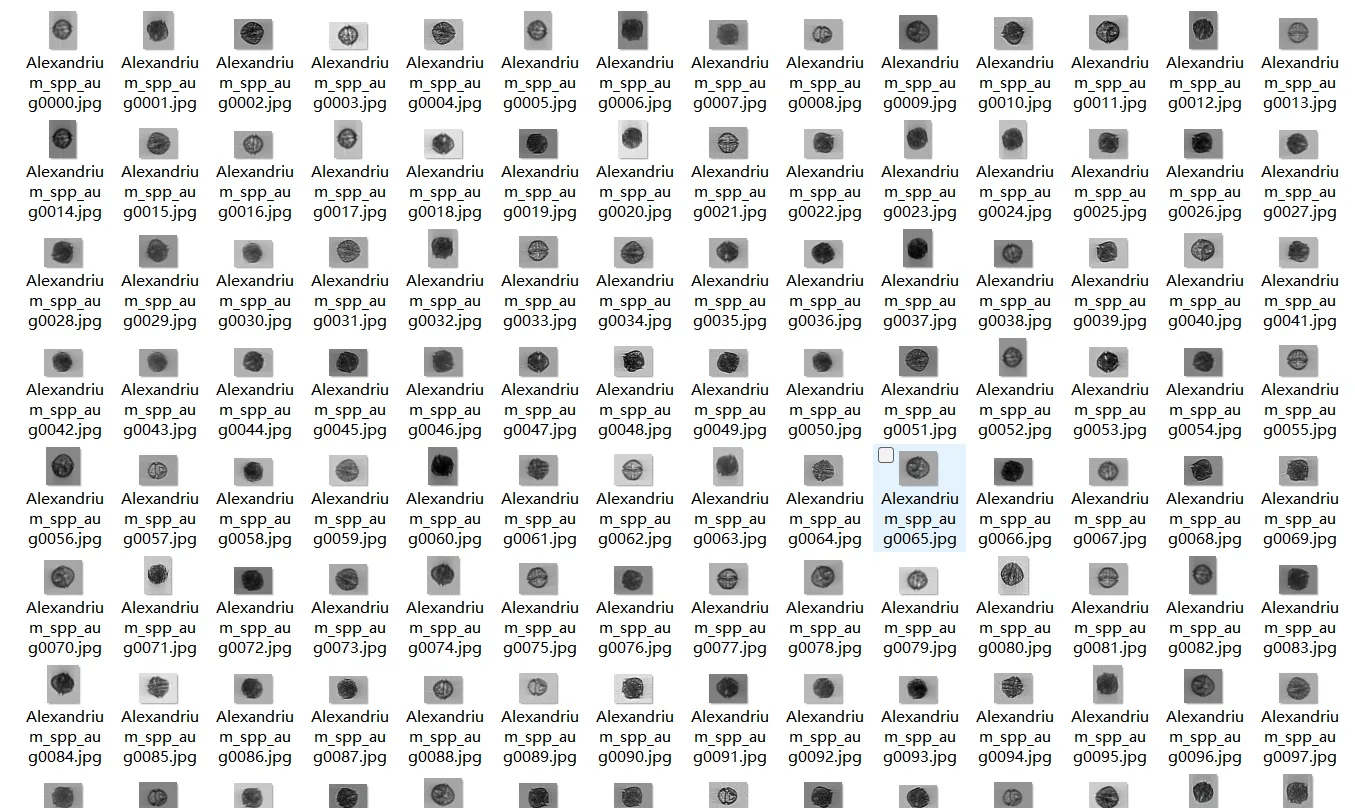
标注文件为同名.txt格式,每行格式为类别索引 x_center y_center width height,坐标均为归一化值,配套 data .yaml已配置好类别名称与数量,可直接适配YOLO系列等目标检测框架。
五、数据集核心优势
1. 大规模高质量样本
约34000张高质量图像,是本批数据集中规模最大的数据集之一:
- 样本量非常充足:保障模型训练收敛性与泛化能力
- 训练稳定性好:大规模数据支撑稳定训练
- 藻类形态覆盖全面:覆盖不同形态、密度与背景
- 应用可靠性高:满足实际部署的模型训练需求
2. 完整的藻类门类覆盖
11类覆盖主要浮游藻类门类:
- 蓝藻门:束丝藻(含束状/丝状)、平列藻、颤藻目
- 硅藻门:中心硅藻
- 甲藻门:亚历山大藻
- 绿藻门:卵胞藻、雪藻-乌龙藻
- 隐藻门:隐藻
- 裸藻门:裸藻
覆盖淡水与水体常见有害/指示藻类,可支撑水华预警、水质评估与生态监测等多场景应用。
3. 细分形态识别
数据集特别细分了束丝藻的不同形态:
- 束丝藻-束状:束状聚集形态
- 束丝藻-丝状:丝状分散形态
- 束丝藻:通用类别
这种细分设计满足藻类形态学分析与密度评估的需求,提升模型对藻类不同生长状态与聚集形态的识别能力。
4. 贴近真实水质监测环境
数据来源于真实水体样本显微/水体图像,具有以下特点:
- 藻类形态多样:不同门类、不同生长阶段的形态变化
- 密度变化大:从稀疏分布到密集聚集
- 水体背景复杂:不同水质条件下的背景差异
- 真实监测场景:贴近实际水质监测采样环境
有效保障模型在实际水质监测中的泛化能力。
5. 高质量人工标注
所有图像均经过高质量人工精准标注:
- 边界框规整、无漏标/错标
- 11类藻种判别标准统一清晰
- 密集场景下的独立标注处理
- 满足高精度检测模型训练需求
有效保证 模型训练 质量。
6. 即用型数据组织
标准目录结构+YOLO格式标注,可直接用于模型训练,无需复杂预处理,降低使用门槛。
六、适用场景
水华与赤潮早期预警监测
自动检测水体中的有害藻类(如束丝藻、亚历山大藻等),实现水华与赤潮的早期预警。
饮用水源地藻类风险评估
在饮用水源地监测藻类种类与密度,评估藻类暴发风险与水质安全。
江河湖库生态健康状况评价
基于藻类群落结构分析,评估水体生态健康状况与富营养化程度。
水产养殖水体藻类管控
在养殖水体中监测有害藻类与有益藻类比例,辅助养殖水质管理。
水环境监测与科研
作为水环境监测站、科研院所的藻类自动识别工具,提升监测效率与数据一致性。
科研教学
用于藻类分类识别、目标检测 算法 研究等科研场景。
七、适用研究方向
本数据集可广泛应用于以下研究领域:
- 藻类检测与分类研究(11类)
- 显微图像目标检测研究
- 密集小目标检测研究(藻类细胞微小)
- 水体生态监测与评价研究
- 水华预警与赤潮防治研究
- YOLO系列模型优化研究
- 轻量化检测模型与边缘部署研究
- 域适应与跨水体泛化研究
八、总结
藻类检测数据集包含约34000张高质量标注图像,采用标准YOLO格式构建,专注于水体浮游藻类的检测与分类任务。数据集覆盖亚历山大藻、束丝藻(含束状/丝状)、平列藻、中心硅藻、隐藻、裸藻、卵胞藻、颤藻目、雪藻-乌龙藻11类核心藻类,具有样本量庞大、门类覆盖完整、形态细分精细等特点,可广泛应用于水华预警、水质监测、生态评估、水产养殖等领域,是开展藻类智能检测算法研发与水环境监测系统建设的优质数据资源。

