
Personal Agent 目前还没有统一的技术定义。Meta 把 Muse 明确称为 Personal AI Agent,OpenAI 将 dots 定义为 always-on agents,SpaceXAI 则把 Grok Bot 放在 persistent agents 的框架下讨论。名称虽不相同,但这些系统都开始处理一个相似的问题:Agent 长期运行以后,怎样在多次任务之间继续使用状态、连接真实账号,并在用户不持续在线的情况下完成工作。
这些技术并不是到了 Personal Agent 才第一次出现。用户级状态、长期记忆、OAuth 授权、定时任务,在此前的 Agent 和自动化系统里都已经存在,变化主要发生在使用方式上。当一个 Agent 长期服务同一个用户,这些机制需要在连续多次任务之间持续配合,而不再只服务于眼前的一次执行。
用户状态如何跨任务保存并重新进入上下文
长期服务一个用户,首先要解决的是状态到底跟谁走。
这并不是 Personal Agent 才出现的问题。Google ADK 已经提供了不同作用域的状态:会话级状态只属于当前会话,用户级状态则可以被同一用户的多个会话继续访问。
到了 dots 这类长期运行的 Agent,这类用户状态开始直接参与后续工作。OpenAI 官方文档写明,dot 可以接收 ChatGPT 中已有的记忆,也可以从连接的应用中形成自己的记忆,并把这些信息用于后续任务。与此同时,每个任务又有自己的对话,并不会自动获得用户和 dot 之间的全部历史对话。
这就把问题继续推到了下一层:保存下来的长期信息,下一次任务到底该取回哪些?
长期记忆和当前上下文在这里需要分开。长期记忆负责让信息跨请求继续存在;上下文则是一次模型调用实际装载的工作集,其中除了长期记忆,还可能包含当前用户指令、文件、工具结果、实时状态和系统指令。
今年 7 月发布的一份《Architecture and Data Model for Persistent Memory in Agentic Systems》互联网草案,对此做了明确区分:长期记忆是跨请求保存、可继续寻址的状态,上下文窗口则是为一次具体操作临时组装的内容。
假设一个 Coding Agent 昨天处理了某个 PR,发现一种实现存在竞态条件。这个结论如果以后还有价值,可以长期保存。第二天再次进行代码审查时,模型没有必要重新读取昨天全部对话,系统只需要取回相关项目、PR、此前结论和原因,再加入最新代码、CI 状态和今天的用户指令。实际过程就可以拆成:
长期保存 → 按当前任务取回相关信息 → 与实时信息一起组成当前上下文
Meta 在 Muse Wonder 中把相关能力称为 Active Memory。官方定义里包含两个动作:把与用户有关的重要上下文带到不同对话之间,并主动取回当前任务需要的细节。
因此,长期服务同一个用户以后,记忆系统还需要处理写入、更新、失效、来源和冲突。错误或已经过期的信息如果继续被取回,也会进入后面的任务。
长期代表用户工作时如何管理授权和凭证
Personal Agent 往往会长期连接邮箱、日历、文件、浏览器和其他账号。此时工具调用不仅涉及模型会不会使用工具,还涉及当前这次操作有没有得到授权,以及授权可以持续多久。
Muse 的实现把这部分拆得很具体。Muse 的核心 Agent 运行在隔离环境中;hatch-authd 负责存储 OAuth Token 等真实凭证,并使用凭证代理机制,让主 Agent 无法直接看到这些敏感信息。连接外部服务和访问网络时,操作还需要经过 Sentinel。Sentinel 独立判断这项操作应该允许、拒绝,还是要求用户确认。
真实凭证也不是直接交给 Agent 使用。需要认证的网络请求先携带代理凭证,操作通过 Sentinel 授权后,真实凭证才会在网络边界被替换进去。Meta 还支持一次性、会话级、任务级、限时和长期等不同授权范围。
这样一个长期工作的 Agent 至少要维护两类状态:
它当前能够使用哪些工具和账号;
用户此前授予的操作权限,现在是否仍然有效。
OpenAI dots 也有类似的控制机制。用户可以给不同操作设置规则:直接执行、预先批准后执行、执行前询问,或者交回用户处理。这些自定义规则不能赋予应用本身没有开放的权限,也不能覆盖内置安全限制;例如修改密码这样的步骤仍需要用户本人完成。
所以,当用户说“把这封邮件发出去”时,这条指令可以明确当前操作意图,但实际执行仍然受现有连接权限、操作规则和安全检查约束。到了持续运行场景,授权生命周期本身也成为工程问题:
昨天授予的权限今天还能不能用?
读取邮箱是否包含发送邮件?
一次任务的授权能否延续到下一次后台任务?
哪些高风险操作必须重新确认?
这些都不能只靠“Agent 有没有这个工具”来解决。
没有新的用户指令时如何启动后台任务
长期运行的 Agent 还要处理任务从哪里开始。
Grok Bot 的 Routine 可以由时间表或外部事件触发。SpaceXAI 给出的例子包括每天固定时间执行、PR 打开、CI 检查失败、Slack 出现新消息等;一次工作也可以由另一个 Bot 启动。
OpenAI dots 同样支持计划任务。用户可以让 dot 定期检查日历或执行重复任务;dot 也可以在没有新问题时主动查看已连接的信息并形成记忆。
这里需要把触发执行和执行权限分开处理。一个事件只负责让系统创建一次新的执行,并不会自动增加这次执行的权限。
OpenAI 对 dots 的主动研究就做了明确限制:它可以读取已经允许访问的信息源并保存私有笔记,但主动研究工具不能直接向其他人发送消息、修改插件里的内容,也不能控制浏览器或电脑;如果后续需要采取进一步操作,仍然要经过正常的操作规则和安全检查。
例如 GitHub 上某个 PR 更新,可以触发一次新的任务:读取代码变化、分析逻辑并生成代码审查建议。但“PR 更新”这个事件只负责启动任务,并不会因此赋予 Agent 合并代码的权限。从运行时角度看,这里实际上是两套机制:
触发机制决定什么时候创建一次新的执行;
授权机制决定这次执行里允许做什么。
跨系统访问如何传递用户身份与授权范围
前面几个问题大多发生在 Agent 产品内部。当 Personal Agent 开始代表用户访问另一家公司的网页、API 或企业 Agent,还会出现一个新的跨系统关系:
用户 → Personal Agent → 外部服务
外部服务需要知道的不只是“是谁发来了这个请求”,还包括:
这个 Agent 正在代表哪个用户;
用户是否已经完成认证;
用户给这个 Agent 开放了什么范围;
当前操作有没有超出这个范围。
Meta、Sierra 等正在开发的 Personal Agent Protocol 就在处理这类问题。Sierra 对协议目标的描述包括认证 Personal Agent、让用户控制访问范围,以及让企业了解 Personal Agent 通过网站、API 或企业 Agent 执行的操作。
协议建立在 OAuth 之上。Personal Agent 可以先以访客身份建立会话;如果后面的任务需要访问用户账户,用户可以登录,或者使用已经配置给 Personal Agent 的凭证。用户还可以决定提供只读权限还是写权限。这个会话可以继续跨网站、API 或企业 Agent 等不同交互方式延续。
这部分和普通的工具调用已经有所不同。Agent 本地有一个“下单”工具,并不能解决外部企业如何确认:
这是哪个用户的 Agent?
用户允许它做什么?
企业自己的策略允许它做到什么程度?
Personal Agent 长期代表用户跨服务工作之后,身份和授权也需要跟着任务一起跨越产品边界。
把四个问题连起来
把 Muse、dots、Grok Bot 以及 Personal Agent Protocol 放在一起看,能够看到一条比较完整的技术链:
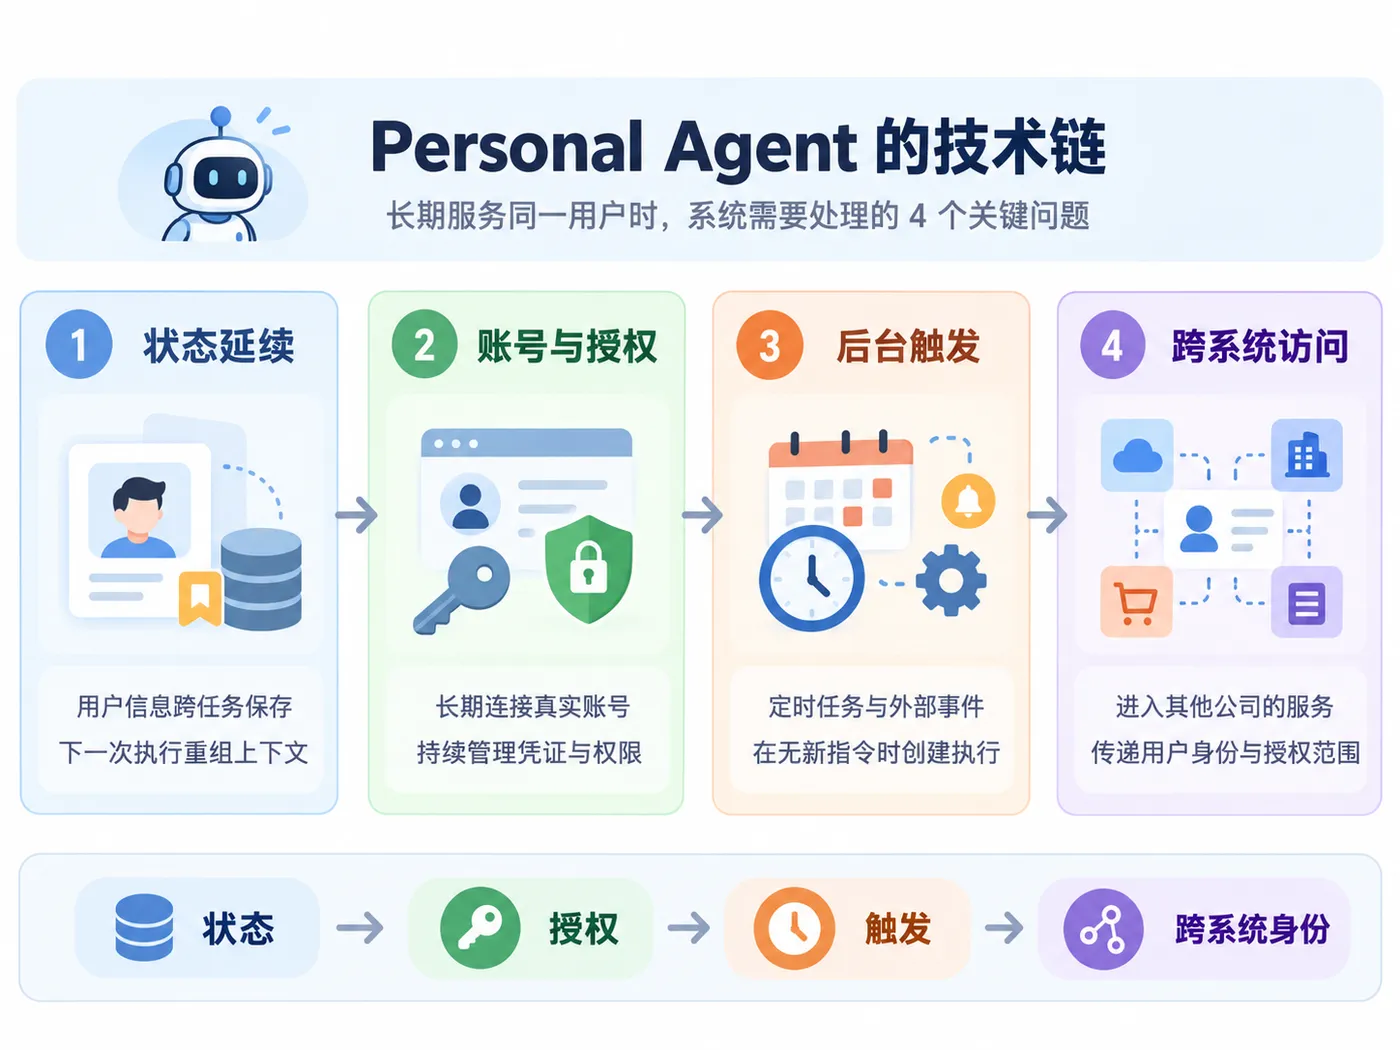
用户信息需要跨任务保存,并在下一次执行时重新组成上下文;Agent 长期连接真实账号,需要持续管理凭证和授权;定时任务和外部事件可以在没有新 Prompt 时创建新的执行;一旦 Agent 进入其他公司的服务,用户身份和授权范围还需要跨系统传递。
这些技术在 Personal Agent 出现以前就已经分别存在于 Agent 框架、自动化系统和身份授权体系中。
现在的变化在于,它们开始同时服务于一个长期存在、持续代表同一用户工作的 Agent。一次任务结束以后,下一次任务还需要继续知道:哪些状态应该保留、哪些信息现在需要取回、哪些权限仍然有效,以及哪些操作必须重新交给用户确认。
这也是 Muse、dots 这类 Personal Agent 产品在模型能力之外,需要处理的一组系统工程问题。Meta 在介绍 Muse 时明确提到,它第一次把收件箱、日历和 Shell 交给软件,并允许它在无人值守时运行,因此大量工程投入都放在隔离、凭证、权限和安全边界上。

