摘要:自 ChatGPT 引爆大模型浪潮以来,如何高效地构建 LLM 驱动的应用成为每个工程师的核心命题。LangChain 作为大模型应用开发的事实标准框架,以其模块化设计、丰富的组件生态和强大的编排能力,让开发者能够以"搭积木"的方式快速构建生产级 AI 应用。本文从 LangChain 的核心架构、关键组件(Model I/O、Retrieval、Chains、Agents)到 LCEL 表达式语言,结合 Java/大数据工程师的视角,系统拆解 LangChain 的设计哲学与应用全景。
关键词:LangChain, LLM, RAG, Agent, 大模型应用开发, LCEL, LangGraph, 向量数据库
一、LangChain 是什么?
2023年,大语言模型(LLM)以摧枯拉朽之势席卷了整个技术圈。从 GPT-3.5 到 GPT-4,从 Llama 到 Claude,模型能力日新月异。但很快,工程师们发现了一个棘手的问题:
直接调用 LLM API 写一个简单的问答系统很容易,但要构建一个真正可用的、复杂的 AI 应用却异常困难。
你很快会遇到这些痛点:
- 提示词管理失控:prompt 散落在代码各处,版本不可追踪,团队协作一团乱麻
- 上下文窗口限制:用户想基于 100 页 PDF 提问,但 GPT-4 一次只能处理有限 token
- 模型调用碎片化:有的任务要调 OpenAI,有的切 Llama,代码中塞满了 if-else
- 缺乏记忆机制:每次对话都是"全新开始",多轮对话需要自行管理历史
- 工具编排混乱:想让模型调用搜索引擎、数据库、API,发现每一步都要手写胶水代码
LangChain 正是为了解决这些工程化难题而生。
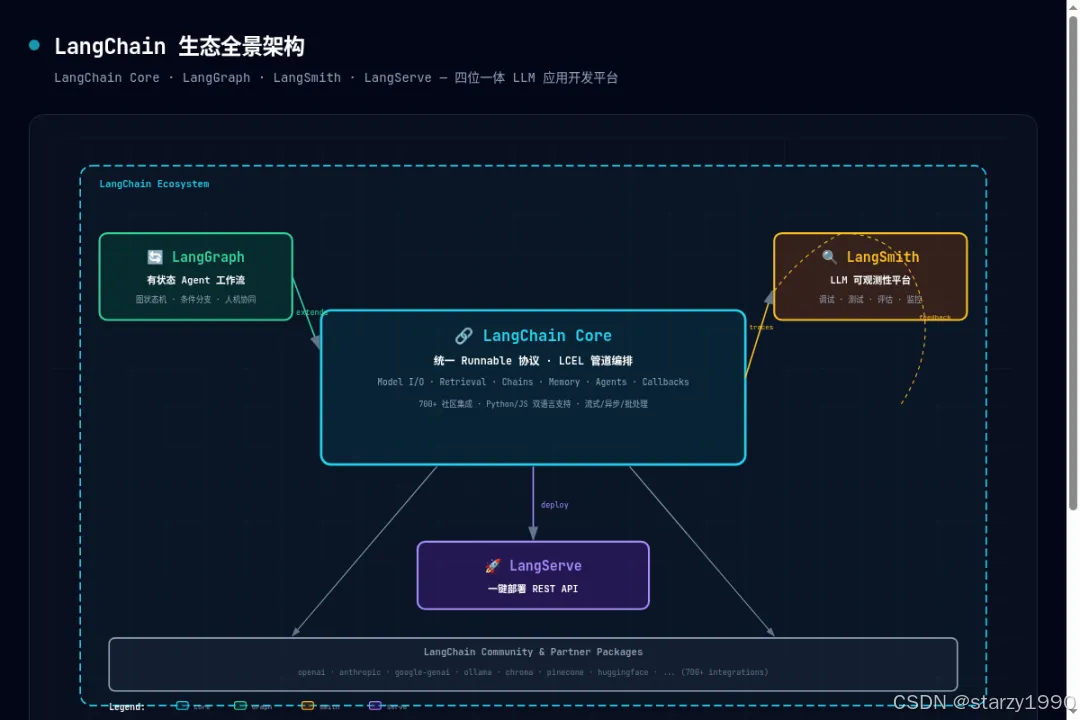
LangChain 由 Harrison Chase 于 2022 年底创建,是一个用于构建 LLM 驱动应用的开源框架。它的核心设计理念是:将 LLM 应用开发中的通用模式抽象为可复用的组件(Components),并通过链(Chains)和智能体(Agents)将这些组件编排为完整的应用流水线。
截至 2025 年,LangChain 已经发展为一套完整的生态体系:
| 组件 | 定位 | 说明 |
|---|---|---|
| LangChain Core | 基础框架 | 提供 LCEL、Runnable 接口、标准化组件抽象 |
| LangChain Community | 社区集成 | 700+ 第三方集成(LLM、向量库、工具) |
| LangGraph | 状态机编排 | 构建有状态的、多角色的 Agent 工作流 |
| LangSmith | 可观测性平台 | LLM 应用的调试、测试、评估和监控 |
| LangServe | 部署服务 | 将 LangChain 链一键部署为 REST API |
二、LangChain 的核心特点
2.1 模型无关(Model-Agnostic)
LangChain 最大的设计优势是与具体模型解耦。无论底层是 OpenAI GPT-4、Anthropic Claude 还是开源 Llama 3,你都可以通过统一的接口调用:
from langchain_openai import ChatOpenAI
from langchain_anthropic import ChatAnthropic

# 切换模型只需改一行代码,其余逻辑完全不变
llm = ChatOpenAI(model="gpt-4o")       # OpenAI
# llm = ChatAnthropic(model="claude-3") # Claude
# llm = ChatOllama(model="llama3")      # 本地 Llama

response = llm.invoke("什么是 LangChain?")
2.2 模块化与可组合性
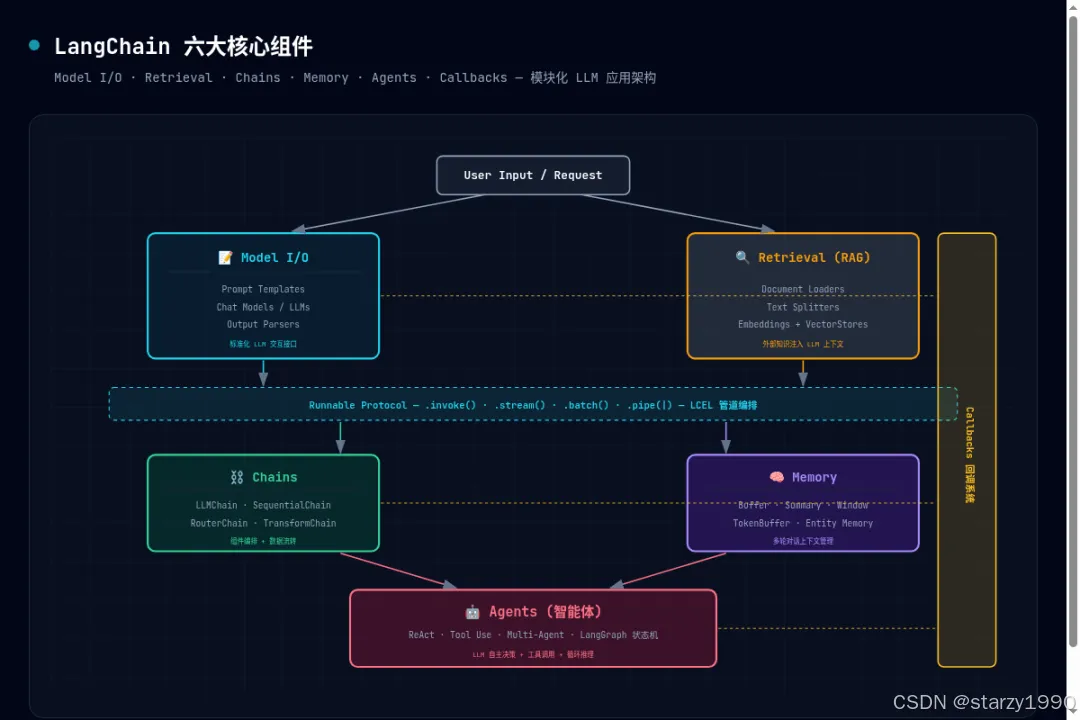
LangChain 将 LLM 应用的每个环节都抽象为独立的标准组件,你可以像搭积木一样自由组合:
Models ← Prompts ← Chains ← Agents
   ↑         ↑        ↑       ↑
   └─── Retrievers ──┘       │
        ↑                    │
   └─── Memory ──────────────┘
每个组件都有明确定义的输入输出接口(Runnable 协议),组件之间通过 LCEL(LangChain Expression Language) 用管道符 | 串联,形成数据流水线。
2.3 生产级特性支持
LangChain 不只是"玩具框架",它内置了大量生产环境必需的工程能力:
- 流式输出(Streaming):支持 token 级别的实时流式返回,大幅提升用户体验
- 异步支持(Async):全链路支持 asyncio,轻松应对高并发场景
- 回调系统(Callbacks):细粒度的钩子机制,支持日志、监控、成本追踪
- 回退策略(Fallbacks):模型不可用时自动降级到备选方案
- 批处理(Batch):内置批量处理能力,降低 API 调用成本
2.4 丰富的生态集成
LangChain 拥有业内最庞大的集成生态,覆盖 700+ 第三方服务:
LLM 提供商    :OpenAI, Anthropic, Google, Cohere, Ollama, HuggingFace...
向量数据库    :Chroma, Pinecone, Weaviate, Milvus, FAISS, Qdrant...
文档加载器    :PDF, CSV, HTML, Markdown, Notion, Google Drive...
工具集成      :搜索引擎, 数据库, API调用, 代码执行器, 文件系统...
三、六大核心组件深度拆解
3.1 Model I/O(模型输入输出)
LangChain 将 LLM 交互抽象为三个标准环节:
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI
from langchain_core.output_parsers import StrOutputParser

# 1️⃣ Prompt 模板:标准化输入
prompt = ChatPromptTemplate.from_template(
    "你是{role}专家,请用{language}回答:{question}"
)

# 2️⃣ LLM 调用:模型无关的统一接口
model = ChatOpenAI(model="gpt-4o", temperature=0.7)

# 3️⃣ Output Parser:结构化输出
parser = StrOutputParser()

# LCEL 串联
chain = prompt | model | parser
result = chain.invoke({

    "role": "大数据架构",
    "language": "中文",
    "question": "Flink 和 Spark Streaming 如何选型?"
})
3.2 Retrieval(检索增强生成)
RAG(Retrieval-Augmented Generation)是 LangChain 最核心的应用模式:
from langchain_community.document_loaders import PyPDFLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_openai import OpenAIEmbeddings
from langchain_community.vectorstores import Chroma

# 1. 文档加载
loader = PyPDFLoader("企业数据中台建设指南.pdf")
documents = loader.load()

# 2. 文档切分
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=1000, chunk_overlap=200
)
splits = text_splitter.split_documents(documents)

# 3. 向量化 + 存储
vectorstore = Chroma.from_documents(
    documents=splits,
    embedding=OpenAIEmbeddings()
)

# 4. 检索 + 生成
retriever = vectorstore.as_retriever(search_kwargs={
   "k": 4})

from langchain_core.runnables import RunnablePassthrough
from langchain_core.prompts import ChatPromptTemplate

template = """基于以下上下文回答问题:
{context}

问题:{question}
"""

prompt = ChatPromptTemplate.from_template(template)

rag_chain = (
    {
   "context": retriever, "question": RunnablePassthrough()}
    | prompt
    | model
    | parser
)
3.3 Chains(链式调用)
Chain 是 LangChain 的核心编排单元。它将多个组件按顺序串联,数据在组件之间流转处理:
from langchain.chains import LLMChain, SequentialChain

# 步骤1:生成大纲
outline_prompt = ChatPromptTemplate.from_template(
    "为主题 '{topic}' 生成详细大纲"
)
outline_chain = LLMChain(llm=model, prompt=outline_prompt, output_key="outline")

# 步骤2:根据大纲撰写内容
content_prompt = ChatPromptTemplate.from_template(
    "根据大纲:\n{outline}\n\n撰写完整文章"
)
content_chain = LLMChain(llm=model, prompt=content_prompt, output_key="content")

# 串联执行
pipeline = SequentialChain(
    chains=[outline_chain, content_chain],
    input_variables=["topic"],
    output_variables=["outline", "content"]
)
3.4 Memory(记忆系统)
多轮对话的关键在于上下文管理。LangChain 提供了多种记忆策略:
| 记忆类型 | 策略 | 适用场景 |
|---|---|---|
ConversationBufferMemory |
全量保存 | 短对话 |
ConversationBufferWindowMemory |
滑动窗口 | 中等长度对话 |
ConversationSummaryMemory |
摘要压缩 | 长对话 |
ConversationTokenBufferMemory |
Token 限制 | 精确成本控制 |
ConversationSummaryBufferMemory |
摘要+缓冲混合 | 最佳平衡 |
3.5 Agents(智能体)
Agent 是 LangChain 最具"智能感"的组件。它不再按固定流程执行,而是让 LLM 自己决定何时调用何种工具、以何种顺序完成任务:
from langchain.agents import create_openai_functions_agent, AgentExecutor
from langchain_community.tools import WikipediaQueryRun, ArxivQueryRun
from langchain_community.tools.tavily_search import TavilySearchResults

# 定义工具集
tools = [
    TavilySearchResults(max_results=3),    # 网络搜索
    WikipediaQueryRun(api_wrapper=...),     # Wikipedia
    ArxivQueryRun(),                        # 学术论文检索
]

# 创建 Agent
agent = create_openai_functions_agent(llm=model, tools=tools, prompt=agent_prompt)
agent_executor = AgentExecutor(
    agent=agent, tools=tools,
    verbose=True, max_iterations=5
)

# Agent 自主规划执行
result = agent_executor.invoke({

    "input": "2024年Transformer架构有哪些重要改进?检索论文并总结"
})
Agent 的执行流程:思考 → 行动 → 观察 → 思考 → ... → 最终答案,这就是著名的 ReAct(Reasoning + Acting)模式。
3.6 Callbacks(回调系统)
Callbacks 提供了对 LLM 应用全链路的可观测能力:
from langchain.callbacks import StdOutCallbackHandler
from langchain.callbacks.base import BaseCallbackHandler

class CostTracker(BaseCallbackHandler):
    def on_llm_end(self, response, **kwargs):
        tokens = response.llm_output["token_usage"]
        cost = tokens["total_tokens"] * 0.00001  # GPT-4 计费
        print(f"💰 本次调用消耗 {tokens['total_tokens']} tokens, 约 ${cost:.4f}")

chain.invoke(input, config={
   "callbacks": [CostTracker()]})
四、LCEL:LangChain 的"管道符"革命
LCEL(LangChain Expression Language)是 LangChain 最优雅的设计之一。它使用 Unix 管道符 | 来串联组件:
# ❌ 传统方式:层层嵌套,难以阅读
result = parser.parse(model.generate(prompt.format(input)))

# ✅ LCEL 方式:从左到右,清晰直观
chain = prompt | model | parser
result = chain.invoke(input)
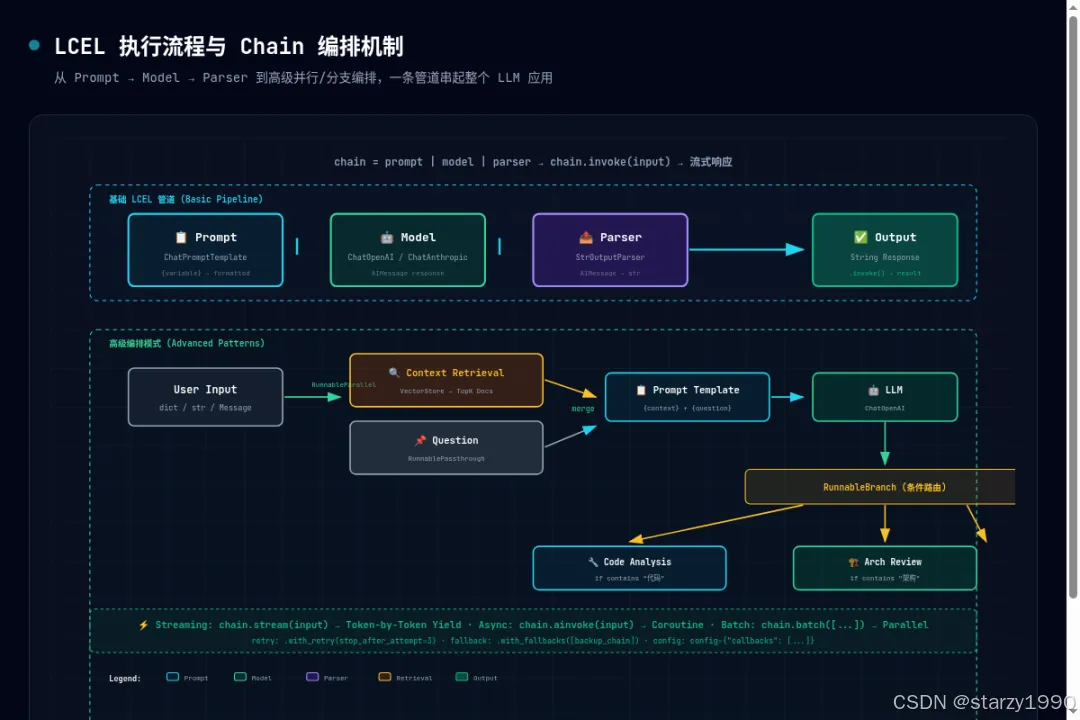
LCEL 带来的不仅是语法糖,更是强大的工程能力:
- 自动并行化:当多个步骤无依赖关系时,LCEL 自动并发执行
- 流式传输:一条
chain.stream()实现端到端 token 级流式输出 - 内置重试/回退:
.with_retry()和.with_fallbacks()声明式配置 - 运行时配置:通过
RunnableConfig动态注入参数
# LCEL 高级用法:并行分支 + 条件路由
from langchain_core.runnables import RunnableBranch

analyze_chain = (
    prompt
    | model
    | RunnableBranch(
        (lambda x: "代码" in x, code_analyzer),
        (lambda x: "架构" in x, arch_reviewer),
        general_handler  # 默认分支
    )
)
五、典型应用场景
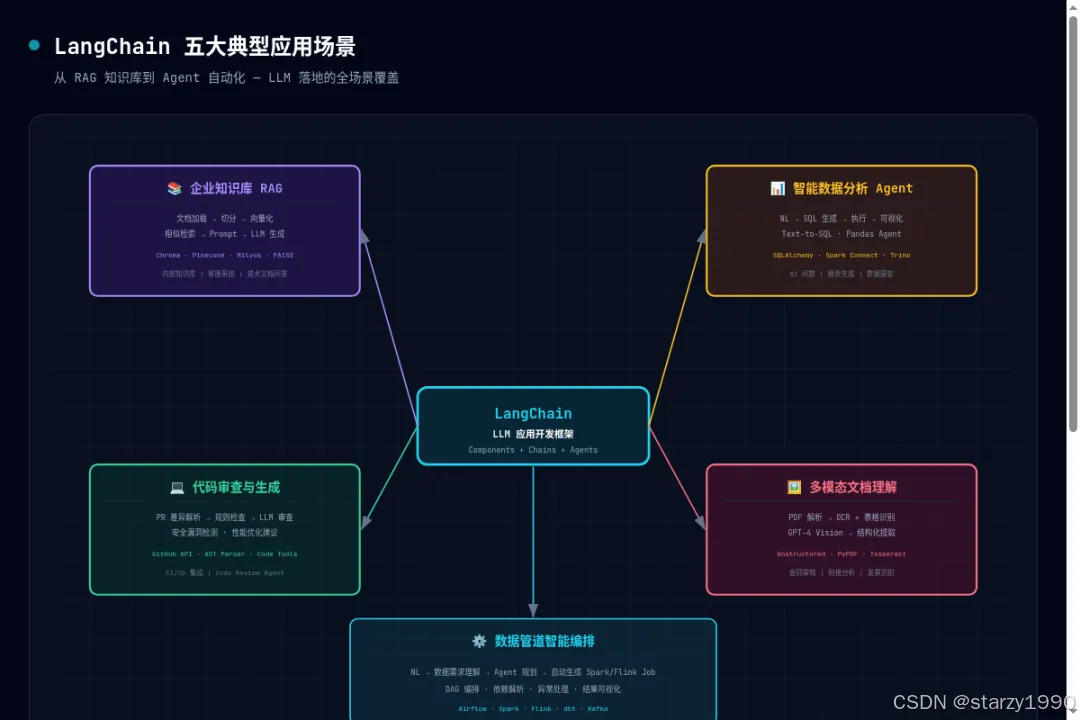
5.1 企业知识库问答(RAG)
场景:基于企业内部文档(技术手册、运维手册、设计文档)构建智能问答系统。
架构:文档 → 加载 → 切分 → 向量化 → 存储 → 用户提问 → 相似检索 → LLM 生成 → 答案
技术栈:LangChain + Chroma/Pinecone + OpenAI Embedding + FastAPI
5.2 智能数据分析助手
场景:用自然语言查询数据库,自动生成 SQL 并可视化结果。
from langchain_community.utilities import SQLDatabase
from langchain_experimental.sql import SQLDatabaseChain

db = SQLDatabase.from_uri("mysql://user:pass@localhost/analytics")
db_chain = SQLDatabaseChain.from_llm(llm, db, verbose=True)

db_chain.run("上个月各产品线的营收排名和环比增长率是多少?")
5.3 自动化代码审查 Agent
场景:提交 PR 后自动审查代码质量、安全漏洞和性能问题。
技术栈:LangGraph + GitHub API + Code Analysis Tools + Claude
5.4 多模态文档理解
场景:同时处理 PDF 中的文字、表格、图片,自动提取结构化信息。
技术栈:LangChain + Unstructured + GPT-4 Vision + LlamaIndex
5.5 数据管道智能编排
场景:用自然语言描述数据处理需求,Agent 自动生成 Spark/Flink 作业。
技术栈:LangChain Agent + Spark Connect + Airflow
六、LangChain vs 其他框架速览
| 维度 | LangChain | LlamaIndex | 自研 |
|---|---|---|---|
| 上手门槛 | 中等 | 中低 | 高 |
| 灵活性 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐⭐⭐⭐ |
| 生态丰富度 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐ | ⭐ |
| RAG 支持 | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | 需自建 |
| Agent 能力 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐ | 需自建 |
| 生产可观测 | LangSmith | 无 | 需自建 |
| 适用团队 | 全场景 | 专注RAG | 极致定制需求 |
七、写在最后
LangChain 不是银弹,但它为大模型应用开发提供了一套经过大量生产验证的最佳实践框架。对于 Java 和大数据工程师而言,LangChain 的模块化设计理念与后端开发中"分层架构 + 依赖注入"的思路一脉相承,学习曲线相对友好。
几点建议供参考:
- 新手入门:从 LCEL + RAG 开始,这是 80% 应用场景的基石
- 进阶方向:掌握 Agent 和 LangGraph,解锁复杂工作流编排
- 生产落地:接入 LangSmith 做可观测性,避免"黑盒"运行
- 持续关注:LangChain 版本迭代快,建议锁定稳定版本并关注 Changelog
大模型时代,框架只是工具,理解原理才能举一反三。希望本文能帮助你建立 LangChain 的系统认知,迈出 AI 应用落地的第一步。
starzy · AI Data Engineer / 大数据技术实践者
blog.starzy.cn · GitHub: starzy1990.github.io
专注 AI Agent · LangGraph · RAG · 大数据架构 · 数据工程实践