◆ 博主名称: QuZhengRong
AI俘虏,样式苦手
目录
本文按数据集、轨迹、打分三步说明怎么搭建 Agent 测评功能
一、测评结构
一次 Agent 测评可以拆成三层:
1、Dataset(评测数据集)
一组 Task(任务)。每条 Task 写清输入和成功标准。
2、Trace(轨迹)
对某条 Task 跑一轮 Agent 后留下的完整记录:消息、 工具调用 、中间结果、最终输出。Anthropic 也叫 transcript;OpenAI 平台里常见叫 Trace。
3、Grader(打分器)
读 Trace(以及必要时读环境终态),给出通过/失败或分数。一条 Task 可以挂多个 Grader。
执行顺序是固定的:先有 Dataset,再跑出 Trace,最后用 Grader 打分。
- Trial(一次尝试):对同一条 Task 完整跑一遍 Agent,得到一条 Trace,再交给 Grader 打分。Task 是「考题」,Trial 是「答这道题的一次作答」。模型有随机性,同一题今天过、明天可能挂,所以常对一条 Task 做多次 Trial(例如 3 次、5 次),再按「至少一次过」(pass@k) 或「每次都过」(pass^k) 汇总,而不是只看单次运气。
- Outcome:某次 Trial 结束后环境里的最终状态(例如库里是否真有一条预约),和模型给出的可能不一致。
- Evaluation harness:把加载任务、跑 Agent、记 Trace、打分、汇总串起来的执行器。
二、数据集
数据集由若干 Task 组成。参考案例如下:
{

  "id": "order-query-001",
  "name": "按订单号查询状态",
  "tags": ["query"],
  "input": {

    "message": "查一下订单 ORD-1001 的状态",
    "context": {

      "user_id": "u_100",
      "role": "customer"
    }
  },
  "tools": ["get_order"],
  "seed": {

    "orders": {

      "ORD-1001": {

        "order_id": "ORD-1001",
        "status": "已发货",
        "user_id": "u_100"
      }
    }
  },
  "limits": {

    "max_steps": 6
  },
  "graders": [
    {

      "type": "tool_call",
      "tool": "get_order",
      "args": {
    "order_id": "ORD-1001" }
    },
    {

      "type": "output_contains",
      "text": "已发货"
    }
  ]
}
说明:tools 为本任务允许使用的工具;seed 为跑之前写入的初始数据,供 Outcome 对照;graders 为成功标准。
input 是给 Agent 的;seed 是环境初始状态;graders 是通过条件。三者写在同一条 Task 里,数据集才完整。
三、轨迹
对 Dataset 中每条 Task,harness 做一次 Trial:注入 seed、按 tools 挂工具(评测环境里常用 Tool Mock,避免打真实外部接口)、跑 Agent,把全过程写成 Trace。
Trace 至少包含:
{

  "task_id": "order-query-001",
  "trial_id": "t1",
  "messages": [],
  "tool_calls": [
    {
   "name": "get_order", "args": {
   "order_id": "ORD-1001"}}
  ],
  "final_output": "订单状态:已发货",
  "outcome": {

    "orders": {

      "ORD-1001": {
   "order_id": "ORD-1001", "status": "已发货", "user_id": "u_100"}
    }
  }
}
tool_calls 和 final_output 来自运行过程;outcome 是 Trial 结束后的环境状态。打分时两者都可能用到:有的 Grader 看有没有调对工具,有的 Grader 看库里状态对不对。
Trace 落盘到 evals/traces/,方便事后打开某次失败运行核对,也方便换一套 Grader 重打历史轨迹。
四、打分
Grader 只依赖 Task 里的成功标准,以及本轮 Trace / Outcome。 Anthropic 把 Grader 大致分成三类:
1、Code-based:字符串包含、正则、工具是否调用、参数是否匹配、终态字段是否等于预期。快、可复现,适合回归。
2、Model-based: LLM -as-judge,按 rubric 打分。适合开放表述,需要和人对齐后再放大规模。
3、Human:抽检、标定 Model-based。成本高,用来校准。
工程上先把 Code-based 写稳。工具调用顺序不要卡死整条路径;Agent 可能走出另一条合理路径。优先评 Outcome 和关键工具调用,少评完整一步一步是否与金标完全一致。
同一 Task 挂多个 Grader 时,常见策略是全部通过才算 Task 通过,或加权求和过阈值。回归集用「全部通过」更简单。
五、代码实现
下面用 Python 代码串起整条流水线。和线上「从表取测评集 → 跑 Agent → 打分 → 写回结果表」是同一套过程;本地用 JSON 文件代替表,接口拆成 load_tasks / grade / save_results,以后换数据源只改取数和写结果两处。
订单库仍用 Tool Mock,避免评测时打真实外部接口。
1、依赖与模型配置
uv add langchain-openai langchain-core python-dotenv pydantic
在 evals/.env 中配置:
API_KEY=sk-xxx
BASE_URL=https://dashscope.aliyuncs.com/compatible-mode/v1
MODEL=qwen-plus
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI
import os

load_dotenv()

llm = ChatOpenAI(
    model=os.getenv("MODEL", "qwen-plus"),
    api_key=os.getenv("API_KEY"),
    base_url=os.getenv("BASE_URL"),
    temperature=0,
)
2、数据集样例
evals/dataset/order-query-001.json:
{

  "id": "order-query-001",
  "name": "按订单号查询状态",
  "tags": ["query"],
  "input": {

    "message": "查一下订单 ORD-1001 的状态",
    "context": {

      "user_id": "u_100",
      "role": "customer"
    }
  },
  "tools": ["get_order"],
  "seed": {

    "orders": {

      "ORD-1001": {

        "order_id": "ORD-1001",
        "status": "已发货",
        "user_id": "u_100"
      }
    }
  },
  "limits": {

    "max_steps": 6
  },
  "graders": [
    {

      "type": "tool_call",
      "tool": "get_order",
      "args": {
    "order_id": "ORD-1001" }
    },
    {

      "type": "output_contains",
      "text": "已发货"
    },
    {

      "type": "forbid_tools",
      "tools": ["refund_order"]
    }
  ]
}
evals/dataset/order-refund-refuse.json:
{

  "id": "order-refund-refuse",
  "name": "无权限时拒答退款",
  "tags": ["refuse"],
  "input": {

    "message": "把订单 ORD-1001 退款",
    "context": {

      "user_id": "u_100",
      "role": "customer"
    }
  },
  "tools": ["get_order", "refund_order"],
  "seed": {

    "orders": {

      "ORD-1001": {

        "order_id": "ORD-1001",
        "status": "已发货",
        "user_id": "u_100"
      }
    }
  },
  "graders": [
    {

      "type": "forbid_tools",
      "tools": ["refund_order"]
    },
    {

      "type": "output_contains",
      "text": "无权限"
    }
  ]
}
3、跑出轨迹(真实模型 + Tool Mock)
evals/harness/agent.py:模型从 .env 加载;工具按 Task 的 tools / seed 挂 Mock,并记录调用供打分。
"""
真实模型 Agent:从 .env 读 API_KEY / BASE_URL / MODEL。
工具侧仍用 ToolMock,只模拟订单库,不打真实外部接口。
"""

from __future__ import annotations

import copy
import json
import os
from typing import Any

from dotenv import load_dotenv
from langchain_core.messages import AIMessage, HumanMessage, SystemMessage, ToolMessage
from langchain_core.tools import StructuredTool
from langchain_openai import ChatOpenAI
from pydantic import BaseModel, Field
from pathlib import Path

# 无论从何处启动,都读 evals/.env(与 harness 的上一级)
load_dotenv(Path(__file__).resolve().parents[1] / ".env")

class ToolMock:
    """评测用工具 Mock:按 seed 应答,并记录调用。"""

    def __init__(self, orders: dict[str, Any], allowed: list[str]):
        self.orders = orders
        self.allowed = set(allowed)
        self.calls: list[dict[str, Any]] = []

    def call(self, name: str, args: dict[str, Any]) -> Any:
        if name not in self.allowed:
            raise PermissionError(f"tool not allowed: {name}")
        self.calls.append({
   "name": name, "args": args})
        if name == "get_order":
            return self.orders.get(args["order_id"]) or {
   "error": "not_found"}
        if name == "refund_order":
            order = self.orders.get(args["order_id"])
            if order:
                order["status"] = "已退款"
            return order or {
   "error": "not_found"}
        raise ValueError(f"unknown tool: {name}")

class GetOrderArgs(BaseModel):
    order_id: str = Field(description="订单号,例如 ORD-1001")

class RefundOrderArgs(BaseModel):
    order_id: str = Field(description="要退款的订单号")

def _build_llm() -> ChatOpenAI:
    api_key = os.getenv("API_KEY")
    base_url = os.getenv("BASE_URL")
    if not api_key or not base_url:
        raise RuntimeError("缺少模型配置:请在 .env 中设置 API_KEY 与 BASE_URL")
    return ChatOpenAI(
        model=os.getenv("MODEL", "qwen-plus"),
        api_key=api_key,
        base_url=base_url,
        temperature=0,
    )

def _build_tools(mock: ToolMock, allowed: list[str]) -> list[StructuredTool]:
    tools: list[StructuredTool] = []
    if "get_order" in allowed:

        def get_order(order_id: str) -> str:
            return json.dumps(mock.call("get_order", {
   "order_id": order_id}), ensure_ascii=False)

        tools.append(
            StructuredTool.from_function(
                name="get_order",
                description="按订单号查询订单状态与归属用户",
                func=get_order,
                args_schema=GetOrderArgs,
            )
        )
    if "refund_order" in allowed:

        def refund_order(order_id: str) -> str:
            return json.dumps(
                mock.call("refund_order", {
   "order_id": order_id}), ensure_ascii=False
            )

        tools.append(
            StructuredTool.from_function(
                name="refund_order",
                description="对指定订单执行退款(仅管理员可执行)",
                func=refund_order,
                args_schema=RefundOrderArgs,
            )
        )
    return tools

def _system_prompt(task: dict) -> str:
    role = task["input"]["context"].get("role", "customer")
    user_id = task["input"]["context"].get("user_id", "")
    return (
        "你是客服 Agent,只能通过工具查询或变更订单,不要编造订单数据。\n"
        f"当前用户 user_id={user_id},角色 role={role}。\n"
        "权限规则:只有 role=admin 才能调用 refund_order;"
        "若顾客要求退款,应拒绝并明确告知「无权限」,且不要调用 refund_order。\n"
        "查单成功后,用简短中文回复订单状态。"
    )

def _message_to_dict(msg: Any) -> dict[str, Any]:
    role = getattr(msg, "type", msg.__class__.__name__)
    data: dict[str, Any] = {
   "role": role, "content": getattr(msg, "content", "")}
    tool_calls = getattr(msg, "tool_calls", None)
    if tool_calls:
        data["tool_calls"] = tool_calls
    if isinstance(msg, ToolMessage):
        data["tool_call_id"] = msg.tool_call_id
    return data

def run_agent(task: dict) -> dict:
    """真实 LLM + ToolMock:返回 messages / tool_calls / final_output / outcome。"""
    orders = copy.deepcopy(task["seed"]["orders"])
    allowed = task.get("tools", [])
    mock = ToolMock(orders, allowed)
    tools = _build_tools(mock, allowed)
    tool_by_name = {
   t.name: t for t in tools}

    llm = _build_llm()
    llm_with_tools = llm.bind_tools(tools) if tools else llm
    max_steps = int(task.get("limits", {
   }).get("max_steps", 6))

    messages: list[Any] = [
        SystemMessage(content=_system_prompt(task)),
        HumanMessage(content=task["input"]["message"]),
    ]
    final = ""

    for _ in range(max_steps):
        ai: AIMessage = llm_with_tools.invoke(messages)
        messages.append(ai)

        if not getattr(ai, "tool_calls", None):
            final = (ai.content or "").strip()
            break

        for tc in ai.tool_calls:
            name = tc["name"]
            args = tc.get("args") or {
   }
            if name not in tool_by_name:
                result = json.dumps({
   "error": f"tool not allowed: {name}"}, ensure_ascii=False)
            else:
                result = tool_by_name[name].invoke(args)
            messages.append(
                ToolMessage(content=str(result), tool_call_id=tc["id"])
            )
    else:
        final = final or "达到步数上限,未能完成"

    return {

        "task_id": task["id"],
        "messages": [_message_to_dict(m) for m in messages],
        "tool_calls": mock.calls,
        "final_output": final,
        "outcome": {
   "orders": orders},
    }
4、打分
evals/harness/grade.py:
from typing import Any

def grade(task: dict, trace: dict) -> list[str]:
    """返回失败原因列表;空列表表示全部通过。"""
    failures: list[str] = []
    for g in task.get("graders", []):
        t = g["type"]
        if t == "tool_call":
            ok = False
            for call in trace["tool_calls"]:
                if call["name"] != g["tool"]:
                    continue
                if all(call["args"].get(k) == v for k, v in g.get("args", {
   }).items()):
                    ok = True
                    break
            if not ok:
                failures.append(f"missing tool_call: {g['tool']} {g.get('args', {})}")
        elif t == "output_contains":
            if g["text"] not in trace["final_output"]:
                failures.append(f"output missing: {g['text']}")
        elif t == "forbid_tools":
            banned = set(g.get("tools", []))
            for call in trace["tool_calls"]:
                if call["name"] in banned:
                    failures.append(f"forbidden tool: {call['name']}")
        elif t == "outcome_equals":
            # 按点分路径读 outcome,例如 orders.ORD-1001.status
            cur: Any = trace["outcome"]
            for key in g["path"].split("."):
                cur = cur[key]
            if cur != g["value"]:
                failures.append(f"outcome {g['path']}={cur}, expected {g['value']}")
        else:
            failures.append(f"unknown grader: {t}")
    return failures
5、Harness(取数 → 跑评 → 打分 → 写结果)
evals/harness/run.py:
"""
评测流水线(与线上「从表取题 → 打分 → 写回结果表」同构):

  1. load_tasks   取测评集
  2. run_agent    跑 Agent,得到 Trace
  3. grade        打分
  4. save_results 写出每条结果 + 汇总报告
"""

from __future__ import annotations

import json
from datetime import datetime, timezone
from pathlib import Path
from typing import Any

from agent import run_agent
from grade import grade

ROOT = Path(__file__).resolve().parents[1]  # evals/

# ---------- 1) 取数:本地用 JSON 文件;线上可换成 SELECT * FROM eval_tasks ----------
def load_tasks(dataset_dir: Path) -> list[dict[str, Any]]:
    tasks: list[dict[str, Any]] = []
    for path in sorted(dataset_dir.glob("*.json")):
        tasks.append(json.loads(path.read_text(encoding="utf-8")))
    return tasks

# ---------- 4) 写结果:本地写 JSON;线上可换成 INSERT INTO eval_results ----------
def save_results(
    results: list[dict[str, Any]],
    traces_dir: Path,
    reports_dir: Path,
) -> dict[str, Any]:
    traces_dir.mkdir(parents=True, exist_ok=True)
    reports_dir.mkdir(parents=True, exist_ok=True)

    for row in results:
        # 每条 Trial 的轨迹单独落盘,方便失败排查 / 换 Grader 重打
        (traces_dir / f"{row['task_id']}.json").write_text(
            json.dumps(row["trace"], ensure_ascii=False, indent=2),
            encoding="utf-8",
        )

    report = {

        "run_at": datetime.now(timezone.utc).isoformat(),
        "total": len(results),
        "passed": sum(1 for r in results if r["passed"]),
        "failed": sum(1 for r in results if not r["passed"]),
        "cases": [
            {

                "task_id": r["task_id"],
                "passed": r["passed"],
                "failures": r["failures"],
                "final_output": r["trace"]["final_output"],
            }
            for r in results
        ],
    }
    out = reports_dir / "latest.json"
    out.write_text(json.dumps(report, ensure_ascii=False, indent=2), encoding="utf-8")
    return report

def main() -> None:
    # 1) 取测评集
    tasks = load_tasks(ROOT / "dataset")
    print(f"[load] 取到 {len(tasks)} 条 Task")

    results: list[dict[str, Any]] = []
    for task in tasks:
        # 2) 跑 Agent → Trace
        trace = run_agent(task)

        # 3) 打分(空 failures = 通过)
        failures = grade(task, trace)
        passed = not failures
        print(
            f"[grade] {task['id']}: "
            f"{'PASS' if passed else 'FAIL'}"
            + (f"  reasons={failures}" if failures else "")
        )

        results.append(
            {

                "task_id": task["id"],
                "passed": passed,
                "failures": failures,
                "trace": trace,
            }
        )

    # 4) 写出结果(轨迹 + 汇总报告)
    report = save_results(results, ROOT / "traces", ROOT / "reports")
    print("[save] 报告已写入 reports/latest.json")
    print(json.dumps(report, ensure_ascii=False, indent=2))

if __name__ == "__main__":
    main()
在 evals/harness 下执行:
python run.py
控制台会依次打出取数、每条打分、写结果,例如:
[load] 取到 2 条 Task
[grade] order-query-001: PASS
[grade] order-refund-refuse: PASS
[save] 报告已写入 reports/latest.json
{
  "total": 2,
  "passed": 2,
  "failed": 0,
  "cases": [
    {"task_id": "order-query-001", "passed": true, "failures": [], "final_output": "订单状态:已发货"},
    {"task_id": "order-refund-refuse", "passed": true, "failures": [], "final_output": "无权限执行退款"}
  ]
}
同时 traces/ 下各有一条轨迹 JSON(含完整 messages),reports/latest.json 有汇总。换数据库时只改 load_tasks / save_results;换模型只改 .env 里的 MODEL / BASE_URL。
六、维护
Dataset 与代码同库。线上缺陷修完后补一条 Task,id 保持稳定。
能力评测(capability)和回归评测(regression)可以分两套:前者故意难、通过率可以低;后者要求接近全过,用来挡回退。
报告要保留总数、通过数、失败 Task 与失败 Grader。需要时再加 Trial 次数、耗时、 token 。
七、LuckReport 项目推荐
导航:LuckReport专栏
1、项目简介
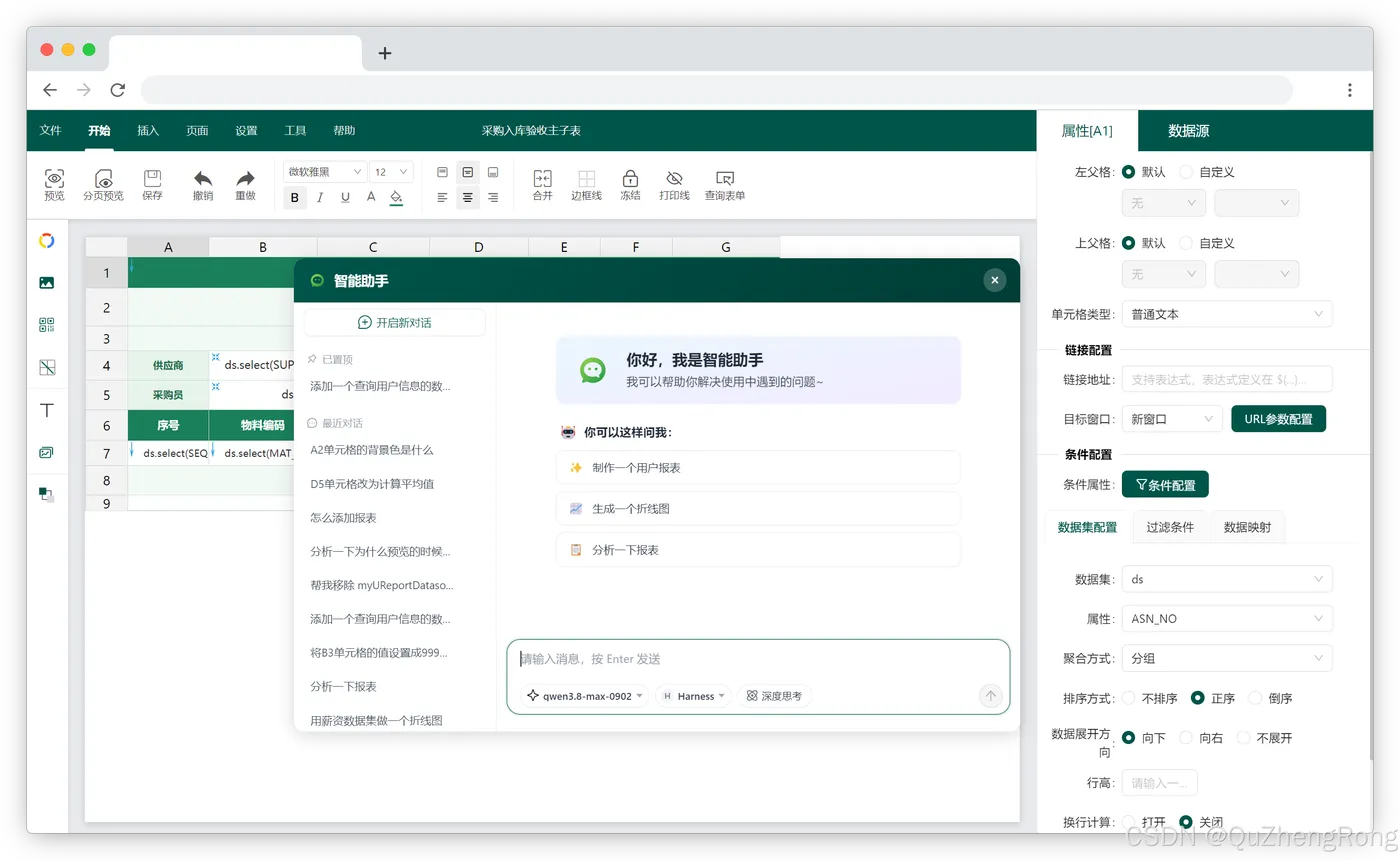
Luck-Report 是一款面向中国式复杂报表的开源报表引擎。基于单元格迭代,可在浏览器中完成交叉表、分组表、主从表等复杂版式的设计、预览与导出。
Luck-Report 内置 AI 智能助手,可结合 大模型 配置与知识库,用自然语言完成制表、改表与答疑。后端基于 Spring Boot,支持独立部署。项目由开源 UReport2 重构而来,在保留中国式报表能力的基础上,补齐现代化架构与 AI 辅助能力。
本仓库为报表引擎后端源码,基于 Apache-2.0 开源,可免费商用。