◆ 博主名称: QuZhengRong
AI俘虏,样式苦手
目录
上一篇讲完了 记忆 机制,Agent 该有的要素差不多齐了:对话、调工具、 RAG 、规划任务、管理记忆。但 Agent 项目除了要具备完整的功能外,我们还需要保障它能够稳定可靠地运行。
实际做过 Agent 开发的人应该都见过类似的问题:任务突然卡住了,过了十几分钟任务推进 0 % ;模型一直重复说胡话,陷入死循环。任务没做完,Agent 却回复完成了。
Agent 的价值在于每一步都能自己拿主意,但风险也同样来源于此。由于 LLM 自带的黑盒特性,它出问题的时候我们往往很难排查出原因。
这一篇要讲的就是 Agent 工程化与兜底:如何应对生产环境的三大典型故障。
一、Agent 翻车
传统程序的执行路径是固定的。比如一个请假申请的后台流程:员工发起请假申请 → 系统校验剩余假期额度 → 推送待办至直属上级审批 → 超长假期触发二级领导审批 → HR 备案归档,审批结果回传给申请人。每一步都在代码里,出了问题能直接定位。
Agent 的步骤是动态规划的,它根据中间结果决定下一步,思考的同时也增加了犯错的概率。
实际开发过程中,我碰到的翻车情况有以下几种:
1、死循环
表现:反复调用同一个工具,或者在几个工具之间来回横跳。
原因其实很简单:LLM 不知道什么时候该停,于是一直尝试调工具,或者调用工具失败,然后反复重试。
解决方法:
1. 设置最大步数,超出步数就强制收尾,程序层面不让它再调了
2. 工具返回结果里如果缺关键信息,直接提示模型向用户提问
2、误调用
表现:用户查询设备运行状态,Agent 调错了工具,查的是设备信息而非当前运行状态;或者工具名相近(get_status / query_status / search_status),模型分不清该用哪个。
原因:工具边界模糊,读写没分开;工具命名风格不统一;参数 Schema 太宽泛,区分度不够。
解决方法:
1. 查询类和执行类工具物理分开,各干各的
2. 参数加校验,格式不对直接抛出异常
3. 收紧参数 Schema 描述,添加错误调用案例
3、权限越界
表现:用户只是问某个配置的含义,Agent 直接去修改了生产配置;或者用户提了一句"帮我分析这个",它理解为执行修改操作而不是只读查询。
原因:工具权限太大,模型认为用户说"帮我处理"就是授权执行,系统 Prompt 里写的规则不一定完全遵循。
解决方法:
1. 高风险动作单独拆出来,提交类工具必须要用户确认
2. 根据账号权限限制工具调用,只允许调用自己权限范围内的工具
二、实战:加盟助手
下面对三个工具按风险分了级,增加了四道防线,跑两轮演示看效果。
from dotenv import load_dotenv
import os
from langchain.tools import tool
from langchain_openai import ChatOpenAI
from langchain_core.messages import SystemMessage, HumanMessage, ToolMessage

load_dotenv()

llm = ChatOpenAI(
    model="qwen-plus",
    api_key=os.getenv("API_KEY"),
    base_url=os.getenv("BASE_URL")
)

# 三个工具按风险分了级:只读查询 / 生成草稿 / 正式提交
@tool
def check_franchise_info(brand: str) -> str:
    """查询指定加盟品牌的信息,只读操作。brand 为品牌全名。"""
    brands = {

        "哪吒仙饮": "加盟费 8 万,要求店面面积 ≥ 80 平、日均客流 ≥ 150 人,总部提供装修和培训支持,回本周期预估 14 个月",
        "旺客炸鸡": "加盟费 5 万,要求店面面积 ≥ 50 平、日均客流 ≥ 200 人,总部提供设备和原料统一配送,回本周期预估 10 个月",
    }
    if brand not in brands:
        return "查询失败:暂未收录这个品牌的加盟信息。hint:请向粉丝确认品牌全名,不要猜。"
    return f"{brand} 加盟信息:{brands[brand]}"

@tool
def draft_franchise_plan(brand: str, budget: str) -> str:
    """生成加盟方案草稿,只生成文本不提交。brand 为品牌全名,budget 为粉丝预算。"""
    return f"【加盟方案草稿】品牌:{brand};预算:{budget};状态:草稿,未提交。"

@tool
def submit_franchise_application(brand: str, budget: str) -> str:
    """正式提交加盟申请。高危操作,必须在粉丝明确确认后才能调用。"""
    return f"加盟申请已提交:{brand},预算:{budget}。"

tools = [check_franchise_info, draft_franchise_plan, submit_franchise_application]
tool_map = {
   t.name: t for t in tools}
llm_with_tools = llm.bind_tools(tools)

SYSTEM_PROMPT = """你是抖音"勇哥餐饮创业说"勇哥的助手,帮粉丝做加盟咨询。

工作规矩:
1. 先查品牌加盟信息再下结论,查不到就问粉丝,禁止猜品牌名
2. 粉丝没明确说"确认提交"之前,绝对不调用 submit_franchise_application,只能先生成方案草稿给粉丝看
3. 同一个工具同样的参数调用失败过,不要原样重试,换思路或者问粉丝"""

# 四道防线
MAX_STEPS = 8                              # 防线一:最大步数,防死循环
BRAND_WHITELIST = ["哪吒仙饮", "旺客炸鸡"]   # 防线二:品牌白名单,防模型瞎编参数
HUMAN_CONFIRMED = False                    # 防线三:粉丝还没确认提交,submit 会被程序拦截
failed_calls = set()                       # 防线四:失败调用记录,同工具同参数不再重试

def guard_check(call: dict):
    """执行前的守门检查,返回 None 表示放行,返回字符串表示拦截原因。

    Args:
        call: 模型产出的工具调用(含 name 和 args 两个键)

    Returns:
        拦截原因文本;None 表示放行
    """
    # 高危动作必须人工确认
    if call["name"] == "submit_franchise_application" and not HUMAN_CONFIRMED:
        return "已被系统拦截:加盟申请属于高危操作,需粉丝明确确认。请先把方案草稿给粉丝看,等确认后再提交。"

    # 品牌名不在白名单,说明模型在瞎编
    brand = call["args"].get("brand", "")
    if brand and brand not in BRAND_WHITELIST:
        return f"已被系统拦截:品牌「{brand}」暂未收录,请向粉丝确认品牌全名。"

    # 同工具同参数已经失败过
    key = (call["name"], tuple(sorted(call["args"].items())))
    if key in failed_calls:
        return "已被系统拦截:这个调用刚才失败过,换个思路或直接问粉丝。"
    return None

def run_guarded_agent(user_input: str) -> str:
    """运行带防线的加盟助手,每次工具调用前都过守门检查。

    Args:
        user_input: 粉丝的咨询内容

    Returns:
        最终回答文本
    """
    messages = [SystemMessage(content=SYSTEM_PROMPT), HumanMessage(content=user_input)]

    for step in range(1, MAX_STEPS + 1):
        response = llm_with_tools.invoke(messages)
        messages.append(response)

        if not response.tool_calls:
            print(f"\n[最终回答]\n{response.content}")
            return response.content

        for call in response.tool_calls:
            blocked = guard_check(call)
            if blocked:
                print(f"[拦截] {call['name']}({call['args']}) -> {blocked}")
                messages.append(ToolMessage(content=blocked, tool_call_id=call["id"]))
                continue

            print(f"[执行] {call['name']}({call['args']})")
            result = tool_map[call["name"]].invoke(call["args"])
            if "失败" in str(result):
                failed_calls.add((call["name"], tuple(sorted(call["args"].items()))))
            print(f"[结果] {result}")
            messages.append(ToolMessage(content=str(result), tool_call_id=call["id"]))

    print("达到最大步数,强制结束。")
    return "达到最大步数,强制结束。"

if __name__ == "__main__":
    print("=== 第一幕:粉丝还没确认 ===")
    run_guarded_agent("勇哥,我想加盟哪吒仙饮,手上大概有 12 万,能帮我分析下吗?合适的话直接帮我提交申请。")

    HUMAN_CONFIRMED = True
    print("\n=== 第二幕:粉丝已确认 ===")
    run_guarded_agent("我确认了。品牌哪吒仙饮,预算 12 万,帮我提交加盟申请吧。")
实际运行轨迹如下(不同模型版本细节会有差异,重点看第一轮里模型想直接调 submit 的时候被拦下的那一行):
=== 第一幕:粉丝还没确认 ===
[执行] check_franchise_info(brand='哪吒仙饮')
[结果] 哪吒仙饮 加盟信息:加盟费 8 万,要求店面面积 ≥ 80 平、日均客流 ≥ 150 人,总部提供装修和培训支持,回本周期预估 14 个月
[执行] draft_franchise_plan(brand='哪吒仙饮', budget='12 万')
[结果] 【加盟方案草稿】品牌:哪吒仙饮;预算:12 万;状态:草稿,未提交。
[拦截] submit_franchise_application(brand='哪吒仙饮', budget='12 万') -> 已被系统拦截:加盟申请属于高危操作,需粉丝明确确认。请先把方案草稿给粉丝看,等确认后再提交。

[最终回答]
哪吒仙饮加盟费 8 万,要求店面 80 平以上、日均客流 150 人,你的 12 万预算应该够。我拟了一份加盟方案草稿……你确认要提交吗?确认了我就帮你交。

=== 第二幕:粉丝已确认 ===
[执行] submit_franchise_application(brand='哪吒仙饮', budget='12 万')
[结果] 加盟申请已提交:哪吒仙饮,预算:12 万。

[最终回答]
加盟申请已经帮你提交了:哪吒仙饮,预算 12 万。接下来等品牌方联系你,按流程走就行……
第一轮里模型确实尝试调用了 submit,被 guard_check 拦下来。拦截原因作为 ToolMessage 写入对话,模型自己调整了策略,改成输出草稿加请求确认。第二轮粉丝确认后 HUMAN_CONFIRMED 被置为 True,submit 才被放行。
这里可以看出模型自己能调整策略,但前提是程序必须兜底做好拦截。
三、生产环境如何定位问题
Agent 的一轮对话背后,往往包含多轮 大模型 调用以及多次工具执行,要排查和追踪整条任务链路,就必须引入链路追踪机制,完整记录每一步的输入、输出以及耗时,示例如下:
[trace_id=run-88] step=1 model_call 耗时 1.2s 输出: 调用 check_franchise_info
[trace_id=run-88] step=2 tool:check_franchise_info(哪吒仙饮) 耗时 0.1s 结果: 加盟费 8 万,回本 14 个月
[trace_id=run-88] step=3 model_call 耗时 0.9s 输出: 生成加盟方案草稿
[trace_id=run-88] step=4 guard:submit_franchise_application 拦截: 高危未确认
上面 demo 里那些 print 就是最朴素的 trace,整理成结构化日志后存起来,出问题了能回放完整链路。生产环境可以用 Langfuse、LangSmith 这类工具。
评估指标
改了一版 prompt 或换了个模型,效果到底是变好了还是变差了?没有评估集的话全凭感觉,不够规范。做法是先攒一批测试问题,每个问题写清楚验收标准(比如粉丝说"合适的话直接帮我提交",验收标准是不能直接提交申请,必须先生成草稿),改完就跑一遍,看任务完成率、平均步数、单次成本这些指标。开放性任务可以用大模型打分,再辅以人工抽检。
四、LuckReport 项目推荐
导航:LuckReport专栏
1、项目简介
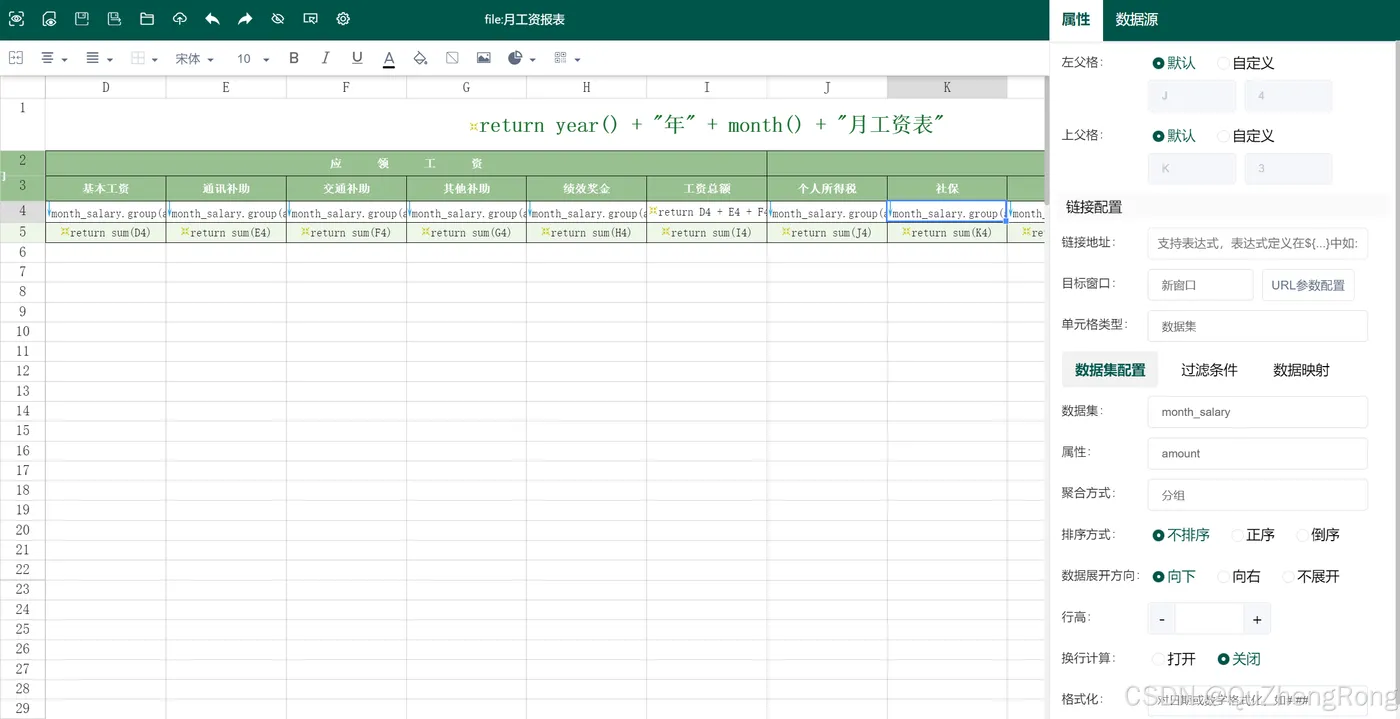
Luck-Report 是一款基于开源项目 UReport2 重构的 Java 高性能报表引擎,通过迭代单元格可以实现任意复杂的中国式报表。相较于 UReport2,Luck-Report 在技术架构上进行了全新升级,后端基于 SpringBoot 框架开发、前端采用 Vue 框架构建,技术选型贴合当下主流项目开发标准,可精准适配各类实际开发需求。
Luck-Report 提供了全新的基于网页的报表设计器,可以在 Chrome、Firefox、Edge 等各种主流浏览器运行(IE 浏览器除外)。使用 Luck-Report,打开浏览器即可完成各种复杂报表的设计制作。
Luck-Report 基于 Apache-2.0 开源协议 开源