◆ 博主名称: QuZhengRong
AI俘虏,样式苦手
目录
到了研究 Agent 记忆 系统的时候了!
其实上一篇已经提到过 Agent 记忆的雏形:Plan-and-Execute 里 Executor 每一步都带着已完成步骤的结果列表,那就是最朴素的工作记忆。但真实场景比调研任务复杂得多,当对话轮数达到几十轮时, 大模型 的上下文窗口可能会溢出,再和大模型对话,模型可能会直接抛出异常。
这一篇讲 Agent 的记忆机制:怎么管理 Agent 的短期记忆,长期记忆
一、Agent 的失忆症
以勇哥的场景为例,说明模型的两种失忆情况:
第一类:会话内忘事。 粉丝第一轮就说了预算 40 万、想开面馆。聊到十几轮之后问"你还是按我最初说的那个预算帮我算算",助手开始反问:“请问您的预算大概是多少?”。这是早期信息被挤出 上下文窗口 ,丢失了数据。
第二类:跨会话忘事。 粉丝昨天花了一小时跟助手聊清楚选址、预算、品类,今天开个新会话接着聊,助手第一句话是"你好,请问想咨询什么?"。它不记得昨天的对话
对于模型来说,记忆只有上下文窗口这一块,当前的窗口就是它的全部世界,要让模型记住东西,就得往上下文窗口里追加数据。
那是不是可以把聊天记录全存起来,对话的时候再全塞进去呢?在对话轮数少的情况下是可以这么做的,但如果对话内容过多,超出了模型上下文,那就得考虑压缩消息了。
所以记忆机制要解决的不是存多少的问题,而是存什么的问题。常见的记忆有以下两种:
| 类型 | 存储位置 | 存活时间 | 作用 |
|---|---|---|---|
| 短期记忆 | 上下文窗口(messages 列表) | 当前会话 | 记住当前对话的来龙去脉 |
| 长期记忆 | 外部存储(数据库/文件) | 跨会话 | 记住用户的情况和偏好 |
二、短期记忆
短期记忆的本质,就是每次发给模型的 messages 列表:System Prompt + 对话历史 + 工具调用 记录。所谓短期记忆管理,就是管这个列表里什么进、什么出、什么被压缩。
短期记忆管理的三板斧:
1、滑动窗口:只保留最近 N 轮对话,超出的直接丢。最简单,但丢得最狠。
2、摘要压缩:丢之前先让模型把早期对话压成一段摘要,关键信息以摘要形式存活。
3、选择性保留:核心约束(预算、品类)和工具的关键结果单独存结构化数据,不走有损的压缩通道。
实战中前面两个经常一起用:窗口内的保留原文,窗口外的压成摘要。代码演示这套组合,沿用前面几篇的 .env 配置:
# 短期记忆:滑动窗口 + 摘要压缩,演示聊了十几轮后,第一轮说的预算还在
# 主题:勇哥说餐饮——粉丝咨询开店,早期聊定的预算和品类,到后期还能被想起
from dotenv import load_dotenv
import os
from langchain_openai import ChatOpenAI
from langchain_core.messages import SystemMessage, HumanMessage, AIMessage

load_dotenv()

llm = ChatOpenAI(
    model="qwen3.7-max-2026-06-08",
    api_key=os.getenv("API_KEY"),
    base_url=os.getenv("BASE_URL")
)

SYSTEM_PROMPT = """你是抖音"勇哥餐饮创业说"的勇哥,说话直接、不留情面。
粉丝咨询开店问题,按你的方法论给建议:
房租别超营业额 15%、人工别超 20%、食材别超 30%,超标就是给房东和员工打工。"""

# 1. 模拟一段已经聊了 10 轮的咨询(真实场景里这些消息是一轮轮攒出来的)
history = [
    ("粉丝", "勇哥你好,我准备开店,预算总共 40 万,帮我参谋参谋"),
    ("勇哥", "40 万在深圳开小店够呛但能做,一分不能乱花。你想做什么品类?"),
    ("粉丝", "想做面馆,家里传下来的手擀面手艺"),
    ("勇哥", "面馆品类不踩坑,但手擀面人工重,人工成本得先想好怎么压"),
    ("粉丝", "我看中南山区一个 100 平米的铺子"),
    ("勇哥", "南山租金不便宜,100 平米月租奔 3 万,营业额得做到 20 万往上才扛得住"),
    ("粉丝", "那我把面积砍到 60 平米呢"),
    ("勇哥", "砍面积是对的,房租压力小一半,先活下来再谈扩张"),
    ("粉丝", "装修我想搞点网红风格,多花点钱"),
    ("勇哥", "装修别超总预算两成,网红风半年就过气,钱要花在后厨设备上"),
]

# 2. 滑动窗口:只保留最近 4 条消息(2 轮对话),其余的等待压缩
KEEP_RECENT = 4

def compress_messages(dropped: list, old_summary: str) -> str:
    """把被挤出窗口的早期消息压缩成摘要,并与旧摘要合并。

    Args:
        dropped: 被滑动窗口挤出的早期消息列表
        old_summary: 之前已有的摘要,压缩时一并带上防止信息断层

    Returns:
        合并后的新摘要文本
    """
    # 拼成"角色: 内容"的对话稿喂给模型压缩
    transcript = "\n".join(
        f"{'粉丝' if isinstance(m, HumanMessage) else '勇哥'}: {m.content}" for m in dropped
    )
    prompt = f"""把下面这段餐饮开店咨询对话压缩成不超过 150 字的要点摘要。
要求:预算、面积、品类、城市、已经聊定的决策必须保留;寒暄和客套全部丢掉。

已有摘要(把新内容合并进去,仍不超过 150 字):
{old_summary or "(无)"}

对话内容:
{transcript}"""
    return llm.invoke(prompt).content

def trim_memory(messages: list, summary: str) -> tuple:
    """整理短期记忆:超窗的早期消息压缩进摘要,返回裁剪后的消息列表和新摘要。

    Args:
        messages: 当前完整消息列表(第一条必须是 System Prompt)
        summary: 当前已有的事件摘要

    Returns:
        (裁剪后的消息列表, 更新后的摘要)
    """
    # System Prompt 永远保留,参与裁剪的只有对话部分
    system_msg = messages[0]
    chat = messages[1:]

    # 对话条数没超窗口,不用动
    if len(chat) <= KEEP_RECENT:
        return messages, summary

    # 窗口外的压进摘要,窗口内的保留原文
    dropped, kept = chat[:-KEEP_RECENT], chat[-KEEP_RECENT:]
    new_summary = compress_messages(dropped, summary)

    # 摘要作为一条 SystemMessage 续在后面,保证模型每一轮都看得见
    summary_msg = SystemMessage(content=f"【之前对话的摘要】{new_summary}")
    return [system_msg, summary_msg] + kept, new_summary

# 3. 组装消息并整理一次记忆,看窗口外的 6 条消息去哪了
messages = [SystemMessage(content=SYSTEM_PROMPT)]
for who, text in history:
    messages.append(HumanMessage(content=text) if who == "粉丝" else AIMessage(content=text))

messages, summary = trim_memory(messages, "")
print(f"=== 压缩后的摘要 ===\n{summary}\n")
print(f"=== 实际发给模型的消息(共 {len(messages)} 条)===")
for m in messages:
    content = m.content if len(m.content) <= 40 else m.content[:40] + "……"
    print(f"[{type(m).__name__}] {content}")

# 4. 第 11 轮提问:预算只在被压缩掉的早期对话里出现过
messages.append(HumanMessage(content="勇哥,你还是按我最开始说的那个预算,帮我算算 60 平米的店这钱怎么分配"))
response = llm.invoke(messages)
print(f"\n=== 第 11 轮回答 ===\n{response.content}")
运行输出:
=== 压缩后的摘要 ===
粉丝预算 40 万在深圳开店,已定品类为面馆(家传手擀面)。原看中南山区 100 平米铺子,因租金压力决定砍到 60 平米。装修预算控制在总预算两成内,重点花钱在后厨设备。

=== 实际发给模型的消息(共 6 条)===
[SystemMessage] 你是抖音"勇哥餐饮创业说"的勇哥,说话直接、不留情面……
[SystemMessage] 【之前对话的摘要】粉丝预算 40 万在深圳开店,已定品类为面馆……
[HumanMessage] 装修我想搞点网红风格,多花点钱
[AIMessage] 装修别超总预算两成,网红风半年就过气……
[HumanMessage] 勇哥,你还是按我最开始说的那个预算,帮我算算 60 平米的店这钱怎么分配

=== 第 11 轮回答 ===
40 万这么分:铺面押金转让加首期房租留 12 万,装修 8 万封顶(别超两成),后厨设备 10 万必须到位,首批物料 3 万,剩下 7 万是活命钱,撑过前三个月爬坡期……
第一轮说的"40 万",原始消息早就不在列表里了,但通过摘要活了下来,第 11 轮照样能引用。
注意点:
1、不要压缩 System Prompt。它是行为准则,丢了人设就崩了,裁剪只动对话部分。
2、摘要要合并,不要覆盖。每次压缩都把旧摘要带上一起合并,否则多轮压缩后早期信息会一层层蒸发。
3、关键信息别赌摘要质量。摘要终究是有损压缩,预算、品类这种核心约束,写入时就单独存一份结构化数据更稳——这正是下一节长期记忆要干的事。
三、长期记忆:写入过筛、按需召回、用完更新
短期记忆只是会话级的,只在会话内生效。跨会话记住用户的情况,要靠长期记忆:把值得记的事实存到外部,新会话开始时取出来拼回上下文。
长期记忆的存储看重筛选。下面有两条粉丝发言:
- “我最近在研究奶茶加盟,感觉挺火的”——临时起意,下周可能就变了
- “我在深圳南山开了家 60 平米的面馆,上个月刚开业”——稳定事实,以后每次咨询都用得上
第一条记下来就是噪音,第二条才值得进长期记忆。可以订制下面三条写入规矩:
1、粉丝明确说过的才算。模型推测出来的"粉丝可能预算有限"不算数。
2、半年后还有用的才算。预算、城市、品类、经营现状算;今天心情好不好不算。
3、隐私敏感的不记。手机号、身份证、银行卡这类信息一律不进记忆库。
长期记忆的三件套:写入、存储、召回。用 JSON 文件做一个最小实现:
# 长期记忆三件套:写入过筛 -> 结构化存储 -> 按需召回,演示跨会话记住粉丝情况
# 主题:勇哥说餐饮——粉丝第一次咨询完,第二次来不用重新自我介绍
from dotenv import load_dotenv
import os
import json
from datetime import date
from langchain_openai import ChatOpenAI
from langchain_core.messages import SystemMessage, HumanMessage, AIMessage
from pydantic import BaseModel, Field

load_dotenv()

llm = ChatOpenAI(
    model="qwen3.7-max-2026-06-08",
    api_key=os.getenv("API_KEY"),
    base_url=os.getenv("BASE_URL")
)

SYSTEM_PROMPT = """你是抖音"勇哥餐饮创业说"的勇哥,说话直接、不留情面。
粉丝咨询开店问题,按你的方法论给建议:
房租别超营业额 15%、人工别超 20%、食材别超 30%,超标就是给房东和员工打工。"""

# 记忆文件落在脚本同目录,从任何位置运行都不会丢
MEMORY_FILE = os.path.join(os.path.dirname(os.path.abspath(__file__)), "fan_memory.json")

# 1. 记忆条目结构:一条记忆 = 类型 + 一句话事实 + 记录日期
# kind 用来做覆盖式更新:粉丝改口了,同类型新事实直接替换旧事实,不无限堆积
# 注意:noted_at 由程序写入,不劳烦模型填,模型只负责提取事实本身
class MemoryNote(BaseModel):
    kind: str = Field(description="记忆类型,从这几个里选:开店计划/经营现状/咨询结论")
    content: str = Field(description="一句话事实,必须是粉丝明确说过的")

class MemoryNotes(BaseModel):
    notes: list[MemoryNote] = Field(description="提取出的记忆条目列表,没有值得记的就返回空列表")

# 2. 写入过筛:三条规矩写进提示词,让模型当守门员
EXTRACT_PROMPT = """从下面这段咨询对话里,提取值得长期记住的事实,守三条规矩:
1. 粉丝明确说过的才算,你推测的不算
2. 半年以后还有用的才算(开店计划、预算、城市、品类、经营现状),临时闲聊不算
3. 手机号、身份证这类隐私信息一律不记
没有值得记的就返回空列表。"""

def extract_memories(conversation: list) -> list[MemoryNote]:
    """从一段对话中过筛提取值得长期记住的事实。

    Args:
        conversation: 消息列表(HumanMessage / AIMessage)

    Returns:
        提取出的 MemoryNote 条目列表,可能为空
    """
    transcript = "\n".join(
        f"{'粉丝' if isinstance(m, HumanMessage) else '勇哥'}: {m.content}" for m in conversation
    )
    # 结构化输出保证提取结果是程序能直接落库的数据,而不是一段自由文本
    return llm.with_structured_output(MemoryNotes).invoke(
        f"{EXTRACT_PROMPT}\n\n对话内容:\n{transcript}"
    ).notes

def save_memories(new_notes: list[MemoryNote]) -> None:
    """把新记忆写入 JSON 文件,同类型的新事实覆盖旧事实。

    Args:
        new_notes: 本轮提取出的 MemoryNote 条目列表
    """
    # 文件不存在时初始化为空列表
    if not os.path.exists(MEMORY_FILE):
        with open(MEMORY_FILE, "w", encoding="utf-8") as f:
            json.dump([], f, ensure_ascii=False)

    with open(MEMORY_FILE, "r", encoding="utf-8") as f:
        stored = json.load(f)

    # 覆盖式更新:比如粉丝预算变了,同 kind 旧条目直接替换,防止新旧打架
    for note in new_notes:
        record = {
   "kind": note.kind, "content": note.content, "noted_at": date.today().isoformat()}
        stored = [m for m in stored if m["kind"] != note.kind] + [record]

    with open(MEMORY_FILE, "w", encoding="utf-8") as f:
        json.dump(stored, f, ensure_ascii=False, indent=2)

def recall_memories() -> str:
    """读取全部记忆条目,拼成一段文字供拼进 System Prompt。

    Returns:
        拼好的记忆文本,没有记忆时返回空字符串
    """
    if not os.path.exists(MEMORY_FILE):
        return ""
    with open(MEMORY_FILE, "r", encoding="utf-8") as f:
        stored = json.load(f)
    if not stored:
        return ""
    lines = [f"- {m['kind']}:{m['content']}(记录于 {m['noted_at']})" for m in stored]
    return "这位粉丝的已知情况:\n" + "\n".join(lines)

# 3. 会话一:第一次咨询(模拟 4 条消息的对话,结束后提取记忆入库)
chat_one = [
    HumanMessage(content="勇哥,我在深圳南山开了家 60 平米的面馆,上个月刚开业,现在每天流水四千左右"),
    AIMessage(content="刚开业日流水四千不算差,但要盯住三个占比:房租、人工、食材,别超 15%、20%、30%"),
    HumanMessage(content="记下了。我下一步想加外卖,你觉得呢"),
    AIMessage(content="可以加,但外卖平台抽成两成起步,先把堂食单量稳住再谈"),
]
notes = extract_memories(chat_one)
print("=== 会话一提取的记忆 ===")
for n in notes:
    print(f"- {n.kind}:{n.content}")
save_memories(notes)

# 4. 会话二:新开会话,先召回记忆拼进 System Prompt,粉丝不用重新自我介绍
memory_text = recall_memories()
print(f"\n=== 会话二的 System Prompt 末尾 ===\n{memory_text}")

messages = [
    SystemMessage(content=SYSTEM_PROMPT + "\n\n" + memory_text),
    HumanMessage(content="勇哥我又来了,上次说的外卖的事,帮我细说说怎么起步"),
]
response = llm.invoke(messages)
print(f"\n=== 会话二回答 ===\n{response.content}")
运行输出:
=== 会话一提取的记忆 ===
- 经营现状:粉丝在深圳南山经营 60 平米面馆,上个月开业,日流水约四千
- 咨询结论:已建议加外卖前先稳住堂食单量,注意外卖平台抽成两成起步

=== 会话二的 System Prompt 末尾 ===
这位粉丝的已知情况:
- 经营现状:粉丝在深圳南山经营 60 平米面馆,上个月开业,日流水约四千(记录于 2026-08-24)
- 咨询结论:已建议加外卖前先稳住堂食单量,注意外卖平台抽成两成起步(记录于 2026-08-24)

=== 会话二回答 ===
你那 60 平米的店刚开业一个月,日流水四千的底子,外卖别急着全量上。先算账:平台抽成两成起步,加上打包盒和满减,一单的利润比堂食薄不少……
会话二里粉丝一个字都没介绍自己,但回答里"60 平米"、"日流水四千"都对上了,这些信息来自 JSON 文件,不是来自模型。这就是长期记忆:记忆存储在外部,每次对话按需注入,模型只负责使用。
注意点:
1、提取必须用结构化输出。MemoryNotes 约束了字段和取值,提取结果是程序能直接落库的数据;让模型自由发挥写一段话,存进去就是没法维护的文本。
2、同类型覆盖,不做无限追加。粉丝预算从 40 万改成 50 万,覆盖同 kind 的旧条目。只进不出的记忆库最后会变成新旧打架的垃圾堆——记忆系统要有更新和淘汰,它不是只进不出的仓库。
3、召回方式随规模升级。几十条记忆全量读出来拼进 Prompt 完全够用;上千条之后就得换成 向量检索 ——把记忆条目向量化,按当前问题检索最相关的几条。技术还是 RAG 那一篇讲的那套,只是库里放的从文档分块换成了记忆条目。
四、总结
- 短期记忆就是 messages 列表,管理三板斧:滑动窗口丢远、摘要压缩保关键、核心信息单独结构化保留。
- 长期记忆是过筛后的事实库:写入守规矩(明确说过、长期有用、不碰隐私),存储结构化,按需召回拼回上下文,同类型覆盖更新。
到这里,Agent 的能力扩展讲完了,但还有最后一道坎——Demo 跑得再顺,生产环境里它照样会死循环、会调错工具、会越权执行。下一篇讲 Agent 工程化与兜底。
五、LuckReport 项目推荐
导航:LuckReport专栏
1、项目简介
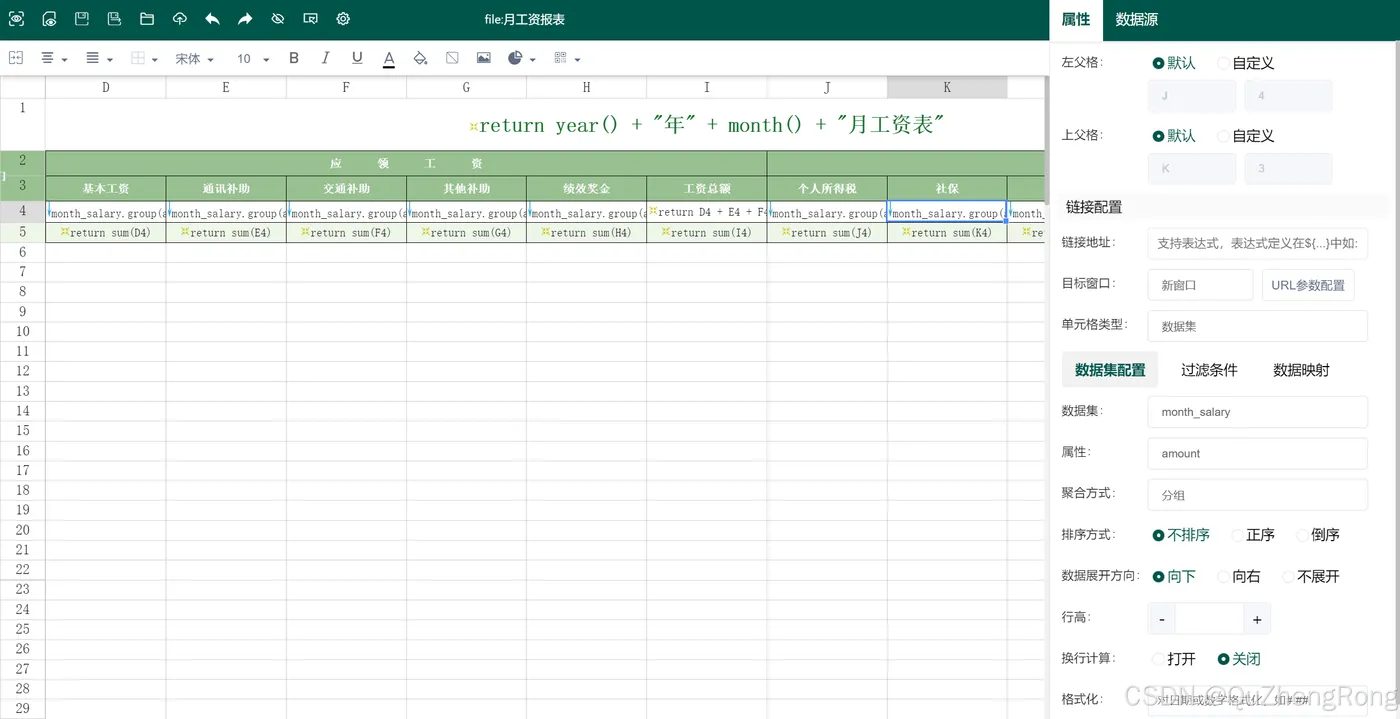
Luck-Report 是一款基于开源项目 UReport2 重构的 Java 高性能报表引擎,通过迭代单元格可以实现任意复杂的中国式报表。相较于 UReport2,在技术架构上进行了全新升级,后端基于 SpringBoot 框架开发、前端采用 Vue 框架构建,技术选型贴合当下主流项目开发标准,可精准适配各类实际开发需求。
Luck-Report 提供了全新的基于网页的报表设计器,可以在 Chrome、Firefox、Edge 等各种主流 浏览器 运行(IE 浏览器除外)。使用 Luck-Report,打开浏览器即可完成各种复杂报表的设计制作。
Luck-Report 基于 Apache-2.0 开源协议 开源