本文面向技术负责人、平台架构师与 AI 基础设施工程师。价格与比例为示意估算,不对应任何具体模型或厂商;接口细节以各模型官方文档为准。
两年前,企业讨论的是"选哪个大模型";今天,几乎没有企业只用一个模型。通用对话用一家,代码补全用另一家,敏感数据走本地开源模型,海外业务再接一家海外模型。多模型共存已经不是过渡状态,而是常态。大模型网关的体系化,正是对这个常态的回应:当模型变成一种可替换、可组合的资源,就需要一层专门的基础设施来调度它。
一、大模型网关为什么出现:多模型共存的四个原因
大模型网关是位于 AI 应用与多个模型服务之间的统一调度层,负责屏蔽模型接口差异,并以 Token 为单位完成路由、计量、限流与回退。
企业走向多模型,通常是下面四个原因叠加的结果:
能力分化
不同模型在推理、代码、长文本、多语言、多模态上的表现各有长短,没有一个模型在所有任务上都占优。
成本分层
同一任务在大模型和小模型上的单价可能相差一个数量级以上(示意估算),把简单任务交给小模型是直接有效的降本手段。
数据边界
机密数据只能交给本地部署的模型,公开数据可以使用公有云模型,同一个应用里往往两种都有。
供应风险
单一模型的限流、故障、下线或价格调整,都会直接影响业务连续性,多模型是一种冗余设计。
二、大模型网关的三代演进
第一代:统一接口层
把各家模型封装成统一的接口(多数以 OpenAI 兼容格式为事实标准),应用只需对接一次。核心价值是"可替换"。
第二代:调度与治理层
在统一接口之上,增加按 Token 的限流与计费、成本与延迟感知的路由、语义缓存、故障回退和内容护栏。核心价值是"可运营"。
第三代:Agent 入口层
管理对象从"模型调用"扩展到"工具调用"和"Agent 任务":对接 MCP 等工具协议,对工具权限做治理,对一个多步任务的整体 Token 与时长做预算。核心价值是"可治理"。这一代仍在演进中,不同产品的完成度差异较大。
三、大模型网关的五个工程难题
"统一接口"听起来简单,真正做起来,难点集中在模型之间那些不兼容的细节上。下面五个问题,是评估一个大模型网关工程深度的好切入点。
难题一:工具调用格式不一致
各家模型对函数调用(tool calling)的请求结构、参数 schema 的支持程度、并行调用、返回格式都有差异。网关要在统一格式和各家原生格式之间做双向转换,还要处理"某个模型不支持并行调用"这类能力缺口。一旦转换不完整,Agent 会在某个模型上出现难以复现的失败。
难题二:Token 计量不统一
不同模型使用不同的分词器,同一段中文在不同模型上的 Token 数可能有明显差异。这意味着:按 Token 设定的配额,在切换模型后实际可用的文本量会变化;网关在请求前做的 Token 预估,也需要按目标模型分别计算。可靠的做法是以模型返回的 usage 为结算依据,请求前的预估只用于限流预占。
难题三:计价维度变复杂
模型计价早已不是一个单价:输入、输出分开计价,缓存命中的输入有折扣,部分模型对长上下文分段计价,推理类模型还有思考 Token。网关的计费模型要能表达这些维度,否则成本报表与实际账单会对不上。
text
单次成本(示意)= 未命中输入 × 输入单价
+ 缓存命中输入 × 缓存单价
+ 输出(含推理 Token)× 输出单价
难题四:回退不是简单的"换一个模型"
故障回退时,备用模型的上下文长度可能更短、可能不支持当前请求用到的工具调用或结构化输出、提示词在另一个模型上的效果也可能不同。所以回退链需要按能力分组,网关在回退前要检查兼容性:上下文是否超长、所需能力是否具备,不满足就继续向下找或直接报错,而不是发出一个注定失败的请求。
难题五:上游限流的级联
模型服务按每分钟请求数和每分钟 Token 数限流,超限返回 429。网关如果只是简单重试,会在高峰期放大上游压力。合理的做法是:在网关侧按上游配额做令牌桶预占,遵守上游返回的重试等待时间,把超出部分排队或导向其他端点,并且只在首个 Token 返回之前重试。
四、大模型网关在 AI 基础设施栈中的位置
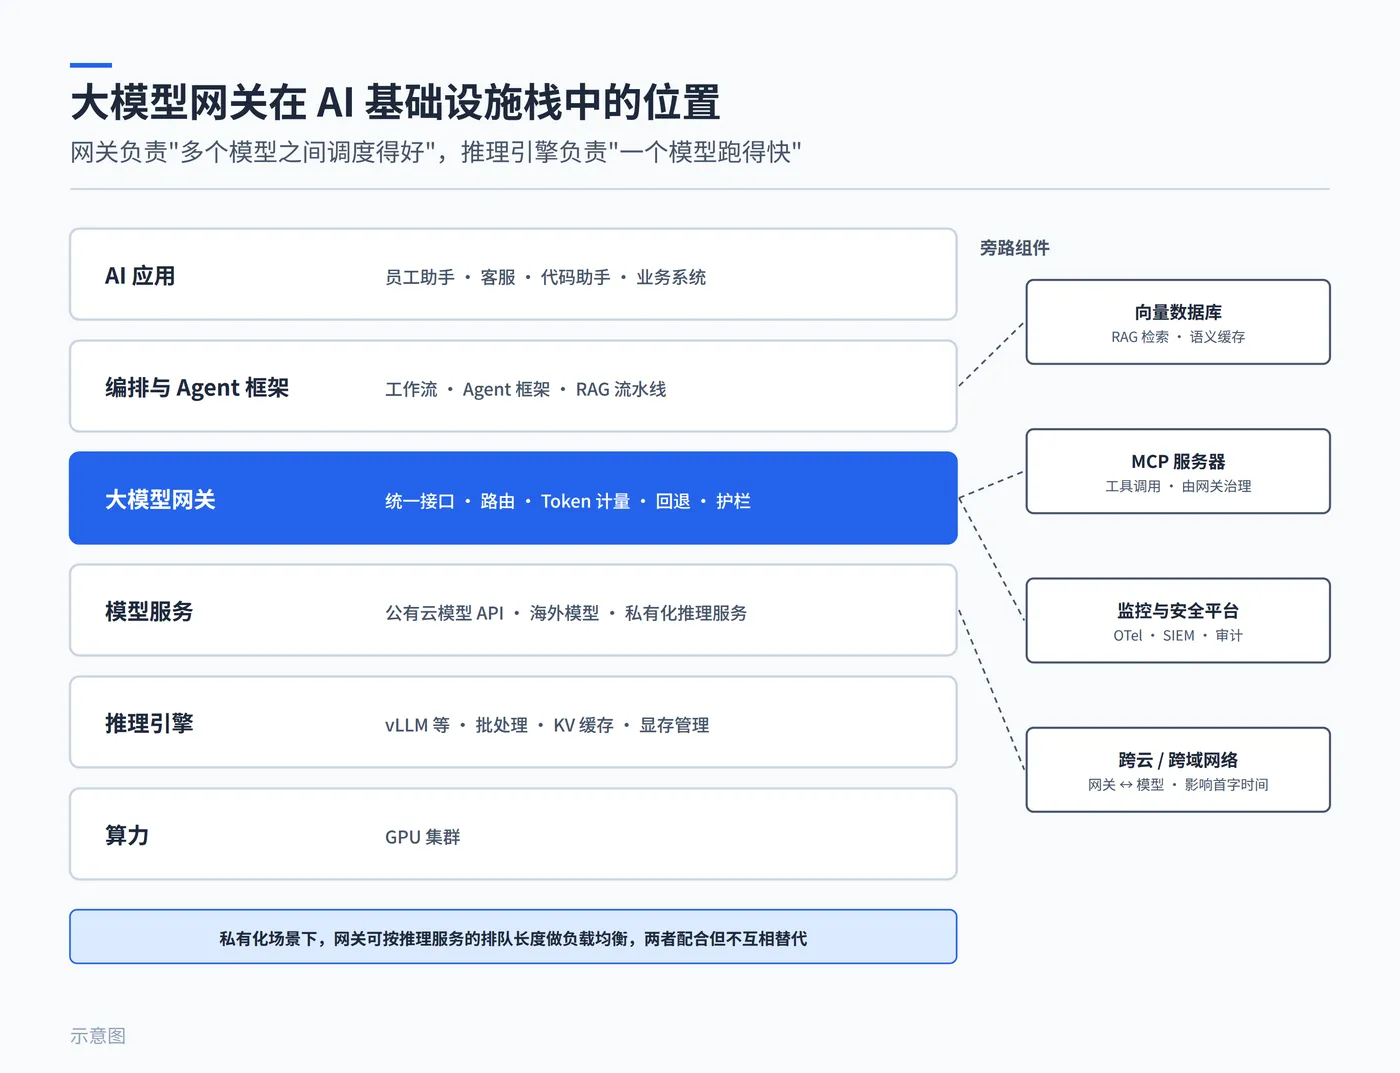
大模型网关在 AI 基础设施栈中的位置
把企业 AI 基础设施自上而下分层,大模型网关处在"应用与编排"和"模型服务"之间:
层次 |
典型组件 |
与网关的关系 |
AI 应用 |
员工助手、客服、代码助手 |
网关的调用方 |
编排与 Agent 框架 |
工作流引擎、Agent 框架、RAG 流水线 |
通过网关调用模型与工具 |
大模型网关 |
统一接口、路由、计量、护栏 |
本文主角 |
模型服务 |
公有云模型 API、私有化推理服务 |
网关的上游 |
推理引擎 |
vLLM 等推理框架 |
私有化模型的运行时 |
算力 |
GPU 集群 |
— |
旁路组件 |
向量数据库、MCP 服务器、监控平台 |
网关对接或治理 |
一个常见的误区是把网关和推理引擎的职责混淆:推理引擎负责"把一个模型跑得快"(批处理、显存管理、KV 缓存),网关负责"在多个模型之间调度得好"。两者在私有化场景下会紧密配合,例如网关按推理服务的排队长度做负载均衡,但不应互相替代。
另一个容易被低估的是网络层:当模型分布在多个公有云、私有机房和海外区域时,网关到模型之间的链路质量会直接体现在首字时间上。跨地域、跨云调用较多的企业,会把网关数据面部署在靠近模型或靠近用户的位置,并为关键链路配置专线或优化的骨干网络,例如通过犀思云这类云网服务商的多云互联网络连接各地模型服务。
五、大模型网关选型逻辑:一棵决策树
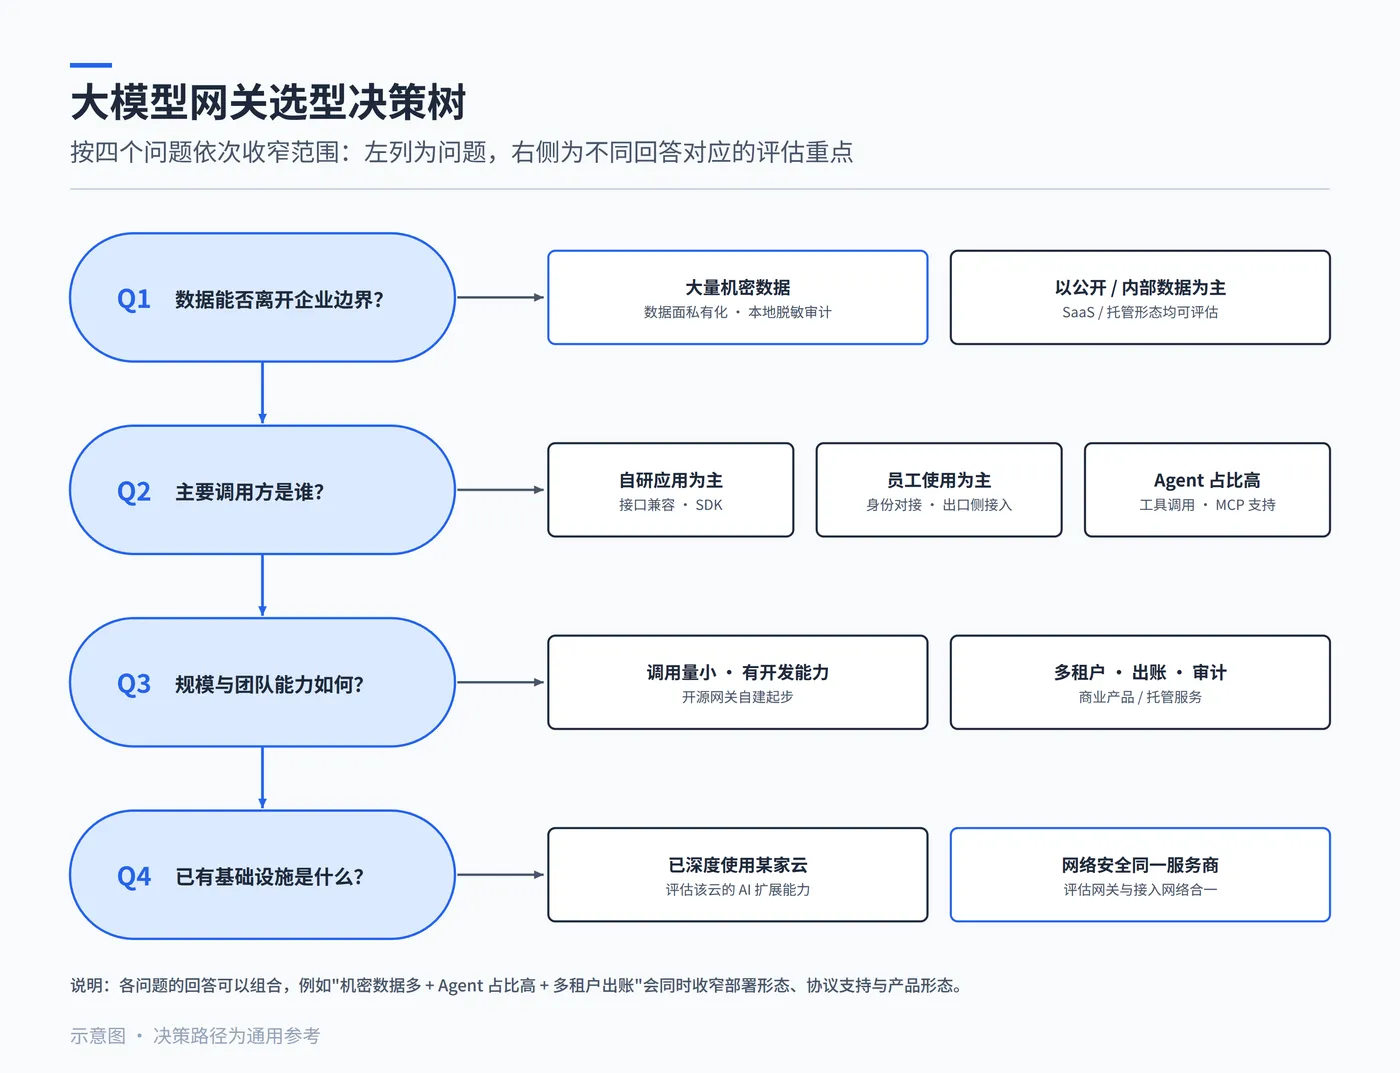
大模型网关选型决策树
选型时,与其逐项对比功能清单,不如按下面几个问题依次收窄范围:
问题一:数据能否离开企业边界?
如果有大量机密数据,网关的数据面需要私有化,至少脱敏与审计要在本地完成,这一条会直接排除只提供 SaaS 形态的方案。
问题二:调用方是谁?
以自研应用为主,看接口兼容性和 SDK;以员工使用为主,看身份对接与出口侧接入能力;Agent 占比高,看工具调用和 MCP 支持。
问题三:规模与团队能力如何?
调用量小、团队有开发能力,开源网关自建是性价比较高的起点;规模大、多租户、需要出账和审计,商业产品或托管服务的总成本往往更低。
问题四:已有基础设施是什么?
已经深度使用某家云的 API 网关或安全产品,优先评估其 AI 扩展能力;网络与安全由同一服务商承载的,评估网关与接入网络合一的形态。
六、大模型网关的未来走向
几个已经可以看到的趋势:接口标准化,统一接口格式与 OpenTelemetry 生成式 AI 语义规范让网关之间的迁移成本下降;与安全融合,大模型网关与 AI 安全网关的边界在模糊,安全厂商通过收购或自研进入网关领域;向 Agent 扩展,工具调用治理会成为网关的标配能力;向网络边缘下沉,部分数据面能力会随企业接入网关部署到分支与边缘节点。
附:数据来源与参考资料
- vLLM 推理框架(来源:vLLM 项目官方文档)
- OpenAI 兼容接口格式(来源:各模型厂商官方文档)
- 多云互联与骨干网络(来源:犀思云官网产品资料)
说明:文中配置与代码为教学示意;时延、比例与容量为量级示意或示例估算,以实测为准;协议与法规以官方原文为准。