前一篇讨论的是 AI 生成需求文档以后如何审核,重点解决“哪些内容可以进入正式需求基线”。当需求已经经过业务确认,下一步会遇到另一个更实际的问题:几十页需求说明书,如何真正变成开发、测试和项目管理可以直接使用的任务依据。
很多项目并不缺需求文档,真正的问题是文档写得很完整,但到了开发阶段还需要重新拆任务,测试阶段又要重新理解验收范围,需求发生变化后也很难判断会影响哪些接口、页面和测试用例。
因此,需求阶段还需要完成一次转换:把“面向阅读的需求文档”,整理成“面向研发过程的结构化需求数据”。AI 在这里适合承担大量整理、拆分、关联和检查工作,但结构怎么定义、粒度拆到什么程度,仍然要服从项目自身的研发和验收方式。
一、需求说明书解决“讲清楚”,需求清单解决“怎么做”
需求说明书更适合描述背景、业务目标、整体流程和业务规则。例如一段BaseMetas 云文档系统的需求可能写成:
员工离职后,管理员应先完成其个人文件交接,再删除账号。已经进入团队空间的文件不需要转移;被删除的成员重新加入企业时按新员工处理,不恢复历史部门、团队和文档权限。
这段内容对人来说很好理解。但开发真正开始以后,还需要继续回答:
- 需要几个功能点;
- 哪些属于前端;
- 哪些属于后台任务;
- 哪些涉及权限;
- 哪些需要新增接口;
- 哪些场景需要测试;
- 哪些内容属于同一项验收。
所以需求文档还需要进一步转换成:需求说明→Requirement ID→功能需求→ 业务规则→异常场景→验收标准→影响模块→测试映射。这一步做好以后,需求才真正开始进入研发流程。
二、先给需求建立统一编号
结构化需求的第一步并不复杂,就是让每一条正式需求都有稳定编号。例如:
REQ-001  离职成员文件交接
REQ-002  文件接收人选择
REQ-003  团队空间资源不迁移
REQ-004  交接失败资源重试
REQ-005  重新入职按新成员处理
Requirement ID 的价值并不只是方便编号。后续很多项目对象都可以围绕它建立关联:
REQ-001
  ├─ 原始需求说明
  ├─ 页面原型
  ├─ API
  ├─ 数据库变更
  ├─ 开发任务
  ├─ 测试用例
  ├─ 缺陷
  └─ 验收结果
以后需求变更时,不再只是问:“这个需求改了会不会有影响”?而是可以快速定位:REQ-001 关联了哪些设计、代码和测试资产。这也是结构化需求最直接的价值。
三、一条需求不要同时包含太多事情
需求说明书经常为了阅读顺畅,把多个规则写在一个段落中。例如:
管理员可以选择离职成员及接收人,系统扫描其个人资源并进行交接;团队空间中的文件不需要迁移,交接失败后允许重试,完成后才允许删除账号。
对阅读没有问题,但作为研发需求粒度过大。更适合拆成:
| 编号 | 需求 |
|---|---|
| REQ-001 | 管理员可以发起离职文件交接 |
| REQ-002 | 系统可以扫描待交接个人资源 |
| REQ-003 | 管理员可以指定文件接收人 |
| REQ-004 | 团队空间资源不参与交接 |
| REQ-005 | 交接失败资源支持重新处理 |
| REQ-006 | 全部交接完成后才能删除账号 |
每一条需求尽量只表达一个主要行为或规则。这样做以后,开发人员更容易估算,测试人员也更容易建立覆盖关系。
四、把“功能”和“规则”分开
这是很多需求文档容易混在一起的地方。例如:
“管理员选择接收人后执行文件交接,接收人必须是企业内正常状态成员。”
这里其实包含两类信息:
功能:
管理员可以选择文件接收人并执行交接。
业务规则:
接收人必须属于当前企业,并且账号状态正常。
进一步还可能存在:
RULE-001 接收人不能是离职成员本人
RULE-002 接收人必须属于同一租户
RULE-003 禁用账号不能作为接收人
RULE-004 团队空间资源不改变 Owner
把功能和业务规则拆开以后,项目会清晰很多。因为功能一般回答:系统要做什么?而规则回答:在什么条件下允许这样做?
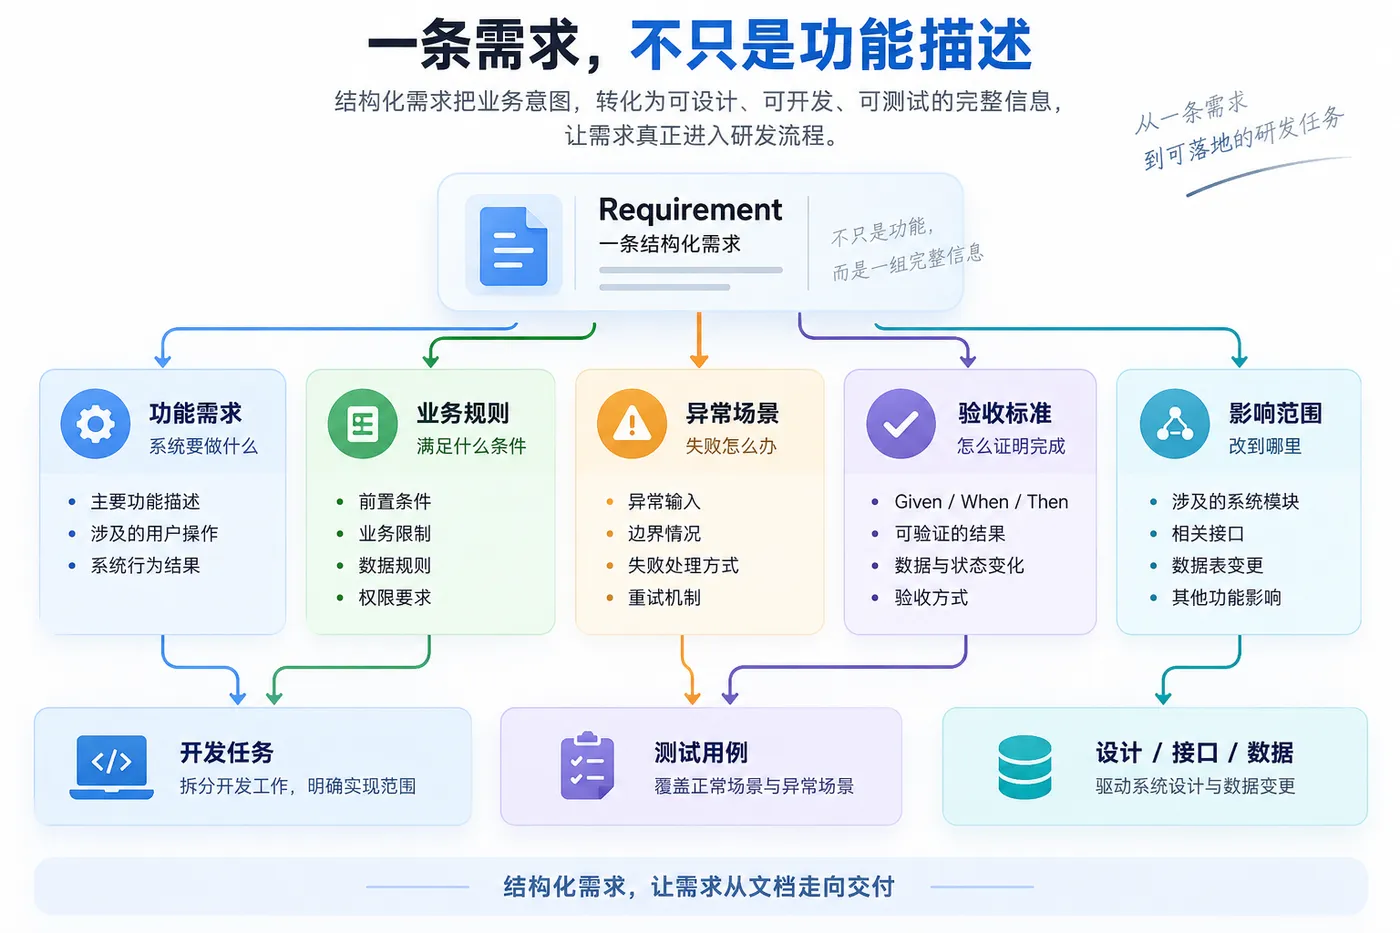
一条需求并不只是功能描述,而是一组可以继续驱动设计、开发和测试的信息。
五、把异常场景单独列出来
正常流程很容易写,真正容易造成返工的是异常情况。比如文件交接流程:管理员选择离职成员 →选择接收人→执行文件交接→完成。如果只写到这里,开发阶段很快就会继续问:
- 接收人已被禁用怎么办;
- 文件迁移部分成功怎么办;
- 文件正在被其他任务锁定怎么办;
- 一次交接十万份文件要不要异步;
- 失败后是否可以重复执行;
- 重试会不会重复迁移已经成功的资源。
这些内容最好不要继续塞在正文段落里,而是单独形成异常场景表:
| 编号 | 场景 | 处理方式 |
|---|---|---|
| EX-001 | 接收人账号已禁用 | 不允许提交 |
| EX-002 | 部分文件迁移失败 | 记录失败资源 |
| EX-003 | 任务执行中断 | 支持继续或重新执行 |
| EX-004 | 重复发起交接 | 已完成资源不重复迁移 |
这样开发和测试都可以直接使用。
六、验收标准不要等到测试阶段再补
很多项目的验收标准是在开发完成以后,由测试人员根据需求“猜”出来的。更合适的方式是,在需求结构化阶段就同步形成。
例如:
REQ-004:团队空间资源不参与离职交接
可以写成:
Given
成员 A 拥有 100 个文件,
其中 20 个已经进入团队空间

When
管理员将 A 的个人文件交接给成员 B

Then
80 个个人空间文件 Owner 变更为 B
20 个团队空间文件 Owner 保持不变
这样一条需求同时具备:功能描述+业务规则+输入条件+预期结果。开发和测试对“完成”的理解会更加一致。AI 在这里很适合辅助从已确认需求生成 Given / When / Then 初稿,但验收结果仍然需要 BA 和测试人员确认。
七、用 AI 从长文档生成需求清单,但不要一次拆到底
需求说明书可能有几十页甚至几百页。AI 很适合完成第一轮结构化,例如:
输入:
需求规格说明书
会议纪要
业务规则

输出:
REQ ID
需求名称
需求说明
业务规则
异常场景
验收标准
来源章节
但实际使用时不建议让 AI 一次完成:需求 → 开发 Task → 测试 Case → 数据库设计 → API。原因很简单:前面一个理解错误,会被一路传递到后面。更稳妥的过程是:需求文档→AI 提取需求清单→人工确认→AI 拆业务规则→人工确认→AI 生成验收标准→需求评审。每一步输出都先稳定下来,再进入下一层。这比一次生成完整研发方案更适合正式项目。
八、案例:把“离职文件交接”整理成需求清单
以 BaseMetas 云文档中的离职成员文件交接为例,原始需求可能只是一段描述。结构化后可以形成:
| ID | 类型 | 内容 |
|---|---|---|
| REQ-001 | 功能 | 管理员可以选择离职成员 |
| REQ-002 | 功能 | 系统扫描该成员待交接资源 |
| REQ-003 | 功能 | 管理员选择资源接收人 |
| RULE-001 | 规则 | 接收人必须为当前企业正常成员 |
| RULE-002 | 规则 | 团队空间资源不进行 Owner 转移 |
| REQ-004 | 功能 | 系统执行个人资源交接 |
| EX-001 | 异常 | 部分资源失败时记录失败清单 |
| REQ-005 | 功能 | 支持失败资源重新处理 |
| RULE-003 | 规则 | 全部交接完成前不能删除账号 |
| REQ-006 | 功能 | 完成交接后允许删除成员 |
| RULE-004 | 规则 | 重新入职时按新成员处理 |
再继续补充验收:
REQ-004
执行文件交接

关联:
RULE-001
RULE-002

异常:
EX-001

验收:
AC-004-01
AC-004-02
AC-004-03
这样需求就不再只是文档,而开始变成一套结构化关系。
九、进一步建立需求与系统模块的关系
对于复杂系统,仅有需求清单还不够。还需要知道一条需求会影响哪里。
例如:REQ-006:重新入职按新成员处理,影响可能包括:
企业成员
├─ 用户账号
├─ 部门关系
├─ 团队关系
├─ 角色
├─ 文件权限
├─ 空间成员关系
└─ 审计记录
因此可以增加 Impact 字段:
| Requirement | 影响模块 |
|---|---|
| REQ-001 | 企业成员管理 |
| REQ-002 | 文件存储、权限 |
| REQ-004 | 文件服务、任务中心 |
| REQ-006 | 成员、部门、团队、权限 |
这类关系 AI 很适合根据已有架构和代码辅助分析。但这里的 AI 输出同样属于候选影响范围,需要架构或开发负责人确认。
十、需求清单最好还能映射到测试
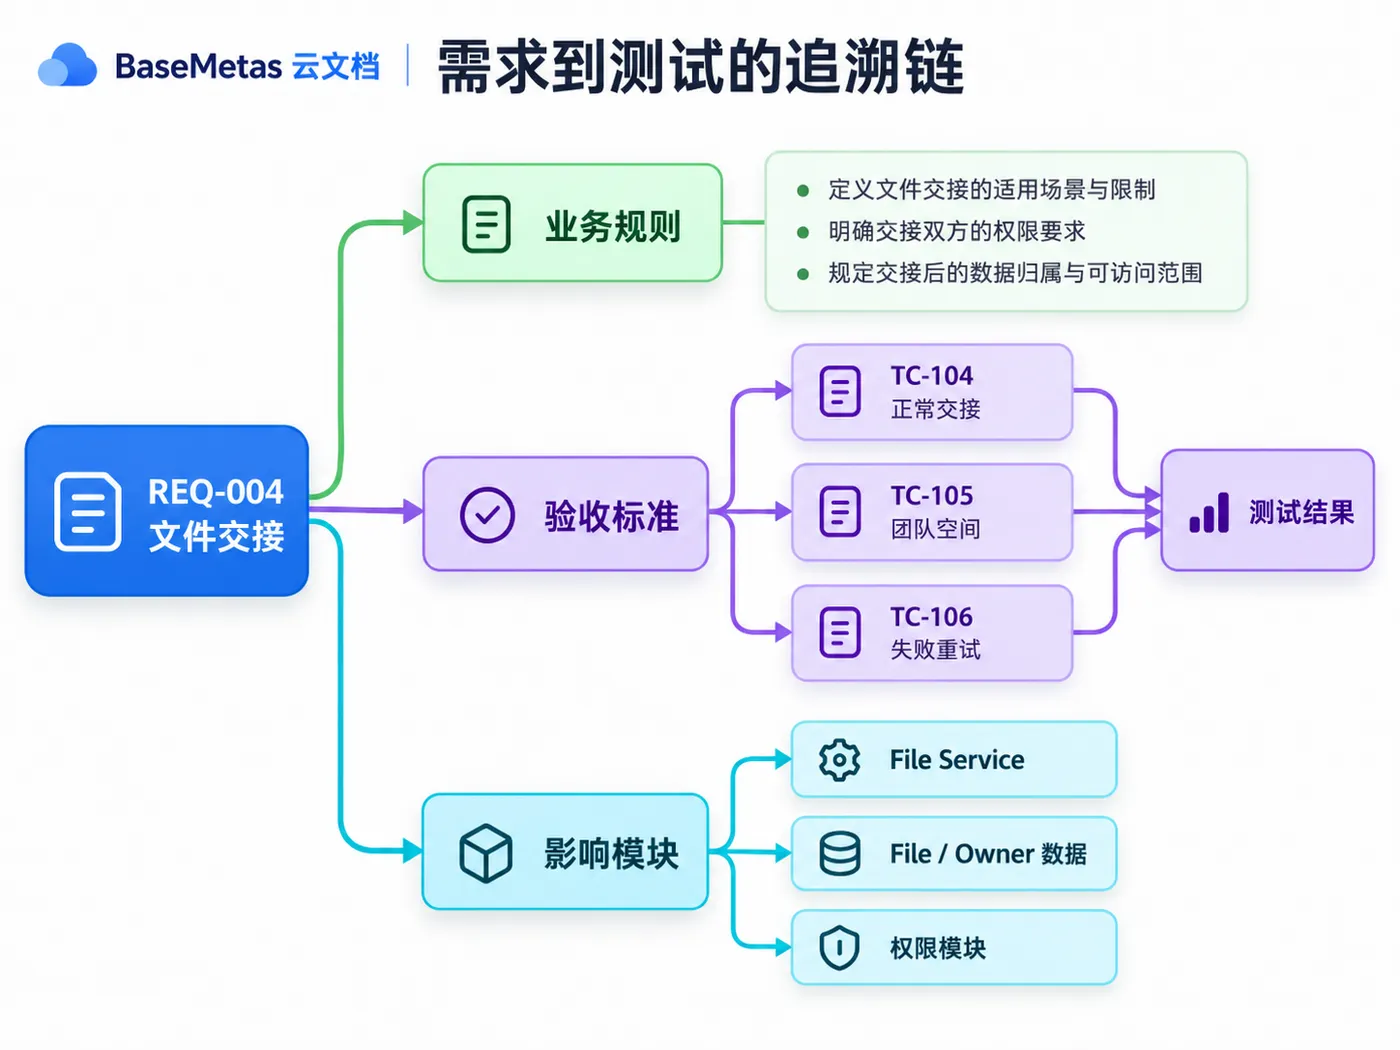
结构化程度再往前一步,就可以建立:Requirement→Acceptance Criteria→Test Case。例如:
REQ-004
文件交接
    ↓
AC-004-01
个人文件 Owner 正确变更
    ↓
TC-104
正常文件交接

AC-004-02
团队空间文件不迁移
    ↓
TC-105
团队空间资源交接验证

AC-004-03
失败资源可重试
    ↓
TC-106
部分失败重试验证
这样到了验收阶段,就能够回答一个非常重要的问题:每一条正式需求有没有测试覆盖?而不是开发完成以后再人工翻阅几百页需求文档。
十一、不要让需求清单变成另一份“大文档”
结构化需求并不是把原来的 100 页 Word 再复制成一个 500 行 Excel。真正有价值的是每一列都能够支持后续工作。例如可以控制在:
| 字段 | 作用 |
|---|---|
| ID | 唯一标识 |
| Title | 简短名称 |
| Description | 需求说明 |
| Type | 功能 / 规则 / 异常 |
| Source | 来源 |
| Priority | 优先级 |
| Status | 当前状态 |
| Acceptance Criteria | 验收标准 |
| Impact | 影响模块 |
| Owner | 责任人 |
| Version | 所属版本 |
对于复杂项目,再扩展:Related API、Related Table、Test Case、Issue、Change Request。需求数据应该根据实际管理需要逐步增加,而不是为了“结构化”增加大量没人维护的字段。
十二、需求发生变化以后,结构化的价值才真正体现出来
假设客户提出:
离职成员重新入职后,希望恢复原来的部门。
如果只有需求文档,项目经理需要人工判断影响。如果已经结构化:
RULE-004
重新入职按新成员处理
      ↓
影响
├─ Member Service
├─ Department Relation
├─ Team Relation
├─ Permission
├─ TC-180
└─ TC-181
那么变化发生后,就可以快速形成影响清单。AI 也可以进一步辅助:变更需求→查找关联 Requirement→查找影响模块→查找测试用例→生成候选影响范围→人工确认。这时候 AI 的价值已经不只是“帮忙写需求”,而开始进入真正的项目管理。
十三、需求结构化不等于把项目改造成复杂的需求管理系统
对于中小项目,没有必要因为 AI 引入一套非常重的 Requirement Management 工具。Excel、项目管理平台甚至数据库表都可以承担需求清单。关键不是工具,而是建立几个基础关系:
需求有编号
需求有状态
需求有来源
需求有验收
需求有负责人
需求可以追溯到测试
这些关系存在以后,后续 AI 才有更稳定的上下文可以使用。因为相比几十页自由文本:结构化需求更适合人管理,也更适合 AI 读取。
十四、AI 时代的需求文档可以形成“两层结构”
未来比较实用的需求管理方式,不一定是彻底抛弃需求说明书,而是形成两层。
第一层:需求说明书
用于人阅读:
项目背景
业务目标
业务流程
场景说明
整体规则
界面说明
第二层:结构化需求清单
用于研发和 AI:
Requirement ID
功能
规则
验收标准
影响模块
负责人
测试用例
状态
于是形成:
需求说明书
   ↓
帮助人理解业务

结构化需求清单
   ↓
驱动设计 / 开发 / 测试 / AI
两者并不是替代关系。而是:一个负责讲清楚业务,一个负责管理研发过程。
十五、结语:需求文档不是终点,进入研发流程才是
传统项目很容易把“需求规格说明书评审通过”看成需求阶段的结束。AI 进入以后,需求文档生成变得越来越容易,这种做法的问题也会更加明显。真正有价值的需求成果应该能够继续回答:
这是什么需求?
谁确认的?
有哪些业务规则?
异常怎么处理?
怎么验收?
影响哪些模块?
由谁开发?
有哪些测试覆盖?
所以需求阶段完成以后,不应该只留下几十页 Word。更理想的状态是同时形成:需求说明书 + 结构化需求清单 + 验收标准 + 需求追溯关系。
AI 可以帮助团队快速完成拆分、整理、关联和检查,但最终结构仍然要服务于项目的设计、开发、测试和交付。需求结构化真正解决的不是“文档格式”,而是让一条业务需求从提出开始,一直到最终验收,都能够被持续跟踪。
上一篇回顾:
https://developer.aliyun.com/article/1768880?spm=a2c6h.13148508.setting.15.63a84f0elMY5b0
下一篇:AI 时代的需求变更,为什么更容易失控?
当需求已经结构化以后,下一步会遇到需求阶段非常现实的问题:变化。AI 让原型、方案和代码生成变快以后,客户和团队提出调整的成本感知也会下降,“顺便改一下”“再增加一个小功能”会变得更加频繁。
下一篇将重点讨论:
已确认需求 → 新建议 → 范围内细化 → 范围外新增 → Change Request
以及如何避免 AI 提效最终演变成项目范围不断膨胀。