上一篇讨论了 AI 如何把访谈记录、会议纪要、聊天消息和历史资料整理成需求候选清单,从而提升需求分析效率。效率提升以后,新的问题也随之出现:AI 可以很快生成一份结构完整、措辞专业的需求文档,但文档完整并不代表需求已经被确认。
传统需求文档的问题通常比较直观,比如遗漏、描述不清或结构混乱;AI 参与以后,更常见的问题是模型会主动补齐缺失信息,把推测、经验和常见做法一起写进文档。如果这些内容没有经过区分和确认,就很容易在后续评审中逐渐被当成正式需求。
因此,AI 生成需求以后,项目团队要关注的不只是“写得是否完整”,还要继续确认:这些需求从哪里来、是否真的符合业务、有没有超出范围、是否与已有规则一致,以及最终能不能验收。
一、AI 生成需求文档容易出现哪些问题
假设客户只提出一句:“文件需要支持外链分享”。让 AI 完善以后,很容易得到一套比较完整的功能描述:支持设置访问密码;支持设置有效期;支持禁止下载;;支持匿名访问;支持访问次数限制;支持管理员统一关闭外链;支持访问日志;支持二维码分享;支持批量取消分享……。这些功能从产品设计角度看都很合理,但需求分析阶段真正需要确认的是:哪些是客户明确提出的?如果没有继续区分,最终需求文档里可能同时混入:客户明确提出的内容+需求人员根据业务推导的内容+为了完整性补充的异常场景+AI 主动建议的新功能。
文档会越来越完整,但项目范围也可能在不知不觉中扩大。因此,可以先建立一个基本原则:AI 可以帮助表达和整理需求,但不能替项目团队决定“什么才是正式需求”。
二、先确认每条需求的来源
AI 参与需求整理以后,重要需求最好都能够回答一个基本问题:这条需求从哪里来?可以为需求增加简单的来源标识:
| 来源类型 | 示例 | 处理方式 |
| 客户明确提出 | 访谈、邮件、确认记录 | 可以进入需求 |
| 现有系统规则 | 当前系统实际行为 | 需确认是否继续保留 |
| 合同 / 制度要求 | 合同、规范、法规 | 纳入需求并确认解释 |
| BA 业务推导 | 根据业务流程补充 | 需要确认 |
| 技术约束 | 架构、安全、平台限制 | 需要业务知悉 |
| AI 建议 | 模型主动补充 | 不直接进入范围 |
例如“外链支持密码访问”,如果能够追溯到客户会议记录,就是明确需求;“增加二维码分享”如果只是 AI 根据常见产品能力补充,则应该单独记录为建议项。
因此,可以形成一个很简单的处理规则:有明确来源→进入需求分析→没有明确来源→进入待确认 / AI 建议。来源清楚以后,后续的范围管理、变更管理和验收都会容易很多。
三、区分已确认规则与推测内容
AI 为了让文档更加完整,往往会主动填补上下文。例如客户明确说:“企业管理员关闭外链后,成员不能再创建新的外链”。AI 在整理时可能进一步写成:“管理员关闭外链功能后,所有历史外链立即失效”。这两条规则并不等价。
第一条只是限制新增,第二条却增加了对历史数据的处理规则。如果客户没有确认,那么后者只能算推测。审核 AI 需求时,可以重点关注一些容易引入确定性规则的词,例如:默认、必须、自动所有、立即、仅允许、禁止、永久、统一。看到这些表达时,应继续追问:这个规则是谁确认的?如果找不到依据,就应该回到澄清状态,而不是直接进入需求基线。
四、避免需求补充演变为范围扩张
AI 很适合回答:“这个功能还有哪些地方可以完善”?但在项目中,这也是最容易造成范围扩大的一类问题。比如原始需求只是:增加文件外链分享。AI 可能继续提出:二维码分享;访问统计;访问次数限制;水印;IP 白名单;分享审批;风险检测;智能推荐有效期。这些能力可能都很有价值,但有价值不等于已经进入项目范围。因此,AI 生成的新内容建议明确分成三类:
| 分类 | 含义 | 处理方式 |
| 已确认需求 | 有明确原始依据 | 进入正式需求 |
| 待确认项 | 业务闭环必须澄清 | 提交客户确认 |
| AI 建议 | 模型主动补充 | 单独进入建议池 |
这样可以避免“为了让需求更完整”,反而把项目范围不断扩大。

五、检查需求之间的一致性
一份需求文档中的每一条单独看可能都没有问题,但组合起来以后却可能互相冲突。例如:
需求 A:企业管理员可以关闭外链功能。
需求 B:文件拥有者创建的外链在有效期结束前始终有效。
那么管理员关闭外链以后,已有链接到底还能不能访问?再比如:
需求 A:成员离职后,个人文件全部转移给接收人。
需求 B:已经加入团队空间的文件不改变 Owner。
如果一个文件最初属于个人,后来又加入了团队空间,就需要进一步明确规则优先级。这类问题可以让 AI 辅助进行交叉检查,例如:规则冲突、前后描述不一致、角色权限冲突、状态转换矛盾、异常处理缺失。AI 在这里很适合作为第一轮检查工具,但最终仍然要由业务人员决定实际规则。
六、补充异常场景和边界条件
AI 生成需求时,通常最容易形成的是一条顺畅的正常流程。例如“离职成员文件交接”可以写成:管理员选择离职成员→选择接收人→执行文件交接→完成。但真正进入开发以后,项目团队会很快遇到更多问题:
- 接收人已经离职怎么办;
- 大量文件交接到一半失败怎么办;
- 文件正在被其他任务处理怎么办;
- 交接过程中能否删除账号;
- 失败后是否允许重试;
- 重复执行是否会产生重复数据;
- 用户重新入职后历史权限是否恢复。
这些问题往往决定系统最终是否真正可用。因此,可以把“异常场景补充”作为需求审核中的固定步骤:AI 负责生成候选异常场景,业务人员判断哪些需要进入正式需求。这样既能利用 AI 的覆盖能力,又不会让模型自动扩展项目范围。
七、用验收标准反向检查需求是否清楚
判断一条需求是否真正清晰,一个很有效的方法是看它能不能转成明确的验收标准。例如:“系统应安全地完成文件交接”。这句话表达了方向,但很难测试。进一步整理成:管理员完成文件交接后,原成员拥有的个人空间文件 Owner 应变更为指定接收人;团队空间资源 Owner 不发生变化;交接失败资源应记录失败状态并允许重新处理。这时候就可以继续形成 Given / When / Then:
Given:
成员 A 拥有 100 个个人文件,
其中 20 个已经进入团队空间
When:
管理员将 A 的文件交接给成员 B
Then:
80 个个人文件 Owner 变更为 B
20 个团队空间文件 Owner 保持不变
系统记录操作人、时间和资源数量
交接完成前不能删除 A

如果一条需求很难形成验收条件,通常意味着其中还有未澄清的信息。所以:验收标准可以作为需求审核的反向检查工具。
八、案例:外链分享需求如何审核
继续使用企业云文档“外链分享”需求。假设 AI 生成了下面一段内容:用户可以为文件生成公开分享链接,支持密码、有效期、下载控制、二维码、访问次数限制;企业管理员可以关闭企业外链功能,关闭后所有已有链接自动失效。可以逐条审核:
| AI 输出 | 审核结果 |
| 支持公开分享链接 | 客户明确提出,保留 |
| 支持密码 | 客户明确提出,保留 |
| 支持有效期 | 客户明确提出,保留 |
| 支持禁止下载 | 客户明确提出,保留 |
| 支持二维码 | 无来源,标记 AI 建议 |
| 支持访问次数限制 | 无来源,标记 AI 建议 |
| 管理员可以关闭外链 | 客户明确提出,保留 |
| 关闭后历史链接失效 | 未确认,进入待澄清 |
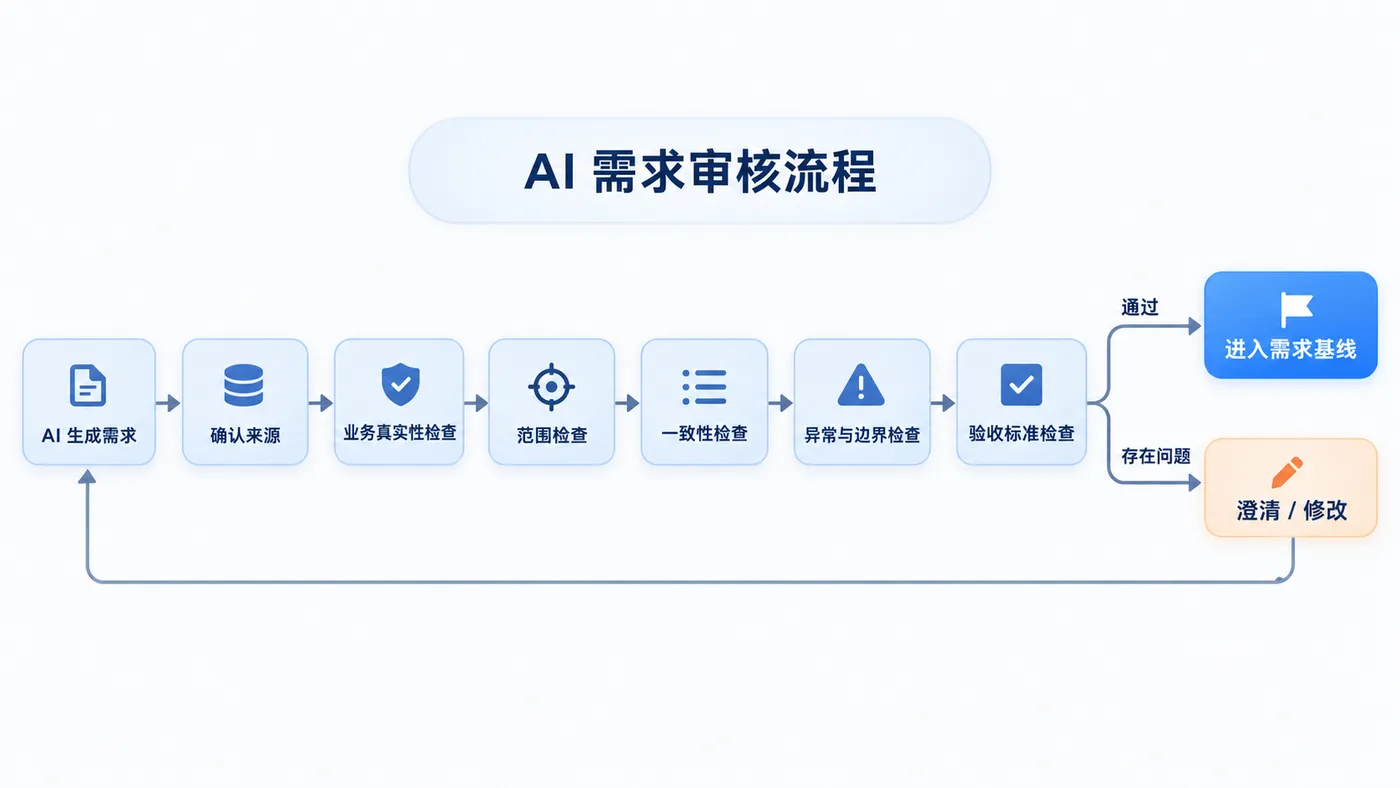
经过这一轮审核后,真正进入需求文档的已经不是 AI 的原始结果,而是经过确认的内容:AI 初稿
→来源检查→范围检查→业务澄清→一致性检查→异常检查→验收标准→正式需求。这才是 AI 需求文档进入项目基线前应该经历的过程。
九、需求审核需要明确角色分工
AI 参与以后,不应该把所有审核责任都交给项目经理。更合理的是继续沿用专业责任链。
| 审核内容 | 主要责任角色 |
| 原始信息是否提取准确 | BA |
| 业务规则是否真实 | BA / 客户 |
| 是否超出项目范围 | PM / 产品负责人 |
| 技术上是否存在明显冲突 | 架构师 / 开发负责人 |
| 是否可以验证 | 测试负责人 |
| 是否进入需求基线 | 项目经理组织确认 |
因此,项目经理需要建立的是审核流程和门禁,而不是自己逐条判断所有业务规则。可以形成:AI 初稿→BA Review→客户确认→技术检查→测试可验证性检查→PM 范围确认→需求基线 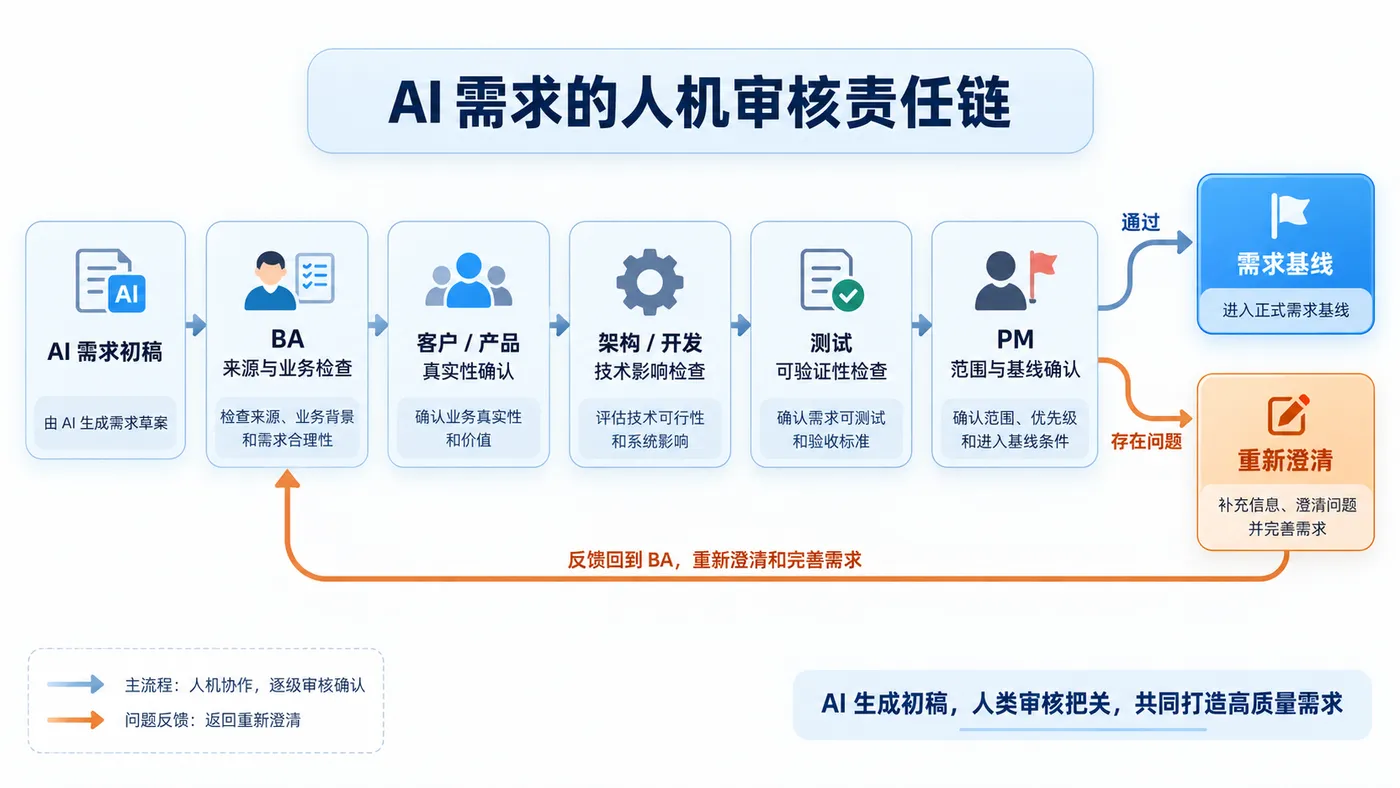

十、为需求补充来源和确认信息
AI 可以快速生成大量需求内容以后,建议在传统需求表基础上增加一些可追溯字段。例如:
| 字段 | 用途 |
| Requirement ID | 唯一编号 |
| 需求内容 | 正式需求描述 |
| 来源 | 客户、合同、制度、推导或 AI 建议 |
| 原始依据 | 会议、邮件、文档位置 |
| AI 是否参与 | 是否经过 AI 整理或生成 |
| 状态 | 已确认、待确认、建议 |
| 业务确认人 | 谁确认真实性 |
| 验收标准 | 如何判断完成 |
| 影响范围 | 涉及模块、接口或数据 |
| 基线版本 | 进入哪个正式版本 |
AI 参与以后,需求文档真正重要的并不只是写得详细,而是:每条需求都能够找到来源、确认人和验收方式。
十一、让 AI 辅助完成第一轮需求检查
AI 无法确认客户真实意图,但很适合承担机械性的第一轮 Review。可以设计一个 Requirement Reviewer,专门检查:缺少来源的需求、规则冲突、疑似推测内容、范围新增、模糊词汇、遗漏异常场景、不可验证需求。流程可以设计成:AI Writer→需求初稿→AI Reviewer→问题清单→
BA / 客户处理。这样 AI 不再只是负责生成,也可以承担部分质量检查工作。其中角色要保持清楚:Writer 负责生成,Reviewer 负责发现问题,人负责最终判断。这套方式后续也可以复用到设计、代码和测试阶段。
十二、如何衡量需求审核是否真正提效
如果企业希望衡量 AI 是否改善了需求阶段,不建议只统计生成了多少文档。更值得关注的是:
| 指标 | 关注点 |
| 无来源需求比例 | 是否产生过多推测内容 |
| 待确认项关闭率 | 澄清是否及时 |
| AI 建议采纳率 | AI 补充是否真正有价值 |
| 冲突发现数量 | 是否提前暴露问题 |
| 开发后需求返工率 | 前期质量是否提高 |
| 验收标准覆盖率 | 需求是否可以验证 |
| 可追溯率 | 是否能找到原始依据 |
如果需求文档生成快了很多,但开发过程中仍然频繁返工,那么 AI 只是提高了写文档的速度,并没有真正改善需求质量。
十三、结语:AI 初稿不能直接成为需求基线
随着 AI 能力增强,未来生成一份几十页的需求规格说明书会越来越容易。真正困难的问题将逐渐变成:这几十页里面,哪些内容是真正被确认过的需求。因此,AI 生成需求以后,更合理的过程应该是:AI 初稿→确认来源→确认业务真实性→检查项目范围→检查规则一致性→补充异常边界→形成验收标准→人工确认→进入需求基线。AI 可以帮助团队把信息整理得更完整,也可以帮助发现遗漏和冲突,但正式需求仍然需要具备:来源、边界、确认人和验收标准。项目经理真正需要避免的,不是 AI 偶尔写错一句话,而是:未经确认的 AI 初稿,因为形式完整、表达专业,被团队直接当成了正式需求。
上一篇回顾:
https://developer.aliyun.com/article/1768876?spm=a2c6h.13148508.setting.14.339d4f0eO7aara
下一篇:从需求说明书到需求清单,AI 如何辅助需求结构化?
完成需求审核以后,下一步会进入更工程化的问题:几十页需求说明书如何转换成可管理、可追踪,并且能够直接进入设计、开发和测试的需求资产。
下一篇将重点讨论:
Requirement ID → 功能清单 → 业务规则 → 用户故事 → 验收标准 → 影响模块 → 测试映射
以及如何利用 AI 把“有一份需求文档”,进一步升级为“有一套可以持续管理的结构化需求数据”。