
在银行和消费金融领域,Blaze、Drools 等规则引擎已经使用多年。无论贷前授信、贷中风险监控,还是贷后逾期管理,本质上都存在大量“根据客户状态进行判断,再选择下一步策略”的业务逻辑。例如贷后催收系统通常会根据逾期天数、逾期金额、历史逾期次数、还款记录、触达次数、案件等级等数据,通过 Blaze 配置催收策略,再决定案件进入 AI 催收、人工催收、内部催收还是委外催收。
Jev 出现之后,一个很自然的问题是:这种面向决策的新模型,能否进入银行已有的规则和风控体系?答案是可以,但更合理的定位并不是替代 Blaze 或 Drools,而是在传统的规则引擎、风险模型和生成式大模型之间补充一层“语义决策能力”。
一、传统规则引擎解决的是“规则明确以后怎么办”
银行大量使用规则引擎,并不是偶然。例如:
IF DPD > 30
AND 逾期金额 > 50000
AND 最近催收失败次数 > 5
THEN
    转人工催收
或者:
IF DPD > 90
AND 满足委外条件
THEN
    转委外催收
这种规则非常适合 Blaze、Drools 等产品,因为输入字段明确、判断条件清晰、执行结果确定,并且整个过程可以解释、回溯和审计。对于金融业务而言,这种确定性尤其重要。系统必须能够回答:为什么这个案件被分配给委外催收?答案应该是明确的:
命中策略 COLLECT_023
DPD > 90
逾期金额满足条件
历史触达失败次数达到阈值
因此,像监管规则、额度规则、黑白名单、DPD 区间、金额阈值、流程控制、权限检查等逻辑,并不适合交给概率模型处理,它们仍然应该由规则引擎和代码控制。
Jev 官方本身也强调类似的设计原则:能够通过确定性代码处理的逻辑,应继续放在代码中,而不是交给模型。
二、真正困难的是“有些业务状态很难写成规则”
规则引擎擅长处理结构化字段,但现代金融系统正在积累越来越多非结构化数据,例如电话录音及转写、客服沟通记录、催收员备注、客户投诉、承诺还款说明、短信内容和历史沟通摘要。例如客户在催收电话中说:
“最近公司资金周转有问题,本周五有笔回款,到时候先把这一期还掉。前几天你们也联系过我,我不是不还,只是暂时周转不开。”
从人工催收人员的角度,很容易形成一些判断:
还款意愿:较高
承诺还款:是
短期偿付能力:一般
失联风险:较低
投诉风险:较低
但如果全部通过 Blaze 表达,就不得不不断增加规则:
IF 包含“工资”
OR 包含“回款”
OR 包含“月底”
OR 包含“发工资以后”
...
随着实际业务越来越复杂,规则会迅速膨胀,而且很难真正表达上下文和语义。这类问题恰好属于 Jev 试图解决的范围。它面对的不是明确数值判断,而是:根据当前复杂状态,这个客户现在更像处于什么状态?
三、Jev 更像“语义决策引擎”,而不是新的规则引擎
可以把两者的分工简单理解为:Blaze / Drools 解决“按照规则应该怎么办”,Jev 解决“当前到底是什么情况”。例如一个逾期客户具有如下状态:
DPD:17天
逾期金额:12600元
历史逾期次数:1次
最近7天AI外呼3次、人工外呼1次
客户两次承诺25号工资到账后还款
昨天主动联系客服确认还款金额
没有明显拒接,也没有投诉
过去12个月还款基本正常
其中:
DPD = 17
逾期金额 = 12600
历史逾期次数 = 1
这些属于结构化数据,非常适合规则和传统模型。但另外一些问题就没有那么容易定义:
客户还款意愿高不高?
承诺还款是否可信?
当前是否适合继续AI催收?
是否应该升级人工处理?
是否存在投诉升级风险?
Jev 可以把这些问题转化成类型化决策,例如:
repayment_intent:
High    0.83
Medium  0.14
Low     0.03

PTP_reliability:
High    0.71
Medium  0.23
Low     0.06

complaint_risk:
Low     0.89
Medium  0.09
High    0.02
这些结果随后可以继续进入现有策略系统:
IF
    DPD <= 30
AND repayment_intent = HIGH
AND PTP_reliability = HIGH
AND complaint_risk = LOW
THEN
    继续AI催收
这样一来,Jev 并不直接决定最终业务动作,而是为规则引擎提供原来很难获得的语义特征。
四、银行风控更合理的架构不是“Jev 替换 Blaze”
实际生产系统更适合采用多种决策技术组合。
                    客户状态
                       ↓
          ┌────────────┼────────────┐
          ↓            ↓            ↓
     Blaze/Drools   风险模型        Jev
          │            │            │
     业务规则       统计预测      语义判断
     监管规则       风险评分      状态识别
     流程策略       PD/Score      意图判断
          └────────────┼────────────┘
                       ↓
                 Strategy Engine
                       ↓
             最终业务策略与流程
三类技术实际上解决的是不同问题。
| 技术 | 更适合解决的问题 |
|---|---|
| Blaze / Drools | 确定性规则、政策、流程和阈值 |
| ML / Score Model | 基于历史数据进行概率预测 |
| Jev | 对复杂上下文和非结构化信息进行语义判断 |
| LLM | 深度分析、解释、交互和内容生成 |
这种架构比“把整个风控系统交给一个大模型”更加现实,也更符合金融系统对可解释性和可治理性的要求。
五、贷后催收可能是 Jev 最容易落地的场景之一
相比授信审批,贷后催收本身存在大量非结构化数据,同时业务输出却非常结构化,因此与 Jev 的设计思路天然契合。一次 AI 催收通话可能产生:
客户:
“我知道已经逾期了,这个月工资发晚了,
25号到账以后我会处理,
前面你们已经联系过几次,
不要每天都给我打电话。”
生成式大模型可以负责转写、摘要和自然语言理解,而 Jev 更适合进一步形成结构化判断:
是否承诺还款:YES   0.96
还款意愿:HIGH      0.82
投诉倾向:MEDIUM    0.63
继续自动外呼:NO    0.78
是否人工复核:YES   0.61
这些状态再进入 Blaze:
IF
    PTP = YES
AND complaint_risk >= MEDIUM
THEN
    24小时内停止自动外呼
    等待承诺还款日
于是整个系统形成非常清晰的职责划分:
LLM
负责理解和生成

Jev
负责语义判断

Blaze
负责业务政策

Workflow
负责状态和执行流程

Human
负责高风险和边界案例
这种组合比简单地使用一个 LLM 完成所有判断更加稳定。
六、Jev 更大的价值可能在于 Next Best Action
贷后催收长期以来非常依赖 DPD Bucket,例如:
DPD 1~3   → 短信提醒
DPD 4~7   → AI外呼
DPD 8~15  → 人工催收
DPD 16~30 → 强化催收
DPD > 30  → 内催或委外
这种策略简单有效,但同一个 DPD 区间的客户实际情况可能完全不同。例如两个 DPD=15 的客户:
| 客户A | 客户B |
|---|---|
| 主动联系客服 | 长期拒接 |
| 主动确认还款金额 | 联系方式频繁失效 |
| 多次表达还款意愿 | 多次承诺但未履约 |
| 历史信用较好 | 明显拒绝沟通 |
传统规则可能因为 DPD 相同而将两人送入相似策略,但语义状态实际上完全不同。Jev 可以形成:
                 客户A       客户B

还款意愿          High        Low
PTP可信度         High        Low
失联风险          Low         High
升级催收需求       Low         High
随后由 Strategy Engine 决定:
客户A
→ 等待承诺还款
→ 降低触达频率

客户B
→ 转人工
→ 提高案件优先级
→ 进入强化催收策略
因此 Jev 在贷后场景最值得关注的,并不一定是再做一个“风险评分”,而是帮助系统更准确地判断:这个客户当前处于什么状态,下一步最合适采取什么动作。也就是所谓的 Next Best Action。
七、从“DPD 状态机”升级到“业务语义状态机”
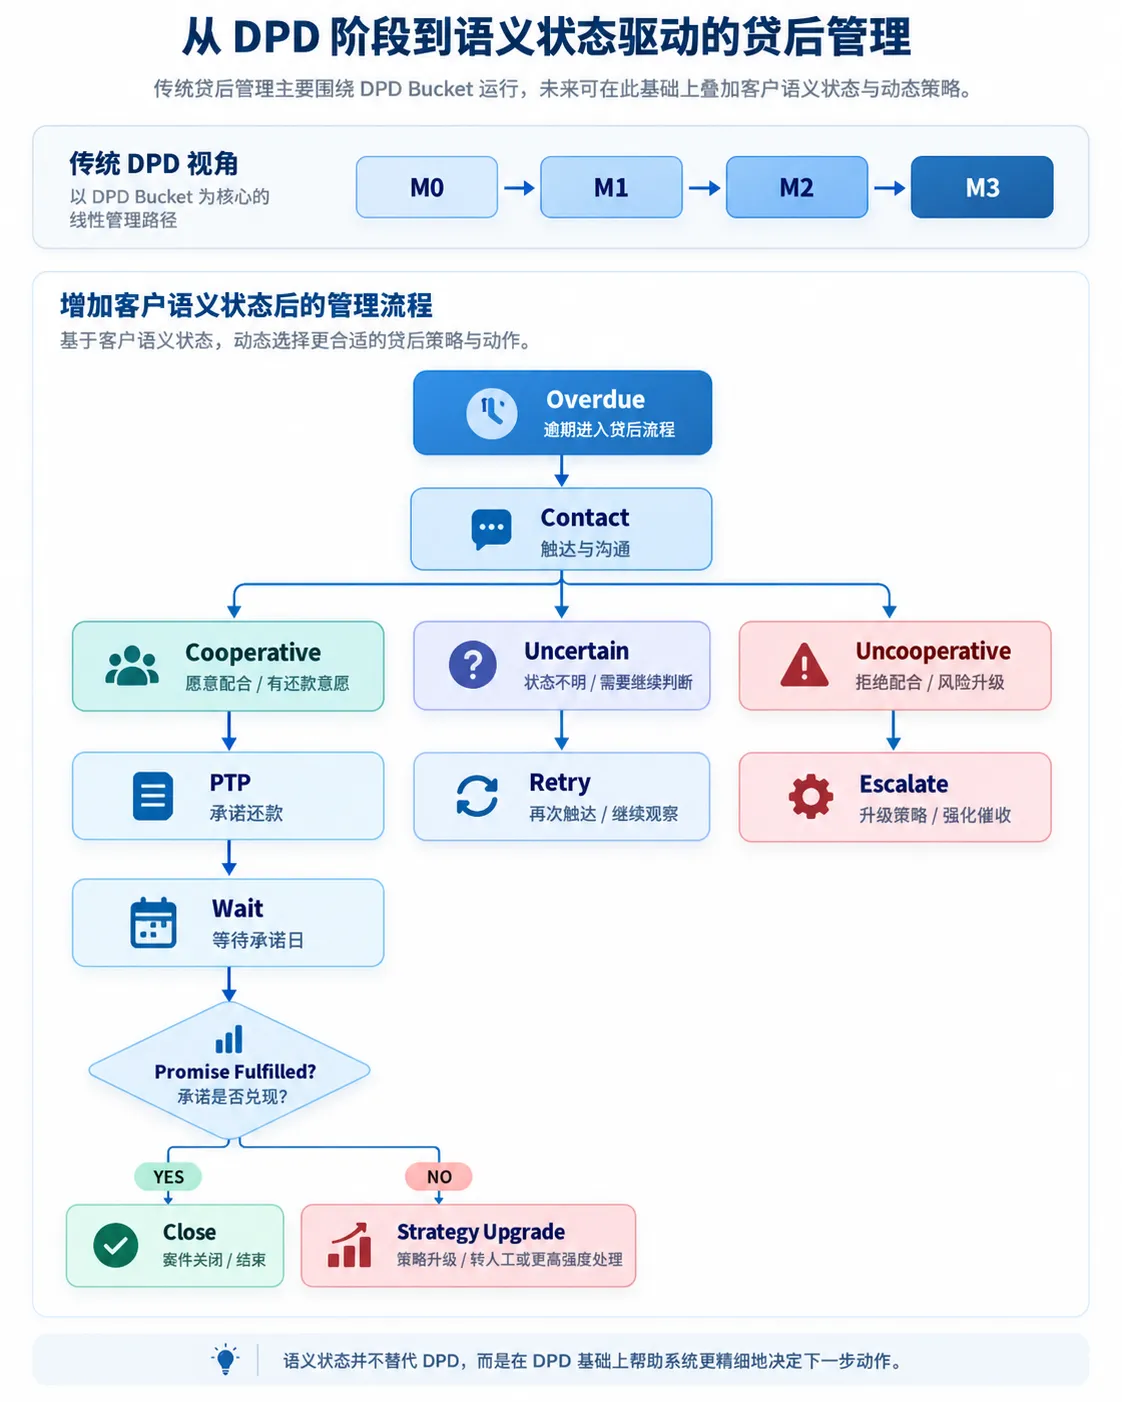
Jev 在这里可以看成状态机中的“智能条件边”。传统 Conditional Edge:DPD > 30。属于确定性条件。Jev 负责的则可能是:客户是否仍具有较强还款意愿?客户是否出现明显投诉倾向?当前是否适合继续AI催收?这与当前 Agent 架构中的 State Machine + AI Decision 思路其实非常接近。
八、贷前、贷中、贷后都可以使用,但价值不同
在贷前阶段,Jev 可以用于申请材料分类、资料一致性判断、异常描述识别、人工审核优先级和复杂材料中的风险信号提取。但授信、额度、拒贷这类高影响决策不适合简单设计成:Jev → Approve / Reject。更加合理的是让 Jev 提供补充语义信号,再由传统风控模型、规则引擎和人工审核共同完成决策。贷中则适合用于风险事件分类、客户行为变化判断、预警级别识别、异常事件路由等。相比之下,贷后通常拥有更丰富的沟通记录、客户反馈、催收记录、承诺还款和历史策略结果,因此更容易形成:
Unstructured State
        ↓
      Jev
        ↓
Typed Decision
也更适合作为这类技术的首批验证场景。
九、金融生产环境不能让 Jev 直接拥有最终决策权
Jev 目前仍然是一个非常新的模型,金融领域又具有较高的监管、审计和风险要求。
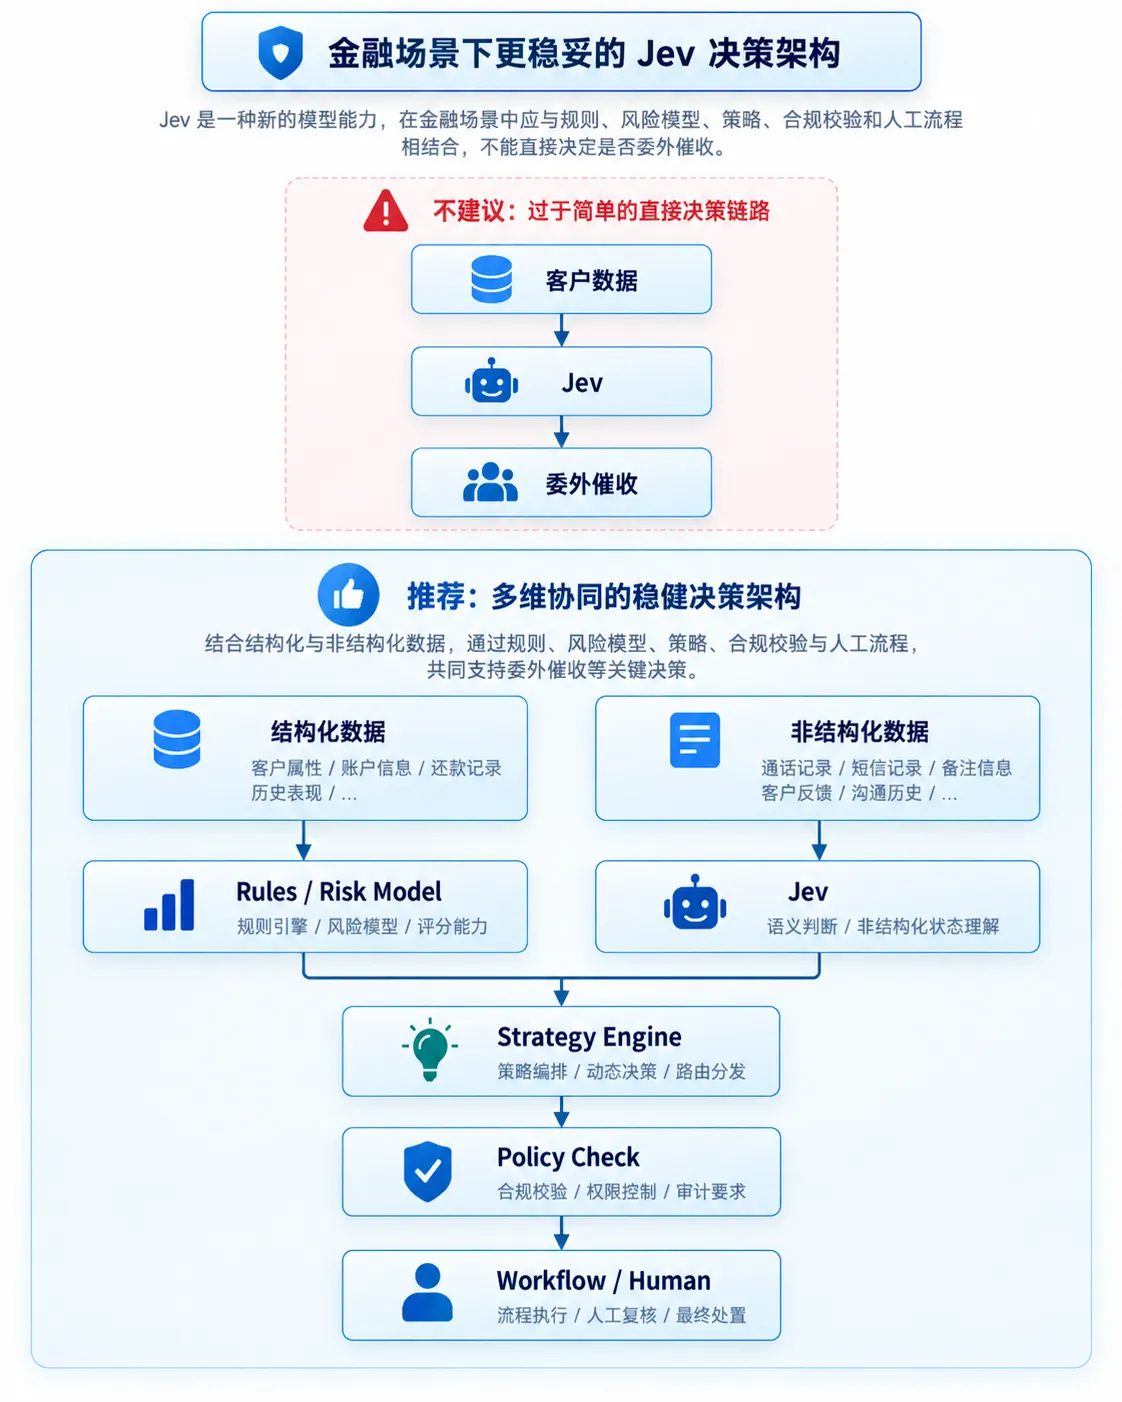
Jev 更适合成为一个 Semantic Feature Provider / Semantic Decision Engine,而不是整个风控体系的最终裁决者。
十、如果重新设计一套贷后催收系统
比较完整的架构可以是:
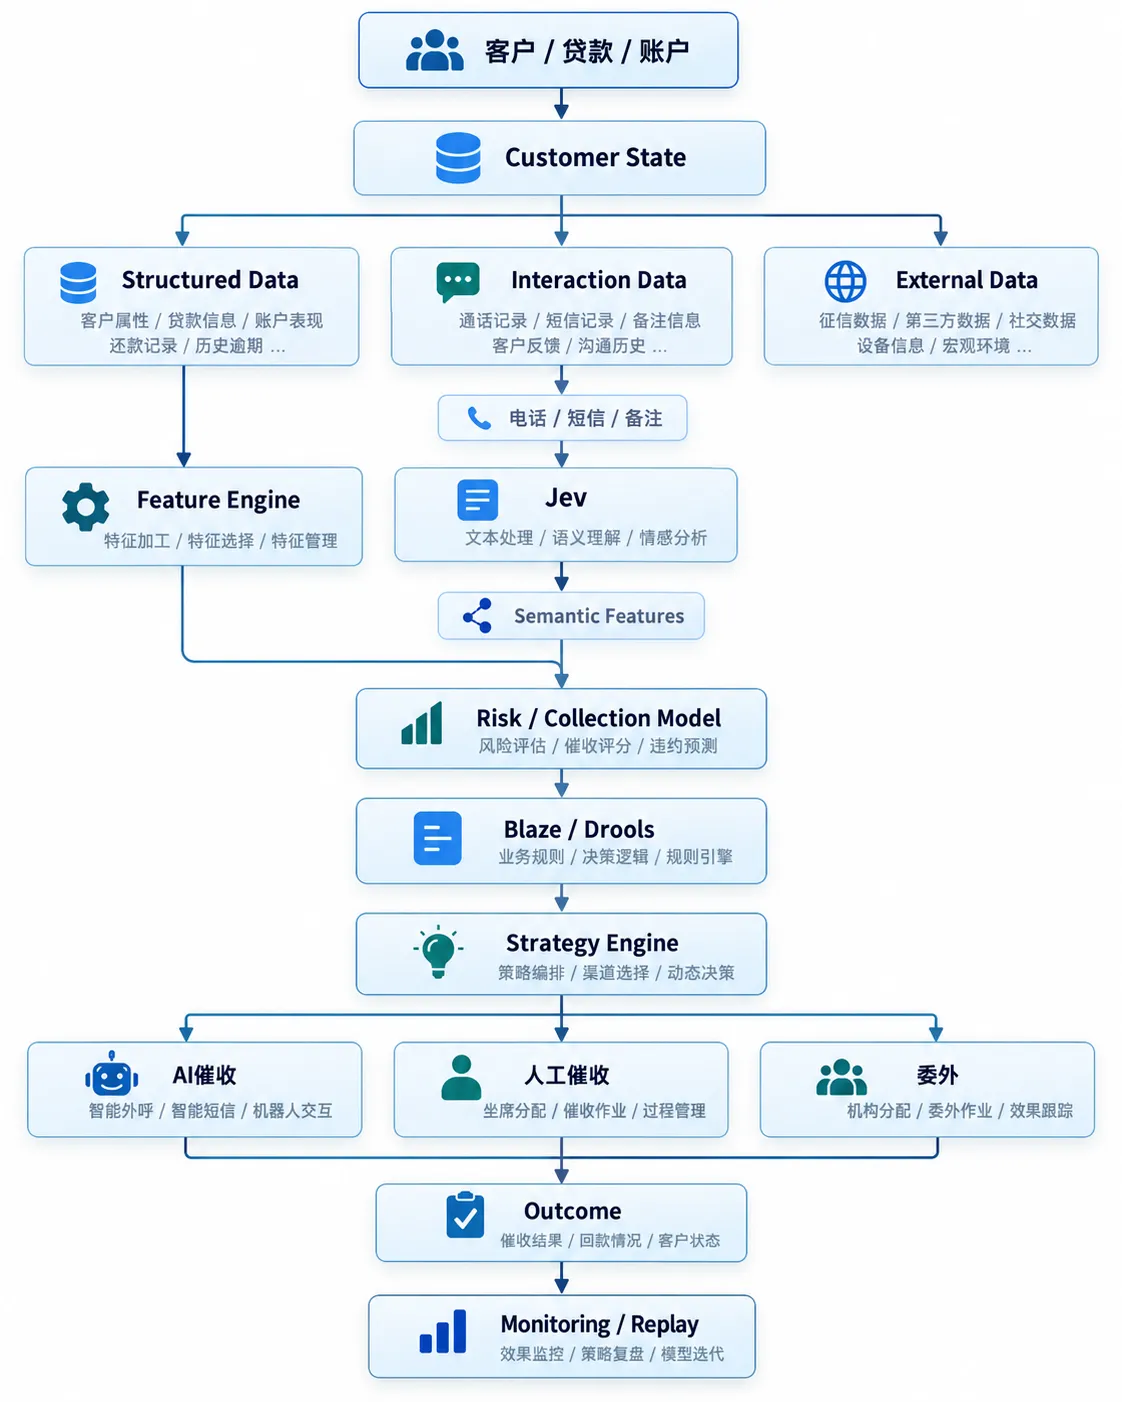
真正落地时也不应该一开始就让 Jev 参与生产决策,而应该经历:历史数据离线回放→与现有策略结果比较→Shadow Mode只判断、不影响生产→生成 Semantic Features→由 Blaze 决定最终策略→逐步开放低风险自动决策。这样既能验证模型价值,也能保留原有体系的稳定性和可审计能力。
十一、从规则引擎到“组合式决策架构”
传统银行 Decision Architecture 通常是:Data→Feature→Score Model→Rules Engine→Decision。生成式 AI 出现之后,一些方案试图直接变成:Data→LLM→Decision。但在金融场景中,这种方式通常过于激进。Jev 所代表的方向反而提供了一种更加现实的演进路线:
                 Data
                   ↓
                 State
                   ↓
        ┌──────────┼──────────┐
        ↓          ↓          ↓
      Rules        ML        Jev
        │          │          │
     Policy    Statistical  Semantic
               Prediction  Judgment
        └──────────┼──────────┘
                   ↓
              Decision Engine
                   ↓
                Workflow
                   ↓
             Human / AI / Tool
规则引擎负责确定性和政策,传统模型负责统计预测,Jev 负责复杂语义状态判断,LLM 则负责理解、分析和交互。这不是用 AI 重做银行风控,而是在已有成熟体系中补上过去最难处理的一层——模糊、非结构化、依赖上下文的语义决策。
对于贷后逾期管理来说,这一点尤其明显。过去催收策略主要依赖 DPD、金额、次数等结构化字段,未来还可以进一步利用客户沟通、行为变化和承诺情况形成动态的语义状态,从而让 AI 催收、人工催收、内催和委外之间的策略选择更加精细。
从这个角度看,Jev 真正值得金融科技关注的地方,并不是它能不能替代 Blaze,而是:它能否成为 Rules、Risk Model 与 LLM 之间的一层新的 Decision Layer。如果这一类模型最终成熟,传统的“规则驱动风控”很可能不会消失,而会逐渐演进成 规则 + 模型 + 语义决策 + 工作流 的组合式决策架构。


