摘要:从 Local 本地调试到 YARN 生产集群、Kubernetes 云原生部署,系统讲解 Spark 五大运行模式的架构原理、配置方法、适用场景和模式选型决策树。配有 4 张原创架构图、各模式 spark-submit 命令模板、client vs cluster 深度对比。面向 Java、大数据及 AI 开发工程师。
一、Spark 运行模式全景架构
Spark 支持五种运行模式,从单机调试到万节点集群,覆盖了所有部署场景: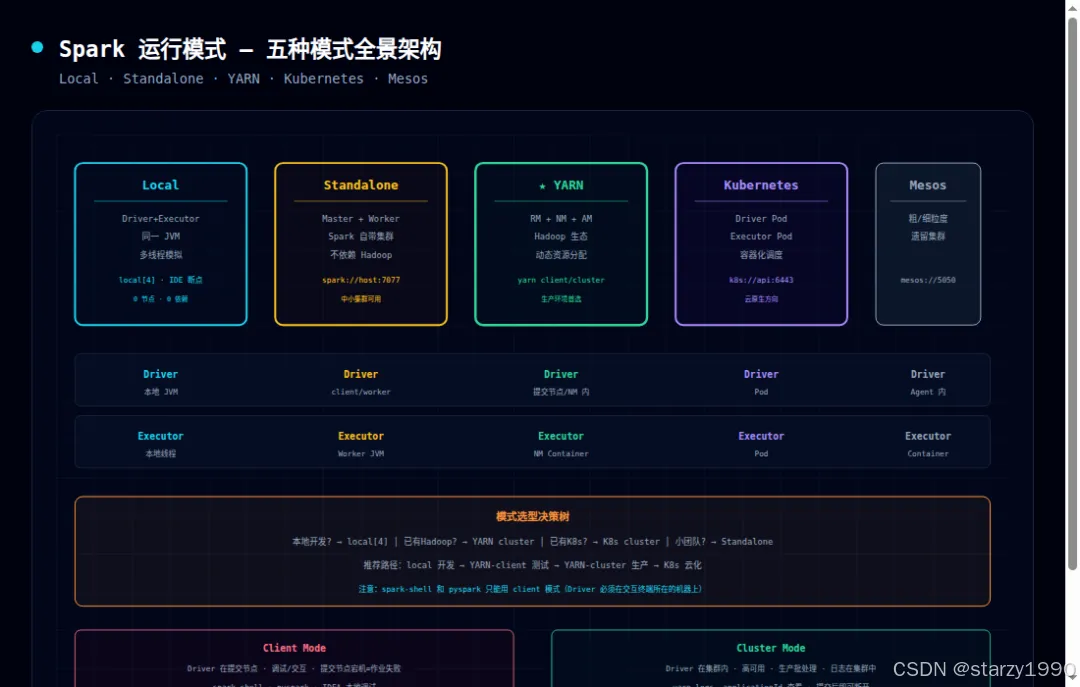
| 模式 | --master | 适用场景 | Driver 位置 | Executor 位置 |
|---|---|---|---|---|
| Local | local[N] |
开发、调试、单元测试 | 本地 JVM | 本地线程 |
| Standalone | spark://host:7077 |
中小集群、不依赖 Hadoop | 提交节点(client) 或 Worker(cluster) | Worker 节点 JVM |
| YARN | yarn |
生产 Hadoop 集群首选 | 提交节点(client) 或 NM(cluster) | NM Container |
| Kubernetes | k8s://https://api:6443 |
云原生、容器化 | Pod | Pod |
| Mesos | mesos://host:5050 |
遗留 Mesos 集群 | 提交节点(client) 或 Agent(cluster) | Agent 容器 |
二、Local 模式 — 本地开发调试
Local 模式是开发阶段最常用的模式,所有组件运行在同一个 JVM 中,无需任何集群。
2.1 三种 Local 模式
| 参数 | 含义 | 典型用途 |
|---|---|---|
local[1] |
1 个线程 | 顺序执行、调试逻辑 |
local[4] |
4 个线程 | 模拟 4 核并行 |
local[*] |
使用所有可用 CPU 核心 | 充分利用本机资源 |
local[4, 2] |
4 线程 + 最多 2 次失败重试 | 测试容错 |
2.2 代码中设置
// 方式1:代码中硬编码(仅开发用)
val conf = new SparkConf().setMaster("local[4]")

// 方式2:spark-submit 命令行(推荐)
// spark-submit --master local[4] ...
2.3 IDEA 调试配置
Run → Edit Configurations → Application
Main class:    com.example.MySparkJob
VM options:    -Dspark.master=local[4] -Xms512m -Xmx2048m
💡 Local 模式下可以直接在 Transformation 闭包内部打断点,因为 Driver 和 Executor 在同一 JVM。这是 Spark 开发效率远超 MR 的核心原因之一。
三、Standalone 模式 — 独立集群
Standalone 是 Spark 自带的集群管理器,无需依赖 Hadoop/YARN,适合中小团队独立部署。
3.1 架构
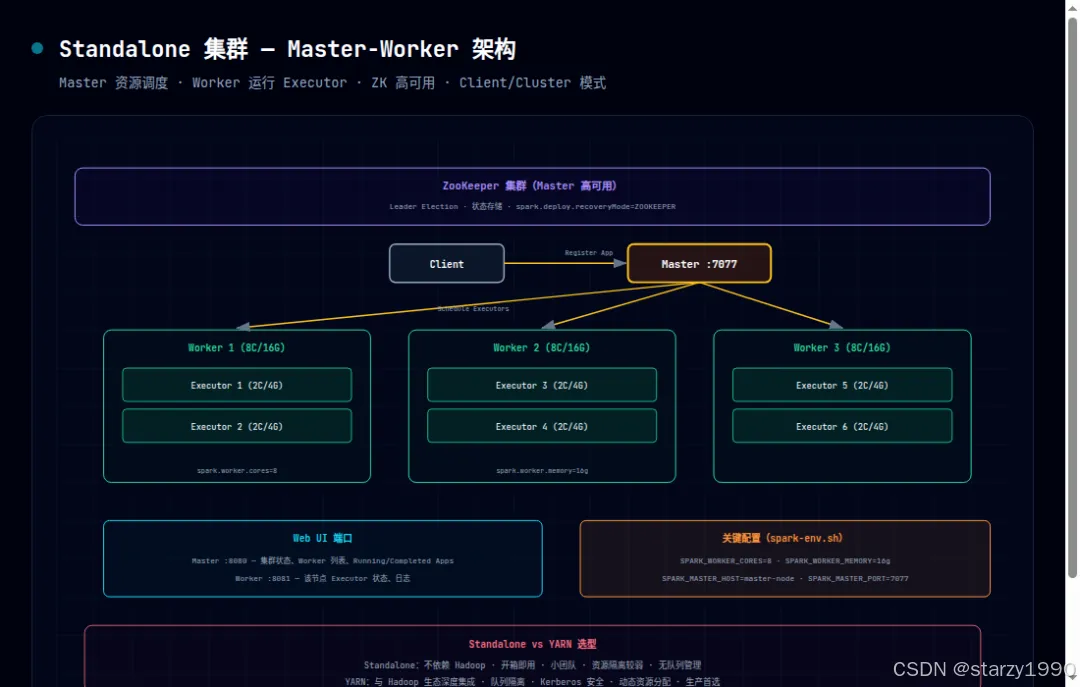
- Master:资源管理主节点,负责 Worker 注册、资源分配(类似 YARN 的 ResourceManager)
- Worker:工作节点,运行 Executor 进程(每个 Worker 可启动多个 Executor)
- Driver:客户端提交时指定 client/cluster 模式决定运行位置
3.2 启动集群
# 1. 启动 Master(在 master-node 上)
$SPARK_HOME/sbin/start-master.sh
# Master 默认监听 spark://master-node:7077
# Web UI 默认监听 http://master-node:8080

# 2. 启动 Worker(在每个 worker 节点上)
$SPARK_HOME/sbin/start-worker.sh spark://master-node:7077

# 3. 提交作业
spark-submit \
  --master spark://master-node:7077 \
  --deploy-mode cluster \
  --executor-memory 2G \
  --total-executor-cores 4 \
  my-app.jar
3.3 Master 高可用(ZooKeeper)
# spark-env.sh
export SPARK_DAEMON_JAVA_OPTS="
  -Dspark.deploy.recoveryMode=ZOOKEEPER
  -Dspark.deploy.zookeeper.url=zk1:2181,zk2:2181,zk3:2181
  -Dspark.deploy.zookeeper.dir=/spark-ha"
⚠️ Standalone 模式下
--deploy-mode cluster时,Driver 运行在某个 Worker 上,该 Worker 宕机会导致 Driver 丢失。建议配置 supervise 模式自动重启。
3.4 关键配置
# spark-defaults.conf
spark.master                     spark://master-node:7077
spark.worker.cores               4          # 每个 Worker 的 CPU 核心数
spark.worker.memory              8g         # 每个 Worker 的内存总量
spark.executor.memory             2g        # 每个 Executor 的内存
spark.cores.max                   16         # 整个应用最大使用核心数
spark.deploy.spreadOut            true       # 尽量分散 Executor 到不同 Worker
四、YARN 模式 — 生产环境首选
YARN 是 Hadoop 生态的标准资源管理器,Spark on YARN 是目前最广泛使用的生产部署方式。
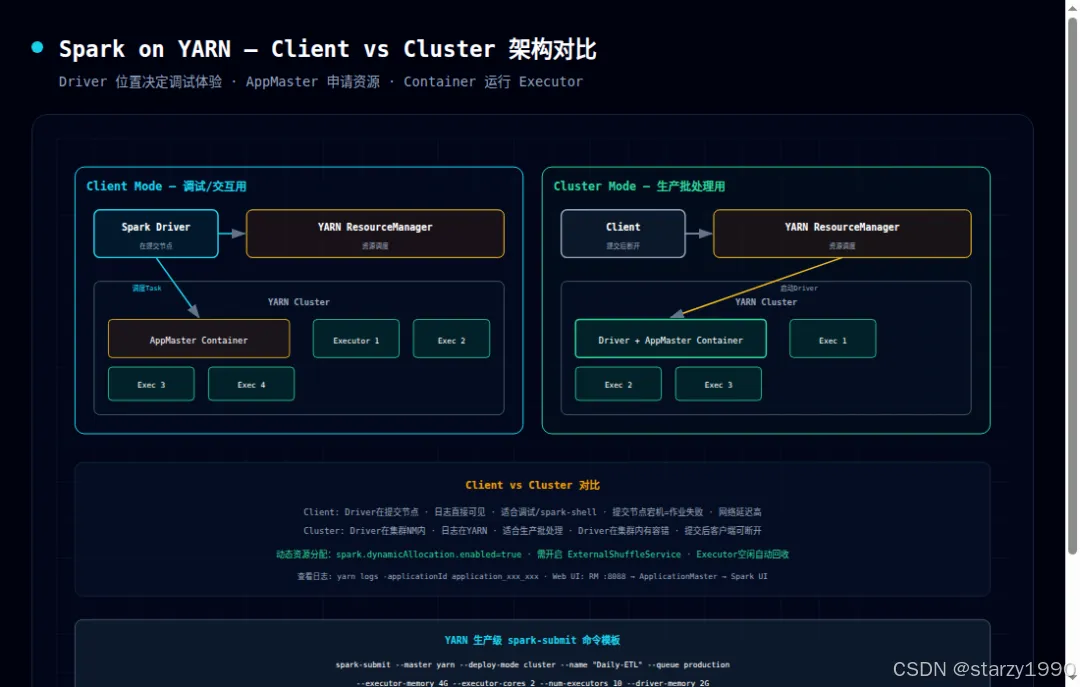
4.1 YARN 架构
| 角色 | 说明 |
|---|---|
| ResourceManager (RM) | 全局资源调度(接收 ApplicationMaster 申请) |
| NodeManager (NM) | 每个节点的资源监控和 Container 管理 |
| ApplicationMaster (AM) | 每个应用一个,向 RM 申请资源,管理 Executor |
| Container | 资源抽象(CPU + 内存),Executor 运行在 Container 中 |
4.2 client 模式 vs cluster 模式
这是 YARN 模式中最关键的决策——Driver 进程放在哪里:
| 维度 | client 模式 | cluster 模式 |
|---|---|---|
| Driver 位置 | 提交节点 | 集群内某个 NM |
| 适用场景 | 开发、调试、交互式查询 | 生产批处理 |
| 日志查看 | 提交终端直接可见 | yarn logs -applicationId <appId> |
| 提交节点宕机 | Driver 丢失 → 作业失败 | 不受影响 |
| spark-shell | ✅ 必须用 client | ❌ 不支持 |
| 网络延迟 | Driver↔Executor 可能跨网段 | Driver 在集群内,延迟低 |
4.3 spark-submit 命令模板
# === client 模式(调试/交互用) ===
spark-submit \
  --master yarn \
  --deploy-mode client \
  --executor-memory 4G \
  --executor-cores 2 \
  --num-executors 10 \
  --driver-memory 2G \
  --conf spark.dynamicAllocation.enabled=true \
  --conf spark.sql.shuffle.partitions=200 \
  --class com.example.MyApp \
  my-app.jar

# === cluster 模式(生产用) ===
spark-submit \
  --master yarn \
  --deploy-mode cluster \
  --name "Daily-ETL-Job" \
  --queue production \
  --executor-memory 4G \
  --executor-cores 2 \
  --num-executors 10 \
  --driver-memory 2G \
  --driver-cores 1 \
  --conf spark.dynamicAllocation.enabled=true \
  --conf spark.dynamicAllocation.minExecutors=5 \
  --conf spark.dynamicAllocation.maxExecutors=50 \
  --conf spark.serializer=org.apache.spark.serializer.KryoSerializer \
  --conf spark.eventLog.enabled=true \
  --jars mysql-connector-java.jar \
  --files log4j.properties \
  --class com.example.ETLJob \
  my-app.jar arg1 arg2
4.4 动态资源分配
# spark-defaults.conf(YARN 模式必开)
spark.dynamicAllocation.enabled           true
spark.dynamicAllocation.minExecutors      2      # 最小空闲 Executor
spark.dynamicAllocation.maxExecutors      100    # 最大 Executor 数
spark.dynamicAllocation.initialExecutors  5      # 初始数量
spark.dynamicAllocation.executorIdleTimeout  60s  # 空闲回收时间
spark.shuffle.service.enabled             true   # 必须开启 ExternalShuffleService
⚠️ 动态资源分配的前提:在所有 NodeManager 节点上启动 ExternalShuffleService(
$SPARK_HOME/sbin/start-shuffle-service.sh),否则 Executor 回收时 Shuffle 数据会丢失。
五、Kubernetes 模式 — 云原生方向
5.1 K8s 架构
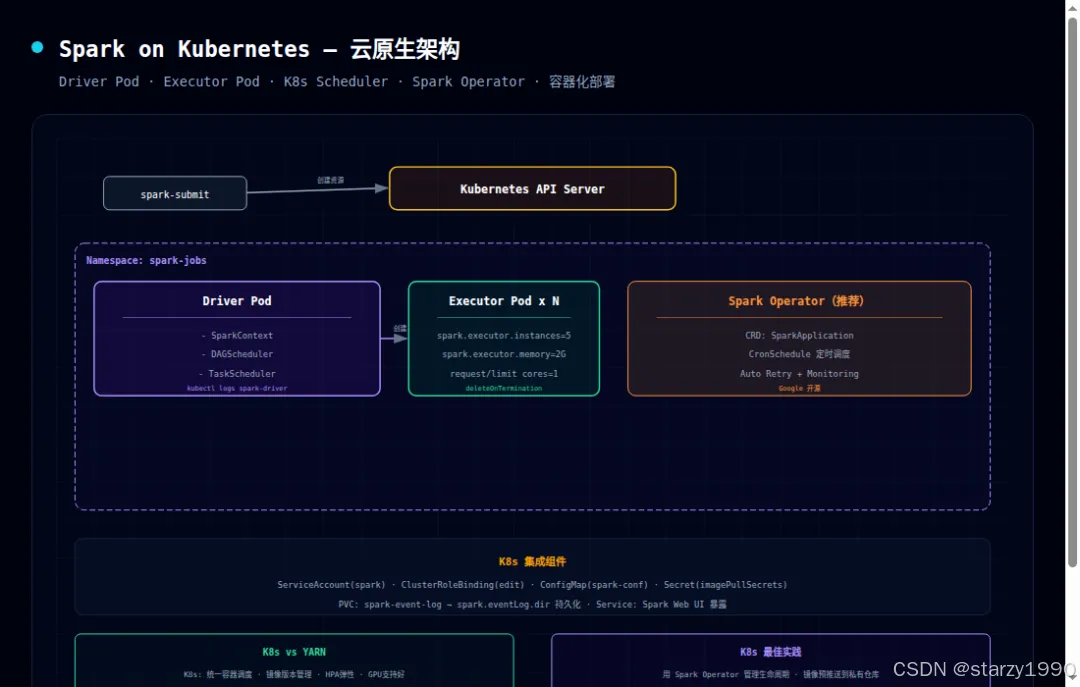
- Driver Pod:提交时创建,运行 SparkContext,负责 DAG 调度
- Executor Pod:由 Driver 动态创建,运行 Task
- 不需要:YARN RM/NM 或 Standalone Master/Worker
5.2 spark-submit on K8s
# 创建 ServiceAccount(一次性)
kubectl create serviceaccount spark
kubectl create clusterrolebinding spark-role \
  --clusterrole=edit --serviceaccount=default:spark

# 提交作业
spark-submit \
  --master k8s://https://k8s-api-server:6443 \
  --deploy-mode cluster \
  --name spark-pi \
  --class org.apache.spark.examples.SparkPi \
  --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark \
  --conf spark.kubernetes.container.image=apache/spark:3.3.0 \
  --conf spark.kubernetes.namespace=spark-jobs \
  --conf spark.executor.instances=5 \
  --conf spark.executor.memory=2G \
  --conf spark.kubernetes.executor.request.cores=1 \
  local:///opt/spark/examples/jars/spark-examples_2.12-3.3.0.jar 1000
5.3 关键 K8s 配置
# Kubernetes 特有配置
spark.kubernetes.container.image                       apache/spark:3.3.0
spark.kubernetes.namespace                              spark-jobs
spark.kubernetes.authenticate.driver.serviceAccountName spark
spark.kubernetes.driver.pod.name                       spark-driver
spark.kubernetes.executor.deleteOnTermination           true
spark.kubernetes.driver.limit.cores                     2
spark.kubernetes.executor.limit.cores                   2
spark.kubernetes.file.upload.path                       hdfs:///spark-upload
💡 K8s 模式下,建议使用 Spark Operator(Google 开源)管理 Spark 作业生命周期,支持定时调度、重试、监控集成。
六、Mesos 模式(简要)
Mesos 是 Apache 的通用资源调度器,曾是 Spark 早期的重要运行平台。架构分为粗粒度(Coarse-Grained)和细粒度(Fine-Grained)两种模式:
spark-submit --master mesos://mesos-master:5050 --deploy-mode cluster ...
目前业界已大幅向 YARN 和 Kubernetes 迁移,Mesos 使用比例持续下降。新项目不建议选用 Mesos。
七、模式选型决策树
开始
 │
 ├─ 本地开发/调试? ─── YES → Local 模式 (local[4])
 │
 ├─ 已有 Hadoop/YARN 集群? ─── YES → YARN cluster 模式
 │
 ├─ 已有 Kubernetes 集群? ─── YES → K8s cluster 模式
 │
 ├─ 小团队 / 不想搭 Hadoop? ─── YES → Standalone 模式
 │
 └─ 遗留 Mesos 集群? ─── YES → Mesos(建议迁移到 YARN/K8s)
| 场景 | 推荐模式 | 理由 |
|---|---|---|
| IDEA 中写代码 + 打断点 | local[4] |
Driver+Executor 同 JVM,可调试闭包 |
| spark-shell 交互式探索数据 | yarn-client |
Driver 在本地,直接看输出 |
| 定时批处理(T+1 ETL) | yarn-cluster |
高可用,无单点故障 |
| 实时流处理(Streaming) | yarn-cluster |
Driver 常驻,需要集群级别容错 |
| 容器化 / DevOps 统一调度 | k8s-cluster |
与微服务统一运维 |
| ML 训练 + GPU 调度 | k8s |
GPU 资源管理和隔离更好 |
八、最佳实践
| # | 实践 | 详细 |
|---|---|---|
| ✅ 1 | 开发用 local, 生产用 cluster | local 模式可断点调试,cluster 模式有容错 |
| ✅ 2 | YARN 生产务必开动态资源分配 | 避免 Executor 空转浪费,提升集群利用率 |
| ✅ 3 | Shuffle Service 必须开 | 动态回收 Executor 时保住 Shuffle 数据 |
| ✅ 4 | driver-memory 按需配置 | 不要盲目给大内存——collect() 数据量决定 Driver 内存需求 |
| ✅ 5 | executor 数量 = 总核心数 / executor-cores | 合理计算,避免碎片化 |
| ✅ 6 | Windows 本地开发用 local[4] | 配置 HADOOP_HOME + winutils.exe |
| ✅ 7 | K8s 用 Spark Operator | 管理作业生命周期,支持 CronSchedule |
写在最后
理解 Spark 五种运行模式,本质上是在回答一个问题:"我的计算任务应该跑在哪里、由谁来管理资源?"
- 写代码时 →
local[4],IDE 里打断点 - 上测试环境 →
yarn-client,看着日志调参数 - 上生产环境 →
yarn-cluster,开动态分配、配 Shuffle Service - 上云原生 →
k8s-cluster,用 Operator 管理生命周期
模式的选择,决定了你的 Spark 作业有多稳定、多高效、多省钱。