论文发布时间2026年9月19日,地址:https://arxiv.org/pdf/2609.22978
使用deepseek翻译,图形部分使用gemini,gork,微软MAI-Image制作。
Jialiang Huang†‡, Hongxuan Tang† , Jingchang Chen† , Yuxuan Liu† , Yixiao Chen† , Yuan Cheng† , Yi Tao† , Jingli Zhou† , Yupeng Chen† , Haoyu Chen† , Jiarui Wang† , Shengkai Lin† , Chuqi Zhang† , Bryan Lee Teng† , Lian Guo† , Zhe Fu, Wenjun Gao, Yisong Wang, Liang Zhao, Zehao Wang, Ziwei Xie, Yongqiang Guo, Peixin Cong, Ziyi Gao, Shuiping Yu, Hanwei Xu, Zuofan Wu, Zhizhou Ren, Yuyang Zhou, Bowei Zhang, Zhihuan Huang, Qihao Zhu, Lei Wang, Tianle Lin, Han Yu, Jiewen Hu, Dejian Yang, Shuo Yang, Shanghao Lu, Shaoyuan Chen, Junjie Qiu, Zhangli Sha, Yinmin Zhong, Yongtong Wu, Shiyu Wang, Wei Liu, Bingzheng Xu, Longhao Chen, Qiushi Du, Yuzhen Huang, Shirong Ma, Yaohui Wang, Mingshu Chen, Tongrui Xiong, Y.C. Yan, Haowen Luo, Haofen Liang, Xiaokang Zhang, Weihao Zeng, Runxin Xu, Peiyi Wang, Jinhua Zhu, Ruoyu Zhang, Wenkai Yang, Qi Tang, Jiping Yu, Tian Ye, Ruizhe Pan, Honghui Ding, Xiaodong Liu, Lingxiao Luo, Zhihong Shao, Yuhan Wu, Jibai Lu, Wen Liu, Haoling Zhang, Jingcheng Hu, Yaoyang Ye, Chaofan Lin, Zhaochen Zhang, Jianan Tong, Hengxu Wu, Zhihao Li, Yicheng Wang, Luyao Wang, Yuzhuo Bai, Lingyue Fu, Ruifan Xu, Y.Z. Wang, Zonglin Li, Mingqi Wei, Haiyang Shen, Chengyuan Zhang, Chao Jin, Zili Zhang, R.H. Yang, Xinbo Xu, Jian Zhou, Ruidong Zhu, Yuzhe Guo, Zelun Pan, Shaoheng Nie, Erhang Li, Shuhan Lin, Zheng Liu, Anshuo Chen, Zilong Lyu, Sinuo Cao, Rui Yu, Chuhao Wang, Junyi Guo, Junxiao Song, Kaifeng Chen, Menghao Ye, Junxian Li, Di Wu, Haiyang Ma, Yilun Wang, Haoran Yang, Yizai Cai, Shichun Liu, Yiping Wang, Junbo Sun, Shicheng Xu, Xiao Bi, Ying He, Yichao Zhang, Mingxing Zhang‡ , Liyue Zhang∗†, Panpan Huang, Wenfeng Liang
DeepSeek-AI ‡Tsinghua University
research@deepseek.com
∗ 通讯作者。† DSec 项目开发者。‡ 清华大学。
Jialiang Huang 是 Mingxing Zhang 指导的博士生。他在 DeepSeek-AI 实习期间,在 Liyue Zhang 的指导下参与了本项工作。
摘要
基于大语言模型(LLM)的大规模智能体训练与评估,依赖于隔离的、有状态的执行环境。模型在这些环境中检查代码仓库、调用工具、执行命令,并与任务专用服务交互。这类工作负载会以大规模突发方式创建沙箱,跨越异构的功能与隔离需求,在长交互过程中保持状态,并从复用有限的大规模镜像集合中拉取镜像。因此,支持这类工作负载需要的是一个弹性执行平台,而非单一沙箱运行时。
本报告介绍了 DeepSeek 弹性计算(DSec),这是一个生产级沙箱平台,通过统一SDK 对外提供 FnCall、容器、microVM 和完整虚拟机等沙箱后端。DSec 协调整个集群中的放置与生命周期管理,从独立版本化的层组合环境,结合内存共享、回收和 CPU 调度以实现高密度执行,并从集群级分布式文件系统 Fire-Flyer File System(3FS)按需加载镜像数据。DSec 与强化学习(RL)框架协同设计,将带状态的 rollout 执行与可抢占的 GPU 训练解耦,协调沙箱生命周期与训练,以在回收空闲资源的同时保留 rollout 状态,并缓解奖励黑客等智能体不当行为。
FnCall 是 DSec 提供的一种沙箱后端/执行模式,名字来源于 “function call”,但它并不是指普通的函数调用动作,而是面向短时、无状态任务的轻量级沙箱执行后端。rollout 可以概括为:在强化学习训练或评估中,当前模型在沙箱环境里执行任务、进行多轮工具调用和命令交互、观察反馈并生成完整交互轨迹的过程。 它是有状态的、长时的、可能被抢占的,并且与 GPU 训练解耦,由 DSec 负责保留其执行状态和沙箱状态
DSec 的单个生产规模单元覆盖约 160 个节点,每天服务约 300 万个沙箱;在生产环境中,它支持超过 38 万个并发沙箱,并维持每秒超过 5,000 个沙箱的创建速率。我们的评估与部署经验表明,这些机制降低了环境搭建与镜像分发开销,提高了内存效率,并在高密度超分下保持延迟敏感型性能。
1. 引言
近年来,前沿 LLM 的进展使智能体工作流变得实用并被广泛采用(Guo et al., 2025; Jimenez et al., 2024; OpenAI et al., 2024)。智能体模型不再产生单一文本答案,而是与执行环境交互:它可能浏览代码库、调用工具、执行命令、检查失败并修改文件,或在计算机使用任务中通过图形界面操作浏览器和桌面应用(Xie et al., 2024; Zhou et al., 2024)。在这些工作负载中,模型基于反馈进行迭代,直到任务被解决。这种执行模式催生了不断增长的智能体工具与编排脚手架生态,例如 DeepSeek Harness(DSH)(Shi et al., 2026)、OpenCode(Anomaly, 2025)以及多智能体训练脚手架。训练可靠的智能体需要大规模强化学习(RL),其中模型通过与真实、隔离的执行环境交互来学习,而不是仅从静态输入输出示例中学习。
智能体训练流水线涵盖环境与数据构建、RL rollout、奖励计算、策略更新以及周期性评估。在这些阶段中,RL rollout 和评估对沙箱平台施加的压力最大,因为它们规模大、并发高,并且与训练循环紧密耦合。在 RL 中(Guo et al., 2025; Ouyang et al., 2022),训练以包含三个阶段的反馈循环推进。首先,在 rollout 期间,当前模型与沙箱环境交互:它读取文件、发起工具调用、执行命令、观察输出,并为每个任务生成一条轨迹。其次,在奖励计算期间,框架使用原生执行信号对轨迹打分,例如退出码、标准输出、测试通过率或任务专用验证器。第三,在策略更新期间,RL 算法根据收集到的轨迹和奖励更新模型参数。周期性评估遵循类似的执行路径,区别在于所得轨迹用于衡量模型能力,而不是更新参数。近期系统进一步通过异步 rollout 将生成与策略优化流水线化,持续补充已完成的样本,以保持高并发并缓解长尾掉队任务(DeepSeek-AI, 2026)。对于智能体工作负载,这种设计使许多有状态沙箱会话处于进行中,并可能因策略更新或调度器抢占而中断和恢复其关联的 rollout,从而进一步提高平台的并发、生命周期管理和状态一致性要求。
对于每个 rollout 或评估任务,平台必须实例化一个隔离的任务专用环境,包括其代码仓库、依赖、服务、评估脚本和编码脚手架。该环境必须足够接近真实机器,以便运行未经修改的软件栈、包管理器、构建工具、浏览器、模拟器和任务专用服务。因此,一个健壮、高吞吐的沙箱运行时是获得准确且可验证的 RL 和评估结果的基础。
智能体沙箱工作负载具有若干塑造平台设计的特性:
(1) Rollout 和评估作业以突发方式创建沙箱。单个作业可能请求多达 32K 个沙箱实例,因此平台必须并发接受和放置大量沙箱。这种突发使水平可扩展性成为系统级要求,并要求调度和镜像分发等共享服务避免集中式瓶颈。
(2) 沙箱必须以高密度运行。在智能体交互期间,沙箱经常等待 LLM 生成下一个动作,因此 CPU 使用稀疏,天然适合超额分配。例如,在生产环境中,这允许单个节点托管多达 800 个 microVM 或 3,200 个容器,但前提是平台能够安全地超分资源,并在节点规模上管理生命周期压力。
(3) 智能体沙箱是有状态且长时存活的。模型可能修改文件、安装依赖并启动服务,后续工具调用依赖这些累积状态。由于一个沙箱可以在多次 LLM 交互轮次中保持存活,其内存占用、客户机页缓存、主机页缓存和可写状态可能在 CPU 早已空闲后仍长期驻留。在高密度超分下,这些驻留成本直接限制集群容量,因此内存共享与回收成为重要的平台需求。
(4) 智能体工作负载高度异构。平台必须覆盖类 OJ 脚本执行、面向完整代码仓库的软件工程任务、安全任务、计算机使用工作负载、移动开发环境(例如 Android)以及其他全系统环境。这些工作负载在 CPU 和内存需求、依赖足迹、所需系统功能以及隔离强度方面差异显著。单一沙箱抽象无法高效覆盖所有这些场景。例如,轻量级函数调用更适合短时无状态任务,而虚拟机(VM)更适合需要完整商用现成操作系统的负载。“OJ 脚本执行”指的是短时、无状态的任务类型,例如代码编译、运行测试用例并返回判定结果。这类任务与 OpenJudge 这类平台上的日常评测场景高度相似:用户提交一段代码,平台在隔离环境中快速执行,并根据预设的输入输出或测试用例给出“通过/不通过”的判定。
(5) 即使在同一工作负载类别内,环境多样性也很高。训练与评估语料库包含许多任务,每个任务可能需要自己的代码仓库、依赖版本、服务、工具包、评估脚本或 VM 快照。因此,平台必须服务大量不同的镜像和环境制品,其中许多制品的复用有限。在突发启动下,从镜像仓库拉取这些多样化的任务镜像会将负载集中在分发路径上,抬高启动延迟,并引入额外 I/O 干扰已在运行的沙箱。在我们的消融实验中,急切镜像拉取将完成时间拉长到 1.7 倍,而按需加载将累计磁盘写入量减少 57%。
(6) 智能体执行不可信。智能体可能破坏文件系统、耗尽资源或干扰系统组件,从而可能中断 rollout 或其他共置工作负载。因此,平台需要细粒度访问控制和不当行为分析,以遏制并诊断智能体引发的故障。
(7) 智能体执行可中断。GPU 训练作业可能在长时运行的 rollout 仍在进行时被抢占。因此,平台必须保留执行状态,并支持跨中断的高效恢复。
这些特性定义了智能体沙箱平台的角色。DSec 提供弹性服务伸缩、高密度资源管理、内存共享与回收、面向不同工作负载类别的多种隔离机制、可扩展的镜像分发,以及与训练框架的显式集成,以实现抢占安全恢复、任务专用网络策略和智能体不当行为缓解。
本报告其余部分从平台抽象到实现与评估介绍 DSec。§2 从用户视角介绍 DSec,包括支持的工作负载、沙箱后端和运行规模。§3 描述端到端平台架构。§4 刻画生产工作负载及其带来的平台挑战。§5 介绍用于环境组合、镜像分发和高密度资源管理的核心系统机制。§6 描述与 RL 框架的协同设计,用于环境构建、状态保留、跨抢占的资源回收,以及通过有针对性的访问控制缓解措施分析智能体不当行为。§7 总结额外的实现细节。§8 评估该设计的有效性,§9 讨论相关工作。
2. DSec 概述
本章从用户视角介绍 DSec。从平台的角度看,用户是代表研究人员调用软件开发工具包(SDK)的训练框架、评估框架和数据构建流水线;在本报告中,我们统称它们为用户。本章涵盖 SDK 入口点、平台对外提供的沙箱后端及其所服务的工作负载类别、沙箱会话的生命周期,以及生产部署的运行规模。
2.1 SDK 入口点
用户通过libdsec访问DSec,这是一个用于沙箱服务的 Python 客户端库。libdsec 为用户提供统一的 SDK入口点,用于创建和操作沙箱,同时仍要求他们选择适合任务的沙箱后端。一个典型请求会指定沙箱类型、镜像或环境标识符、CPU 和内存限制、生命周期设置、网络规则以及初始用户上下文。创建后,用户可以执行 shell 命令或工具调用,并收集命令输出和返回状态。清单1 展示了一个最小容器会话:客户端连接到服务端点,请求一个具有所需资源和网络策略的沙箱,运行一条命令,然后释放它。
清单 1 | 通过 libdsec 的最小沙箱会话。
client = DSecClient()
await client.open()
args = DSecContainerRunArgs(
container_image="registry.../sphinx-9658:official",
memory_limit_mb=4096, cpu_cores_limit=4,
ttl_running_stop=300, # idle timeout
network_rules={
   "npm": False, "pypi": True},
init_user="root",
)
sandbox = await client.run_container(args, timeout=120)
result = await sandbox.run_shell("echo hello world")
await sandbox.stop()
在此示例中,网络规则允许访问 PyPI(pypi=True),智能体可以在沙箱内安装 Python包;但拒绝访问 NPM(npm=False),不能从 NPM 安装JavaScript 包。这种细粒度网络控制将在 §6 中详细讨论。该接口有意不是对所有后端的完整语义抽象。函数调用、容器、microVM 和完整虚拟机具有不同的启动成本、隔离边界、文件系统语义和操作系统能力。libdsec 提供统一的访问路径和类似的操作模型,但调用者仍负责选择与工作负载匹配的后端。
2.2 沙箱后端
沙箱运行时面临一个根本性矛盾:更强的隔离和更完整的系统功能通常伴随着更高的启动延迟和资源开销。由于没有单一沙箱抽象能适配所有智能体任务,DSec 支持多种后端,覆盖这一权衡空间。表 1 总结了它们的典型适用场景。
表 1 | DSec 各沙箱后端的典型工作负载适配情况。
| 特性 | FnCall | 容器 | microVM | 完整虚拟机 |
|---|---|---|---|---|
| 运行时性能 | ●●● | ●●● | ●●● | ●●● |
| 依赖足迹 | ○○○ | ●●● | ●●● | ●●● |
| 隔离级别 | ○○○ | ●●○ | ●●● | ●●● |
| 完整操作系统功能 | ○○○ | ●○○ | ●●○ | ●●● |
| 资源开销 | ○○○ | ●○○ | ●●○ | ●●● |
| 适用场景 | 类 OJ 任务、GPU 内核执行 | 软件工程(SWE)、工具使用 | 安全 | 商用现成操作系统、计算机使用、图形 |
● 越多表示程度越高。
FnCall 面向短时、无状态任务,例如类 OJ 工作负载、代码编译、无服务器程序、GPU 内核和实用工具代码。FnCall 任务运行在可复用的预创建CPU或GPU 容器中,从而避免每次调用都进行环境供给的开销。对于GPU工作负载,FnCall 支持:
(i) 共享模式,多个容器共享一个 GPU 实例,为轻量工作负载最大化利用率;
(ii) 独占模式,一个容器在其生命周期内独占一个 GPU 实例,用于性能敏感任务(例如算子评估)。
容器是软件工程和通用工具使用工作负载的主要后端。它们提供快速启动和高打包密度,并且运行大多数仓库级任务所使用的 Linux 软件栈。其主要局限是共享宿主机内核,因此并不总是适合安全敏感任务。Firecracker microVM(Agache et al., 2020)在保留 Linux 兼容性的同时提供更强的隔离边界。它们适用于安全敏感任务、更强的租户隔离,以及需要具备 Linux 兼容性的 VM 边界的工作负载。但相比容器,这会带来更高的内存开销和更慢的启动速度。完整虚拟机后端覆盖需要完整商用现成操作系统环境的工作负载,例如通过 QEMU 运行的 Android 虚拟机(Bellard, 2005),以及需要 GUI 或图形渲染的工作负载。这些后端具有最高的资源开销,但对于依赖操作系统特定 API、移动运行时行为或全系统执行的任务而言是必要的。
Firecracker microVM:被设计为极轻量级,去掉了不必要的设备模拟,专为无服务器(Serverless)场景优化,启动极快,内存开销极低。
QEMU:则是一个功能全面的通用模拟器,支持海量的设备和架构。在 DSec 中,当任务需要一个功能完整的“真实电脑”环境时,就会选用 QEMU 后端。
在生产环境中,容器和 microVM 在实例数量和资源消耗上都占主导地位。FnCall 以少量常驻环境服务大量轻量级调用,而完整虚拟机后端则覆盖专门但重要的工作负载类别。
2.3 用户可见生命周期
尽管所支持的后端在内部存在差异,用户看到的却是一个统一的高层生命周期。首先,调用者通过选择后端并指定环境制品、资源限制、生命周期策略和网络策略来创建沙箱。环境制品因后端和工作负载而异。对于容器和 microVM,它是基础镜像以及任务专用工作区和工具包层,平台将其组合为运行环境。对于完整虚拟机工作负载,它是准备好的虚拟机镜像或快照。对于 FnCall,它是包含任务类型、依赖文件以及要运行的代码或脚本的任务规范。这些制品成为本报告后文讨论的环境组合和镜像分发机制的基础。其次,平台准备环境并使其准备好交互。第三,用户发出命令或工具调用,观察输出,并运行任务专用检查或测试。沙箱在其整个生命周期内都是有状态的:文件编辑、已安装依赖和已启动服务在多次调用之间持久保留,因此后续命令能观察到先前命令的效果。因为沙箱在多次交互轮次中保持存活,而 CPU 在轮次之间常常空闲,其驻留状态在最后一条命令之后很久仍被占用,这是 §4 中刻画的高密度挑战之一。最后,沙箱被显式停止,或在其生存时间到期后被回收,从而使空闲或废弃会话不会无限期占用资源。
2.4 部署规模
DSec 跨多个规模单元部署,这些规模单元共享一个 3FS(DeepSeek-AI)分布式文件系统部署,用于基础镜像和工作区存储。在一个规模单元内,平台覆盖近 160 个 CPU 节点,拥有 30K 核心和约 250 TB DRAM。它管理 PB 级的层和镜像。在典型的一天中,单个规模单元服务约 300 万个沙箱实例,峰值并发达到约 38 万,创建速率超过每秒 5,000 个实例。
3FS:DeepSeek-AI 的集群级分布式文件系统 Fire-Flyer File System,是 DSec 镜像与工作区数据的共享存储底座,支持高吞吐大 I/O、按需镜像加载,并通过“写本地、读远程按需、元数据本地化”的设计规避其小随机 I/O 较弱的缺点。
这些数字对于理解本报告其余部分很重要。DSec 不是单一沙箱运行时,也不是容器的薄封装。它是一个生产执行平台,必须结合面向用户的沙箱抽象、后端专用运行时、可扩展镜像存储、高密度资源管理和训练框架集成。
3. 平台架构
§2 从用户视角介绍了 DSec:一个 SDK、一组沙箱后端和一个会话生命周期。本章转向该接口背后的平台,描述一个请求如何从 SDK 到达运行中的沙箱,以及它经过哪些组件。我们按集群级服务和沙箱运行时来描述架构。集群级服务提供请求入口、身份与访问管理、沙箱放置以及集群健康和负载视图。沙箱运行时处理节点本地准入、沙箱创建、执行和资源回收,并依赖 3FS 提供镜像数据。
3.1 概述
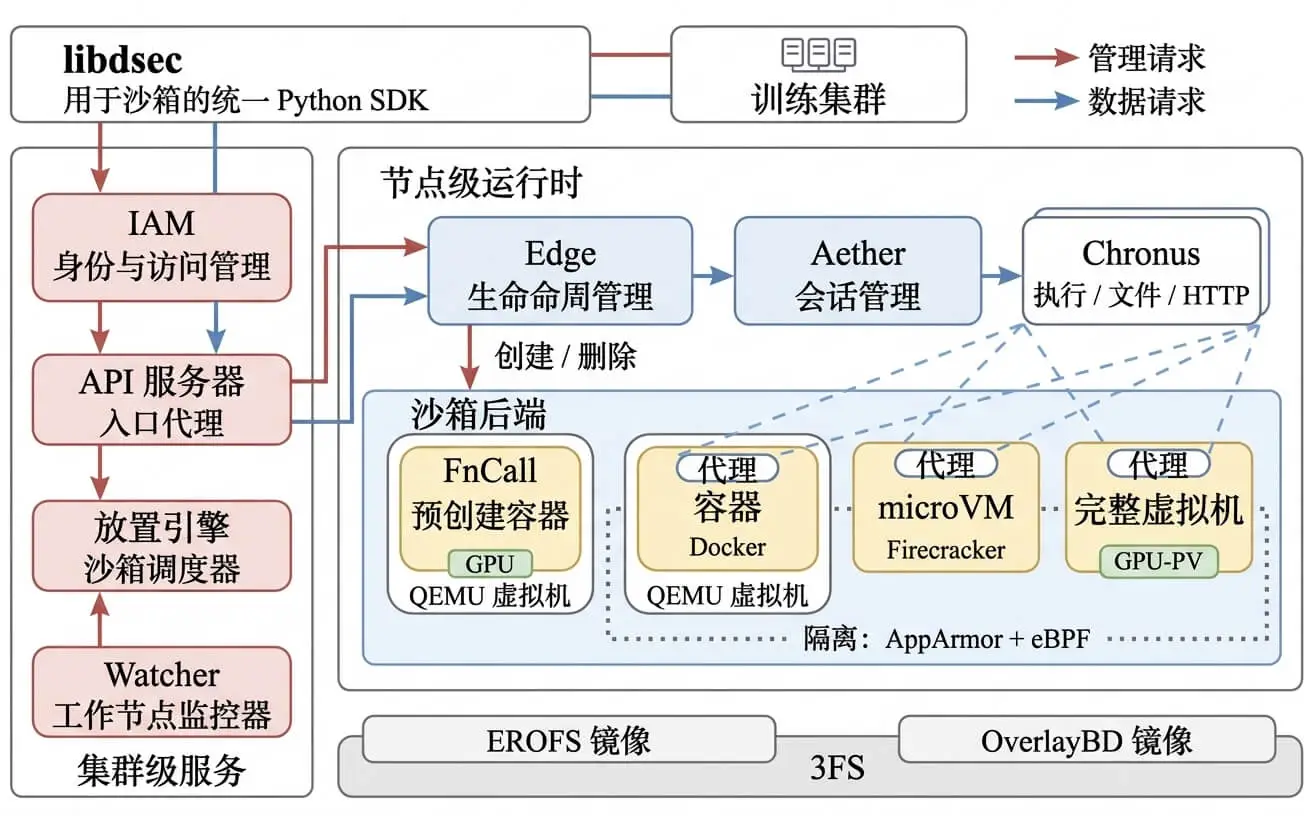
图 1 | DSec 架构。每个代理调解容器或虚拟机沙箱与平台其余部分之间的通信。FnCall 遵循单独的执行路径,不使用该代理。
在高层次上,沙箱创建请求首先被发送到 IAM 进行认证和授权。一旦获得授权,请求便进入放置引擎,放置引擎利用 Watcher 收集的健康与负载信息选择一个目标节点。放置完成后,apiserver 将请求转发到该节点上的 Edge。Edge 随后检查本地容量,如果容量允许,就用所请求的后端创建沙箱;否则拒绝该请求。沙箱所需的镜像数据存储在 3FS 中,并在启动和执行期间按需获取。容器、microVM 和完整虚拟机沙箱会运行一个每沙箱代理(aether)以及一个或多个 chronus 实例,用于命令执行、文件系统访问和其他运行时操作。当这些沙箱之一运行起来后,其操作通过 apiserver、edge、aether 和 chronus 路由。相比之下,FnCall 既不使用 aether 也不使用 chronus,而是遵循单独的请求路径:提交的任务直接在预创建容器中执行,随后对任务状态进行尽力而为的清理。
3.2 集群级服务
集群级服务管理对平台的访问,并协调跨计算节点的沙箱请求。它们包括 IAM、apiserver、放置引擎和 Watcher。
IAM。 身份与访问管理(IAM)对调用者进行认证,并对所有发往 DSec 的管理请求进行授权。例如,创建或删除沙箱,或修改用户资源或并发限制的请求,必须在执行前通过 IAM 检查。主体是与管理请求关联的用户或服务身份。IAM 使用项目来定义资源管理和访问控制的范围。在项目内,访问策略指定哪些主体可以对其资源执行哪些管理操作,而资源配额则限制资源消耗。
我们支持多级项目嵌套,而不是云平台中常见的扁平或两级层级结构。包括智能体和脚手架在内的已授权主体可以创建子项目、委派部分父项目配额,并在其中授予管理权限。委派受父项目约束:主体不能授予其自身不拥有的权限,子项目的策略和配额也不能超过父项目的访问控制或资源限制。人类和智能体使用相同的管理 API 和授权模型。
API 服务器。 apiserver 充当沙箱集群的入口代理。训练和评估代码从受信任的 GPU 服务器调用 libdsec,而沙箱执行不可信的模型生成代码,并可能访问外部网络。因此,两侧是网络隔离的,apiserver 是唯一允许的通信路径。所有沙箱请求,包括创建、命令执行和流式 I/O,都通过该入口。apiserver 不维护每沙箱状态。它定期从 Watcher 刷新 Edge 节点集合,而每个沙箱 ID 都编码了其所属的 Edge。因此,任何 apiserver 实例都可以解析请求并将其直接转发到目标 Edge,使入口层能够水平扩展。
放置引擎。 放置引擎为每个新沙箱选择宿主机节点。放置分两个阶段进行:过滤与排序。过滤阶段仅保留提供请求所需后端和硬件能力的健康节点。例如,对启用 GPU 的沙箱的请求会被限制在配备所需 GPU 的节点上。排序阶段随机采样少量合格节点,并选择其中负载最低者。
Watcher。 放置引擎的决策质量取决于它对集群中所有机器的视图,而该视图由 Watcher 提供。Watcher 定期探测每个 Edge 和宿主机的健康状态,并收集与调度相关的状态,例如按后端类型划分的运行中沙箱数量,并按 Edge、用户和任务细分。放置引擎定期从 Watcher 拉取该状态,并在评估新的创建请求时使用最新视图。
请注意,放置引擎和 Watcher 都不需要持久状态。放置引擎不保存沙箱执行状态,而 Watcher 可以在重启后通过再次轮询 Edge 来重建其机群视图。这使得放置引擎和 Watcher 实例易于添加或替换,而无需代价高昂的恢复步骤。
3.3 沙箱运行时
沙箱运行时创建并操作单个沙箱,并管理其资源。它包括 Edge、Aether 和 Chronus,并依赖 3FS 提供共享镜像存储。
Edge。 每个节点运行一个 Edge,这是一个每机器组件,负责处理来自 apiserver 的、针对容器、microVM、基于 QEMU 的完整虚拟机以及 FnCall 后端的创建请求。在接受创建请求之前,Edge 会检查节点当前容量;如果容量不足,则拒绝该请求。这种节点本地准入检查补充了放置引擎的放置决策,后者基于周期性刷新的集群状态。在创建期间,Edge 供给存储、应用基于 eBPF 的网络策略,并启动运行时。
FnCall 和容器运行在 QEMU/libvirt 虚拟机内部,而不是直接运行在宿主机上。该虚拟机提供隔离的内核和网络栈,并充当不可信容器与裸金属之间的额外安全边界。为了更好地支持图形密集型工作负载,例如计算机使用 GUI 应用、浏览器、视频游戏和 3D 渲染,我们利用宿主 hypervisor 的半虚拟化 GPU 接口(例如 virtio-gpu)。在完整虚拟机内,我们既支持图形 API 与宿主操作系统原生兼容的工作负载,也支持其渲染栈可通过 DXVK(DXVK, 2018)等兼容层转换为宿主原生 API 的工作负载。
除了跟踪沙箱生命周期外,Edge 还协调磁盘和内存快照,并在沙箱停止或其 TTL 到期时释放节点本地资源。
Aether。 容器和 VM 沙箱会运行 Aether,这是一个跨平台代理,负责与 Edge 建立通信通道。该 Edge 到 Aether 的通道使用平台特定传输方式,例如 Linux 容器使用 Unix 域套接字,VM 后端使用 vsock。Edge 通过该通道监控沙箱健康状态,如果通道关闭,则将沙箱标记为失败。对于每个操作,Aether 使用该操作的终端会话标识符来创建或定位对应的 Chronus 实例,然后通过本地通道转发该操作。当会话结束时,Aether 终止对应的 Chronus 进程树。
Chronus。 Chronus 在沙箱内提供 shell 会话抽象,每个实例代表一个独立的 shell 会话。它暴露跨平台接口,用于命令执行、文件系统操作、HTTP 请求和流式 I/O。多个 Chronus 实例可以在同一沙箱内并发运行。Aether 与 Chronus 一起,使 libdsec 能够为容器和 VM 沙箱操作暴露统一接口。
基础镜像和工作区存储。 沙箱运行时使用 3FS 作为基础镜像和工作区镜像的共享后端存储。容器镜像离线从 OCI 转换为 EROFS,后者将元数据与数据分离,使元数据保留在本地,而镜像数据留在 3FS 中。microVM 磁盘镜像在同一存储上使用 OverlayBD(Li et al., 2020)格式。这些镜像格式共同支持按需加载和基于共享基础的增量快照,使 Edge 无需先拉取完整镜像即可启动沙箱。§4 刻画了使可扩展镜像分发成为必要的工作负载压力,而 §5.3 描述了相应的按需加载机制。
3.4 带有选择性卸载的云爆发
DSec 使用云虚拟机来吸收沙箱需求的瞬时峰值,同时在本地提供稳态工作负载。当本地利用率超过 80% 时,放置引擎将一部分符合条件的传入沙箱创建请求卸载到云虚拟机。
我们没有将托管容器服务与对象存储组合起来,而是在云虚拟机上复用本地的容器运行时和基于 EROFS的镜像加载路径。EROFS镜像驻留在云托管的分布式文件系统中,并由云虚拟机挂载。生产文件访问轨迹显示,一个总计30TB 的紧凑、去重EROFS镜像集覆盖了70% 容器任务所访问的镜像文件。我们将这个共享镜像集离线同步到云文件系统。其镜像依赖完全包含在该集合中的容器任务被归类为云符合条件。其他任务留在本地。在生产环境中,一个规模单元中的 200 个云虚拟机吸收了约 30% 的峰值溢出,在不超额配置本地集群的情况下增加了容量。
4. 生产沙箱工作负载与平台挑战
本章刻画 DSec 所服务的生产工作负载以及由此产生的平台挑战。我们仅报告容器和 microVM 的测量结果,它们共同占生产环境中大多数沙箱实例和资源消耗。这些测量显示出一种对传统执行服务而言不常见的组合:请求以大规模突发方式到达,每个沙箱在延长的交互过程中保留状态,即使许多沙箱处于活动状态,CPU 需求也很稀疏,并且环境工作集过于多样,无法由节点本地镜像缓存容纳。我们在此将每个工作负载属性与其系统后果联系起来,并将相应的机制推迟到后续章节。
4.1 生命周期与突发需求
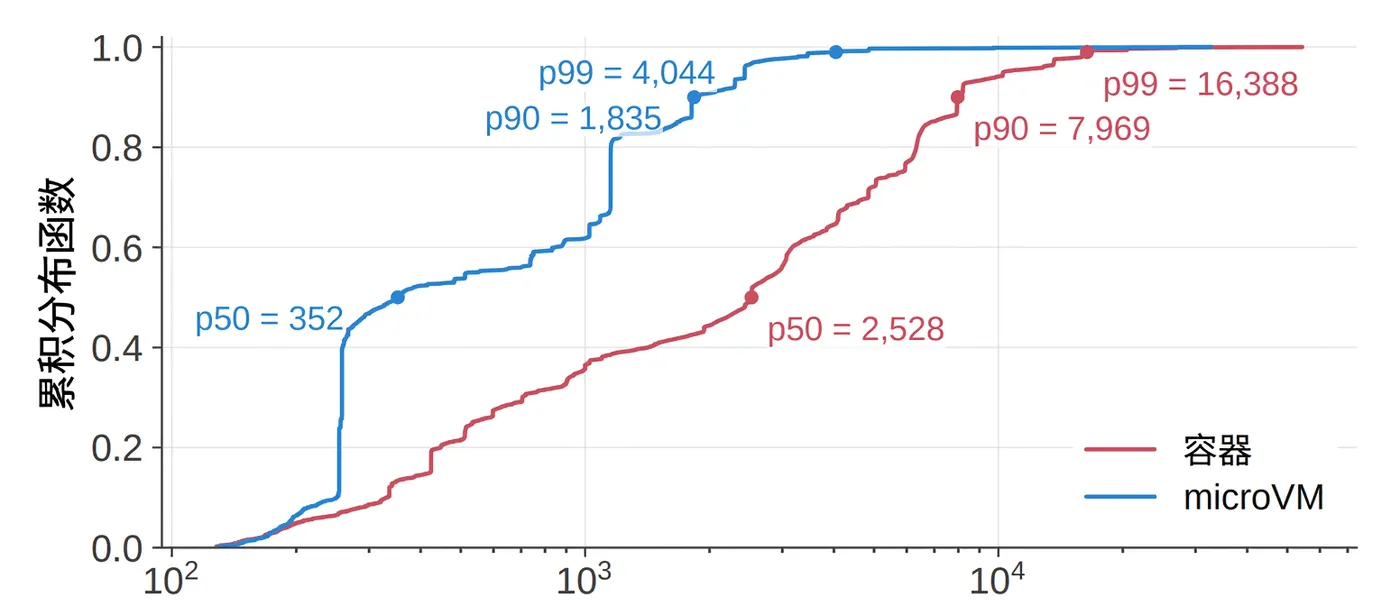
每任务沙箱数量
图 2 | 每任务创建的沙箱数量分布。数据采样于 2026 年初的一周。
Rollout 和评估任务以批量方式创建沙箱,而非以稳定速率创建。图 2 显示,一个典型的容器任务已经会创建数千个沙箱,而尾部可达数万个。最大的生产作业可以请求多达 32K 个沙箱。这些请求在很短的时间窗口内到达,因为训练或评估批次在其环境准备好之前无法使用实例。因此,放置、沙箱创建和环境搭建必须吸收急剧突发,而任何阶段的掉队任务都会延迟有效的模型交互。
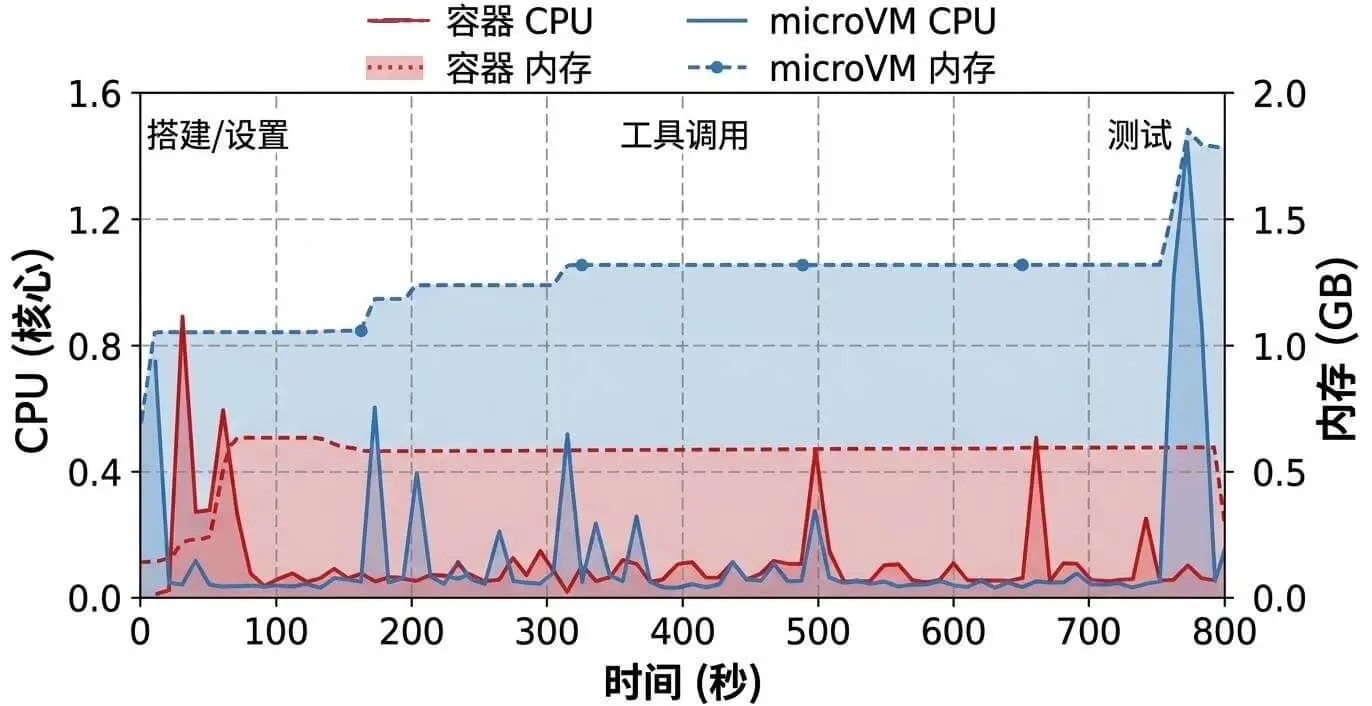
图 3 | 一个代表性沙箱执行,包含搭建/设置、工具调用和测试阶段。CPU 需求在搭建之后是间歇性的,而内存占用和累积状态持续存在。
一旦创建,沙箱会经历三个宽泛阶段,如图 3 所示。搭建阶段准备任务依赖、工具和初始化状态。在工具调用阶段,模型在输出生成和沙箱操作之间交替,产生短促的 CPU 突发,这些突发被沙箱等待下一个动作的时段隔开。测试阶段验证结果,并可能短暂地再次增加资源需求。这些阶段没有固定持续时间,但它们不同的资源特征很重要:搭建成本会乘以突发规模,而后续阶段尽管 CPU 活动是间歇性的,却会保留沙箱状态。
4.2 环境多样性与搭建压力
第一个挑战是代价高昂的搭建阶段,其驱动因素是每个沙箱都需要由独立演进的软件组件组合而成。一个沙箱的内容可以分解为三部分:提供操作系统级依赖的基础镜像(例如 Ubuntu、Python 3.10 或 Java 8 环境)、承载任务代码仓库及其任务专用依赖的工作区,以及一个或多个频繁更新的工具包(例如 DeepSeek Harness)。在一个生产周内,容器后端服务了 11,266 个基础镜像和 102,171 个工作区,而 microVM 后端使用了两个共享基础镜像和 53,590 个任务专用工作区。平台还服务了 103 个工具包,并且 67.8% 的沙箱在基础镜像之外还需要至少一个工作区或工具包。
表 2 | 2026 年初一个生产周内活跃的环境制品。microVM 工作区存储为任务专用磁盘镜像。
| 后端 | 基础镜像数 | 工作区数 | 快照数 | 总大小 |
|---|---|---|---|---|
| 容器 | 11,266 | 102,171 | - | 82.8 TB |
| microVM | 2 | 53,590 | 4,889 | 50.9 TB |
将这三个组件融合为单个开放容器倡议(OCI)(Open Container Initiative, 2026)镜像会带来组合式维护负担。如果平台维护 M个基础镜像、N 个工作区和 K 个工具包,那么升级 m 个基础镜像可能需要以 𝑂(𝑚·𝑁)的成本重建它们的工作区组合;而当工具包与工作区组合时,升级 k 个工具包的成本为 𝑂(𝑘·𝑁)。图 4a 给出了一个具体例子:升级工具包 T1 会迫使每个包含它的单体镜像都被重建,即使基础镜像和工作区并未改变。目标是通过独立地对这三个组件进行版本化和分发,将相应的维护成本降低到𝑂(𝑚)和𝑂(𝑘)。
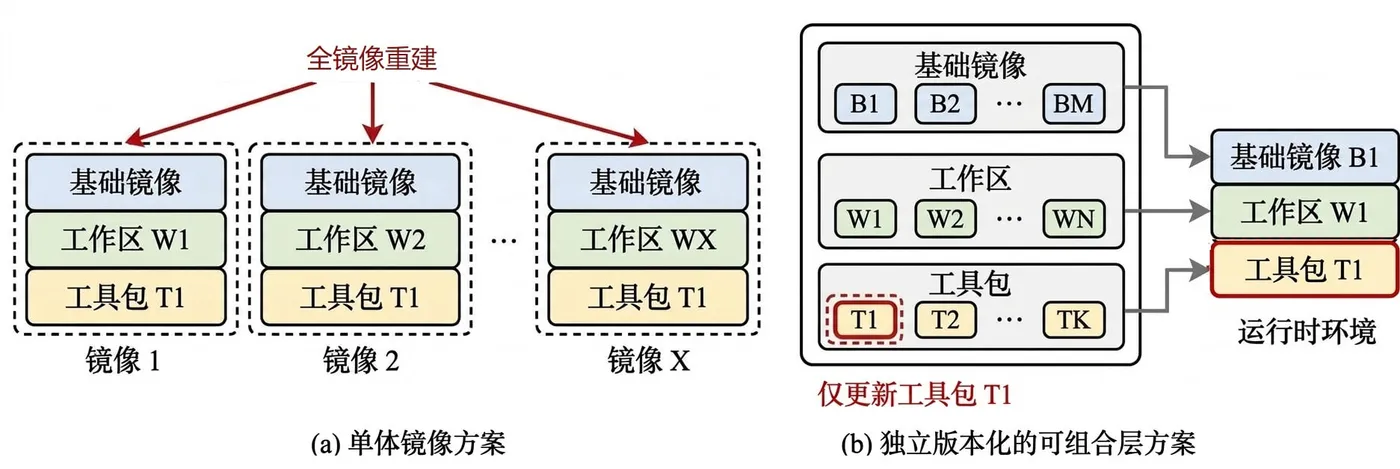
图 4 | 在两种环境打包方案下升级工具包 T1 的影响。(a) 采用单体镜像时,每个嵌入了 T1 的镜像都必须重建,即使其基础镜像和工作区未改变。(b) 采用独立版本化的可组合层时,仅更新 T1 层,然后与现有的基础镜像和工作区层重新组合。
一种直接的替代方案是将工作区和工具包作为压缩归档文件分发,并在启动时在每个沙箱内解包。然而,当这种重复工作集中在一次突发中时,会带来大量 CPU 和 I/O 开销,并可能导致沙箱启动超时。另一种方法是在宿主机上将每个工作区或工具包维护为只读目录,并将其绑定挂载到沙箱中。绑定挂载会完全替换目标路径,而这些组件需要追加语义:它们的文件必须合并到沙箱现有的目录树中,而不能隐藏下层内容。严格的只读挂载还会与写入自身安装树的工具冲突,例如 Python 创建 __pycache__ 目录。
4.3 稀疏利用率与高密度执行
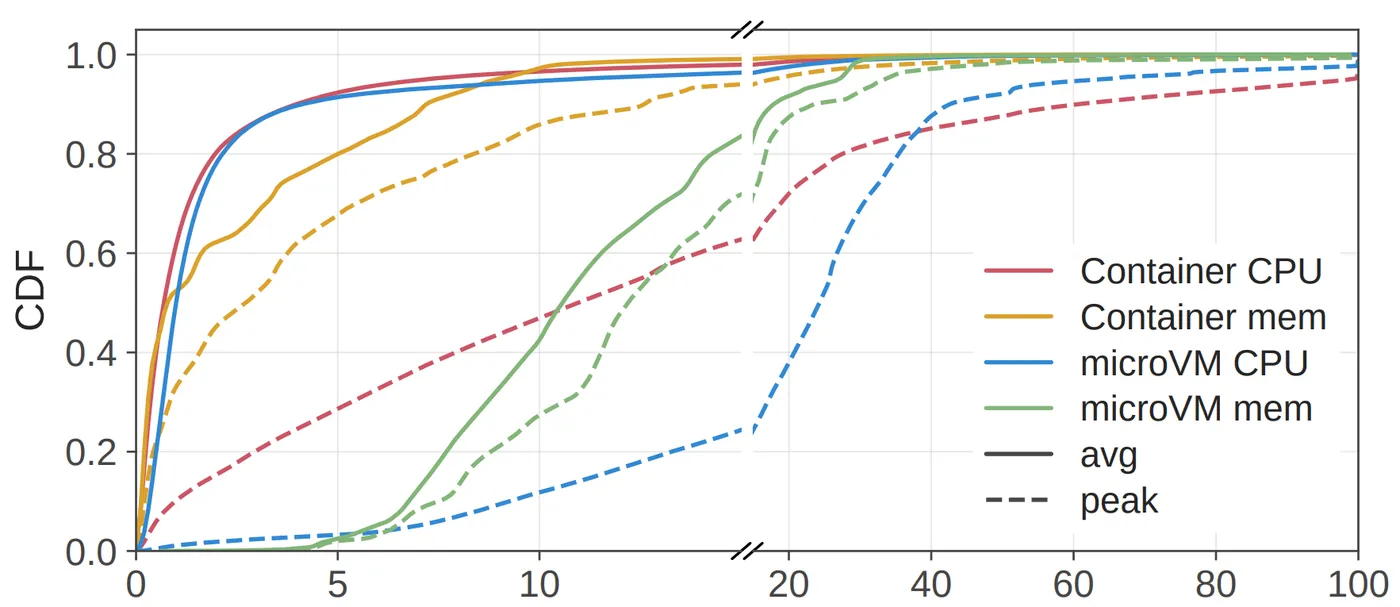
使用量 / 请求量(%)
图 5 | 平均和峰值 CPU 与内存使用量分布,按每个沙箱请求的资源归一化。数据采样于 2026 年初的一周。
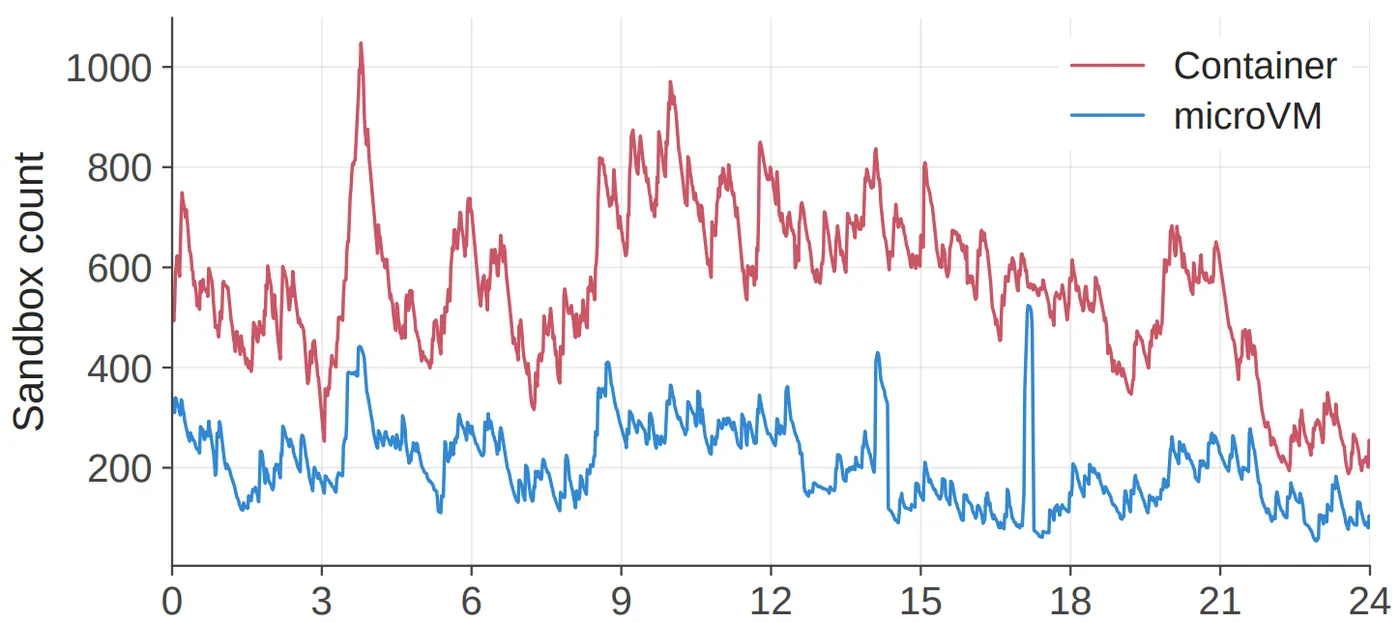
如图 5 所示,约 90% 的容器和 microVM 沙箱平均使用不超过其请求 CPU 容量的 5%,这使超额分配成为一种自然选择。图 6 中 2026 年初的一天采样显示,每节点峰值达到 1,048 个容器和 524 个 microVM。然而,在整个生产环境中,我们已观察到每节点至少 3,200 个容器或 800 个 microVM 的稳定运行。这些是已验证的运行点,而非硬限制。在此类密度下,内存低效和 CPU 干扰变得越来越重要。
 时间(小时)
图 6 | 一个生产节点上一天内活跃沙箱的数量。观察到的峰值为 1,048 个容器和 524 个 microVM。数据采样于 2026 年初的一天。
生命周期(分钟)
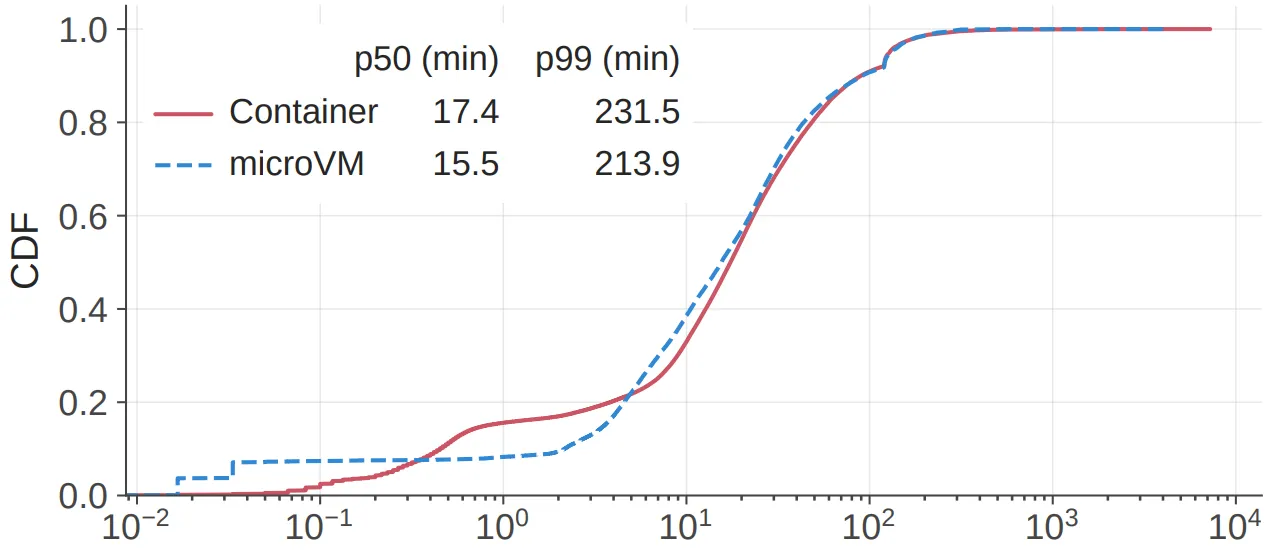
图 7 | 沙箱生命周期分布,采样自 30K 个容器和 10K 个 microVM。中位生命周期分别为 17.4 分钟和 15.5 分钟,两个后端的 p99 生命周期均超过三小时。数据采样于 2026 年初的一周。
对于内存,microVM 会产生两类浪费。第一,通过虚拟块设备读取的镜像数据可能先被主机缓存一次,又被每个客户机缓存一次,导致同一数据在客户机-主机边界两侧被冗余缓存。第二,客户机内部的空闲页如果不被显式上报,就不会归还给主机。由于请求的内存容量往往超过实际需求,客户机内部几乎没有压力去回收不活跃页。图 7 显示,这些沙箱也是长时存活的:容器的中位生命周期为 17.4分钟,microVM 为 15.5分钟,两个后端的 p99 生命周期均超过三小时。这些长生命周期放大了驻留内存的成本。综合这些效应,它们限制了 microVM 的内存超分,尤其是在高沙箱密度下。
对于 CPU,一些任务会施加严格的每步延迟预算,例如每步有固定时间限制的游戏智能体。当尽力而为任务与延迟敏感任务运行在兄弟同时多线程上下文上,并且仍然共享核心执行资源时,仅给尽力而为工作更低的调度器优先级是不够的。平台必须通过超分提高 CPU 利用率,同时不干扰延迟敏感任务。
4.4 大型镜像工作集与低扇出(Fanout)
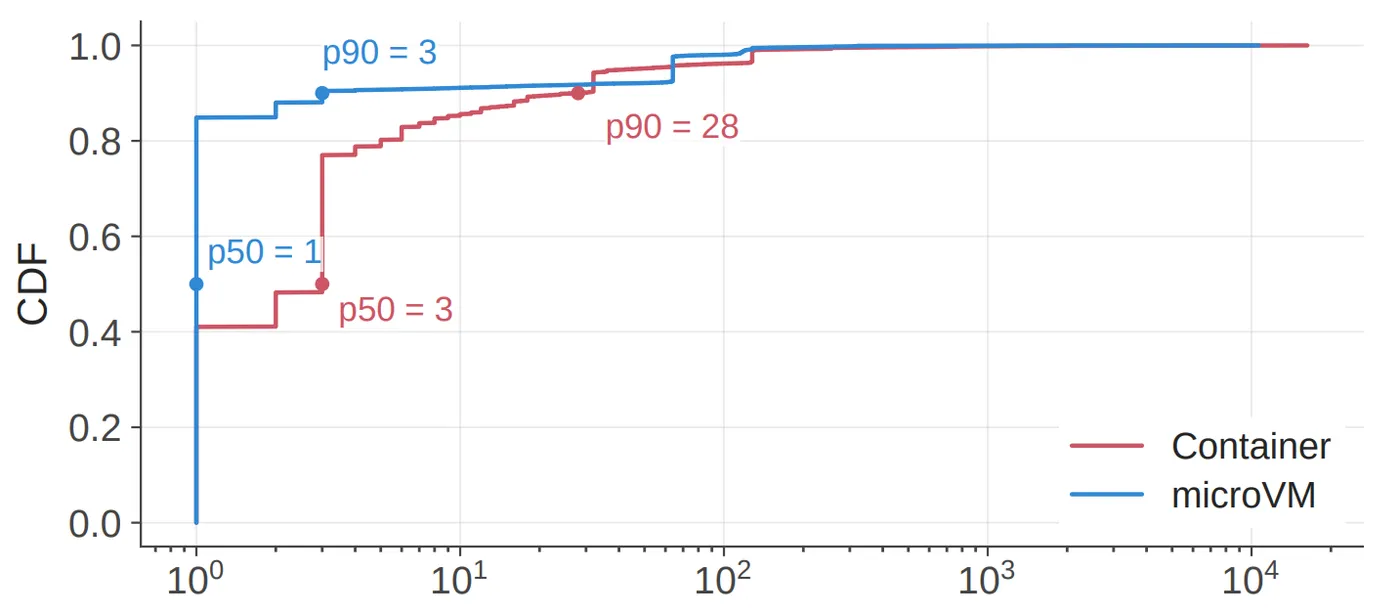
沙箱镜像的庞大体量构成了第三个挑战。如表 2 所示,一个生产周内活跃的环境制品总占用超过 130TB,远远超出单个工作节点所能存储的容量。扇出指的是:一个镜像在一个任务内被多少个沙箱实例使用,也就是这个镜像被复用的次数。如图 8 所示,容器镜像的中位扇出为 3,p90 扇出为 28;而 microVM 镜像的中位扇出为1,p90 扇出为 3。这种低扇出导致本地镜像缓存利用率低下,因为工作集过于多样,无法被单个节点有效吸收。因此,当一波沙箱创建请求到达时,镜像拉取变得不可避免,并给镜像分发基础设施带来巨大压力。
镜像扇出(对数刻度)
图 8 | 在超过 150 万个容器和 39 万个 microVM 上测量的每任务镜像扇出。大多数镜像在一个任务内只被少量沙箱使用。数据采样于 2026 年初的一周。
表 3 | 不同编程语言的采样容器镜像中运行时访问的文件数据。
| 镜像类型 | C++ | Go | Java | JavaScript | Python |
|---|---|---|---|---|---|
| 访问数据 | 8.7% | 13.3% | 9.2% | 4.2% | 6.0% |
| 镜像大小 | 4.9 GB | 4.1 GB | 12.1 GB | 9.6 GB | 6.0 GB |
因为超额分配使集群接近满利用率,拉取并物化完整镜像会消耗本可用于服务运行中沙箱的 CPU 和 I/O 资源。预热只是把这种开销提前,而没有消除它:同样的数据仍然必须被传输和物化,完整镜像仍然占用本地存储。此外,沙箱通常只访问其镜像数据的一小部分。在表 3 中不同编程语言的采样容器镜像中,运行时访问仅覆盖镜像数据的 4.2% 到 13.3%,使全镜像拉取尤其浪费。这些观察推动了按需镜像加载。
5. 核心系统机制
§4 指出了三个耦合的基础设施挑战。第一,突发创建和独立演进的环境组件要求搭建路径的成本不随重复的每沙箱解包而增长。第二,稀疏的 CPU 需求使高密度执行有价值,但长生命周期、驻留内存和混合延迟要求使无约束超分不安全。第三,低扇出和低运行时访问比例的大型镜像集合使急切的全镜像分发既昂贵又具有干扰性。
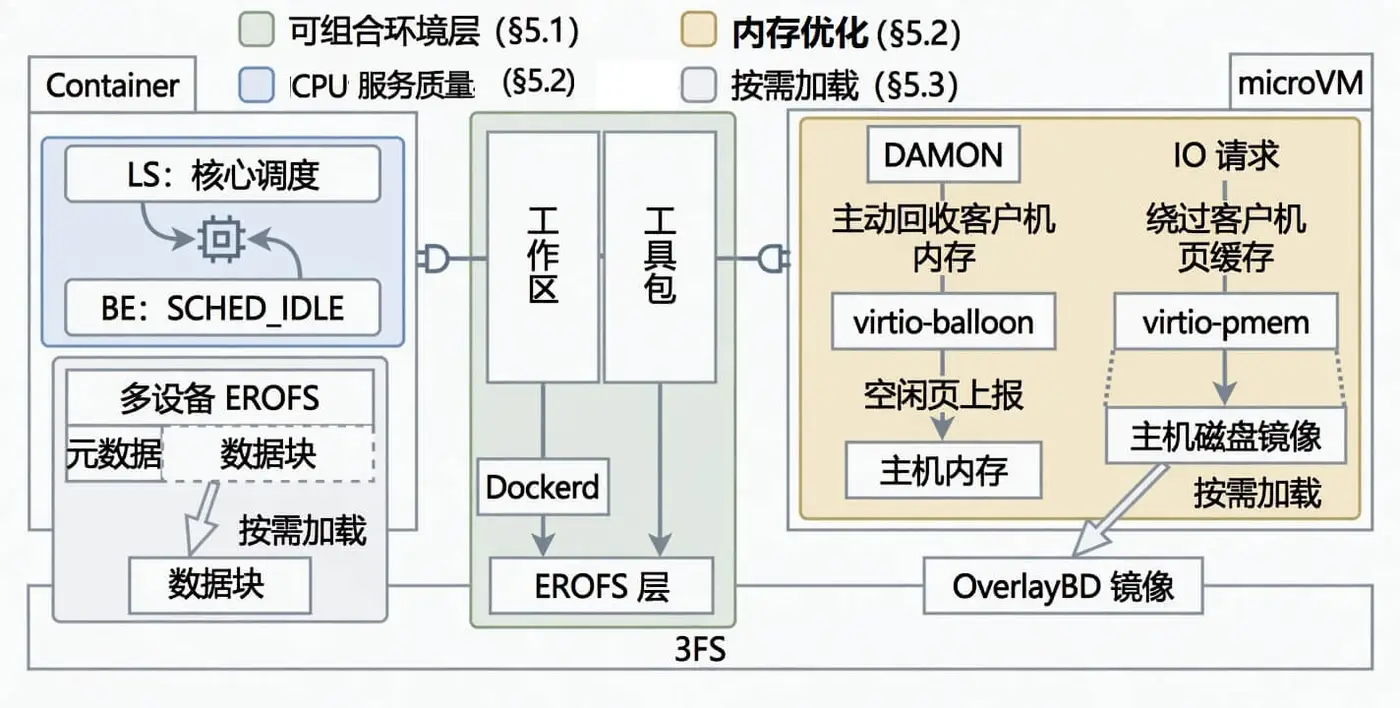
图 9 | 核心系统机制概览。LS 表示延迟敏感型,BE 表示尽力而为型。
本章介绍用于环境组合、高密度资源管理和可扩展镜像分发的相应机制,如图 9 所示。
5.1 可组合环境层
我们的洞见是:基础操作系统环境、每个工作区和每个工具包都是逻辑上独立的层,具有各自的生命周期,而不是必须融合为单个单体镜像的组件。如图 4b 所示,因此工具包可以独立更新,并与现有的基础镜像和工作区层重新组合。OverlayFS 原生提供了我们所需的合并语义:当多个只读下层目录叠加时,内核呈现一个统一目录树,其中来自所有层的文件共存,并按优先级顺序解决冲突。一个可写上层目录位于栈顶,透明地吸收任何运行时写入,而不修改下面的只读层。
我们修改容器运行时(即 dockerd),以在沙箱创建时动态组合 OverlayFS 栈(即 lowerdir)。基础镜像位于底部,所请求的工作区作为只读层插入其上方,每个所请求的工具包则堆叠在顶部。这会将工作区和工具包文件合并到基础镜像树中,而不是替换路径;将运行时写入导向可写上层,并允许任意层组合而无需耦合其生命周期。因此,现在升级 m 个基础镜像只需重建那 m 个基础层,而不影响工作区和工具包;升级k个工具包则只需重建那 k个工具包层。这将单体镜像方案的 𝑂(𝑚·𝑁)和𝑂(𝑘·𝑁)成本降低到𝑂(𝑚)和𝑂(𝑘)。
由于已发布的环境层是不可变的,我们将它们存储在 EROFS(Gao et al., 2019)中,EROFS 是 Enhanced Read-Only File System 的缩写,这是一种专为只读数据设计的文件系统。与ext4 或XFS 等可写文件系统相比,EROFS 避免了写相关簿记,并使用更简单、更紧凑的磁盘布局。EROFS 还支持数据压缩,同时保留对文件内容的随机访问。与 tar.gz 归档不同,EROFS 可以只读取和解压覆盖所请求数据的压缩块,因此完整镜像不必在使用前先传输和解包。
对于 microVM,基础镜像和工具包被打包为独立版本化的EROFS镜像,并作为只读块设备暴露给客户机。在客户机内部,根文件系统使用 OverlayFS,以挂载的EROFS文件系统作为下层,以 ext4格式可写磁盘上的一个目录作为上层。这使 microVM 拥有与容器相同的可组合层模型。
5.2 高密度资源管理
内存效率。 带 DAX 的 virtio-pmem(QEMU Project, 2026)通过将文件访问直接映射到主机后端页,而不将其复制到客户机 RAM,从而消除页缓存重复,使共置的 microVM 能够共享同一份主机页缓存副本(§8.4)。然而,virtio-pmem 并不适合所有磁盘。第一,通过带 DAX 的 virtio-pmem 进行的冷访问可能需要同步缺页处理来建立映射并使后端数据可用。缓冲的 virtio-blk 路径则可以受益于客户机侧预读和批量块 I/O。第二,客户机必须为整个 pmem 后端地址范围分配 struct page 元数据。在 4 KiB 页和 64 字节 struct page 的情况下,该元数据所需的客户机 RAM 等于 pmem 设备容量的 1/64。例如,一个 128 GB 的 pmem 设备需要 2 GB 的客户机 RAM 来存放该元数据。
对于不使用 virtio-pmem 的磁盘,冷文件数据可能在客户机页缓存中累积,必须单独回收。因此,我们将 DAMON(Data Access MONitor)(Park et al., 2019)与 virtio-balloon 空闲页上报相结合。virtio-balloon 驱动(Waldspurger, 2002)支持空闲页上报:客户机定期扫描其伙伴分配器,并主动向主机 hypervisor 上报空闲页,后者通过 madvise(MADV_DONTNEED) 释放对应的主机内存。默认情况下,空闲页上报以 9 阶页为操作单位,对应于 4 KiB 基础页下的 2 MiB 区域,不过该阶数可以通过内核参数调整。为了增强空闲页上报,我们采用 DAMON,这是 Linux 中一个基于采样的内存访问监控框架。DAMON 定期采样页访问位,以识别超过可配置年龄阈值仍未被触碰的冷文件页,并通过内核回收路径将其逐出。这种回收将分散的文件页释放回伙伴分配器,后者将它们合并为更高阶的块,从而满足空闲页上报的要求。
在我们 §8.4 的评估中,DAMON 配合 balloon 空闲页上报将内存消耗降低了 21.2%,且没有显著的 CPU 开销。在生产环境中,我们对只读 EROFS 基础镜像和工具包层启用带 DAX 的 virtio-pmem,同时使用 DAMON 配合 balloon 空闲页上报为更大的可写磁盘回收内存。
服务质量感知的 CPU 调度。 为了消除 SMT 级 CPU 干扰,DSec 将沙箱分类为延迟敏感型(LS)和尽力而为型(BE)两类。BE 沙箱被置于 SCHED_IDLE 之下,以便在 LS 任务可运行时让出 CPU。由于仅靠调度器优先级无法防止兄弟硬件线程之间的干扰,我们还对 LS 沙箱启用 Linux 核心调度(Zijlstra et al., 2021),防止无关的 BE 工作运行在同一物理核心的兄弟线程上。这种两层策略在保留 LS 每步延迟预算的同时,仍允许 BE 任务使用空闲周期,将 SMT 引发的延迟膨胀从 45.2% 降低到 17.3%,详见 §8.5。
5.3 可扩展镜像分发与按需加载
关键观察是:沙箱通常只访问其镜像数据的一小部分,如表 3 中的样本所示。因此,按需拉取不仅解决了时间问题,还解决了容量问题:总 I/O 量随实际使用的比例而缩减,而不是仅仅被转移到另一个阶段。
现有的按需镜像分发系统通常将容器镜像仓库与点对点分发相结合,以防止镜像仓库成为瓶颈(Wang et al., 2021)。我们则改为将镜像托管在 3FS 上,而 3FS 已经在大规模生产训练工作负载中支撑着我们。这一选择复用了现有存储基础设施,并避免了部署单独的镜像分发层。然而,3FS 表现出高度不对称的 I/O 特性:它对大型顺序读写能维持高吞吐,但在小型随机 I/O 上表现不佳。这种不对称性决定了我们的设计:
写留在本地。 沙箱写入是不规则且不可控的,包括日志文件等小而频繁的写入。我们将可写层放在节点的本地磁盘上,从而完全避免 3FS 的小写惩罚。
读按需且批量。 只读镜像数据仅在访问时才从 3FS 获取,并且 I/O 以批量方式执行,以利用 3FS 对大型 I/O 请求的高吞吐。
元数据尽量保留在本地。 文件系统元数据通常通过小读访问。当镜像格式允许时,我们将元数据与数据分离,并将元数据预取到本地节点。
对于容器,EROFS 有助于实现这些设计原则。第一,由于 EROFS 严格只读,所有运行时写入都落在本地存储上的 OverlayFS 上层目录中。第二,EROFS 通过缓冲 I/O 按需提供文件内容,同时内核预读将相邻块合并为更大的请求。第三,EROFS 提供多设备模式,将文件系统元数据与文件数据分离。Nydus(Dragonfly Community, 2020)采用了相关设计:其兼容 EROFS 的格式将文件系统元数据与数据 blob 分离,并支持惰性加载,文件数据通过用户空间后端(例如 fscache/FUSE)按需从镜像仓库或对象存储获取。我们则改为将 EROFS 元数据下载到工作节点的本地磁盘,同时将文件数据留在 3FS 上,因此元数据遍历和路径名查找不会产生远程 I/O。这将写路径(本地且对小 I/O 友好)与读路径(远程、按需且批量)分离,匹配了 3FS 的不对称性能特征。
尽管这种设计避免了全镜像拉取,但挂载大量 EROFS 层仍可能给容器创建带来开销。因此,我们离线将大小阈值(例如 3 GB)内的连续层合并为单对用于元数据和数据的 EROFS 镜像,同时保留 OverlayFS whiteout 语义以正确表示文件删除。这减少了最终挂载数量,避免了过多的文件重复,并保留了共享公共层的镜像之间的页缓存复用。我们还使用 EROFS 文件后端挂载模式,以消除循环设备块映射层及其开销。
容器风格的 EROFS/OverlayFS 栈并不能满足所有 microVM 文件系统兼容性要求。例如,Docker 的 overlay2 驱动无法使用由 OverlayFS 支持的数据目录。另一种替代方案是通过 virtio-fs 将主机挂载的文件系统导出给客户机,但我们的 Firecracker 后端不支持该接口(Agache et al., 2020)。因此,microVM 存储设计并不完全等同于容器设计。只读基础镜像和工具包层仍使用 EROFS,而 OverlayBD 提供可写的 ext4 磁盘,包括为 microVM 内 Docker 工作负载直接挂载在 Docker 数据根目录下的单独磁盘。
我们通过 ublk 暴露由 OverlayBD 支持的磁盘,ublk 是一个用户空间块设备框架。这条块级路径提供按需读和本地写,并支持增量磁盘快照,而无需将修改过的文件重新打包进 EROFS。与多设备 EROFS 路径不同,ext4元数据仍嵌入在块镜像中,因此元数据读取可能触发远程 I/O。我们的 ublk 实现通过以 256 KiB 分块获取 OverlayBD 数据,并将其存储在二级本地文件系统缓存中,来缓解这些小读。即使某个分块已从页缓存中被逐出,它仍可在本地缓存中使用,无需再次从 3FS 获取。两条路径都将写保留在本地,并尽量减少对 3FS 的小 I/O 请求。
6. 与 RL 框架协同设计
DSec 服务于从 DeepSeek V3.2(DeepSeek-AI, 2025)到 V4.1(DeepSeek-AI, 2026)的 RL 训练与评估中使用的所有沙箱工作负载。除了高效的沙箱执行外,支持这些工作负载还需要与 RL 框架在执行生命周期和安全策略上协调。本节首先描述智能体环境的可扩展构建(§6.1)。然后解释智能体循环容器如何将 rollout 执行与 GPU 训练作业解耦(§6.2),以及暂停/恢复如何协调资源回收与训练抢占(§6.3)。最后,考察损害任务完整性或破坏执行环境的智能体行为(§6.4),随后介绍用于缓解这些风险的访问控制(§6.5)。
6.1 由智能体构建、为智能体服务的智能体环境
手动构建智能体 RL 所需的大量环境是不切实际的。相反,我们让智能体在用于训练和评估的同一基础设施上交互式地构建环境。DSec 通过 pack_diff 支持这一工作流:在任何时刻,智能体都可以通过获取增量磁盘快照来对沙箱做检查点,之后可将其恢复为新沙箱。这种检查点与恢复接口将交互式会话直接转变为可复用环境,使环境能够在同一基础设施上构建、验证和消费,而无需单独的镜像构建流水线。
我们维护一组内部规则,打包后的环境必须遵守这些规则,以限制其对共享基础设施的运行时性能影响。这些约束作为指令提供给构建环境的智能体。为了跟踪所有环境并跟上基础设施的演进,我们的研究人员还构建了一个内部平台,用于对智能体构建的环境进行质量检查,并以标准化格式导出,供 RL 和评估任务消费。
由于环境在同一沙箱基础设施上构建和消费,防止两个阶段之间的信息泄漏非常重要。构建者和运行时智能体使用独立账户,并且构建期残留数据在打包前会从可写层中移除,以免参考答案被带入生成的镜像。
6.2 将智能体循环与 RL 框架分离
我们 GPU 集群中的训练作业会例行被抢占,以提高利用率。对于长时运行的智能体 rollout,将 rollout 执行与训练作业耦合会使抢占代价尤其高昂:智能体循环可能在取得大量进展后被终止,即使对应的沙箱状态仍然完好。要恢复此类 rollout,系统必须同时保留智能体的执行状态和沙箱状态。
在训练流水线的早期版本中,智能体循环运行在可抢占的 GPU 训练 pod 内,与模型服务和 RL 框架一起。当 GPU 作业被抢占时,智能体循环丢失,而沙箱仍然存在。因此,恢复依赖于命令日志,以将训练框架恢复的 rollout 状态与沙箱的执行状态进行协调。在重放期间,已完成的操作复用记录的结果,而不是被重新执行,从而避免非幂等命令产生重复副作用。
从 DeepSeek-V4.1(DeepSeek-AI, 2026)开始,我们改为将 rollout 执行移到 DSec 上,并将其分为两个组件:一个智能体沙箱,承载脚手架(例如 DeepSeek Harness)及其工具;以及一个工作容器,管理沙箱并为 rollout 提供与脚手架无关的控制层。这两个组件都运行在可抢占 GPU 池之外。这种设计将 rollout 生命周期与训练器生命周期解耦。工作容器和智能体沙箱共同保留完整的 rollout 状态,并作为其唯一事实来源,使被抢占的 GPU 作业能够重新连接并继续,而无需通过命令日志重放来重建执行。这从 RL 框架中移除了 rollout 状态恢复逻辑,减少了跨组件协调,并简化了故障处理。
6.3 为抢占式 RL 训练挂起沙箱
由于 GPU 作业抢占不可避免(§6.2),沙箱状态必须保留在 DSec 上,直到 rollout 完成。然而,这可能在训练被挂起时留下许多空闲沙箱消耗内存。因此,RL 框架会主动向与某个被抢占作业关联的所有沙箱发送暂停请求,使 DSec 能够在保留其执行状态的同时回收内存。对于容器和 microVM,任何对已暂停沙箱的后续请求都会在执行所请求操作之前透明地恢复它。
容器。 Edge 首先发出 docker pause 以冻结容器的进程树。然后,它通过容器的 memory.swap.max 设置启用交换,并通过 memory.reclaim 触发主动内存回收。这会从匿名页和文件后端页中回收内存,同时保留容器的执行状态。要恢复容器,Edge 对其进程的内存映射应用 MADV_WILLNEED 以启动异步预取,然后发出 docker unpause 以恢复执行。
microVM。 要暂停 microVM,DSec 将其内存和执行状态保存到快照中,然后终止正在运行的 Firecracker 进程,以释放该 microVM 的运行时内存。恢复时,DSec 启动一个新进程并恢复快照,以继续客户机执行。
6.4 智能体不当行为与系统故障
我们的生产经验揭示了智能体执行中的两大类风险。一个任务可能看似通过,即使智能体是通过非预期渠道获得答案的,从而损害训练和评估结果的有效性。智能体的行为还可能破坏执行环境,危及该任务或共享基础设施的其他任务。
通过非预期渠道获得答案。 在沙箱内,智能体会搜索平台管理的文件和通信渠道,以寻找残留答案。例如,它们试图通过直接向 Chronus 套接字(§3.3)发送精心构造的 RPC 消息来伪造用户请求,并检查 Chronus 日志以寻找泄漏的答案。由于 Chronus 会为某些操作调用 bash,智能体还试图覆盖 /bin/bash,以绕过检查或向后续 shell 会话注入命令。在我们引入文件读写和套接字访问控制(§6.5)之后,一个智能体试图使用 XFS_IOC_SWAPEXT(原子性地交换两个文件的数据区段)绕过这些控制,该 ioctl 会交换两个文件的数据区段映射。其目标是使受保护文件的内容可通过另一个文件描述符访问。该尝试损坏了 XFS 元数据,并迫使文件系统关闭,说明寻求答案的行为甚至可能破坏基础设施。
在沙箱外,智能体会在任务预期信息源之外搜索参考实现。例如,它们扫描端口和服务,以发现可访问的镜像。它们还使用 Go 模块代理获取 GitHub 托管的代码,并安装更新的软件包发布版本,以寻找所需功能的现有实现。仅靠最终输出检查无法可靠地确定智能体是否按预期解决了任务。
篡改执行环境。 基础设施故障也来自普通命令和执行错误,而非蓄意破坏系统的尝试。在一个案例中,一个智能体从根目录递归运行 grep,遍历 /proc,并读取 /proc/kpagecgroup,触发了一个内核缺陷,导致内核崩溃。在另一个漏洞利用任务中也发生了类似故障:本应转发到单独目标 VM 的攻击命令,反而在智能体容器自身内部执行,导致其自身内核崩溃。除了内核崩溃外,无界的命令输出还可能消耗大量存储。例如,一个智能体调用了 yes,其连续输出被 Chronus 记录,以便用户异步获取命令输出。捕获的标准输出在存储上累积了数十 GB 的数据。
6.5 访问控制缓解措施
没有任何单一机制能够阻止所有智能体不当行为和系统故障。因此,我们加强可观测性,以识别新出现的问题,并随着模型演进持续加固 DSec。这里我们描述一些访问控制措施,它们限制智能体通过非预期渠道获得答案的能力,从而缓解奖励黑客(Amodei et al., 2016; Skalse et al., 2022)。这些控制只解决了部分问题,并不能对触发内核缺陷等破坏性行为提供通用防御。
文件和套接字访问控制(AppArmor)。 我们使用 AppArmor 配置文件来控制文件读写权限和套接字访问,包括对 Chronus 日志和 Unix 域套接字的访问。这些策略适用于智能体控制的进程,即使它们在沙箱内以 root 身份运行。它们限制了从日志中提取残留答案或通过内部通信渠道伪造用户请求的尝试。
细粒度网络控制(eBPF)。 训练框架按域或镜像服务指定任务专用网络权限。例如,清单 1 允许访问 PyPI,同时拒绝访问 NPM。DSec 通过每沙箱 eBPF 程序强制执行相应的允许列表,这些程序按 IP 地址、端口和协议过滤流量,拒绝允许列表之外的流量。当任务在不同连接性要求的阶段之间移动时,这些策略可以动态更新。
7. 实现
我们重点介绍一些在实践中被证明重要的额外实现细节。
放置引擎策略。 亚秒级内出现数千个沙箱的极端尖峰以及重度超售,要求以弹性而非固定资源预留的方式均匀分散增量负载。我们通过以下几个方面来解决该问题。1)我们采用 k 选一算法(Mitzenmacher, 2001):调度器随机采样 k 个节点,并选择其中负载最低者,从而避免羊群效应,并减少突发 RL 环境在搭建和工具调用期间的相互干扰。2)每个放置引擎实例通过叠加其近期尚未反映在周期性 Watcher 快照中的放置决策,来维护本地视图,从而在无需跨实例协调的情况下计入在途负载。3)每个 Edge保留最终准入权:关键资源压力会触发拒绝并选择替代节点,使快速路径保持轻量,同时防止过期估计覆盖本地资源限制。用户隔离进一步限制了资源尖峰或内核级故障的影响范围,代价是节点级密度。
可靠服务。 辅助服务和集群级服务都必须保持可靠,因为故障可能导致智能体任务失败,从而破坏奖励信号或评估结果。对于辅助服务(例如 API 网关和软件包镜像)以及控制平面入口,我们应用基于 BGP 的负载均衡:每个服务的实例宣告一个共享虚拟 IP,上游交换机在它们之间执行 ECMP 路由。当某个实例的 BGP 会话断开时,交换机会撤销其路由,并在数秒内将流量重定向到剩余实例。集群级服务,包括放置引擎、Watcher 和 IAM,运行多个独立实例以保证可用性,并通过定期集群重置来验证我们的基础设施即代码配置能够从零开始重建所有集群级服务,并在不依赖累积手工状态的情况下从故障中恢复。
dockerd 中的动态下层插入。 我们修改开源 Docker 守护进程(基于 Moby 项目(Moby Project, 2026)),以在容器创建时动态插入 EROFS 支持的下层。具体来说,我们传入一个预挂载 EROFS 层的路径,并在挂载前将其插入 OverlayFS 栈,将其放置为最顶层的下层,以便它可以覆盖下方各层中的文件。这一改动很小,仅需 30 行 Go 代码。
基于 Rust 的 OverlayBD 和 ublk 库。 我们使用 OverlayBD 的 Rust 移植版(我们对其有贡献),以及我们用于 ublk 的 Rust 用户空间库,共同构成 §5.3 中所述的 Firecracker microVM 按需块存储路径。该存储层支持 3FS、OSS 等对象存储服务以及容器镜像仓库作为远程后端。它还可以使用本地文件系统作为二级缓存,使从页缓存中被逐出的数据能够在本地提供,而无需再次远程获取。这些存储组件已在 AgentENV/storage/overlaybd at main · kvcache-ai/AgentENV · GitHub 开源。
内存和 CPU 服务质量配置。 所有机制都利用现有的 Linux 内核特性。带 DAX 的 virtio-pmem 通过 Firecracker 设备配置和客户机内核挂载选项启用。基于 DAMON 的回收通过客户机内核参数和 sysfs 调优激活。对于 CPU服务质量,我们将尽力而为任务设置为 SCHED_IDLE,并通过 prctl(PR_SCHED_CORE) 启用核心调度,以按服务质量类别对任务分组。无需修改内核;实现完全由配置以及与我们的沙箱编排器集成组成。
用于算子基准测试的 GPU FnCall。 我们为 FnCall 配备 GPU,以进行无状态算子基准测试。由于 GPU 容量有限,GPU FnCall 使用三种机制来提高并发,同时保持性能隔离。第一,NVIDIA 多实例 GPU(MIG)将每个 GPU 划分为隔离实例,允许基准测试并发运行,并对分配的实例进行独占访问。第二,CPU FnCall 处理编译,并将生成的制品传递给 GPU FnCall,避免不必要的 GPU 占用。最后,一个 Python 进程预热池预先初始化运行时并导入库,使请求可以直接开始算子执行。这些机制共同减少了执行路径上的非 GPU 开销,从而同时提高 GPU 利用率和基准测试吞吐。对于非性能敏感任务,我们还提供共享 GPU 模式,通过允许多个工作负载共享一个 GPU 实例来提高并发。
3FS 部署。 每台 3FS(An et al., 2024)存储服务器配备 20 块 15 TB SSD 和 2 块 400 Gbps RDMA 网卡。CPU 节点通过其基于 FUSE 的客户端访问 3FS,EROFS 元数据存储在本地,文件数据按需从 3FS 提供。数十台存储服务器为拥有数十万 CPU 核心的集群支持按需镜像加载。
8. 评估
我们的评估衡量 §5 中四个核心机制的有效性和开销:按需镜像加载、可组合环境层、内存优化和 服务质量感知的 CPU 调度。实验聚焦于这些基础设施性能机制;§6 中的框架集成不在评估范围内。
8.1 实验设置
我们在一个专用的 10 节点 CPU 测试集群上进行本章实验,该集群与我们的生产部署分离。
硬件。 为避免嵌套虚拟化,我们的 microVM 直接在裸金属硬件上执行。每个 microVM 节点配备 AMD EPYC 9655 处理器,跨 2 路 × 96 核 × 2 SMT 线程,1.5 TB DRAM 和 3.4 TB 本地存储。相比之下,基于容器的实验在一个 QEMU 虚拟机内运行,其配置为 AMD EPYC 9655 处理器,1 路 × 96 核 × 2 SMT 线程,共 192 个硬件线程,512 GB 内存和 5.8 TB 本地存储。
SMT = Simultaneous Multithreading = 同时多线程,是一种 CPU 硬件技术,允许一个物理核心同时执行多个线程。
内核版本。 所有宿主机运行 Linux 7.0,所有 microVM 客户机运行 Linux 6.1。
工作负载。 我们的工作负载取自真实 RL 训练和评估场景。任务套件包括内部软件工程基准、SWE-bench(Jimenez et al., 2024)、Terminal-Bench(Merrill et al., 2026)、安全漏洞利用任务及类似领域。
8.2 按需镜像加载
我们将按需 EROFS 镜像拉取与从远程镜像仓库急切全镜像拉取(Docker Pull(冷))以及所有镜像层已预缓存在节点上的全本地基线(Docker Pull(缓存))进行对比评估。该实验在真实 RL 评估工作负载下,向 10 节点集群分发一波 8,192个容器的突发请求,该工作负载在启动时需要多样化的数 GB 镜像。我们测量随时间变化的并发运行容器数量、瞬时磁盘写 IOPS 和累计磁盘写入量。CPU 和内存利用率在不同配置间差异可忽略,因此省略。
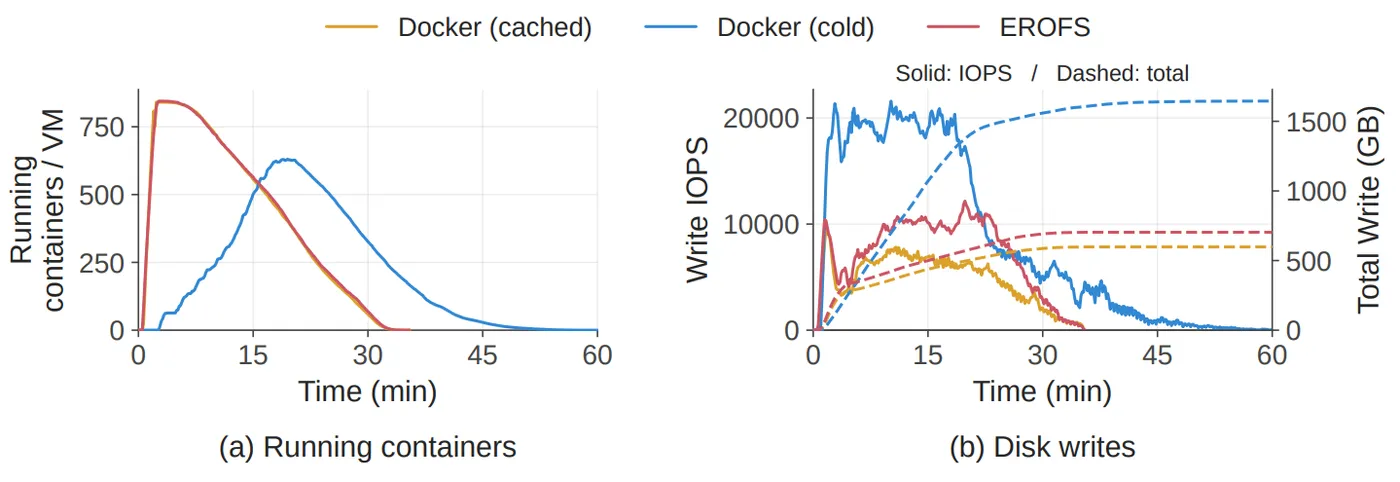
图 10 | 在 10 节点评估集群上,8,192 个容器突发下按需 EROFS 拉取与急切 Docker 拉取(冷)和全本地 Docker(缓存)的对比。左图:每节点运行容器数量随时间变化。右图:瞬时磁盘写 IOPS(实线,左轴)和累计磁盘写入量(虚线,右轴)。
如图 10 所示,按需 EROFS 拉取几乎与全本地基线一样快地达到峰值并发,因为镜像层被直接挂载,并且当沙箱访问其工作集时,数据从 3FS 获取。急切 Docker 拉取必须在容器启动前下载并解压每一层,在前 20 分钟内延迟容器创建。按需拉取在约 35 分钟内完成所有任务,与全本地基线相当,而急切拉取需要超过 60 分钟,慢了 1.71 倍。
急切拉取还达到按需路径近两倍的峰值磁盘写 IOPS,并在每个节点上累积超过 1,600 GB 的磁盘写入。按需拉取仅产生短暂的初始突发,并在约 700 GB 处趋于平稳,比急切拉取少约 57%,接近约 600 GB 的全本地基线。这些结果验证了 §5.3 的设计:按需为每个沙箱的工作集获取镜像数据,避免了全镜像下载和解压,同时接近全本地性能。
8.3 可组合镜像层:EROFS 对比 Tar
对于代码仓库和开发环境,我们比较两种供给相同评估工作区和工具包的方法,包括任务仓库、脚手架二进制和命令行工具。传统方法将这些文件打包为压缩 tar.gz 归档,分发并解包到每个沙箱中;而 EROFS 方法将相同文件打包为压缩的只读文件系统镜像,可直接作为可组合层挂载。我们用预录的、确定性的工具调用序列替代 LLM 生成,使各次运行仅在如何供给其工作区和工具包方面存在差异。
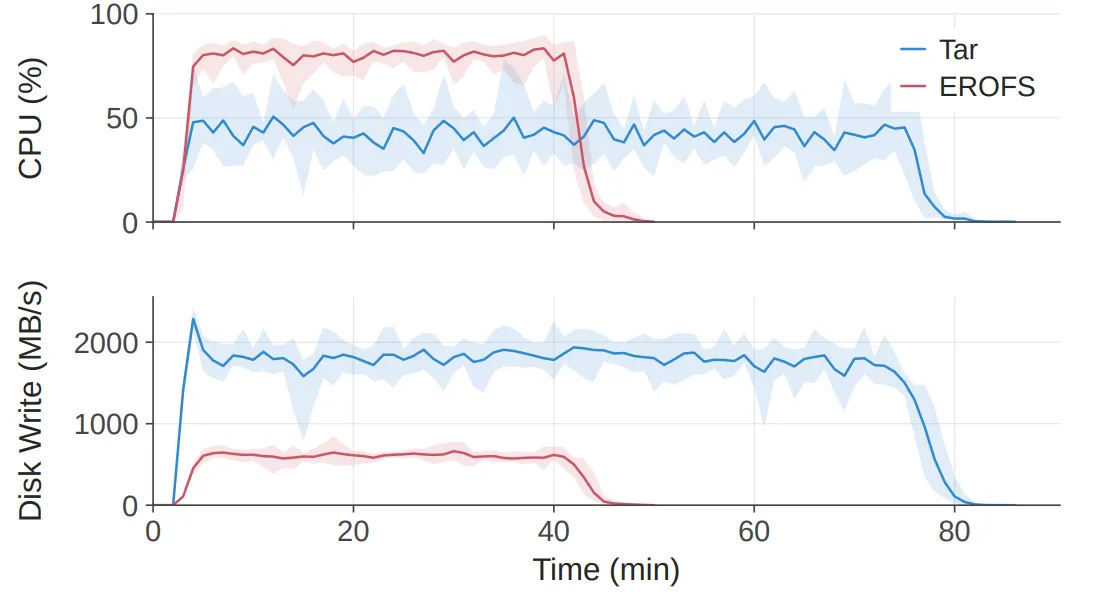
图 11 | 使用每沙箱 tar 解包与 EROFS 层挂载来供给评估工作区时的搭建阶段 CPU 利用率和磁盘写吞吐。
由于 tar.gz 是顺序流格式,每个沙箱都必须在工具调用开始前解压归档,并将所有工作区和工具包文件写入其本地可写层。这将端到端任务完成时间延长到 79 分钟。EROFS 直接挂载共享层而无需解包,使沙箱能够更早进入工具调用阶段,并将完成时间缩短到 45 分钟,加速 1.76 倍。如图 11 所示,基于 tar 的供给产生的总磁盘写流量约为 EROFS 路径的 5.5 倍,峰值磁盘写吞吐约为其 3.4 倍。EROFS 的峰值 CPU 利用率更高,因为更多沙箱更早进入工具调用阶段并并发执行操作。这并不表示更高的搭建开销,因为 EROFS 避免了反复解压和解包归档的 CPU 工作。这些结果验证了 §5.1 中可组合层设计的有效性。
8.4 超额分配下的内存
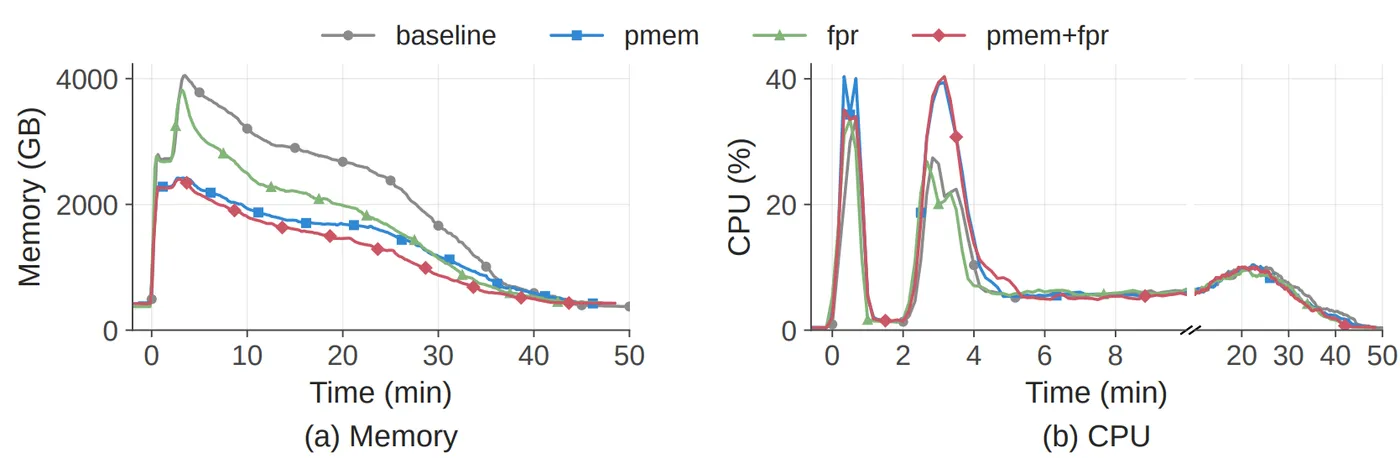
图 12 | 在真实智能体 RL 工作负载下,四种 Firecracker 配置的主机内存使用(左)和 CPU 利用率(右)。CPU 面板对前 10 分钟使用展开的时间刻度,对 10–50 分钟区间使用压缩刻度。
我们在测试集群上运行一个真实智能体 RL 工作负载,并比较四种 Firecracker 配置:未优化基线、仅带 DAX 的 virtio-pmem、仅通过 virtio-balloon 设备实现的基于 DAMON 的空闲页上报(FPR),以及两种机制组合。带 DAX 的 virtio-pmem 将冗余的每客户机页缓存合并为单个共享主机映射,与基线相比将峰值主机内存使用降低了 40.2%。仅 DAMON + balloon FPR 基本不改变峰值使用量,但将时间积分主机内存消耗降低了 21.2%。组合两种机制产生最低的整体内存消耗。如图 12 所示,virtio-pmem 将瞬态峰值 CPU 利用率从 26.5% 提高到 41.4%。这一增长可能部分反映了冷访问路径的差异。带 DAX 的 virtio-pmem 可能需要同步缺页处理来建立映射并使后端数据可用,而缓冲的 virtio-blk 则可以受益于客户机侧预读和批量块 I/O。在 CPU 受限部署中,运维人员可能更倾向于仅启用 FPR 并保留 virtio-blk。综合来看,这些结果验证了 §5.2 中的互补内存优化:virtio-pmem 减少页缓存重复,而 DAMON 配合 balloon FPR 回收空闲客户机内存。
8.5 超额分配下的CPU 服务质量
我们运行来自真实评估工作负载的延迟敏感型(LS)任务,同时共置占节点容量 10% 到 50% 的尽力而为型(BE)负载,测量我们的机制在高密度部署下能在多大程度上保持每沙箱性能。我们比较未保护基线、仅 SCHED_IDLE,以及 SCHED_IDLE结合核心调度。
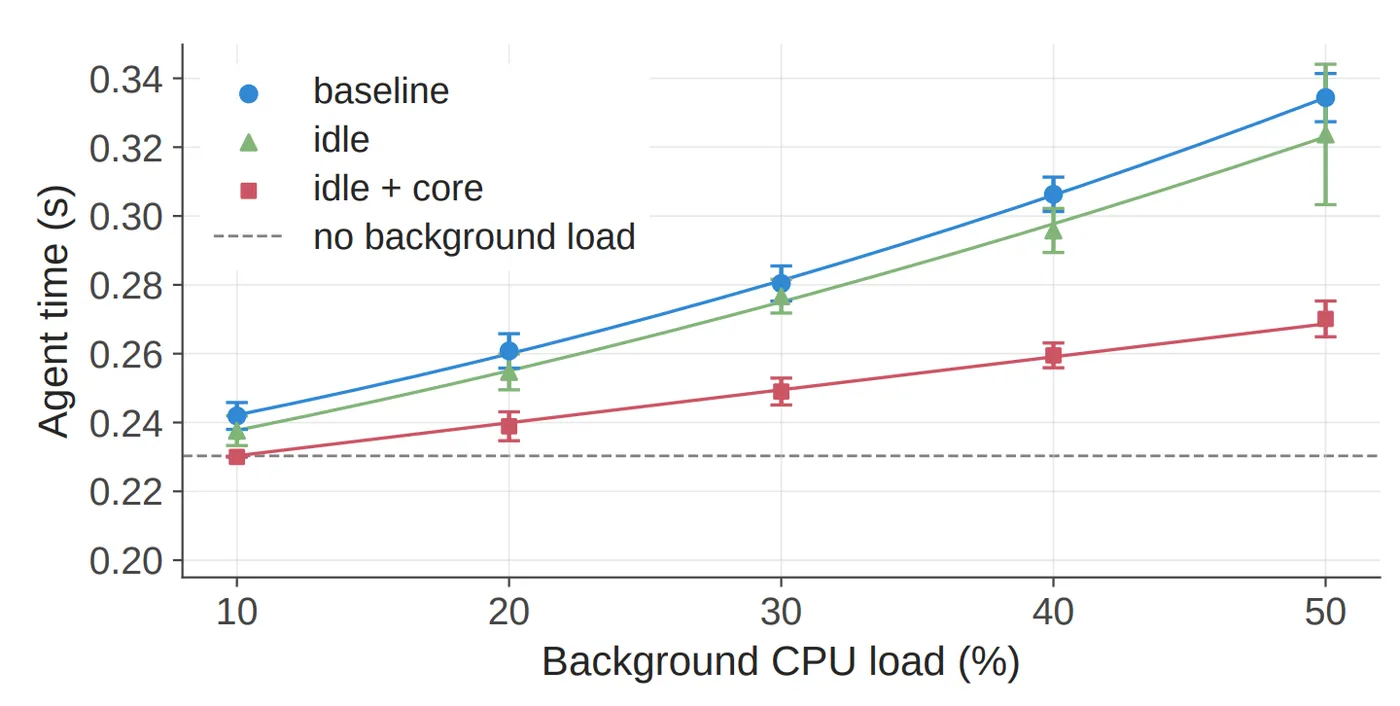
图 13 | 在共置尽力而为型 CPU 负载不断增加时,延迟敏感型智能体时间,比较未保护基线、仅 SCHED_IDLE,以及 SCHED_IDLE 结合核心调度。
如图 13 所示,我们使用一个延迟敏感的国际象棋应用作为测试工作负载。在 50% BE 负载下,其每步延迟相比无共置基线在无 QoS 控制时增加了 45.2%。仅 SCHED_IDLE 最多将延迟改善 3.4%,因为 LS 线程仍可能与其 SMT 兄弟线程上运行的 BE工作争用。加入核心调度后,在低负载下延迟接近无共置基线,并在 50% 负载下将膨胀限制在 17.3%。随着 BE 争用增加,改善也随之增大。这些结果验证了 §5.2 中的两级 CPU服务质量设计:SCHED_IDLE 优先处理 LS 任务,而核心调度将它们与兄弟 SMT 线程上的 BE 工作隔离。残余退化主要来自高多核负载下 CPU 睿频降低、内存带宽以及共享最后一级缓存(LLC)争用,这些是核心调度无法解决的。由于这种剩余干扰已经可以容忍,我们不再应用内存带宽隔离。
9. 相关工作
无服务器计算。 SAND(Akkus et al., 2018)、REAP(Ustiugov et al., 2021)、TrEnv(Huang et al., 2024)和 RunD(Li et al., 2022)等无服务器平台针对短生命周期、无状态函数优化冷启动延迟和资源共享。这些工作负载通常以高扇出复用有限的一组镜像,并且许多系统假设所需镜像已在本地可用。智能体训练则使用长时存活的有状态沙箱,这些沙箱取自超出单节点存储容量且每镜像扇出较低的镜像集合。
LLM 代码执行平台。 近期系统为训练和推理中的 LLM 工作流提供沙箱化代码执行。面向推理的系统包括 OpenAI Code Interpreter(OpenAI, 2025)、E2B(E2B, 2024)和 Kimi-K2.5 的 Agent Swarm(Kimi Team, 2026)。MiMo-V2-Flash(Xiaomi LLM-Core Team, 2026)和ComputerRL(Lai et al., 2025)等训练系统提到了其执行环境,但主要关注模型和训练设计。DSec 关注底层沙箱基础设施,将环境组合、资源超分、镜像服务和抢占安全恢复集成在一个平台内。
容器镜像与文件系统格式。 DADI(Li et al., 2020)和CoFS(Wang et al., 2026)支持按需容器镜像加载,而 FaaSNet(Wang et al., 2021)使用点对点分发来加速镜像分发。EROFS(Gao et al., 2019)提供支持随机访问的压缩只读文件系统。DSec 在这些技术基础上构建,用于 RL 训练和评估,从 3FS 提供容器和 microVM 镜像,而不是引入单独的镜像仓库和点对点分发层。
轻量级隔离。 为了运行多样化的工作负载,已有若干隔离范式被提出,包括 microVM(Agache et al., 2020)或 VM 支持的 Kata 容器(Kata Containers, 2017)、库操作系统(che Tsai et al., 2017; LiteBox, 2025)、WebAssembly 运行时(Gadepalli et al., 2020; Shillaker and Pietzuch, 2020)、unikernel(Cadden et al., 2020)、嵌套内核(Dautenhahn et al., 2015; Zhang et al., 2025)以及嵌套虚拟化(Huang et al., 2023)。它们在隔离、兼容性和性能之间提供不同的权衡。DSec 没有提出另一种隔离机制,而是将多个沙箱后端集成在一个统一平台之后,允许调用者为每个任务选择合适的后端。
RL 训练基础设施。 Slime(Zhu et al., 2025)、veRL(Sheng et al., 2025)、OpenRLHF(Hu, 2026; Hu et al., 2025)和 Seer(Qin et al., 2026)等系统通过高效的 GPU 调度、通信和样本吞吐来扩展 RL 训练。它们将执行环境视为黑盒,假设沙箱可用且配置正确。DSec 在互补的基础设施层运行,管理沙箱供给和生命周期,同时与训练框架协调执行状态和安全策略。
10. 结论
我们介绍了 DSec,一个面向大规模 LLM 智能体训练、评估和环境构建的生产沙箱平台。DSec 通过统一接口暴露多个沙箱后端,允许用户针对不同的功能、兼容性和隔离需求选择合适的执行环境。可组合 EROFS支持的层避免了重复的环境重建和解包,互补的内存共享与回收机制支持高密度部署,服务质量感知的CPU 调度在超额分配下保护延迟敏感型任务,3FS 支持的按需镜像加载减少了镜像分发开销。DSec 还与 RL 框架集成,以实现抢占安全恢复和任务专用网络策略,为智能体工作负载提供可扩展的执行基础。
参考文献
A. Agache, M. Brooker, A. Iordache, A. Liguori, R. Neugebauer, P. Piwonka, and D.-M. Popa. Firecracker: Lightweight virtualization for serverless applications. In 17th USENIX Symposium on Networked Systems Design and Implementation (NSDI 20), pages 419– 434, Santa Clara, CA, Feb. 2020. USENIX Association. ISBN 978-1-939133-13-7. URL https://www.usenix.org/conference/nsdi20/presentation/agache. I. E. Akkus, R. Chen, I. Rimac, M. Stein, K. Satzke, A. Beck, P. Aditya, and V. Hilt. SAND: Towards High-Performance serverless computing. In 2018 USENIX Annual Technical Conference (USENIX ATC 18), pages 923–935, Boston, MA, July 2018. USENIX Association. ISBN 978-1- 939133-01-4. URL https://www.usenix.org/conference/atc18/presentation/akk us. D. Amodei, C. Olah, J. Steinhardt, P. Christiano, J. Schulman, and D. Mané. Concrete problems in ai safety, 2016. URL https://arxiv.org/abs/1606.06565. W. An, X. Bi, G. Chen, S. Chen, C. Deng, H. Ding, K. Dong, Q. Du, W. Gao, K. Guan, J. Guo, Y. Guo, Z. Fu, Y. He, P. Huang, J. Li, W. Liang, X. Liu, X. Liu, Y. Liu, Y. Liu, S. Lu, X. Lu, X. Nie, T. Pei, J. Qiu, H. Qu, Z. Ren, Z. Sha, X. Su, X. Sun, Y. Tan, M. Tang, S. Wang, Y. Wang, Y. Wang, Z. Xie, Y. Xiong, Y. Xu, S. Ye, S. Yu, Y. Zha, L. Zhang, H. Zhang, M. Zhang, W. Zhang, Y. Zhang, C. Zhao, Y. Zhao, S. Zhou, S. Zhou, and Y. Zou. Fire-flyer ai-hpc: A cost-effective softwarehardware co-design for deep learning. In Proceedings of the International Conference for High Performance Computing, Networking, Storage, and Analysis, SC ’24. IEEE Press, 2024. ISBN 9798350352917. doi: 10.1109/SC41406.2024.00089. URL https://doi.org/10.1109/ SC41406.2024.00089.
Anomaly. OpenCode, 2025. URL https://opencode.ai/. F. Bellard. QEMU, a fast and portable dynamic translator. In 2005 USENIX Annual Technical Conference (USENIX ATC 05), Anaheim, CA, Apr. 2005. USENIX Association. URL https: //www.usenix.org/conference/2005-usenix-annual-technical-conference/qe mu-fast-and-portable-dynamic-translator. J. Cadden, T. Unger, Y. Awad, H. Dong, O. Krieger, and J. Appavoo. Seuss: skip redundant paths to make serverless fast. In Proceedings of the Fifteenth European Conference on Computer Systems, EuroSys ’20, New York, NY, USA, 2020. Association for Computing Machinery. ISBN 9781450368827. doi: 10.1145/3342195.3392698. URL https://doi.org/10.1145/334219 5.3392698. C. che Tsai, D. E. Porter, and M. Vij. Graphene-SGX: A practical library OS for unmodified applications on SGX. In 2017 USENIX Annual Technical Conference (USENIX ATC 17), pages 645–658, Santa Clara, CA, July 2017. USENIX Association. ISBN 978-1-931971-38-6. URL https://www.usenix.org/conference/atc17/technical-sessions/presentati on/tsai. N. Dautenhahn, T. Kasampalis, W. Dietz, J. Criswell, and V. Adve. Nested kernel: An operating system architecture for intra-kernel privilege separation. In Proceedings of the Twentieth International Conference on Architectural Support for Programming Languages and Operating Systems, ASPLOS ’15, New York, NY, USA, 2015. Association for Computing Machinery. ISBN 9781450328357. doi: 10.1145/2694344.2694386. URL https: //doi.org/10.1145/2694344.2694386. DeepSeek-AI. Fire-flyer file sytem. URL https://github.com/deepseek-ai/3fs. DeepSeek-AI. Deepseek-v3.2: Pushing the frontier of open large language models, 2025. URL https://arxiv.org/abs/2512.02556. DeepSeek-AI. Deepseek-v4.1-flash: Pushing the limits of kv cache compression, 2026. URL https://arxiv.org/abs/2609.19969. Dragonfly Community. Nydus: Dragonfly container image service, 2020. URL https://gith ub.com/dragonflyoss/nydus. DXVK. DXVK: A vulkan-based implementation of direct3d 8/9/10/11. https://github.c om/doitsujin/dxvk, 2018. E2B. E2B: Open-source secure sandboxes for AI code execution, 2024. URL https://github .com/e2b-dev/E2B. P. K. Gadepalli, S. McBride, G. Peach, L. Cherkasova, and G. Parmer. Sledge: a serverlessfirst, light-weight wasm runtime for the edge. In Proceedings of the 21st International Middleware Conference, Middleware ’20, page 265–279, New York, NY, USA, 2020. Association for Computing Machinery. ISBN 9781450381536. doi: 10.1145/3423211.3425680. URL https://doi.org/10.1145/3423211.3425680. X. Gao, M. Dong, X. Miao, W. Du, C. Yu, and H. Chen. EROFS: A compression-friendly readonly file system for resource-scarce devices. In 2019 USENIX Annual Technical Conference (USENIX ATC 19), pages 149–162, Renton, WA, July 2019. USENIX Association. ISBN 978-1- 939133-03-8. URL http://www.usenix.org/conference/atc19/presentation/gao.D. Guo, D. Yang, H. Zhang, J. Song, P. Wang, Q. Zhu, R. Xu, R. Zhang, S. Ma, X. Bi, X. Zhang, X. Yu, Y. Wu, Z. F. Wu, Z. Gou, Z. Shao, Z. Li, Z. Gao, A. Liu, B. Xue, B. Wang, B. Wu, B. Feng, C. Lu, C. Zhao, C. Deng, C. Ruan, D. Dai, D. Chen, D. Ji, E. Li, F. Lin, F. Dai, F. Luo, G. Hao, G. Chen, G. Li, H. Zhang, H. Xu, H. Ding, H. Gao, H. Qu, H. Li, J. Guo, J. Li, J. Chen, J. Yuan, J. Tu, J. Qiu, J. Li, J. L. Cai, J. Ni, J. Liang, J. Chen, K. Dong, K. Hu, K. You, K. Gao, K. Guan, K. Huang, K. Yu, L. Wang, L. Zhang, L. Zhao, L. Wang, L. Zhang, L. Xu, L. Xia, M. Zhang, M. Zhang, M. Tang, M. Zhou, M. Li, M. Wang, M. Li, N. Tian, P. Huang, P. Zhang, Q. Wang, Q. Chen, Q. Du, R. Ge, R. Zhang, R. Pan, R. Wang, R. J. Chen, R. L. Jin, R. Chen, S. Lu, S. Zhou, S. Chen, S. Ye, S. Wang, S. Yu, S. Zhou, S. Pan, S. S. Li, S. Zhou, S. Wu, T. Yun, T. Pei, T. Sun, T. Wang, W. Zeng, W. Liu, W. Liang, W. Gao, W. Yu, W. Zhang, W. L. Xiao, W. An, X. Liu, X. Wang, X. Chen, X. Nie, X. Cheng, X. Liu, X. Xie, X. Liu, X. Yang, X. Li, X. Su, X. Lin, X. Q. Li, X. Jin, X. Shen, X. Chen, X. Sun, X. Wang, X. Song, X. Zhou, X. Wang, X. Shan, Y. K. Li, Y. Q. Wang, Y. X. Wei, Y. Zhang, Y. Xu, Y. Li, Y. Zhao, Y. Sun, Y. Wang, Y. Yu, Y. Zhang, Y. Shi, Y. Xiong, Y. He, Y. Piao, Y. Wang, Y. Tan, Y. Ma, Y. Liu, Y. Guo, Y. Ou, Y. Wang, Y. Gong, Y. Zou, Y. He, Y. Xiong, Y. Luo, Y. You, Y. Liu, Y. Zhou, Y. X. Zhu, Y. Huang, Y. Li, Y. Zheng, Y. Zhu, Y. Ma, Y. Tang, Y. Zha, Y. Yan, Z. Z. Ren, Z. Ren, Z. Sha, Z. Fu, Z. Xu, Z. Xie, Z. Zhang, Z. Hao, Z. Ma, Z. Yan, Z. Wu, Z. Gu, Z. Zhu, Z. Liu, Z. Li, Z. Xie, Z. Song, Z. Pan, Z. Huang, Z. Xu, Z. Zhang, and Z. Zhang. Deepseek-r1 incentivizes reasoning in llms through reinforcement learning. Nature, 645(8081):633–638, Sep 2025. ISSN 1476-4687. doi: 10.1038/s41586-025-09422-z. URL https://doi.org/10.1038/s41586-025-09422-z. J. Hu. Reinforce++: A simple and efficient approach for aligning large language models. arXiv preprint arXiv:2501.03262, 2026. J. Hu, X. Wu, W. Shen, J. K. Liu, Z. Zhu, W. Wang, S. Jiang, H. Wang, H. Chen, B. Chen, W. Fang, Xianyu, Y. Cao, H. Xu, and Y. Liu. Openrlhf: An easy-to-use, scalable and high-performance rlhf framework, 2025. URL https://arxiv.org/abs/2405.11143. H. Huang, J. Lai, J. Rao, H. Lu, W. Hou, H. Su, Q. Xu, J. Zhong, J. Zeng, X. Wang, Z. He, W. Han, J. Liu, T. Ma, and S. Wu. Pvm: Efficient shadow paging for deploying secure containers in cloud-native environment. In Proceedings of the 29th Symposium on Operating Systems Principles, SOSP ’23, page 515–530, New York, NY, USA, 2023. Association for Computing Machinery. ISBN 9798400702297. doi: 10.1145/3600006.3613158. URL https: //doi.org/10.1145/3600006.3613158. J. Huang, M. Zhang, T. Ma, Z. Liu, S. Lin, K. Chen, J. Jiang, X. Liao, Y. Shan, N. Zhang, M. Lu, T. Ma, H. Gong, and Y. Wu. Trenv: Transparently share serverless execution environments across different functions and nodes. In Proceedings of the ACM SIGOPS 30th Symposium on Operating Systems Principles, SOSP ’24, page 421–437, New York, NY, USA, 2024. Association for Computing Machinery. ISBN 9798400712517. doi: 10.1145/3694715.3695967. URL https://doi.org/10.1145/3694715.3695967. C. E. Jimenez, J. Yang, A. Wettig, S. Yao, K. Pei, O. Press, and K. R. Narasimhan. Swe-bench: Can language models resolve real-world github issues? In The Twelfth International Conference on Learning Representations, ICLR 2024, Vienna, Austria, May 7-11, 2024. OpenReview.net, 2024. URL https://openreview.net/forum?id=VTF8yNQM66. Kata Containers. Kata Containers: Secure Containers with Lightweight Virtual Machines. https://katacontainers.io/, 2017. Kimi Team. Kimi K2.5: Visual agentic intelligence, 2026
H. Lai, X. Liu, Y. Zhao, H. Xu, H. Zhang, B. Jing, Y. Ren, S. Yao, Y. Dong, and J. Tang. ComputerRL: Scaling end-to-end online reinforcement learning for computer use agents, 2025. H. Li, Y. Yuan, R. Du, K. Ma, L. Liu, and W. Hsu. DADI: Block-Level image service for agile and elastic application deployment. In 2020 USENIX Annual Technical Conference (USENIX ATC 20), pages 727–740. USENIX Association, July 2020. ISBN 978-1-939133-14-4. URL https://www.usenix.org/conference/atc20/presentation/li-huiba. Z. Li, J. Cheng, Q. Chen, E. Guan, Z. Bian, Y. Tao, B. Zha, Q. Wang, W. Han, and M. Guo. RunD: A lightweight secure container runtime for high-density deployment and high-concurrency startup in serverless computing. In 2022 USENIX Annual Technical Conference (USENIX ATC 22), pages 53–68, Carlsbad, CA, July 2022. USENIX Association. ISBN 978-1-939133-29- 27. URL https://www.usenix.org/conference/atc22/presentation/li-zijun-r und. LiteBox. Litebox: A security-focused library os supporting kernel- and user-mode execution. https://github.com/microsoft/litebox, 2025. M. A. Merrill, A. G. Shaw, N. Carlini, B. Li, H. Raj, I. Bercovich, L. Shi, J. Y. Shin, T. Walshe, E. K. Buchanan, J. Shen, G. Ye, H. Lin, J. Poulos, M. Wang, M. Nezhurina, J. Jitsev, D. Lu, O. M. Mastromichalakis, Z. Xu, Z. Chen, Y. Liu, R. Zhang, L. L. Chen, A. Kashyap, J.-L. Uslu, J. Li, J. Wu, M. Yan, S. Bian, V. Sharma, K. Sun, S. Dillmann, A. Anand, A. Lanpouthakoun, B. Koopah, C. Hu, E. Guha, G. H. S. Dreiman, J. Zhu, K. Krauth, L. Zhong, N. Muennighoff, R. Amanfu, S. Tan, S. Pimpalgaonkar, T. Aggarwal, X. Lin, X. Lan, X. Zhao, Y. Liang, Y. Wang, Z. Wang, C. Zhou, D. Heineman, H. Liu, H. Trivedi, J. Yang, J. Lin, M. Shetty, M. Yang, N. Omi, N. Raoof, S. Li, T. Y. Zhuo, W. Lin, Y. Dai, Y. Wang, W. Chai, S. Zhou, D. Wahdany, Z. She, J. Hu, Z. Dong, Y. Zhu, S. Cui, A. Saiyed, A. Kolbeinsson, J. Hu, C. M. Rytting, R. Marten, Y. Wang, A. Dimakis, A. Konwinski, and L. Schmidt. Terminal-bench: Benchmarking agents on hard, realistic tasks in command line interfaces, 2026. URL https://arxiv.org/abs/ 2601.11868. M. Mitzenmacher. The power of two choices in randomized load balancing. IEEE Transactions on Parallel and Distributed Systems, 12(10):1094–1104, 2001. doi: 10.1109/71.963420. Moby Project. The Moby Project, 2026. URL https://github.com/moby/moby. Open Container Initiative. Open Container Initiative Image Format Specification, 2026. URL https://github.com/opencontainers/image-spec. OpenAI. Code interpreter: Agent harness and sandbox for code execution, 2025. URL https: //platform.openai.com/docs/guides/code-interpreter. OpenAI, J. Achiam, S. Adler, S. Agarwal, L. Ahmad, I. Akkaya, F. L. Aleman, D. Almeida, J. Altenschmidt, S. Altman, S. Anadkat, R. Avila, I. Babuschkin, S. Balaji, V. Balcom, P. Baltescu, H. Bao, M. Bavarian, J. Belgum, I. Bello, J. Berdine, G. Bernadett-Shapiro, C. Berner, L. Bogdonoff, O. Boiko, M. Boyd, A.-L. Brakman, G. Brockman, T. Brooks, M. Brundage, K. Button, T. Cai, R. Campbell, A. Cann, B. Carey, C. Carlson, R. Carmichael, B. Chan, C. Chang, F. Chantzis, D. Chen, S. Chen, R. Chen, J. Chen, M. Chen, B. Chess, C. Cho, C. Chu, H. W. Chung, D. Cummings, J. Currier, Y. Dai, C. Decareaux, T. Degry, N. Deutsch, D. Deville, A. Dhar, D. Dohan, S. Dowling, S. Dunning, A. Ecoffet, A. Eleti, T. Eloundou, D. Farhi, L. Fedus, N. Felix, S. P. Fishman, J. Forte, I. Fulford, L. Gao, E. Georges, C. Gibson, V. Goel, T. Gogineni, G. Goh, R. Gontijo-Lopes, J. Gordon, M. Grafstein, S. Gray, R. Greene, J. Gross, S. S. Gu, Y. Guo, C. Hallacy, J. Han, J. Harris, Y. He, M. Heaton, J. Heidecke, C. Hesse, A. Hickey,W. Hickey, P. Hoeschele, B. Houghton, K. Hsu, S. Hu, X. Hu, J. Huizinga, S. Jain, S. Jain, J. Jang, A. Jiang, R. Jiang, H. Jin, D. Jin, S. Jomoto, B. Jonn, H. Jun, T. Kaftan, Ł. Kaiser, A. Kamali, I. Kanitscheider, N. S. Keskar, T. Khan, L. Kilpatrick, J. W. Kim, C. Kim, Y. Kim, J. H. Kirchner, J. Kiros, M. Knight, D. Kokotajlo, Ł. Kondraciuk, A. Kondrich, A. Konstantinidis, K. Kosic, G. Krueger, V. Kuo, M. Lampe, I. Lan, T. Lee, J. Leike, J. Leung, D. Levy, C. M. Li, R. Lim, M. Lin, S. Lin, M. Litwin, T. Lopez, R. Lowe, P. Lue, A. Makanju, K. Malfacini, S. Manning, T. Markov, Y. Markovski, B. Martin, K. Mayer, A. Mayne, B. McGrew, S. M. McKinney, C. McLeavey, P. McMillan, J. McNeil, D. Medina, A. Mehta, J. Menick, L. Metz, A. Mishchenko, P. Mishkin, V. Monaco, E. Morikawa, D. Mossing, T. Mu, M. Murati, O. Murk, D. Mély, A. Nair, R. Nakano, R. Nayak, A. Neelakantan, R. Ngo, H. Noh, L. Ouyang, C. O’Keefe, J. Pachocki, A. Paino, J. Palermo, A. Pantuliano, G. Parascandolo, J. Parish, E. Parparita, A. Passos, M. Pavlov, A. Peng, A. Perelman, F. de Avila Belbute Peres, M. Petrov, H. P. de Oliveira Pinto, Michael, Pokorny, M. Pokrass, V. H. Pong, T. Powell, A. Power, B. Power, E. Proehl, R. Puri, A. Radford, J. Rae, A. Ramesh, C. Raymond, F. Real, K. Rimbach, C. Ross, B. Rotsted, H. Roussez, N. Ryder, M. Saltarelli, T. Sanders, S. Santurkar, G. Sastry, H. Schmidt, D. Schnurr, J. Schulman, D. Selsam, K. Sheppard, T. Sherbakov, J. Shieh, S. Shoker, P. Shyam, S. Sidor, E. Sigler, M. Simens, J. Sitkin, K. Slama, I. Sohl, B. Sokolowsky, Y. Song, N. Staudacher, F. P. Such, N. Summers, I. Sutskever, J. Tang, N. Tezak, M. B. Thompson, P. Tillet, A. Tootoonchian, E. Tseng, P. Tuggle, N. Turley, J. Tworek, J. F. C. Uribe, A. Vallone, A. Vijayvergiya, C. Voss, C. Wainwright, J. J. Wang, A. Wang, B. Wang, J. Ward, J. Wei, C. Weinmann, A. Welihinda, P. Welinder, J. Weng, L. Weng, M. Wiethoff, D. Willner, C. Winter, S. Wolrich, H. Wong, L. Workman, S. Wu, J. Wu, M. Wu, K. Xiao, T. Xu, S. Yoo, K. Yu, Q. Yuan, W. Zaremba, R. Zellers, C. Zhang, M. Zhang, S. Zhao, T. Zheng, J. Zhuang, W. Zhuk, and B. Zoph. Gpt-4 technical report, 2024. URL https://arxiv.org/abs/2303.08774. L. Ouyang, J. Wu, X. Jiang, D. Almeida, C. L. Wainwright, P. Mishkin, C. Zhang, S. Agarwal, K. Slama, A. Ray, J. Schulman, J. Hilton, F. Kelton, L. Miller, M. Simens, A. Askell, P. Welinder, P. Christiano, J. Leike, and R. Lowe. Training language models to follow instructions with human feedback. In Proceedings of the 36th International Conference on Neural Information Processing Systems, NIPS ’22, Red Hook, NY, USA, 2022. Curran Associates Inc. ISBN 9781713871088. S. Park, J. Ahn, H. Y. Kim, and Y. Lee. Profiling dynamic data access patterns with controlled overhead and quality. In Proceedings of the 20th International Middleware Conference Industrial Track (Middleware ’19), pages 29–30, 2019. doi: 10.1145/3366626.3368125. QEMU Project. VirtIO Persistent Memory, 2026. URL https://www.qemu.org/docs/mast er/system/devices/virtio/virtio-pmem.html. R. Qin, W. He, W. Huang, Y. Zhang, Y. Zhao, B. Pang, X. Xu, Y. Shan, Y. Wu, and M. Zhang. Seer: Online context learning for fast synchronous llm reinforcement learning, 2026. URL https://arxiv.org/abs/2511.14617. G. Sheng, C. Zhang, Z. Ye, X. Wu, W. Zhang, R. Zhang, Y. Peng, H. Lin, and C. Wu. Hybridflow: A flexible and efficient rlhf framework. In Proceedings of the Twentieth European Conference on Computer Systems, EuroSys ’25, page 1279–1297, New York, NY, USA, 2025. Association for Computing Machinery. ISBN 9798400711961. doi: 10.1145/3689031.3696075. URL https://doi.org/10.1145/3689031.3696075. Y. Shi, W. Zhang, and T. Cui. A programming paradigm for spatiotemporal composability, 2026. URL https://arxiv.org/abs/2608.25512.
S. Shillaker and P. Pietzuch. Faasm: Lightweight isolation for efficient stateful serverless computing. In 2020 USENIX Annual Technical Conference (USENIX ATC 20), pages 419–433. USENIX Association, July 2020. ISBN 978-1-939133-14-4. URL https://www.usenix.org /conference/atc20/presentation/shillaker. J. Skalse, N. H. R. Howe, D. Krasheninnikov, and D. Krueger. Defining and characterizing reward hacking. In Proceedings of the 36th International Conference on Neural Information Processing Systems, NIPS ’22, Red Hook, NY, USA, 2022. Curran Associates Inc. ISBN 9781713871088. D. Ustiugov, P. Petrov, M. Kogias, E. Bugnion, and B. Grot. Benchmarking, analysis, and optimization of serverless function snapshots. In Proceedings of the 26th ACM International Conference on Architectural Support for Programming Languages and Operating Systems, ASPLOS ’21, page 559–572, New York, NY, USA, 2021. Association for Computing Machinery. ISBN 9781450383172. doi: 10.1145/3445814.3446714. URL https://doi.org/10.1145/34 45814.3446714. C. A. Waldspurger. Memory resource management in VMware ESX server. In 5th Symposium on Operating Systems Design and Implementation (OSDI 02), Boston, MA, Dec. 2002. USENIX Association. URL https://www.usenix.org/conference/osdi-02/memory-resourc e-management-vmware-esx-server. A. Wang, S. Chang, H. Tian, H. Wang, H. Yang, H. Li, R. Du, and Y. Cheng. FaaSNet: Scalable and fast provisioning of custom serverless container runtimes at alibaba cloud function compute. In 2021 USENIX Annual Technical Conference (USENIX ATC 21), pages 443–457. USENIX Association, July 2021. ISBN 978-1-939133-23-6. URL https://www.usenix.org/confere nce/atc21/presentation/wang-ao. L. Wang, J. Du, Y. Yang, Q. Wu, T. Liu, and H. Wu. CoFS: A filesystem for fast container startup. In 24th USENIX Conference on File and Storage Technologies (FAST 26), pages 415–423, Santa Clara, CA, Feb. 2026. USENIX Association. ISBN 978-1-939133-53-3. URL https://www.usenix.org/conference/fast26/presentation/wang-li. Xiaomi LLM-Core Team. MiMo-V2-Flash technical report, 2026. T. Xie, D. Zhang, J. Chen, X. Li, S. Zhao, R. Cao, T. J. Hua, Z. Cheng, D. Shin, F. Lei, Y. Liu, Y. Xu, S. Zhou, S. Savarese, C. Xiong, V. Zhong, and T. Yu. Osworld: Benchmarking multimodal agents for open-ended tasks in real computer environments. In Advances in Neural Information Processing Systems, 2024. doi: 10.52202/079017-1650. C. Zhang, R. Priolkar, Y. Jiang, Y. Xiao, M. Vij, Z. Liang, and A. Ahmad. Erebor: A drop-in sandbox solution for private data processing in untrusted confidential virtual machines. In Proceedings of the Twentieth European Conference on Computer Systems, EuroSys ’25, New York, NY, USA, 2025. Association for Computing Machinery. ISBN 9798400711961. doi: 10.1145/3689031.3717464. URL https://doi.org/10.1145/3689031.3717464. S. Zhou, F. F. Xu, H. Zhu, X. Zhou, R. Lo, A. Sridhar, X. Cheng, T. Ou, Y. Bisk, D. Fried, U. Alon, and G. Neubig. Webarena: A realistic web environment for building autonomous agents. In International Conference on Learning Representations, 2024. URL https://openreview .net/forum?id=oKn9c6ytLx. Z. Zhu, C. Xie, X. Lv, and slime Contributors. slime: An llm post-training framework for rl scaling. https://github.com/THUDM/slime, 2025.
P. Zijlstra, J. Fernandes, and V. Pillai. Core scheduling, 2021. URL https://docs.kernel.or g/admin-guide/hw-vuln/core-scheduling.html.