阿里云代理商:GPU服务器需要多大带宽?模型下载和接口服务怎么规划

简介: 阿里云GPU服务器需要多大带宽,必须先区分模型下载、对外接口和集群通信。下载模型是数据进入实例,向用户返回结果是数据离开服务,多机训练则可能主要使用内网。这三类路径不能用购买页上的一个公网带宽数字统一解释。

阿里云代理商:阿里云GPU服务器需要多大带宽?模型下载和接口服务怎么规划

✅本文由 ➡️国内云代理商『聚搜云 JuSouYunClouD -服务器服务商•撰写』如需转载请注明!

阿里云GPU服务器需要多大带宽,必须先区分模型下载、对外接口和集群通信。下载模型是数据进入实例,向用户返回结果是数据离开服务,多机训练则可能主要使用内网。这三类路径不能用购买页上的一个公网带宽数字统一解释。企业先画出数据流向,再估算容量,才能避免接口没有改善、网络费用却增加的情况。ChatGPT 图像 2026年10月10日 18_24_20-1.png
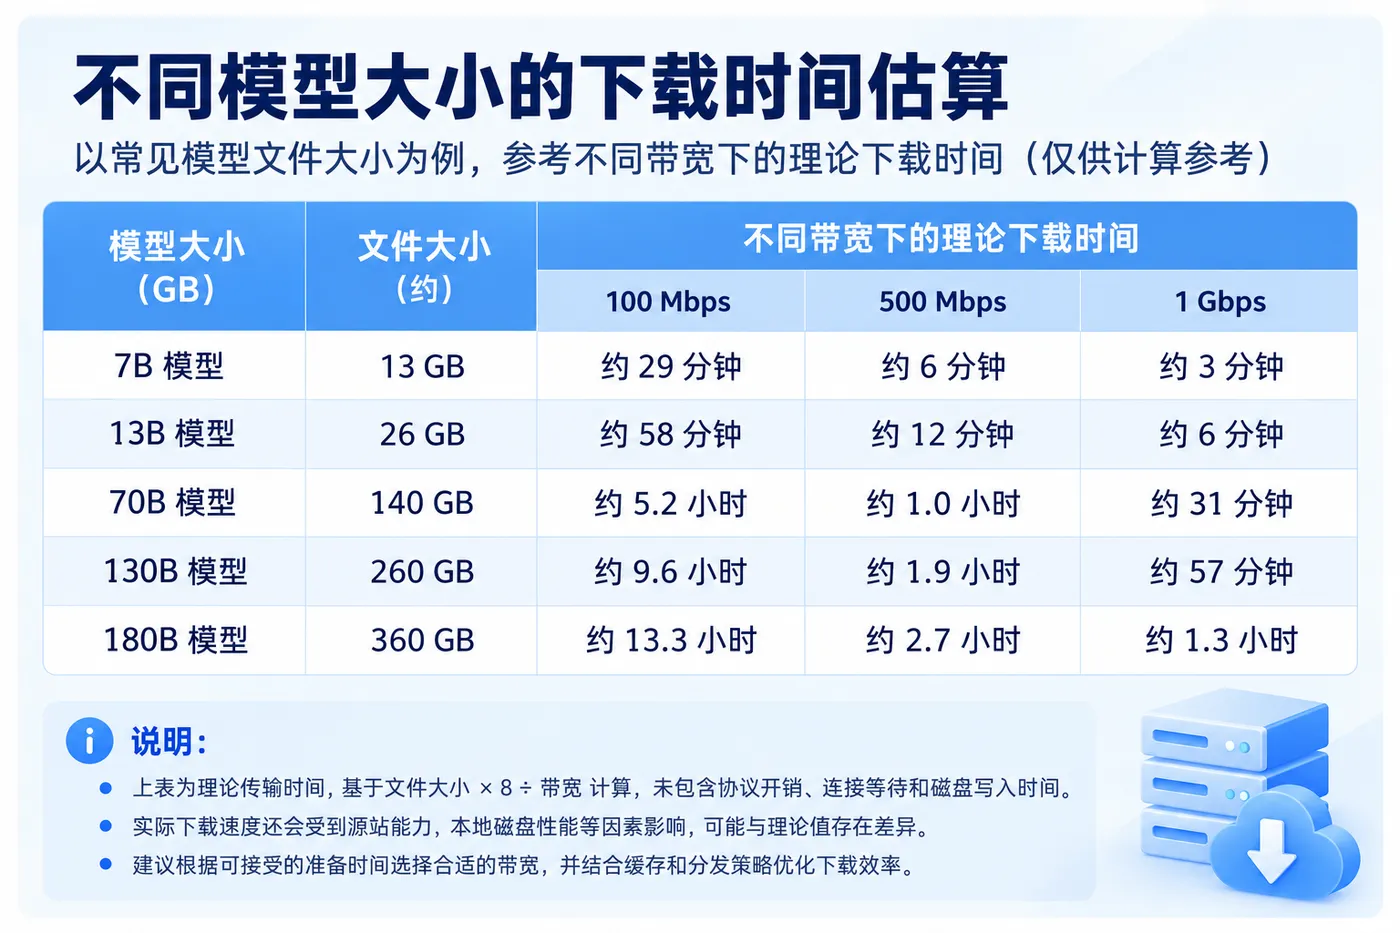
一、阿里云GPU模型下载,先估算完成时间

模型下载需要多快,取决于模型文件体积与可以接受的准备时间。可以将文件字节数乘以8,再除以实际路径的有效传输速率,得到理想传输时间。这里使用的是可达到的下载速率,不是直接套用购买页的出网带宽,源站能力和本地落盘也会限制速度。

下面的Python示例假设需要传输120GB十进制数据,分别计算100Mbps和1000Mbps有效速率下的理论时间。只进行本地算术,不访问网络,也不是阿里云带宽实测。

python3 - <<'PYCODE'
size_gb = 120
for mbps in (100, 1000):
    seconds = size_gb * 10**9 * 8 / (mbps * 10**6)
    print(mbps, "Mbps:", round(seconds / 3600, 2), "hours")
PYCODE

结果约为2.67小时和0.27小时,尚未计入协议开销、连接等待与校验。若实际耗时远高于理论值,应同时观察下载端速率、CPU解压和磁盘写入。如果磁盘已经持续排队,单独增加网络容量可能无法缩短准备时间。

(一)阿里云GPU带宽计费,方向不能看反

阿里云固定公网IPv4的相关文档区分入网与出网,并按出方向收费。入方向不收费,不代表下载速度没有限制;使用EIP或NAT等访问路径时,也应查看对应产品规则。“模型下载慢”与“公网出带宽不够”不是同一个结论,需要先确认经过哪条链路。
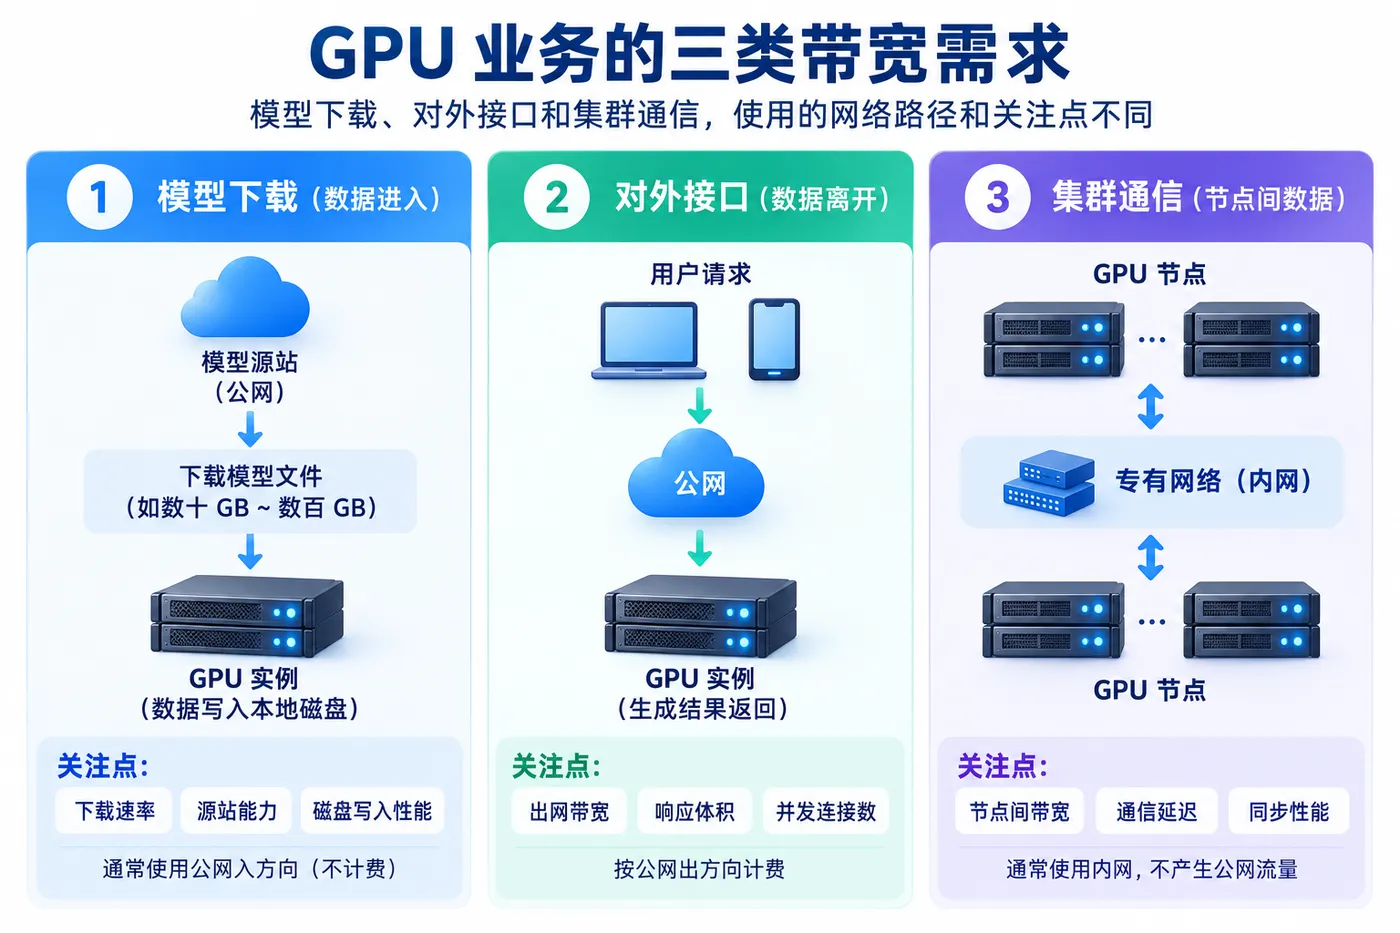
ChatGPT 图像 2026年10月10日 18_24_21-2.png

二、阿里云GPU接口,按实际返回内容估算出网

文本生成接口与图片、视频接口的网络需求差别很大。可以用单位时间完成的请求数乘以平均响应字节数,估算平均出网,再依据高峰分布测试峰值。不能把GPU每秒生成的token数直接当成字节数,因为文本编码、协议和业务字段都会改变传输量。

流式返回还要观察连接持续时间与并发连接数。用户觉得“首个字出现得慢”,可能来自排队、检索或模型预填充,也可能来自网络建立过程。应在服务端分别记录进入请求、开始推理和首个输出的时间;只有传输阶段明显受限,增加公网带宽才对准问题。

在已安装sysstat的Linux实例上,可用下列只读采样观察网卡收发速率。持续10次采样,不产生主动压测流量;应在业务请求发生时运行,并与应用日志对齐时间。

sar -n DEV 1 10

查看对应网卡的接收和发送速率,注意工具显示单位,再与云平台监控核对。某块网卡出现流量,不足以证明流量走公网;容器、虚拟网卡及内网访问会影响观察位置。如果发送速率低而接口仍慢,应回到服务端处理和排队时间继续定位。
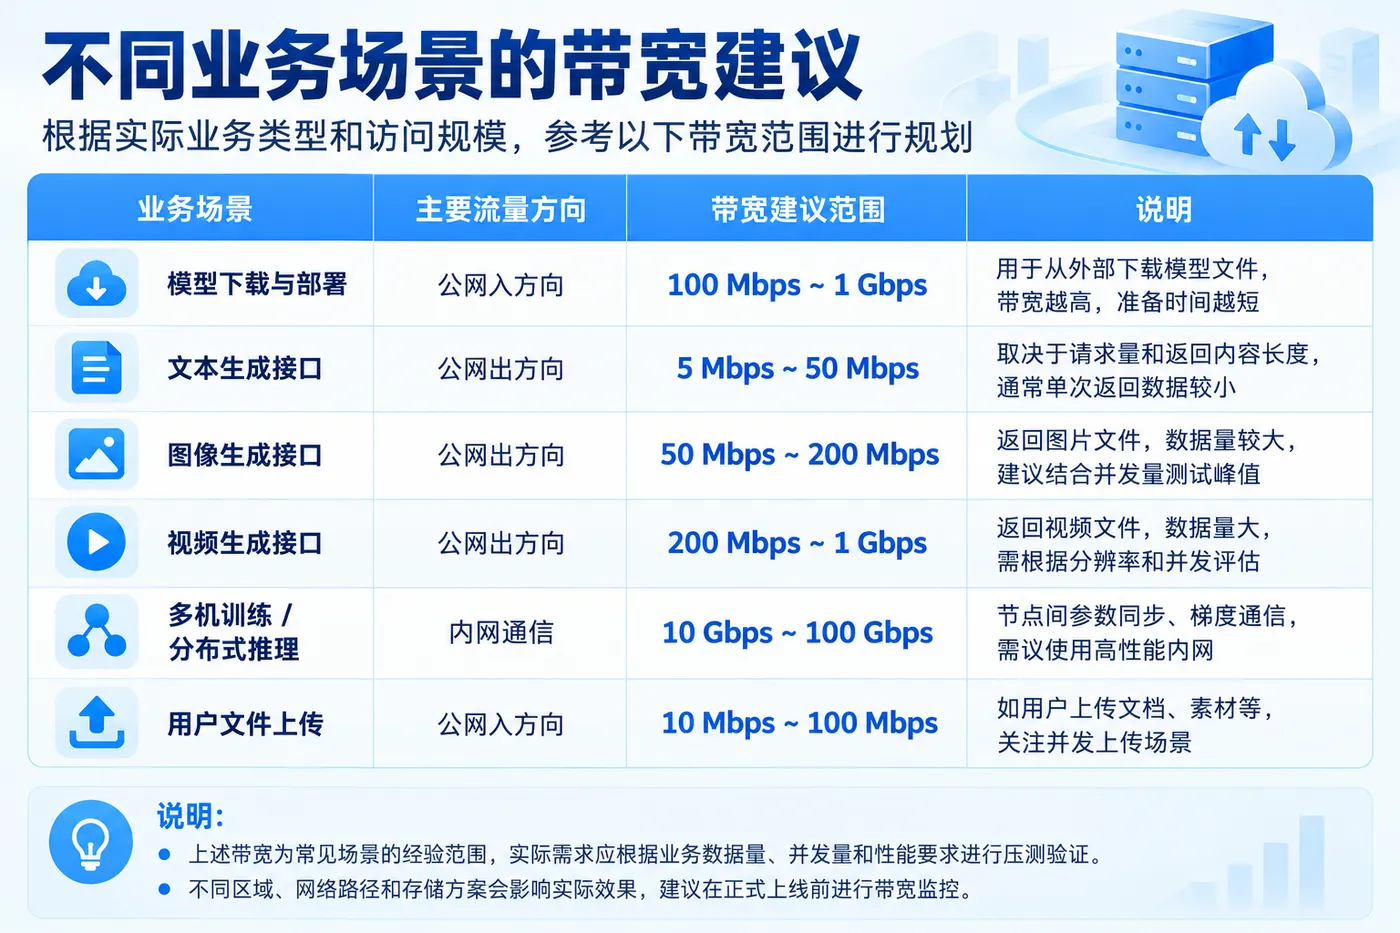
ChatGPT 图像 2026年10月10日 18_24_21-3.png

三、阿里云GPU内网,模型分发与训练通信要分别看

将同一模型分发到多台实例,会形成集中读取压力。可以评估同地域的受控存储与缓存,减少重复经过公网的传输,但仍需核对存储请求、吞吐及计费。模型缓存必须绑定版本与校验结果,不能为了加快启动让不同节点加载到不同权重。

聚搜云参与网络配置评估时,可要求方案分别列明模型准备时间、接口高峰流量和节点间通信需求。三项需求对应不同路径,不能把“增加公网带宽”作为共同处理方法。尤其多卡、多机训练的同步性能,通常需要查看实例内网能力与实际通信配置。

如果只有每天启动时模型分发慢,先评估缓存和预热;如果持续训练出现同步等待,再检查通信链路;如果外部用户下载生成文件慢,则测量出网与响应体积。这样的划分能避免为了一个短时准备过程,全年保有不必要的网络配置。

阿里云GPU服务器需要多大带宽,最终应得到三组有依据的数据:模型准备允许多久、接口峰值传输多少,以及集群通信需要什么能力。带宽配置对应到具体路径后,企业才知道哪里值得扩容,哪里需要修改应用或存储流程。ChatGPT 图像 2026年10月10日 18_24_22-4.png
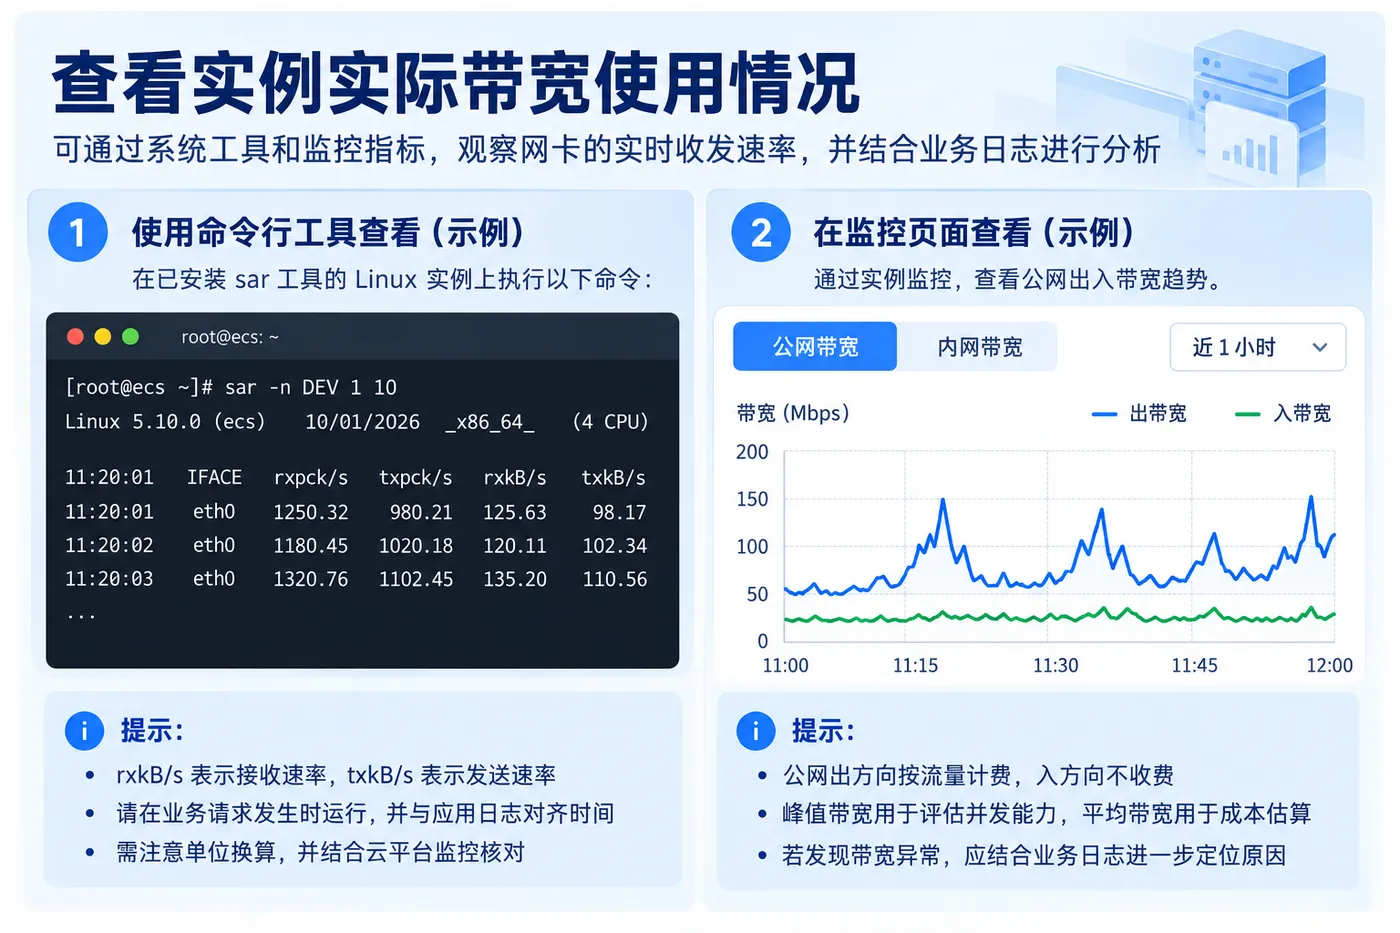
相关文章
|
19天前
|
人工智能 JSON API
全网刷屏的 Jev 模型正式开放!一手实战测评 + 保姆级教程
全网爆火的 Jev 模型是什么?有什么用?怎么使用?怎么接入 AI 编程工具?效果真的好么?傻子可懂的 Jev 保姆级实战教程 + 项目实战测评来啦
8789 25
|
17天前
|
人工智能 并行计算 PyTorch
秋叶 ComfyUI 2026 整合包 v3.2 完整部署教程:Python 3.13 + Torch 2.13 全栈升级
秋叶aaaki ComfyUI 2026年8月整合包v3.2正式发布!全面升级Python 3.13.11、PyTorch 2.13.0+cu130及ComfyUI v0.30.2,原生支持MiniMax H3、Wan 2.2、Qwen-Image-2.1等2026主流音视频/图像模型,解压即用,无需环境配置。
3356 15
|
17天前
|
人工智能 测试技术 API
最近全网爆火的 Jev 到底是什么?适合干什么、怎么用,一篇讲透!
Jev是TypeSafe AI推出的“系统一模型”,不生成文本,专做毫秒级结构化决策:Choice(多选)、Score(打分)、Noul(是非概率)。响应快193倍、成本低444倍,适合工单路由、内容审核、测试定级等高频判断场景。
2196 4
最近全网爆火的 Jev 到底是什么?适合干什么、怎么用,一篇讲透!
|
11天前
|
人工智能 Linux 开发者
【2026国内使用】Codex安装过程一篇讲透(Win/Mac/Linux全支持)
Codex是OpenAI推出的AI编程智能体,可读取本地项目、理解需求并自动修改代码。支持桌面GUI、命令行(CLI)及VS Code/Cursor插件三种形态,覆盖可视化操作、终端高效开发与编辑器无缝集成场景,助开发者用自然语言驱动编码全流程。(239字)
【2026国内使用】Codex安装过程一篇讲透(Win/Mac/Linux全支持)
|
17天前
|
云安全 人工智能 安全
|
3天前
|
人工智能 JSON 自然语言处理
2026 年 Jev 决策模型深度拆解:原理解读、实战测评与保姆级落地教程
有一款特殊AI模型在开发者圈子刷屏,它摒弃传统大模型擅长的对话聊天能力,专注做高速结构化决策,它就是TypeSafe AI推出的Jev模型。该模型由ChatGPT共同发明人Diogo Almeida主导研发,定位为**System One Model(系统一模型)**,对标人类大脑快速直觉判断的思维模式,在响应延迟、调用成本、结构化输出稳定性上相比传统生成式大模型有着巨大差异。本文会完整拆解Jev底层原理、三大核心原语能力、适用业务场景,同时提供可直接运行的curl、Python代码示例,并且结合多组实测数据,客观分析模型优势与能力边界,帮助普通开发者和AI应用从业者快速上手落地。
366 1
|
6天前
|
人工智能 Linux Windows
千问办公(QwenWork)官网入口:其实有2个,一个是网页端千问办公,一个是介绍指南页面
千问办公(QwenWork)是阿里云推出的AI智能办公平台,支持网页端直接使用及Windows/Mac/Linux客户端下载。提供PPT生成、财报分析、网页搭建等AI功能,个人版免费,企业版198元/席/月。详情见官网qwenwork.cn或阿里云产品页。
809 0
千问办公(QwenWork)官网入口:其实有2个,一个是网页端千问办公,一个是介绍指南页面

热门文章

最新文章


