"我们在 AI 里的可见度是多少?"这是个自然的问题,但它本身问错了。
可见性不是一个数字,而是三个机制完全不同、观测方法也完全不同的层次。把它们压进同一个指标里,得到的数字一定自欺。这篇文章尝试给出一套可落地的分层评测框架。
一、先拆开:可见性有三层
Search Engine Land 在 2026 年 9 月的一篇观点文章里,把生成式引擎优化的目标归纳为三个支柱:LLM 可读性、品牌语境、代理式电商。对应到结果层面,正好是三件事:
- 被引用:你的内容进入了模型的检索结果,被当成可引用的信源;
- 被推荐:你的品牌作为实体被提及,并且被正确描述;
- 被选中:在 AI 直接参与决策的场景里,你的产品被选进了答案。
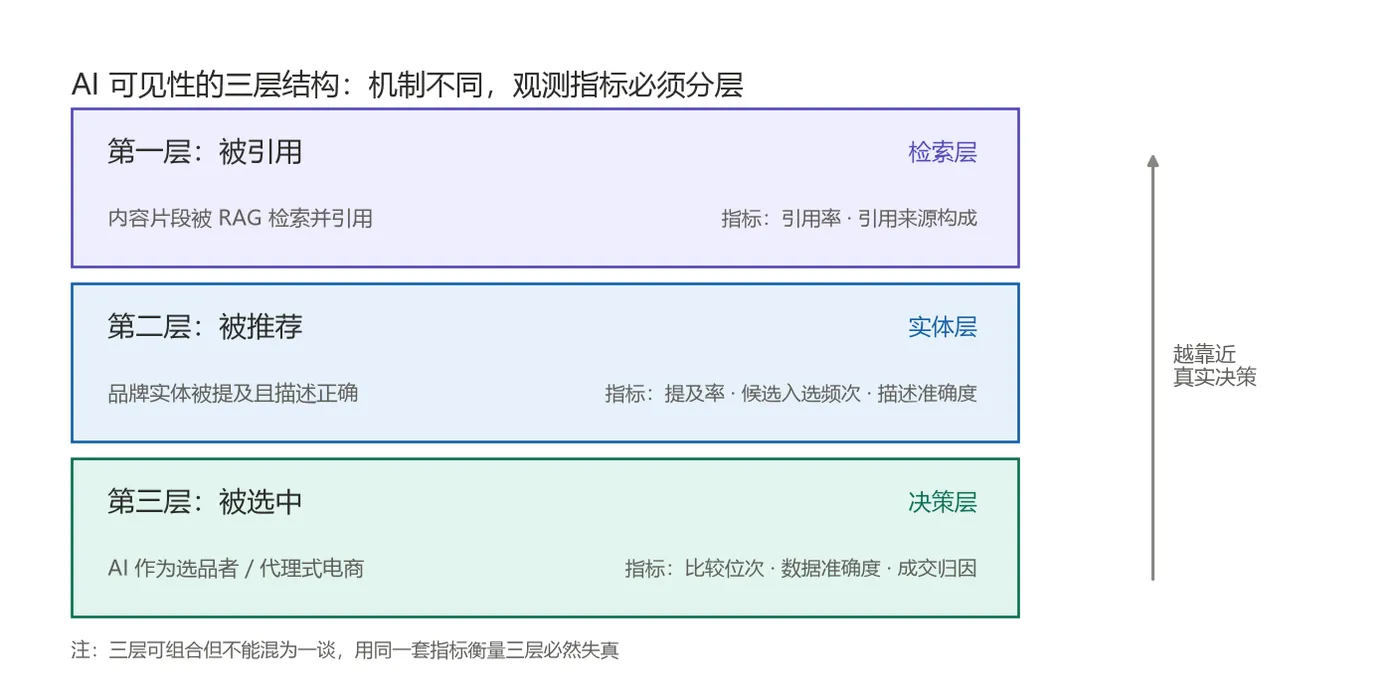
三层可以组合,但必须分开观测。用一个指标衡量三层,最常见的后果是:第一层做得不错,报表却显示"没效果"——因为指标问的是第三层的事。
二、第一层:被引用(检索层)
机制:系统从语料库里召回片段,再把片段拼进上下文生成回答。这一层发生在 RAG 的检索阶段,与"品牌"无关,只与"内容能不能被摘出来"有关。
一个容易被忽略的事实:这一层的成果里可能根本不出现品牌名,只出现你提供的某项数据、某个流程或某个判断。内容被引用不等于品牌被提及——这中间隔着一整套实体建设。
该观测的指标:
- 引用率:固定问题集下,内容被实际引用的比例;
- 引用来源构成:被引用的内容里,来自自有域名、官方文档、白皮书的占比。这个指标比引用率更能反映"可控资产"的建设进度。
对应要做的事:按"用户会怎么问"组织标题与段落,一段只承载一个判断、先结论后依据,把参数、适用范围、限制条件写足。页面层面保持结构清晰、持续更新。
三、第二层:被推荐(实体层)
机制:品牌要作为一个可识别的实体出现在回答里。这一步依赖的不只是内容质量,还有实体识别与消歧——系统需要确认"这个名字指的是哪家公司",以及"它在哪个品类里"。
这里有个工程上很硬的要求:跨源事实一致性。名称、地址、资质、服务范围、成立时间,在不同平台上的表述必须一致。互相矛盾的信息会直接削弱模型的采信度——不是"取多数",而是整体降权。
实体消歧失败的典型表现有两种:一是同名混淆,品牌名与另一个更知名的实体高度重合,模型在生成时把它归到了错误的类目下;二是指称不一致,官网、第三方资料、社交平台上用了不同的简称或译名,模型无法确认它们指向同一个实体,于是分别对待、各自稀释权重。前者要改名或增加限定词,后者要统一指称——这两件事都属于"实体工程",不是内容生产能解决的。
该观测的指标:
- 提及率:品类词、场景词下品牌被提及的比例;
- 候选入选频次:在"有哪些主流方案"这类清单型回答中出现的频率;
- 描述准确度:被提及的时候,说的是不是对的。
第三条最容易被忽略,也最危险——被错误描述,比不被提及更糟。前者会持续污染模型对该实体的认知,且很难自行纠正。
四、第三层:被选中(决策层)
机制:在代理式电商这类场景里,决策主体变了。前两层最终做决定的是人,而这一层里,AI 智能代理正在扮演"选品者"甚至"采购者"。
决定结果的不再是文案质量,而是数据的机器可读性:商品参数是否完整、价格与库存是否准确、能否被结构化地读取和比对。这需要的是商品数据审计与结构化改造,而不是再写一篇稿子。
该观测的指标:
- 在比较类回答中的位次与出现频次;
- 价格、参数等关键字段的准确度(代理会直接拿这些字段做比对,一个错价就可能被淘汰);
- 成交侧的归因口径,需要在观测开始前就约定清楚。
五、评测集怎么设计:四个高频陷阱
指标定了,观测方式同样会决定结果是否可信。有四个坑特别常见:
1. 提示性提问陷阱
问"某某品牌怎么样",答案里几乎必然出现该品牌——这不是可见性,这是同义反复。真正有效的评测必须用品类词、场景词、对比词做无提示提问:不问品牌,看它会不会自己出现。同一套内容,用这两种提问方式测出来的数字可以差出一个量级。
2. 没有基线问题集
"覆盖了多少问题"本身就是核心交付物。建议先固化 10–30 个真实用户会问的问题,作为基线集,之后所有采样都基于同一组问题。问题集一变,前后数据就不可比。
3. 样本量与观察周期不足
生成式回答天然有波动,单点采样没有统计意义。合理的做法是周级或更密的采样,但按季度看趋势,不要按周看起伏——把噪声当成趋势,是最常见的误判来源。
4. 使用不存在的指标
目前没有像搜索排名那样统一公开的后台可查,也不存在稳定的"位次"。任何承诺"AI 排名第几位"的口径都是编造的。可信的指标只有统计量:提及率、引用率、入选频次、准确度,且必须附带采样方式、样本量与时间窗口。
六、写在最后
把可见性压成一个数字,是当下最常见的做法,也是最不可靠的做法。
更稳的路径是:先确认要的是哪一层(最多两层),再把它翻译成一组固定的问题,然后按层定义指标、约定采样口径,最后分层归因。三层混在一张验收单里,问题出在哪一层就永远说不清。
对开发者来说,这其实是一个很标准的评测工程问题:定义清晰的目标层、构造无偏的评测集、用统计量而非单点结果来下结论。
作者长期关注大模型应用与内容生态,以上为结合公开资料的工程观察,欢迎在评论区交流实现细节。