别再给 API 打工:我用 Dify + Ollama + DeepSeek 搭了一套「本地优先、云端兜底」的私有 AI 平台

简介: 15 个 Docker 容器跑起来的私有 AI 平台:本地 Ollama 零成本处理日常任务,DeepSeek API 只兜复杂推理的底,Dify 做编排大脑,双层记忆让 AI 记得住上下文也翻得动历史资料。本文复盘整套架构的分流设计、记忆方案与部署踩坑实录。

15 个 Docker 容器,双层记忆,本地零成本跑日常任务,云端 API 只兜复杂推理的底。这套架构我实际跑了一段时间,把踩过的坑和取舍一次讲清。

一、为什么自建,而不是直接用 SaaS?

市面上的 AI 助手很好用,但当你把简历、求职材料、个人项目数据反复喂给它的时候,三个问题就暴露了:

  • 隐私:敏感个人信息上传到第三方服务器,心里始终不踏实;
  • 成本:日常问答、文本整理这类简单任务,用云端大模型属于「高射炮打蚊子」,token 费纯属浪费;
  • 可控:SaaS 说改版就改版、说限流就限流,自己的平台自己说了算。

但纯本地也有硬伤:小模型跑复杂推理(比如长文分析、多步规划)能力明显不够。所以我的答案是——不二选一,两条通道都要。

二、总体架构:一张图看懂
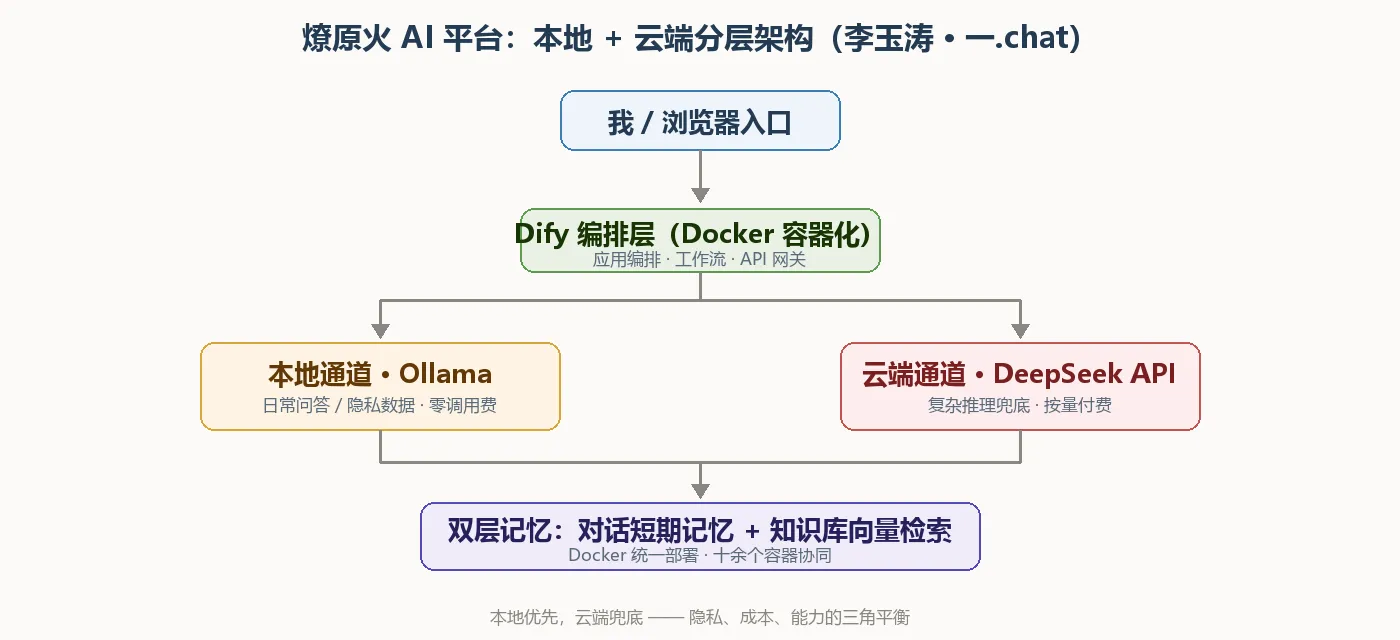
燎原火 AI 平台分层架构图

整个平台分四层:

  1. 用户入口层:统一的对话界面,用户只管提问,不感知后端用了哪个模型;
  2. Dify 编排层:整个平台的「大脑」,负责工作流编排、Prompt 管理、模型路由,全部容器化部署;
  3. 双通道执行层:本地通道(Ollama)+ 云端通道(DeepSeek API),按任务复杂度自动分流;
  4. 双层记忆层:对话短期记忆 + 向量检索长期记忆,让 AI 记得住上下文、也翻得动历史资料。

三、双通道设计:本地优先,云端兜底

这是整套架构里最核心的一个决策。分流逻辑如下:

维度 本地通道 · Ollama 云端通道 · DeepSeek API
成本 电费,约等于零 按 token 计费
隐私 数据不出本机 出网到第三方
延迟 无网络往返,首 token 快 受网络波动影响
能力上限 小模型,复杂推理吃力 强推理,长文本稳
适合任务 日常问答 / 文本整理 / 格式化 深度分析 / 多步规划 / 代码生成

分流原则一句话:简单任务本地跑满,复杂任务才交给云端。 这样一来,90% 的日常请求成本归零,API 费只花在刀刃上。

四、双层记忆:短期会话 + 长期向量

只用聊天记录做上下文,AI 是「金鱼记忆」;只做向量检索,AI 又「失忆」于当前对话。所以做了双层:

  • 第一层 · 对话短期记忆:当前会话的滚动窗口,保证多轮对话连贯;
  • 第二层 · 向量长期记忆:历史资料、往期对话切片后向量化,检索时按语义相关性召回。

两层叠加的效果是:AI 既知道「我们刚才聊到哪」,也知道「你上周让我准备过什么」。

五、部署踩坑实录(都是真实坑)

坑 1:Ollama 模型用完即卸载

本地模型默认推理完就释放显存/内存,下一轮对话要重新加载,延迟暴涨。解法是设置 OLLAMA_KEEP_ALIVE 让模型常驻,代价是常驻内存占用——我按机器配置做了权衡。

坑 2:输出长度被截断

num_predict 参数没调,长回答总是半途而废。这个参数控制最大生成 token 数,默认值偏保守,做长文任务必须显式调大。

坑 3:Docker 容器编排

Dify 全家桶 + Ollama + 向量库 + 中间件,最终跑起来 15 个容器。一开始没理清依赖关系,容器启动顺序错乱导致服务起不来,后来靠 depends_on + 健康检查理顺。

六、写在最后

这套平台的真正价值不在技术多炫,而在于想清楚了一个平衡:

隐私、成本、能力,三者不必全选,分层即可兼得。

如果这篇文章对你有帮助,点赞收藏是最大的支持。有问题欢迎评论区交流。

相关文章
|
2月前
|
运维 监控 安全
国家评测机构首次给智能体分五级:这套五维框架,测试团队明天就能抄成上线验收清单
智能体上线评审常陷“五人五义”困局。全国首个五级智能体评测证书揭示破局关键:将主观判断拆为功能性、稳定性、安全、工程化、场景适配五大可证维度,每维设独立判据与证据链,推动验收从经验走向可审计、可复现、可追责。(239字)
国家评测机构首次给智能体分五级:这套五维框架,测试团队明天就能抄成上线验收清单
|
2月前
|
传感器 监控 安全
施工安全设施检测数据集 | 10600张YOLO智慧工地数据集
该数据集含10600张YOLO格式标注图像,覆盖路障、护栏、锥桶、脚手架、工程机械等9类施工安全目标,专为智慧工地安全巡检与预警设计,适配YOLOv5-v12等主流模型,支持训练高鲁棒性检测系统。(239字)
|
2月前
|
存储 人工智能 并行计算
新手小白如何购买阿里云GPU云服务器?新版阿里云GPU云服务器产品功能介绍及配置价格表
随着大模型推理、模型微调、AIGC生成、科学仿真、3D渲染等业务快速普及,越来越多个人开发者、学生、小型研发团队开始接触云端GPU算力。对于刚刚接触GPU云服务器的新手来说,面对繁多的实例规格族、不同GPU芯片型号、显存参数、多种计费模式,很容易踩坑。很多用户会出现显存选小跑不通模型,盲目选购高端实例造成高额账单,忽略GPU驱动安装、可用区库存限制、安全组端口配置等关键环节,购买完成之后实例无法正常识别显卡,甚至产生意料之外的高额扣费。
473 7
|
2月前
|
人工智能 缓存 监控
QoderWake联合云电脑:让数字员工随时待命工作
QoderWake联合无影云电脑上线,为数字员工Waker提供持久化云端运行环境:关机不中断任务、远程实时查看与接管操作、环境状态自动保留。支持浏览器/终端/桌面全场景自动化,适用于竞品监控、夜间构建、定时报表等长时任务。
357 0
|
2月前
|
人工智能 自然语言处理 数据挖掘
AI时代来了!智能数据分析工具推荐与未来趋势
本文聚焦阿里云瓴羊Quick BI的AI进化,解析其“智能小Q”三大Agent如何实现自然语言问数、智能解读与自动报告,推动数据分析从“人找数据”迈向“数据找人”,助力企业构建高效、可信、可复用的数据决策闭环。(239字)
|
7天前
|
人工智能 弹性计算 双11
2026年阿里云双11热门产品优惠活动:大模型4.5折起、云服务器38元起,Token Plan79元起、AI建站9.9元起‌
2026年双11活动,阿里云围绕"AI生产力普惠"与"云上成本优化"两条主线,释放大模型、Token Plan、AI建站、云服务器四大板块优惠:全模型通享低至4.5折、首购10元起;Token Plan个人版纳入12项Harness权益,79元/月起、团队版150元/月起;万小智3.0建站9.90元/月起;云服务器覆盖38元轻量至13.8万元GPU旗舰,99元、199元档续费同价。多数支持先领券再下单。
|
3月前
|
消息中间件 存储 安全
RocketMQ 高可用创新论文入选 ACM FSE:无需复制业务数据,实现有状态服务秒级接管
面向云上有状态服务高可用,提出无需额外业务数据复制的秒级故障接管机制,在不牺牲成本和稳态性能的前提下,实现云上有状态消息服务的快速恢复。
297 15
|
3月前
|
弹性计算 安全
阿里云服务器ECS按流量计费的话,1GB流量多少钱?流量超出会怎样?
阿里云ECS按流量计费仅对出网流量收费,各地域单价不同:北京/上海/杭州等为0.8元/GB,青岛0.72元/GB,海外低至0.5元/GB。超量不限速,但欠费将暂停公网访问。详情见官网定价页。阿里云服务器ECS官网:https://t.aliyun.com/U/AZBUsA
|
3月前
|
人工智能 弹性计算 安全
AI 网关能力评估解读:从七大板块看 AI 网关如何接住大模型流量
信通院将“AI网关”纳入可信云评估体系,确立七大能力板块、24项子能力,推动其从营销概念走向可测、可评、可证的标准化能力品类。本文聚焦工程实践,剖析AI网关如何解决流式Token计费、智能体多跳调用等核心难题,并解读“接得住、管得住、护得住”三层能力本质。
287 7