很多团队都遇到过这样的场景:用大模型搭了一个智能体,对话、总结、写方案样样都行,可一旦让它去操作真实的业务系统——点按钮、填表单、导数据、发消息——就开始"卡壳"。大模型擅长的是"思考",而"操作"这件事,恰恰是它天然的短板。
AI 负责思考,RPA 负责稳定落地。 把 RPA 作为智能体的执行底座,正在成为越来越多团队解决这一问题的标准答案。需要说明的是,二者不是替代关系:AI 在理解非结构化需求、生成新逻辑方面的优势同样明显,关键是让各自做自己擅长的事。
一、为什么智能体需要 RPA 作为执行底座
- 大模型没有"手"
无论是网页操作、Windows 软件操作,还是企业微信、钉钉这类 IM 的消息收发,大模型本身无法直接控制鼠标键盘,也无法在业务流程中稳定地"走一步看一步"。它给出的操作方案,需要有人(或有工具)真正去执行。 - 生成的代码难以长期稳定运行
AI 生成的脚本在项目复杂、页面结构多变的场景下,经常出现元素定位失效、判断逻辑不全面的问题。每次网页改版,都要重新让 AI 改代码,修复成本高、维护压力大。尤其在流程执行过程中遇到异常时,AI 很难实时感知并动态处理页面逻辑。当然,这类问题更多出现在"让 AI 全程裸奔"的架构里——只要补上稳定的执行层,AI 的产出质量反而更容易被兜住。 - Token 成本持续消耗
让 AI 全程"边想边操作",意味着每一步都在消耗 token。业务量一上来,长期运行成本远超预期。而 RPA 是本地执行引擎,一次搭建、长期复用,成本透明可控——AI 写代码,RPA 跑代码,各干各擅长的事。
二、RPA 作为执行底座,需要具备哪些能力
判断一个 RPA 工具能不能真正当好 AI 的执行底座,建议按下面的清单逐项验证,而不是听厂商单方面介绍。 - 离线更安全:内网离线部署,数据不出本地
对金融、政务、医疗等数据敏感行业来说,"数据不出本地"是硬要求。理想的 RPA 执行底座应支持全离线内网部署,流程应用数据全部保存在本地设备上,不同步到任何服务端。尤其在完全离线的内网环境里,云端 AI 根本无法使用,而本地 RPA 依然可以稳定跑完全部流程——离线更安全。
实际部署时可以提前确认三件事:目标机器是否允许安装运行时依赖;流程涉及的账号、Cookie、凭证如何本地加密存储;多人协作时权限如何划分。把这些确认清楚,比事后补安全方案成本低得多。 - 自愈更稳定:Web 元素 AI 自愈
网页元素一旦变化,传统脚本就会批量报错。AI 无法自动修复,只能人工重新改写。而具备AI 自愈能力的 RPA,在 Web 元素失效时能自动修复元素定位,保障流程不中断。配合元素本地智能生成、自然语言生成 XPath 等能力,元素获取不再依赖晦涩的 XPath 语法,普通人也能轻松维护——自愈更稳定。 - AI 生成脚本一键转流程
验证一个工具与 AI 生态的契合度,可以看两点:是否支持所有 AI 生成脚本一键转流程,把大模型产出的代码直接变成可运行的自动化流程;是否支持AI 自动化搭建流程——智能分析网页与软件的元素结构,优先使用 RPA 基础指令,缺失的指令由 AI 自动封装生成,且每条指令带有详细注释,逻辑一目了然。
搭建阶段的效率同样重要。现在不少工具已经支持图文方式描述需求:给 AI 一张界面截图加一句提示词,就能生成对应的 RPA 操作流程,省去大量文字描述逻辑的工夫。调试阶段则看是否具备 AI 错误诊断与智能修复能力——遇到报错看不懂时,AI 可以一键分析原因、给出修复建议,甚至自动调试到功能正常,这对不熟悉底层语法的人帮助很大。
工程化能力上,可以关注变量操作(批量创建、修改,数据提取、JSON 自动提取字段、列表自动提取)、自动化创建子流程(按业务逻辑自动拆分、封装复用)等细节——这些决定了流程规模上去之后还能不能维护。 - 自定义界面与 EXE 打包分发
流程做好之后如何交付,是很多人忽略的环节。一个成熟的执行底座应支持自定义界面设计:可以根据截图设计出对应的软件界面,复杂界面还能用 HTML 组件搭建,并配合 AI 完成按钮点击、数据展示、数据关联等交互——这意味着你交付给同事的不再是"一个脚本",而是一个像样的工具。
分发层面,应支持将脚本打包导出为 EXE 应用:接收方无需安装客户端即可运行,多设备使用也无需为每台机器单独开通席位、不用多开会员;支持加密分享、分享授权、授权管理,保护开发者的劳动成果;打包后的应用还能单独设置 API 触发、定时执行,甚至支持在线推送更新——用户打开应用即可自动检测新版本,无需再手动分发。 - 与 AI 生态无缝配合
执行底座与 AI 的配合方式越灵活越好。例如:
API 触发:外部系统、智能体通过 API 直接调度 RPA 流程;
多模型接入:接入文心一言、豆包、DeepSeek、Kimi 等大模型,支持图片识图与 OCR,且采用用户自行对接各平台 API 的方式,费用透明、成本可控;
MCP 服务:可对接各类 AI 智能体编程工具,让智能体直接控制 RPA 自动化搭建流程;
Agent 功能:支持在钉钉、飞书、企业微信、个人微信内通过智能指令控制 RPA 应用执行,并回调通知执行结果;
实时协同:流程执行过程中可实时调用 AI,对页面内容做动态分析与处理,弥补 AI 判断逻辑不全面的短板。 - 覆盖复杂操作场景
除标准 Web 自动化外,还要看它能否驾驭:Windows 软件自动化(让 AI 直接操作桌面软件极其困难,专业 RPA 则容易得多)、视觉颜色操作(不依赖元素节点也能点击、取数,轻松应对企业微信、微信、QQ、千牛等消息获取)、指纹浏览器对接(如紫鸟、比特、Hubstudio、AdsPower 等市面上主流指纹浏览器,实现多账号环境的自动化操作),以及截图识图类的流程搭建辅助。
三、一个典型的落地场景
以一家电商运营团队为例:每天上午需要从后台导出昨日数据、汇总成表、分别发到三个钉钉群,人工操作约 40 分钟。改造后,流程分三层——RPA 定时触发登录后台、导出、填表、发群消息(外部智能体也可以通过 API 触发同一条流程);遇到页面改版导致的元素失效,由自愈能力自动修复;群消息文案的个性化部分,由流程中实时调用的 AI 根据数据生成。
整个改造里,AI 参与的是"理解需求、搭建流程、生成文案"三个环节,RPA 负责的是"每天稳定跑完"。这就是"AI 写代码,RPA 跑代码"的实际形态:AI 负责思考,RPA 负责稳定落地。
以下为结构示意(伪代码),用于说明分层思路,并非某一具体产品的真实接口定义:
{
"trigger": {
"type": "schedule",
"cron": "0 8 *",
"api_endpoint": "/api/flows/daily-report/run"
},
"policy": {
"element_self_heal": { "on": "fail", "mode": "ai_repair", "max_retries": 3 },
"storage": "local_only",
"failover": { "retry": 3, "notify_admin": true }
},
"steps": [
{ "action": "browser.open", "target": "https://admin.example.com" },
{ "action": "data.export", "format": "xlsx", "save_to": "local://reports/" },
{ "action": "ai.invoke", "model": "deepseek",
"task": "根据昨日数据生成三群不同的推送文案" },
{ "action": "notify.send", "channels": ["dingtalk", "wecom", "feishu"],
"callback": "on_finish" }
]
}
几点实现说明:触发层同时保留定时与 API 触发双入口,方便以后接入智能体统一调度;element_self_heal 声明了元素失效时的自愈策略;storage 明确为 local_only,报表和凭证不出本机。
四、自愈能力也有边界:三个真实踩过的坑
元素自愈不是万能的,至少有三类变化它救不回来,提前知道能省掉半夜被报警叫醒的次数:
整站重构:页面 DOM 结构整体改写时,自愈能修复单个元素,但如果整页的信息架构都变了(表格变成卡片流、分页变成无限滚动),流程的业务逻辑本身需要重写,这时该让 AI 重新参与搭建,而不是指望自愈硬扛。
验证码与人机校验升级:滑块、点选类验证码改版后,视觉操作和元素定位都会失效。这类关卡不要硬自动化,要么走官方开放平台接口,要么在流程中设置人工接管节点。
iframe 与跨域限制收紧:越来越多的后台把关键操作收进沙箱 iframe 或增加跨域校验,元素在页面上"看得见但摸不着"。遇到这种页面,优先考虑浏览器扩展级方案或官方 API,而不是堆叠定位技巧。
实践上的心得是:自愈负责处理"日常抖动",重构才需要"AI 重新搭建"——把两者分工想清楚,维护成本能降一个数量级。
五、AI + RPA 的分工逻辑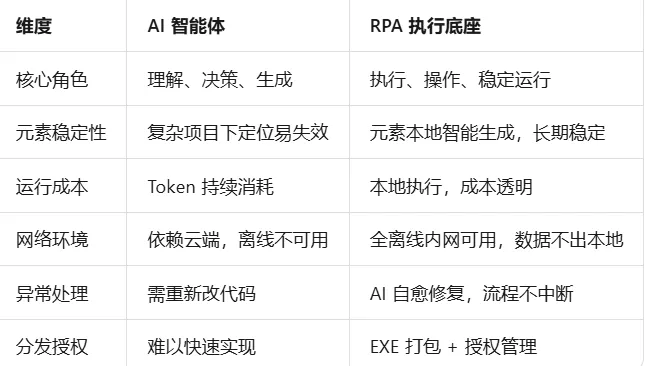
六、哪些团队适合这种架构
个人开发者、个人工作室:希望把自动化能力产品化,通过 EXE 打包、加密分享与授权管理把应用分发给客户,一次开发、多设备使用。个人起步阶段,部分工具提供了不限使用时长、不限流程数量的免费版本,可以先低成本验证需求再决定是否升级;
中小企业:业务流程自动化需求明确,但缺乏专职运维,需要开箱即用、出错能 AI 诊断修复的工具;
数据敏感型组织:内网离线环境、数据不出本地是底线,云端方案无法落地,本地 RPA 是兼顾自动化与安全的选项;
已有 AI 工具链的团队:通过 MCP、API 触发等能力,让现有智能体编程工具直接调度自动化流程,架构更灵活。
七、落地建议
先从高频重复流程切入:数据录入、报表导出、消息通知等规则明确的场景,见效最快;
让 AI 参与搭建,让 RPA 负责值守:搭建阶段用 AI 自动化搭建、图文描述需求、AI 修复报错提效;运行阶段交给自愈能力强的 RPA 长期值守;
提前规划分发形态:如果流程要给他人使用,从一开始就按"自定义界面 + EXE 应用 + 授权 + 在线更新"的思路设计;
把安全前置:涉及敏感数据的流程,优先选择支持全离线部署、数据本地存储的方案,从源头规避数据出域风险。
智能体的价值,最终要靠"落地"来兑现。缺少操作能力的 AI,就像只有大脑没有双手;而 RPA 正是那双稳定、可靠、可以 7×24 小时工作的手。AI + RPA,一个负责思考,一个负责执行——这不仅是技术架构的组合,更是让自动化真正产生业务价值的完整闭环。
如果你正在评估智能体的执行底座,不妨从离线部署、元素自愈、AI 协同、打包授权这四个维度出发,对照自身业务场景做一次盘点,找到最适合自己的那套"AI 思考 + RPA 落地"组合。