
一条 join 落在集群上,可能走四种完全不同的算法,代价差出一个量级甚至更多。
选哪一种的不是你,是 Spark 自己,依据是它手里那份统计信息。
统计信息大概率是估的,估歪了计划不会报错,只会换一条更贵的路走下去,一路走到笛卡尔积也没人提醒你。
下面的参数与默认值全按 Apache Spark 4.x 的口径。
一. 谁在替你选,什么时候定下来
物理规划阶段有一个专门挑 join 算法的策略类,4.x 里是 SparkStrategies.scala 的 JoinSelection。
它拿到两棵逻辑计划树和自带的统计信息,产出一个物理算子,定完就进执行阶段。
判据读的是 plan.stats.sizeInBytes,那张表在这一刻被认定的字节数。
它可能是昨天 ANALYZE 出来的,可能是按文件大小猜的,可能是过滤条件估出来的一个比例,唯独不可能是刚称过的真重量。
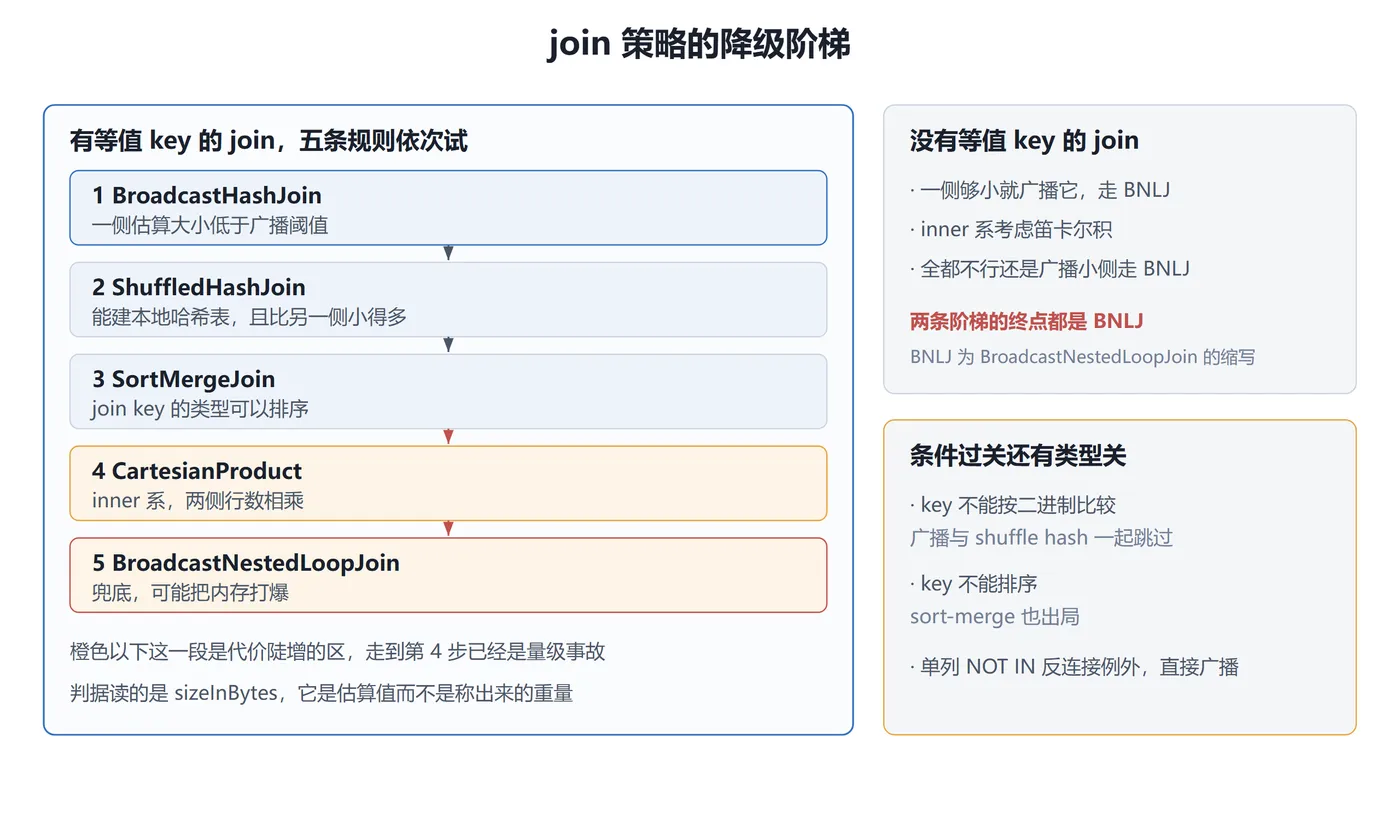
没有 hint 的时候,源码注释把顺序写死了,五条规则一条条往下试。
- 有一侧小到能广播,且 join 类型允许广播这一侧,走 BroadcastHashJoin
- 有一侧小到能在本地建哈希表,且比另一侧小得多,同时
spark.sql.join.preferSortMergeJoin是 false,走 ShuffledHashJoin - join key 的类型能排序,走 SortMergeJoin
- join 类型是 inner 系,走 CartesianProduct
- 前面全不走,走 BroadcastNestedLoopJoin,注释原话是这一步可能 OOM,但没有别的选择
计划里的节点名和源码算子类一一对应,BroadcastHashJoin 是 BroadcastHashJoinExec,SortMergeJoin 是 SortMergeJoinExec,ShuffledHashJoin 是 ShuffledHashJoinExec,BroadcastNestedLoopJoin 是 BroadcastNestedLoopJoinExec,CartesianProduct 是 CartesianProductExec。
没有等值 key 的 join 走另一条阶梯,先看一侧能不能广播,能就 BroadcastNestedLoopJoin,inner 系再考虑 CartesianProduct,最后仍回到 BroadcastNestedLoopJoin 广播较小那一侧。
两条阶梯都收在这张兜底网里。
二. BroadcastHashJoin,赌的是那一侧真的小
自动触发靠 spark.sql.autoBroadcastJoinThreshold,4.x 文档给的默认值是 10MB,判据是 sizeInBytes 不超过它,设成 -1 就把广播这条路整个封掉。
省掉的东西很诱人,小表发到每个 executor 内存里,大表边读边在 map 端配对,没有 shuffle,也没有排序和跨节点搬运。
成本分三段,都能在源码里指着看。
driver 先把整张小表收上来,走 executeCollectIterator,这一步受 spark.driver.maxResultSize 约束,4.x 默认 1g,超了作业直接失败。
收上来要建成哈希表或数组,指标是 time to build,建完分发出去的指标是 time to broadcast,等它的上限是 spark.sql.broadcastTimeout,默认 300 秒。
到了 executor 侧,这张表每个 executor 存一份,是乘法关系的内存占用。
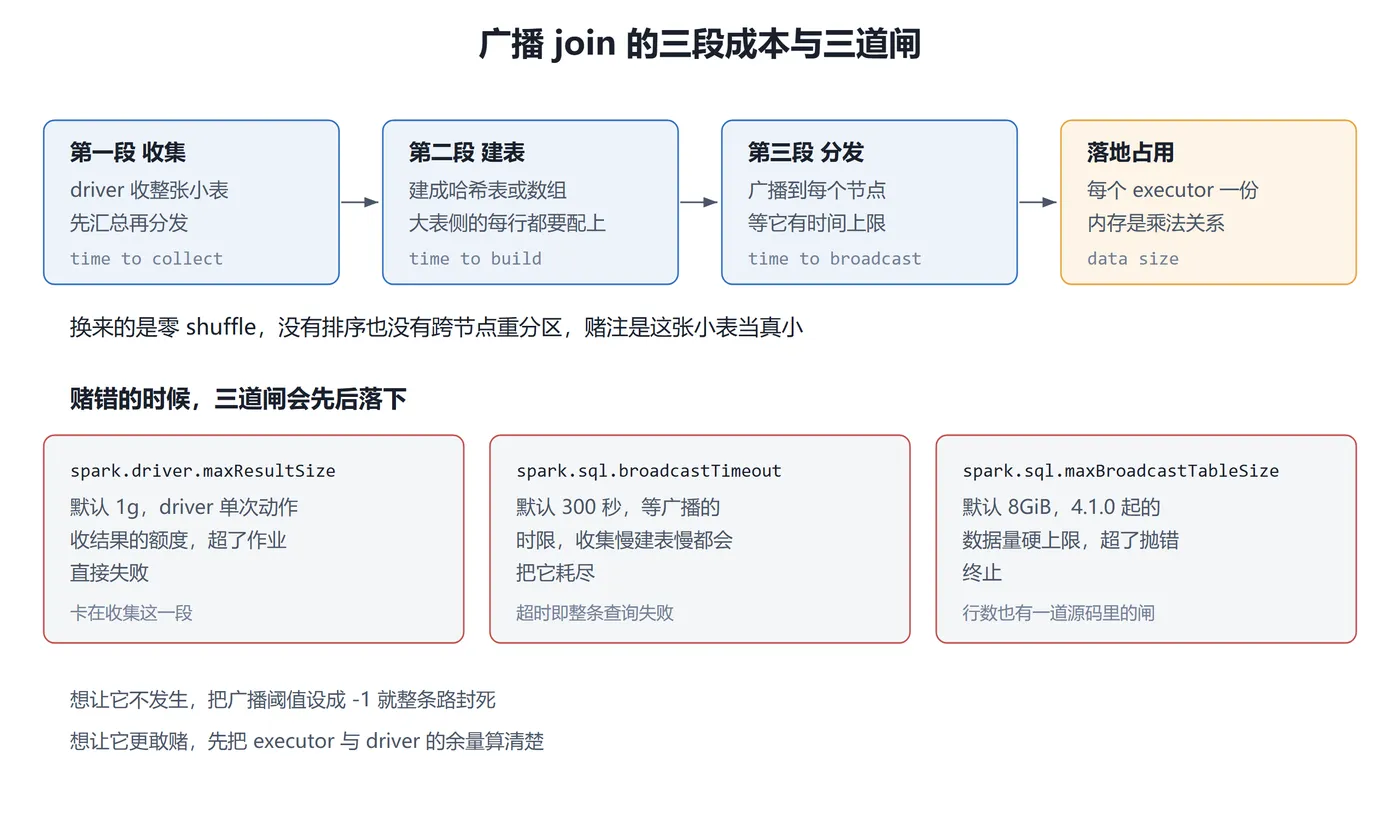
4.1.0 起多了一道硬闸,spark.sql.maxBroadcastTableSize 默认 8589934592 字节即 8GiB,广播数据超过它就抛错终止,不给你慢慢 OOM 的机会。
行数上也有一道,写死在 BroadcastExchangeExec,走哈希表那条路的按 BytesToBytesMap 容量上限折算,其余情况是 512,000,000 行。
哪一侧能当广播侧不是想当然的。joins.scala 里 canBuildBroadcastLeft 只放行 inner 系和 right outer,canBuildBroadcastRight 放行 inner 系、left outer、left single、left semi、left anti 和 existence。
也就是说 left join 的左表不能广播,左表要保行,广播补不上缺失配对,想广播只能改 SQL。
三. SortMergeJoin 是兜底,不是最优
两边的 key 各自排序再像拉链一样归并配对,这是 sort-merge join。
它是大表 join 最常见的落点,原因不在它快,在于它几乎总是可用,RowOrdering.isOrderable 过线就轮到它。
代价是两块,两侧各排一次序,大表排序是磁盘和外溢的常客,两侧又都要按 key 做 hash 重分区,分区数由 spark.sql.shuffle.partitions 决定,默认 200。
4.x 里有一件事和很多老笔记不一致,spark.sql.join.preferSortMergeJoin 的默认值是 true。
这个键在源码里标了 internal,不在公开配置表的列面上,默认 true 意味着即便 ShuffledHashJoin 的条件全满足,规则二也被堵死,sort-merge 仍是默认落点。
3.x 时代它默认 false,从那时候留下来的调优清单会误导人。
sort-merge 最典型的翻车姿势是倾斜。
hash 分区按 key 哈希投递,同一个 key 的所有行必须落到同一个分区,一个热点 key 就能把那个分区撑成别人的一百倍。
AQE 判倾斜是两道线,spark.sql.adaptive.skewJoin.skewedPartitionFactor 默认 5.0 配上 spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes 默认 256MB,两道同时过才动手拆。
一道都没过的热点分区,sort-merge 原样交给一个 task,199 个分区先跑完,剩它一个啃撑爆的那份,stage 的墙钟被它定住。
认它有三个位置。
Stages 页最慢 stage 的 Summary Metrics 里,task 耗时的 max 和 median 差出一个量级是信号,再对一眼这些慢 task 的 Shuffle Read Size 是不是同时也是最大的那几个。
4.x 的 stage 详情页没有替你标好倾斜的徽标,只能自己读数字。
AQE 真动手拆过的分区,露面在 SQL 页执行计划里,节点是 AQEShuffleRead,描述里写着 skewed。
四. ShuffledHashJoin,三条线同时过才轮到它
它和 sort-merge 的区别只有一个,不排序。
两侧照样 shuffle 到同一批分区,然后在分区内直接建哈希表配对,省掉排序,代价是每个 task 要在自己内存里立一张哈希表。
joins.scala 里这条路的判据是三个条件叠起来的。spark.sql.join.preferSortMergeJoin 必须是 false,4.x 默认 true,这一条默认就把门堵上了。
build 侧的 sizeInBytes 要小于 spark.sql.autoBroadcastJoinThreshold 乘以 spark.sql.shuffle.partitions,按默认值是 10MB 乘 200。
build 侧的 sizeInBytes 乘 spark.sql.shuffledHashJoinFactor(默认 3)还要不大于另一侧。
后两条一条管绝对量一条管相对比例,都是字节口径,源码里没有行数参与这道判断,想显式点名就挂 SHUFFLE_HASH hint。
AQE 那条转换路默认也是死的,spark.sql.adaptive.maxShuffledHashJoinLocalMapThreshold 默认 0,还要求它不小于 spark.sql.adaptive.advisoryPartitionSizeInBytes(这个配置自身不给默认值,源码里是回落到内部键 spark.sql.adaptive.shuffle.targetPostShuffleInputSize 的 64MB),不动配置永远不会触发。
从计划里认它看节点名 ShuffledHashJoin,后面跟着 BuildLeft 或 BuildRight 标出建表侧。
选错的信号集中在内存,这个 stage 的 task 峰值内存和 Spill Memory 一起抬高,Shuffle Read 总量看着并不离谱,就是单个分区装不下。
它比 sort-merge 更怕倾斜,同一个热点 key,sort-merge 是慢,shuffled hash 是建表建到 OOM。
五. 退化成 BroadcastNestedLoopJoin 和笛卡尔积的,是条件的形状
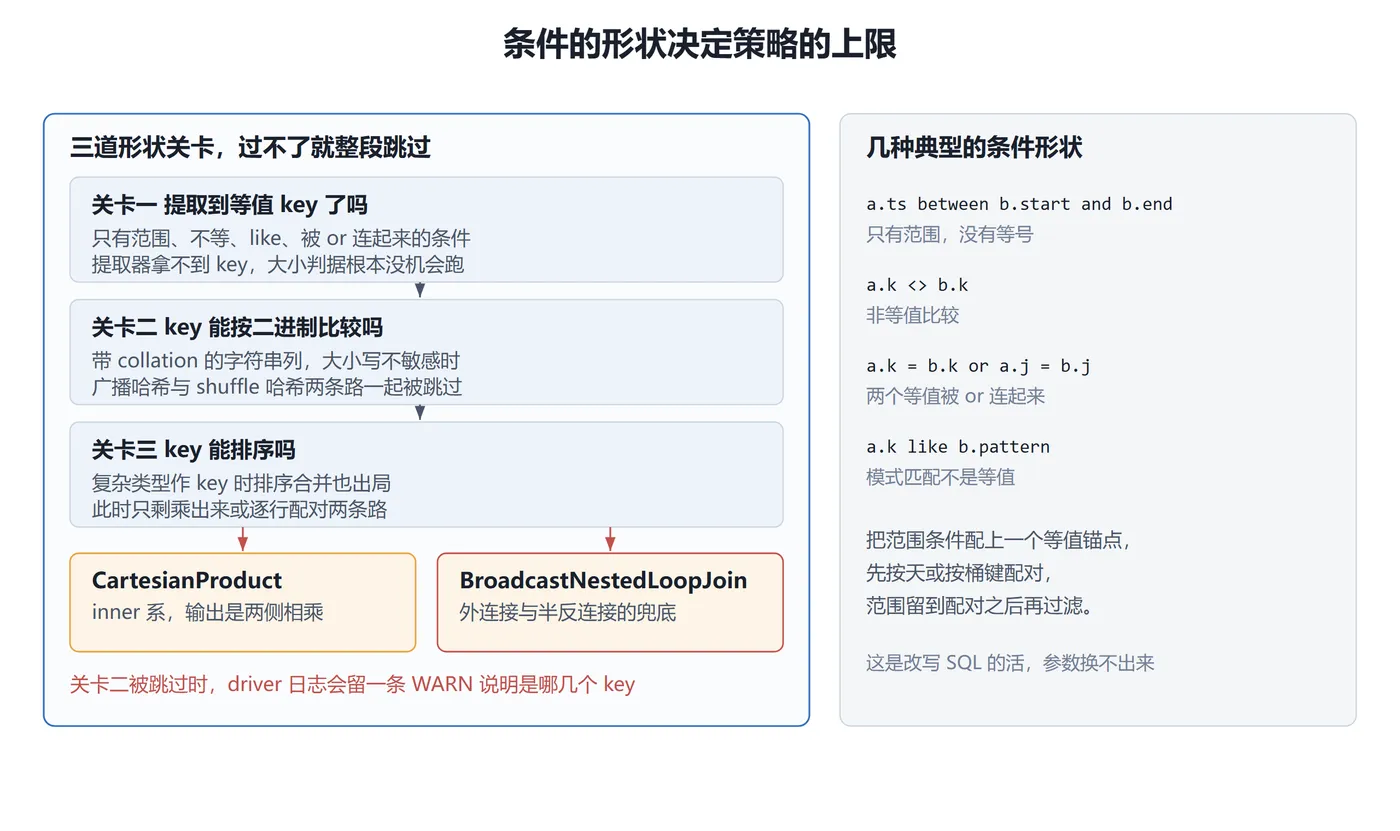
这一类降级和大小无关,是形状问题。ExtractEquiJoinKeys 匹配不到等值 key,等值那整段规则就直接跳过,不管你的表多小。a.ts between b.start and b.end 只有范围没有等号,a.k <> b.k 和 a.k like b.pattern 都是非等值比较。
形状过关了还有类型这一关,这一关在 4.x 是新添的。hashJoinSupported 要求所有 join key 的类型满足 UnsafeRowUtils.isBinaryStable,Spark 4.0 起字符串列带 collation,大小写不敏感或重音不敏感的字符串比较没法直接比二进制,这类 key 会把 BroadcastHashJoin 和 ShuffledHashJoin 两条路一起跳过。
跳的时候 driver 日志打一条 WARN,原文是 Hash based joins are not supported due to joining on keys that don't support binary equality,后面跟着具体哪几个 key 和它的类型名。
搜这条 WARN 是识别此类降级最快的入口。
key 能哈希但没法排序也一样出事,RowOrdering.isOrderable 过不去,sort-merge 也关掉,于是只剩最后两条。
inner 系走 CartesianProduct,两侧一行配一行地乘出来,其余 join 类型走 BroadcastNestedLoopJoin,把较小的一侧广播出去逐行配对。
指标上的特征很醒目。
CartesianProduct 和 BroadcastNestedLoopJoin 都只有一个 metric,名字是 number of output rows。
前者的输出量级是两侧行数相乘,一千万行配一万行就是中间那一千亿行,这个数字直接写在节点指标上,不用猜。
后者更隐蔽,输出行数被条件过滤后看着不大,但每个 task 都把整张广播表重扫一遍,task 时间均匀地长而没有哪个特别慢,这种要看 stage 总耗时和 Task State 里 REMAINING 的分布。
单列的 NOT IN 子查询是个例外,4.x 里由 ExtractSingleColumnNullAwareAntiJoin 兜住,命中就直接生成 BroadcastHashJoin ... LeftAnti 广播右侧,不查大小也不查阈值。
六. 计划里写的那一行,可能不是跑出来的那一行
spark.sql.adaptive.enabled(默认 true)开着的时候,物理规划定下来的那份计划文本只是草稿,它在每个 shuffle 边界拿落地的真实数字重跑一遍选择。
改判有三个方向。
一侧的真实字节数掉到广播阈值以下,sort-merge 换成 BroadcastHashJoin,阈值 spark.sql.adaptive.autoBroadcastJoinThreshold 默认沿用非 adaptive 那份,换完广播 spark.sql.adaptive.localShuffleReader.enabled(默认 true)让 Spark 尽量本地读 shuffle 文件。
所有 post-shuffle 分区都低于 spark.sql.adaptive.maxShuffledHashJoinLocalMapThreshold,sort-merge 换成 shuffled hash,这道默认 0,等于默认不走。
一侧 map 统计里的非空分区比例低于 spark.sql.adaptive.nonEmptyPartitionRatioForBroadcastJoin(internal 键,默认 0.2),它就被判掉广播资格,DynamicJoinSelection 挂上 NO_BROADCAST_HASH 改走 shuffle join,理由是空分区多时大量 task 一侧为空立刻返回,shuffle join 反而快。
关键在 AQE 只改判它看得见的那一侧。DynamicJoinSelection 匹配的是携带 MapOutputStatistics 的 shuffle query stage,从没经过 shuffle 的 leaf 扫描,在 AQE 眼里仍是编译期那份估算。
小表侧是直接从盘上读进来的维表时,广播决策从头到尾用的都是估算值,估歪了没人纠正,一路开到 BroadcastExchange 让 driver 收全表。
ANALYZE TABLE ... COMPUTE STATISTICS 是全量收集,带 NOSCAN 只收字节数不扫数据。
表元数据里没有统计时 spark.sql.statistics.fallBackToHdfs 默认 false,而它只对非分区的 Hive 表有意义,分区表和其它数据源走另一套粗估。
列级直方图靠 spark.sql.statistics.histogram.enabled,默认 false,没开它,过滤后的行数只能按启发式猜。
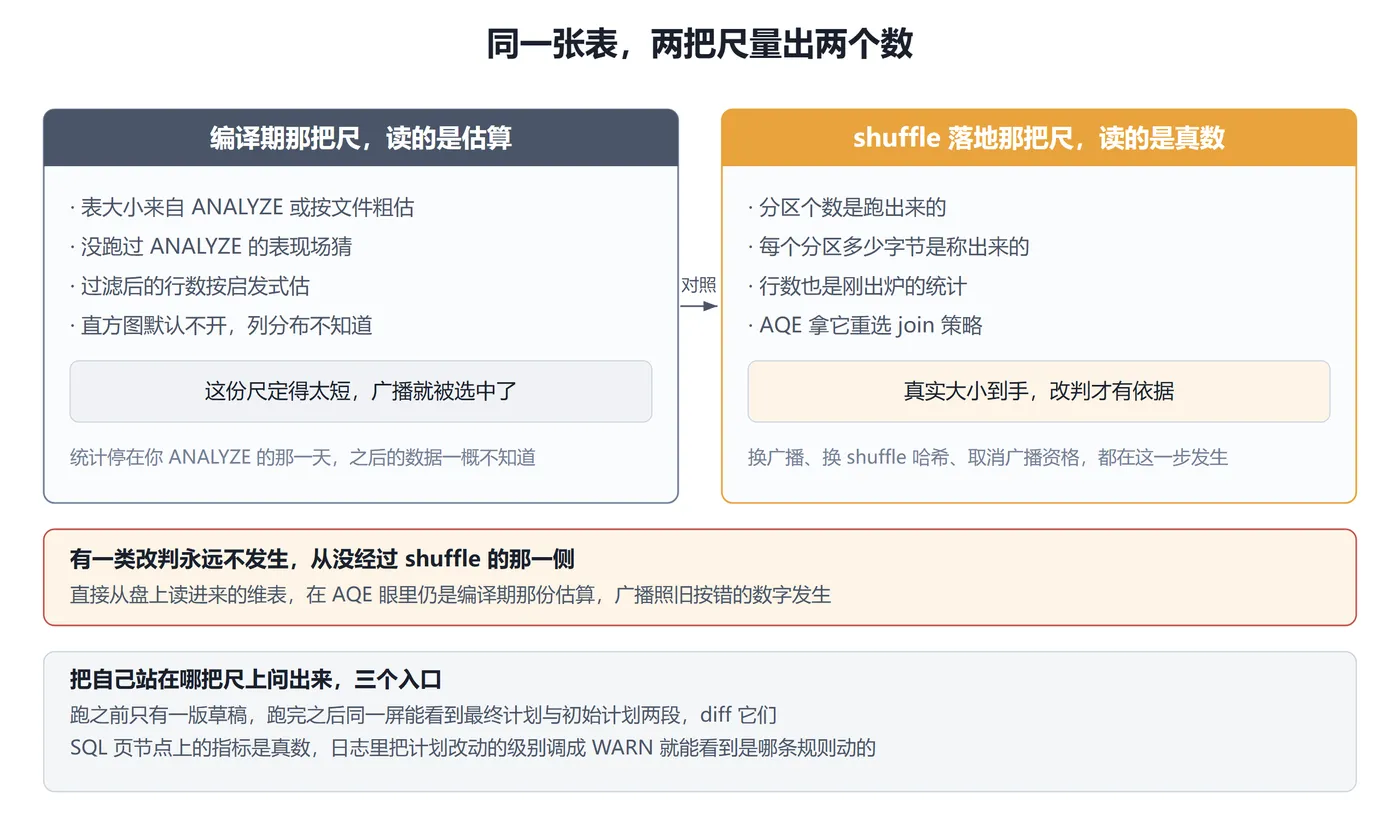
想知道自己站在哪一把尺上,有三个入口。EXPLAIN FORMATTED 在执行前顶层是 AdaptiveSparkPlan isFinalPlan=false,执行后取会切成 true,同屏给出 == Final Plan == 和 == Initial Plan == 两段,diff 它们就是改判的凭据。
Spark UI 的 SQL 页节点挂的指标是跑出来的真数,和计划文本里那行估算对照,估得离不离谱一眼可见。spark.sql.planChangeLog.level 设成 WARN 能把每条规则对计划的改动写进日志,4.x 源码默认 TRACE 也就是不打,配 spark.sql.planChangeLog.rules 只留 join 相关的规则。
七. 判据和动手边界
判错的时候按这个顺序读,别一上来翻配置。
先读计划里的 join 节点名,落在哪一格就回去对上面那一节的条件。
再读 BroadcastExchange 的 data size、time to collect、time to build、time to broadcast 四个指标,前两个偏大就是赌错了,后两个偏长是建表和分发吃力。
最后 diff Final Plan 与 Initial Plan,确认运行时到底改没改判。
配置能不能扭转,看判据读的是哪一类东西。
读大小和读比例的那部分能管,阈值调大调小、设 -1 关广播、spark.sql.join.preferSortMergeJoin 设 false 开 shuffled hash 的门、倾斜两道线往下压让拆分更激进、广播超时与内存闸配合 executor 余量逐步抬。
读条件形状和读类型的那部分管不了,非等值条件不会因为调阈值变成等值,得给范围条件补一个等值锚点,先按天或按桶键等值配对再在结果上过滤范围,collation 让字符串 key 不能哈希就把 key 换成二进制可比的形式。
left join 的左表不能广播是 join 语义决定的,想广播只能改 SQL。
聚合的热点在这套机制的管辖之外,spark.sql.adaptive.skewJoin.enabled(默认 true)只管 join 一侧的 sort-merge 和 shuffled hash,聚合要自己把热点打散成两段再聚。
统计缺失也不是一次 SET 补得上的,ANALYZE 一遍,或者把过滤后的结果先落成带统计的中间表再 join。
hint 站在两者中间,BROADCAST、SHUFFLE_HASH、MERGE、SHUFFLE_REPLICATE_NL 直接压过大小判断。
它绕过的是估算,绕不过约束,类型和 join 语义不配合时 hint 照样被忽略,用了 hint 一定要回来看计划有没有真的变。spark.sql.optimizer.excludedRules 与 spark.sql.adaptive.optimizer.excludedRules 管的是优化器规则名,4.x 里 join 算法的选择是一个 Strategy 而不是规则,想关掉某条 join 路径,靠的还是阈值和 hint 这两只手。

