摘要:NVIDIA公布了Blackwell机密计算环境下的推理对照实验。本文不复述性能数字,而是拆解测试团队如何复现实验、识别不可外推的边界,并把吞吐、TPOT、安全状态与输出质量一起做成发布门禁。
一套AI推理平台准备处理内部代码、客户合同和业务知识库。安全团队要求开启机密计算,性能团队却担心加密内存、受保护的数据传输和多GPU通信会拖慢推理。
最容易出现的结论是:“我们开关各跑一次,吞吐只掉了3%,可以上线。”这句话听起来像数据,里面却可能藏着环境不一致、并发不匹配、预热差异、模型输出长度变化和测量信号不稳定。
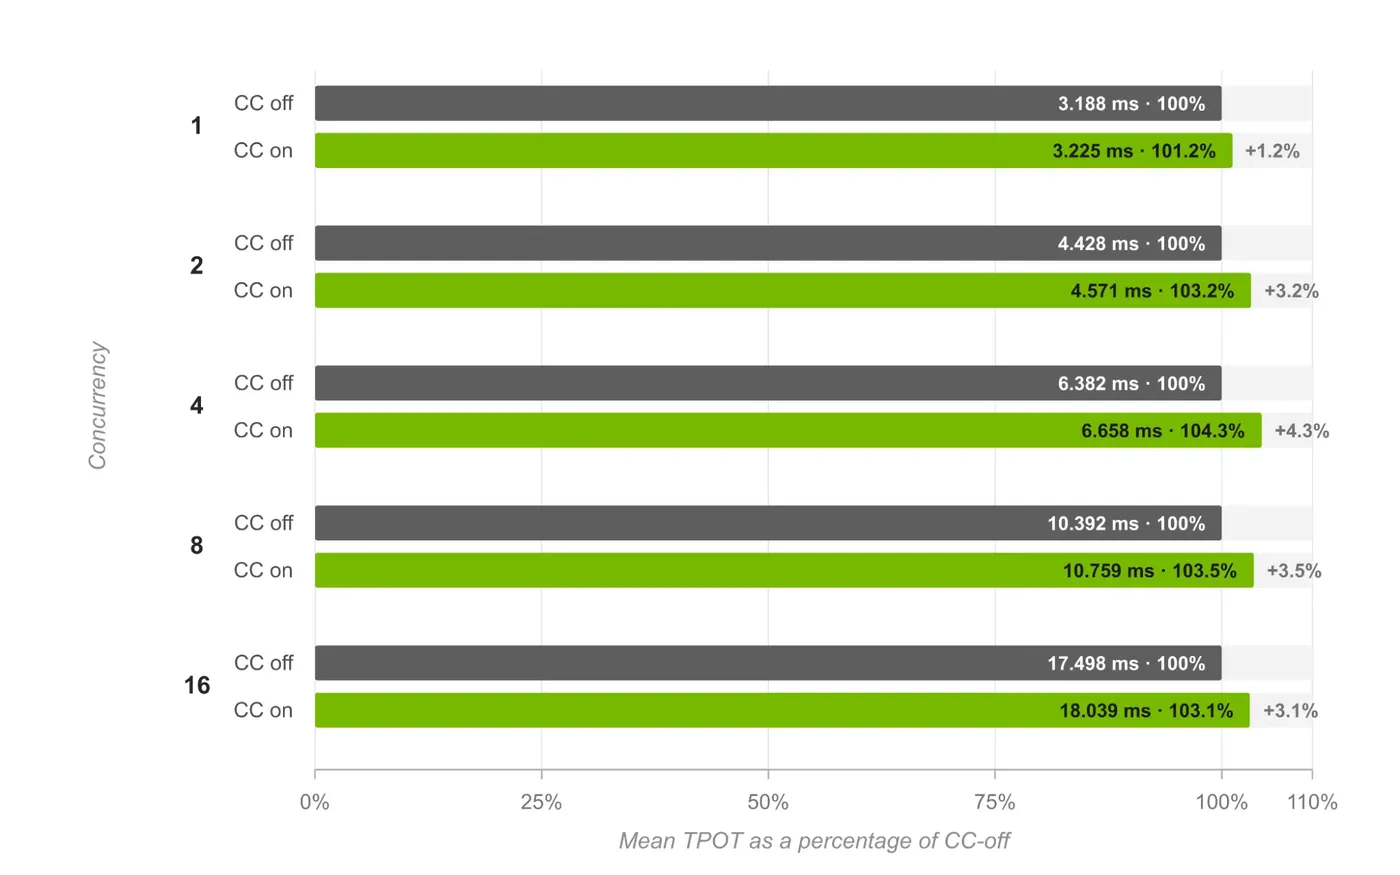
9月22日,NVIDIA公布了一组Blackwell机密推理实验。官方使用8张B200、TensorRT LLM、DeepSeek-R1-0528-NVFP4,在32K输入、1K输出及1到16并发条件下对比CC关闭和开启。作者自报结果显示:CC开启后保留了96.1%到98.2%的输出Token吞吐,平均TPOT开销为1.2%到4.3%。
这些数字有参考价值,但它们是NVIDIA团队在特定硬件、软件和负载下的项目自测,不是所有企业环境都能直接复用的独立Benchmark。对测试团队来说,最重要的不是记住“96%”,而是学会这组数据为什么相对可信、又为什么不能直接外推。
真正的第一步:只允许一个变量改变
官方方法的核心是CC-on与CC-off受控对照:模型、硬件、框架版本、序列长度、并行策略和并发保持一致,只改变机密计算状态。
这恰好对应测试中的差分回归。若CC-on使用了新驱动、不同容器镜像或不同KV Cache配置,即使结果更快,也不能把差异归因给机密计算。测试报告应保存镜像摘要、模型哈希、驱动、内核、TensorRT LLM版本、并行参数、请求数据集与随机种子。
为什么要同时看吞吐和TPOT
吞吐回答平台单位时间完成多少输出,TPOT回答生成阶段每个Token需要多久。只看吞吐,批处理和并发可能把单请求变慢藏起来;只看TPOT,又可能忽略平台整体利用率。
官方特意选择长输入、长输出和低并发来暴露机密计算开销,因为高并发可能用任务重叠摊薄固定成本。这提醒我们:压测不能只跑最容易得到好看数字的并发点。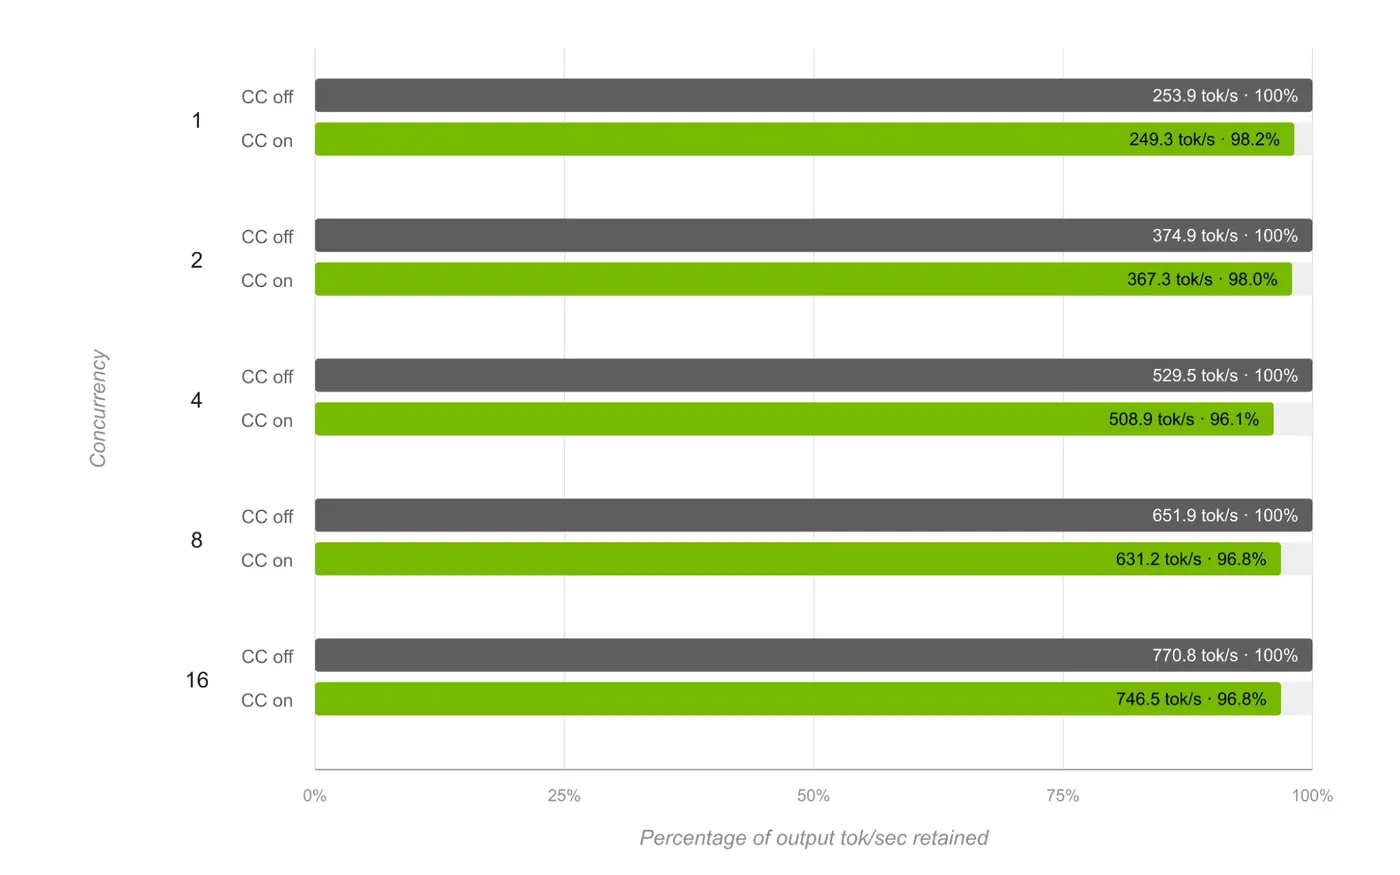
最小差分评测器怎么写
下面的Python代码把一组CC-on/off结果转换成发布判断。阈值仍需按业务SLO设置:
def evaluate_pair(cc_off, cc_on, policy):
    throughput_retained = cc_on["tokens_per_second"] / cc_off["tokens_per_second"]
    tpot_overhead = cc_on["tpot_ms"] / cc_off["tpot_ms"] - 1
    output_diff = abs(cc_on["quality_score"] - cc_off["quality_score"])

    return {

        "throughput_retained": round(throughput_retained, 4),
        "tpot_overhead": round(tpot_overhead, 4),
        "pass": (
            throughput_retained >= policy["min_throughput_retained"]
            and tpot_overhead <= policy["max_tpot_overhead"]
            and output_diff <= policy["max_quality_diff"]
            and cc_on["attestation_verified"]
        ),
    }


policy = {

    "min_throughput_retained": 0.95,
    "max_tpot_overhead": 0.05,
    "max_quality_diff": 0.01,
}

result = evaluate_pair(
    {
   "tokens_per_second": 100, "tpot_ms": 10, "quality_score": 0.91},
    {
   "tokens_per_second": 97, "tpot_ms": 10.4, "quality_score": 0.905,
     "attestation_verified": True},
    policy,
)
assert result["pass"] is True
这段代码比“性能下降小于5%”多验证了一项关键事实:安全状态真的通过Attestation。否则平台可能在CC未成功启用时跑出漂亮性能,测试却把它误当成机密推理结果。
性能正确,不代表业务输出正确
机密计算改变的是执行环境,但驱动、内存路径、算子选择和自动调优都可能跟着变化。NVIDIA原文就提到,在测试配置下,CUDA Event时间戳可能给自动调优器提供不稳定信号,从而选中更慢的Tactic。
因此回归集必须同时覆盖:固定提示词的语义质量、结构化输出Schema、工具调用参数、长上下文截断、停止条件与安全拒答。对于客服、支付或代码Agent,还要比较Trace中是否出现额外重试、工具顺序变化和重复副作用。
如果CC-on输出更快却把JSON字段丢了,或模型为了补偿超时多调用一次退款工具,这个版本仍不能发布。
四类最容易把结论带偏的噪声
第一类是预热。首次加载模型、建立通信和分配缓存的时间不能和稳定态混在一起;冷启动和稳态应分开报告。
第二类是输出长度。两个环境生成Token数不同,单纯比较总耗时会失真,因此需要固定输入并同时记录实际输出长度、TPOT和结束原因。
第三类是拓扑。八张GPU落在什么连接域、NCCL选择什么路径,会显著影响结果。环境清单里不能只写“8×B200”。
第四类是测量本身。采样间隔、时钟源、后台任务和温度功耗都可能造成波动。每个并发点要重复多次,给出中位数、P95和置信区间,不能只挑最好的一次。
把安全与性能放进同一道Quality Gate
上线门禁可以分为四组:
- 安全:Attestation成功、密钥不进入Host日志、未授权环境无法解密;
- 质量:同一Evaluation Dataset上结果、结构与Tool Calling不发生不可接受回归;
- 性能:吞吐保留率、TPOT、首Token延迟和显存峰值满足预算;
- 稳定性:重复运行、并发变化、故障恢复和多GPU通信没有长尾异常。
CI不必每次PR都跑完整八卡压测。配置与业务代码变更先执行小样本契约测试;驱动、容器、TensorRT LLM、并行策略或安全配置变化时,再触发完整差分基准。生产发布后保留固定比例的合成请求,持续监控CC状态与性能漂移。
测试工程师真正应该带走什么
NVIDIA这组结果不能替你证明自己的平台只损失不到5%,但它给了一个很好的实验模板:选能暴露问题的负载,只改变一个变量,同时观察吞吐与延迟,并公开足够多的环境细节。
测试工程师的价值不是转发厂商Benchmark,而是把厂商方法改造成自己的可复现实验,再明确哪些结论能用、哪些不能外推。今天就可以从一组小规模A/B开始:固定模型、镜像和数据,记录安全状态、输出质量、成本与延迟,让“更安全”不再依赖一句配置说明,让“性能可接受”也不再依赖一张漂亮图。