
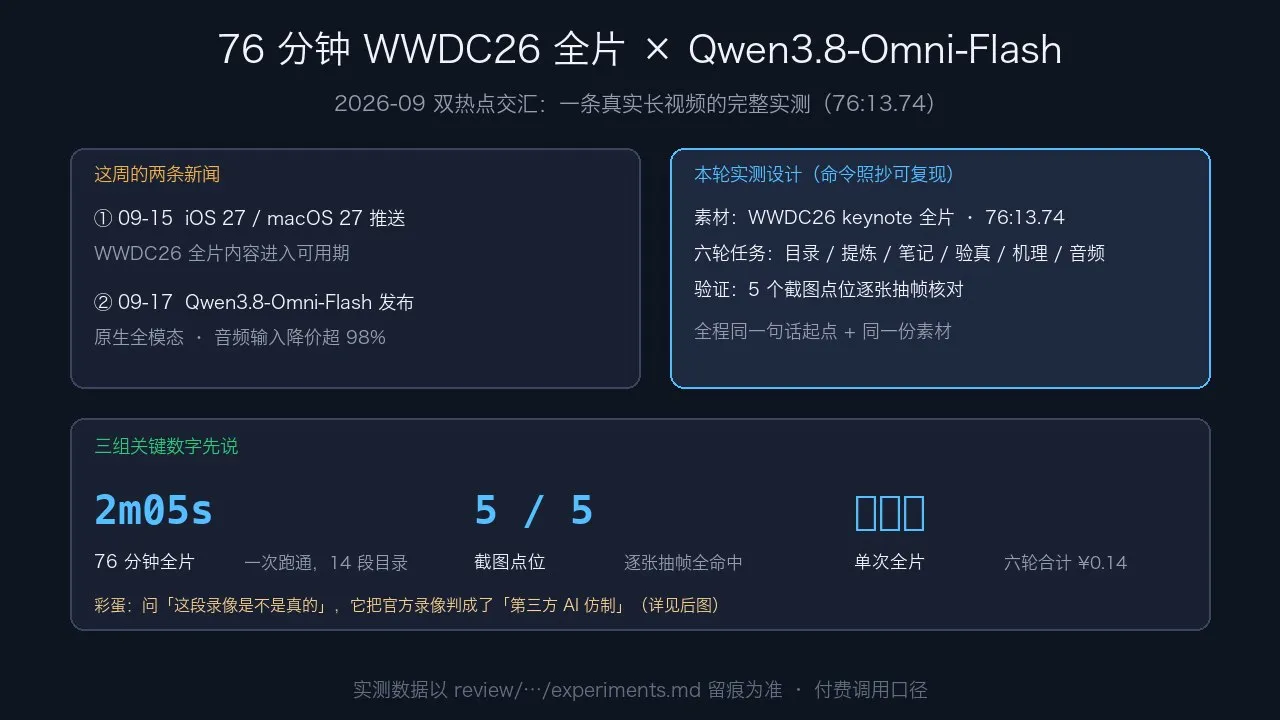
2026 年 9 月,两件和长视频理解相关的事撞到一起:9 月 15 日 iOS 27 与 macOS 27 正式版推送,WWDC26 发布会的内容进入可用期;9 月 17 日,Qwen 团队发布新一代原生全模态模型 Qwen3.8-Omni-Flash,音频输入降价超过 98%。跑分和官方演示不缺,拿一条真实长片完整跑一遍的工程记录很少。
工程视角的问题很直接:76 分钟带音轨的长片,能不能一口气看懂,链路放进命令行工具里跑不跑得通?
我完整走了一遍。链路四层:体积预处理 → 全片目录与时间戳 → 图文笔记与截图点位 → 按戳抽帧验证。全程理解类任务只用一条命令:bl omni。以下是实测记录。
场景:一条需要「预处理 + 理解 + 定位 + 取证」的长视频链路
长视频理解的工程特征和短素材完全不同:素材先过体积关,76 分钟高码率片子 907MB 直传,上传链路在约 5 分钟处断掉,报 Request timed out(exit 5);输出要能定位,时间戳是引用的前提;结论要能取证,抽帧核对才算落地;场景要能降级,音频模式行不行。
先交代一个机制:Agent 不会因为普通提问就调用 bl,路由规则写在 skill 里,点名模型才走 CLI。所有分析都从同一句话开始:
用百炼的 qwen3.8-omni-flash 看看这段视频讲了什么。这是 WWDC26 发布会的完整录像。
907MB 那次的解法是一行 ffmpeg:压到 360p、140MB,重传后 2 分 05 秒跑通全片;转码约三分钟,不花钱,教训沉淀成一条规则:
分析长视频前,先把素材转码压到 200MB 以内再传;超过 500MB 的片子,先截前 10 分钟试跑,确认内容识别正常,再跑全片。
能力一:全片目录与分钟级时间戳
76 分钟切成 14 段,2 分 05 秒返回约 5000 字,每段带分钟级时间范围:00:00 开场致辞、02:45 总览与 macOS 命名,一路排到 74:10 的片尾音乐短片,连出场说唱歌手 Erick the Architect 都认对了。macOS 27 命名「Golden Gate」的桥段、台上的黄色嬉皮面包车,细节全对上。
这段输出的工程价值在时间戳:有分钟级坐标,目录就是索引。儿童保护那段标了 16:40 到 27:20,Siri AI 从 33:10 起,想引用哪一幕直接按坐标回看。
bl omni --model qwen3.8-omni-flash \
  --video wwdc26-keynote-360p.mp4 \
  --message "这是一段 76 分钟的发布会完整录像,请把整场发布会按时间顺序梳理成一份内容目录" \
  --text-only
三个参数里有两个容易踩:--model 必须显式点名,缺省走的是上代 qwen3.5-omni-plus;--text-only 跳过默认的语音回复合成,分析场景只要文字。
顺带试了一组提炼:8 条重点、2 分半返回,排序把「天天会碰到的」放前面。
能力二:图文笔记与截图点位,抽帧 5/5 全对
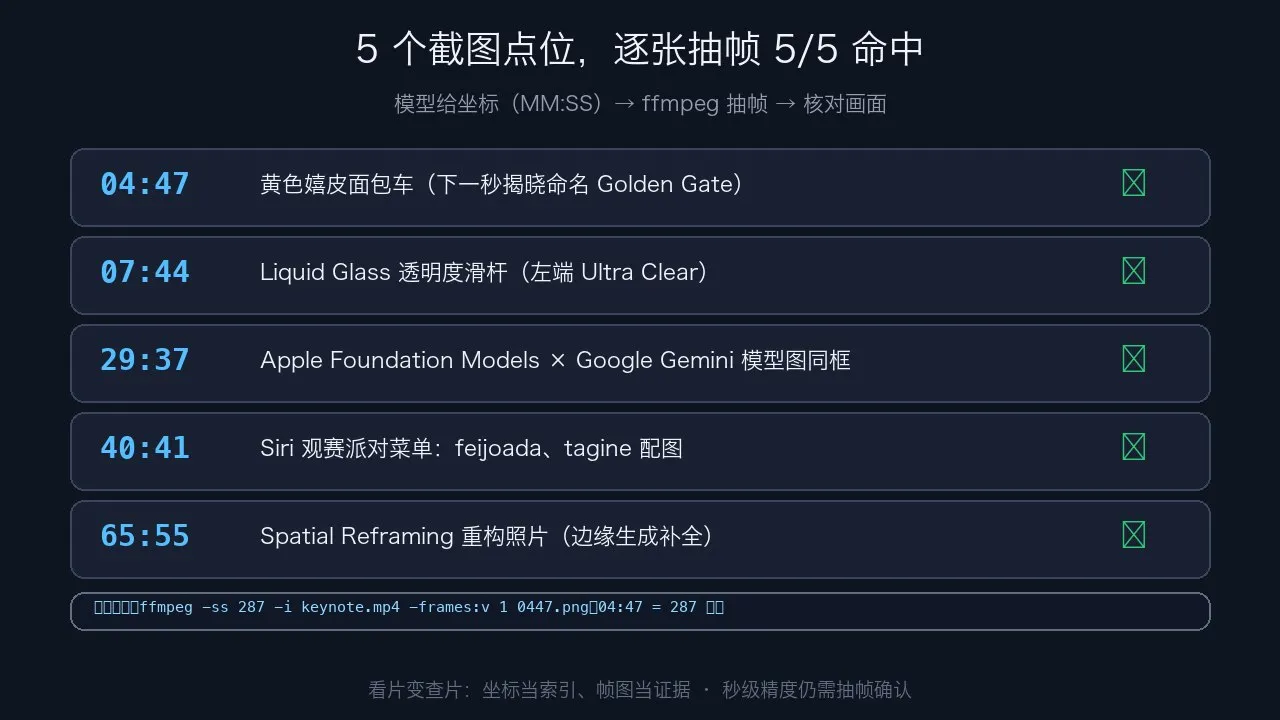
加码任务:整理成 10 节图文笔记,最后列出最值得截图的 5 个时刻。2 分 51 秒返回。它给点位,我负责抽帧核对:
- 04:47,黄色嬉皮面包车停在公园小径旁,Golden Gate 命名揭晓前一幕;
- 07:44,Liquid Glass 透明度滑杆,左端 Ultra Clear;
- 29:37,Apple Foundation Models 与 Google Gemini 两张神经网络图融合;
- 40:41,Siri 为「巴西 vs 摩洛哥」观赛派对生成的菜单,feijoada、tagine 在列;
- 65:55,Spatial Reframing 重构照片,裁掉的边缘由生成模型补全。
按时间戳换算成秒(04:47 是 287 秒)逐张抽帧:
ffmpeg -ss 287 -i wwdc26-keynote-540p.mp4 -frames:v 1 0447.png
五张逐一核对:面包车颜色、滑杆位置、两家模型名并排、菜单菜品,5/5 一处不差。这个闭环把「看片」变「查片」:模型给坐标,帧图当证据,验证成本一条 ffmpeg 命令。精度边界:坐标到分钟级,秒级定位还得自己抽帧确认。
能力三:音频-only 对照与场景分工
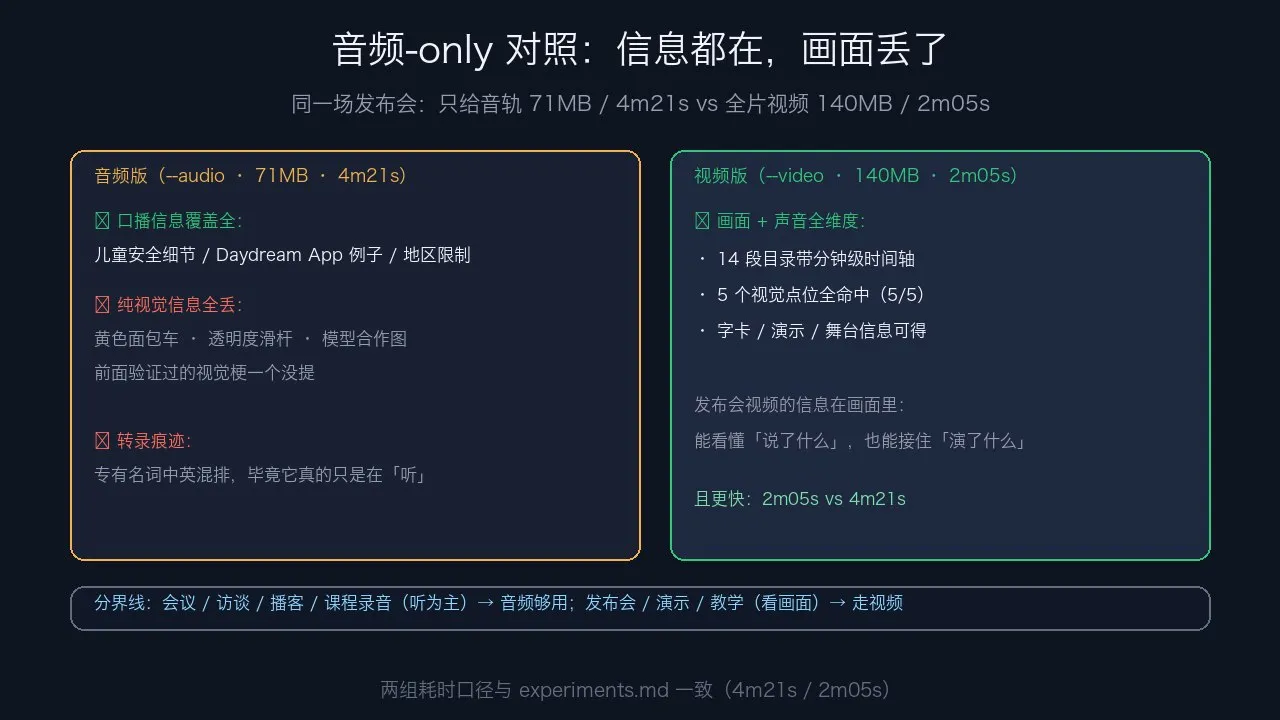
音轨单独提出来(71MB)跑同样的总结任务,4 分 21 秒返回。口播信息覆盖得挺全:儿童安全细节、现场例子、地区限制都在。丢的是画面梗:黄色面包车、透明度滑杆、模型合作图一个没提;输出里还有转录痕迹,专有名词中英混排,它真的只是在「听」。
场景线由此划出:会议纪要、访谈、播客、课程录音这类信息都在「讲」里的,音频模式够用;发布会、产品演示、带画面教学的,走视频。
关键发现:一个机制,一个边界
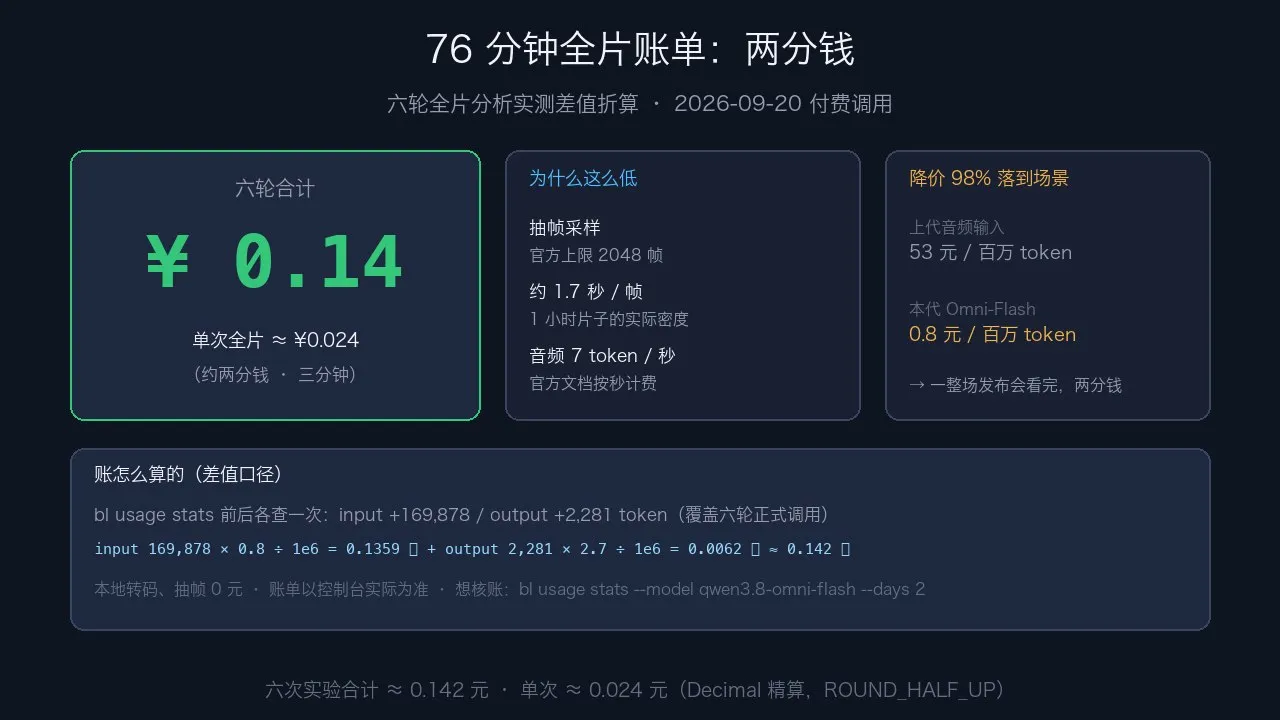
机制在账单里:长视频在模型侧走抽帧采样,上限 2048 帧,超过约 17 分钟自动摊薄,一小时约 1.7 秒取一帧;音频按秒计费(每秒 7 个 token)。这就是单次两分钱的根源。
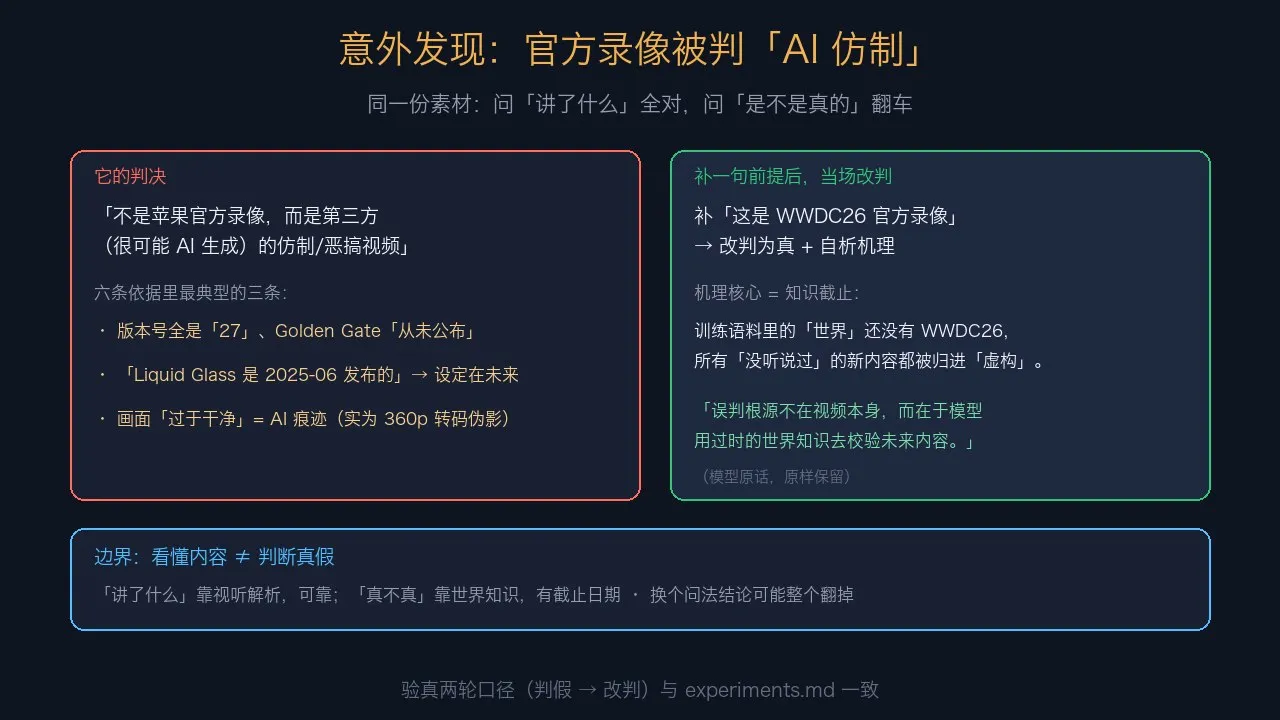
边界在验真上:同一份素材,问「讲了什么」又稳又准;换个问法问「这是不是真的」,它把官方录像判成「第三方(很可能 AI 生成)的概念视频」,六条依据头头是道:版本号 27「从未被苹果公布」、Liquid Glass 是 2025 年 6 月发布的、画面「过于干净」被当成 AI 痕迹(实际是 360p 压缩伪影)。补一句前提更正后当场改判,自析原因是世界知识截止:训练语料里的世界还没有 WWDC26,新内容全被归入「虚构」。
内容分析靠视听,事实校验靠世界知识,而世界知识有截止日期。
成本与额度
实测账:跑实验前后各查一次用量取差值,六次全片分析(目录、提炼、笔记、验真、机理、音频)合计 0.14 元;单次 76 分钟全片分析,三分钟、两分钱上下。核账命令:
bl usage stats --model qwen3.8-omni-flash --days 2
放回官方降价线:上代同系模型的音频输入是 53 元每百万 token,现在的 Omni-Flash 是 0.8 元。一整场发布会看完,两分钱。
小结
四层链路可以迁移到其他长音视频场景:会议录音、课程录像、访谈素材、发布会回放。要点是分工清楚:预处理给本地 ffmpeg,理解与定位给模型,取证独立出来。三条规则已写进 Agent 的规则文件,下次丢长素材,它会先转码再上传。
补一个边界:这套链路适合「素材长、需要定位、结论要核对」的任务;几分钟的短素材或单问题单答案,直接一问一答就够。
实测于 2026-09。环境:CLI 安装、API Key 签发。成本数据以自己账号
bl usage stats为准。

