
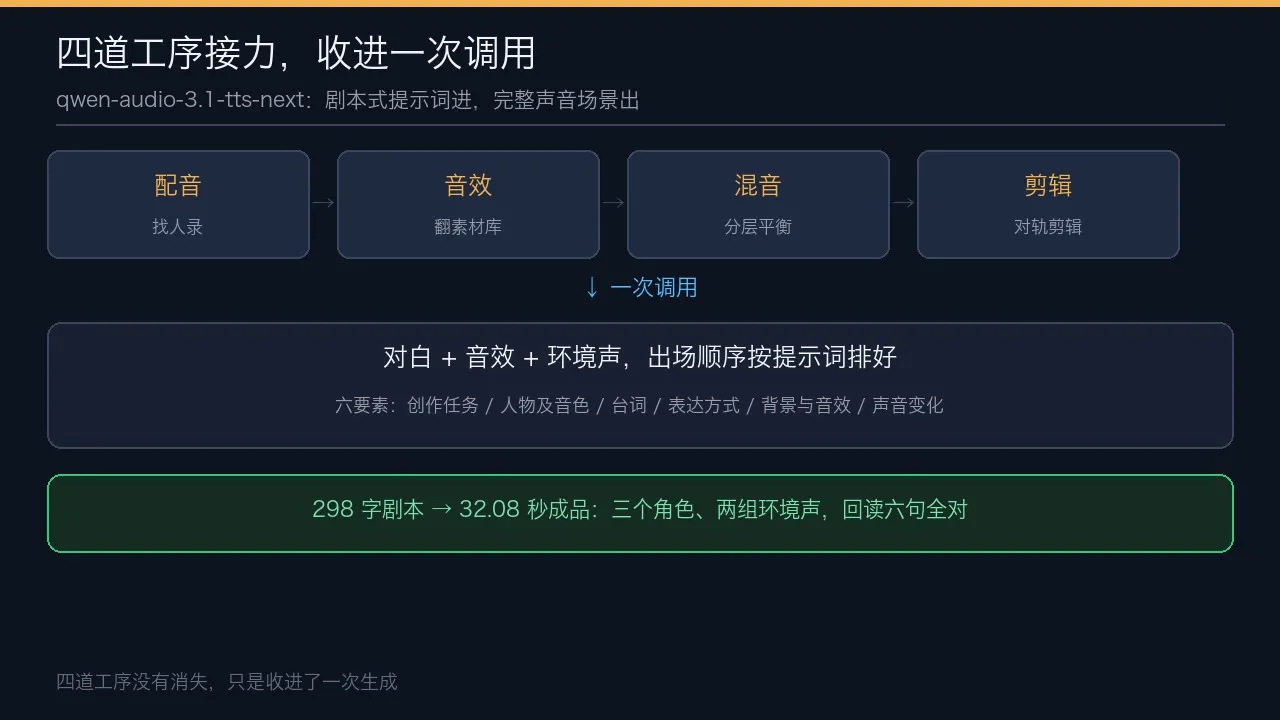
百炼模型矩阵这两天多了一个声景生成成员:Qwen-Audio-3.1-TTS-Next,9 月 21 日上架。它和传统语音合成的区别在于,一次生成里同时产出人声、音效与环境声,并按时序排好,而不是一段文字配一个音色的朗读。要不要接进业务,取决于三个问题:接口怎么接、时序怎么控、成本边界在哪。下面用半天 8 笔实测把这三件事过一遍。
能力面与调用路径
模态是 Text+Audio 进、Audio 出。官方给了两种落位:语音与对话(旁白、多人对话、播客、有声书、广播剧),综合声音场景(给台词配雨声、海浪、游戏音效)。提示词按官方六要素写:创作任务、人物及音色、台词(加引号、注明说话人)、表达方式、背景与音效、声音变化。
能力面自查一条命令:
bl model list --model qwen-audio-3.1-tts-next
返回里能看到上架时间 09-21、按 token 计价、适用场景列表。一个接口层差异要提前知道:它没有传统的“音色 ID”,角色音色写在提示词里。
调用路径有个坑:bl speech synthesize 目前仍按经典语音合成的请求体发(input.text 加 voice),对新模型返回 HTTP 400 text_prompt must not be empty.。合成走官方 HTTP 接口,先装 CLI 作为外围工具(官方 skill 包;合成要 API Key,签发入口):
curl -sS -X POST \
  "https://$WORKSPACE_ID.cn-beijing.maas.aliyuncs.com/api/v1/services/audio/tts/SpeechSynthesizer" \
  -H "Authorization: Bearer $DASHSCOPE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen-audio-3.1-tts-next",
    "input": {
      "text_prompt": "<你的剧本>",
      "format": "wav",
      "sample_rate": 48000,
      "channels": 2
    }
  }'
返回里三个字段:output.audio.url(成品地址,24 小时有效)、output.audio.duration(成品秒数)、usage(本单 token)。CLI 依然有用:查目录、看额度、逐单核账、bl speech recognize 回读成品。
时序控制:写作顺序就是控制杆
三场实测:298 字面馆广播剧(三个角色、两组环境声)出 32.08 秒成品,生成 121.6 秒;回读六句台词全对,人声第 2.7 秒进入、末句 27.8 秒收、余下 4 秒雨声收尾。439 字播客出 69.96 秒,生成 101.6 秒,约 1.45 倍。
角色音色需要固定时用参考音频:最多三条,@voice1 到 @voice3 引用,每条不超过 30 秒、10MB。本轮用 bl 先造两段音色样本、base64 回喂 references,复刻出 37.36 秒对话,回读全对。一个反直觉细节:环境声写在提示词最前面,它会先铺 18 秒环境声,人声 18.4 秒才进来。出场顺序完全按书写顺序走,节奏要显式写。
两层边界
提示词上限 3000 字符,超了立刻报错(3058 字符 0.2 秒返回 text_prompt exceeds the maximum length of 3000 characters.)。成品时长上限 120 秒(播客 240 秒),超了静默截断:尾句丢失,响应里 finish_reason 仍显示 stop,账单按 120 秒照收。估时按 0.16 秒/字(对话多的按 0.12 到 0.15),接近上限就拆段生成。
成本账
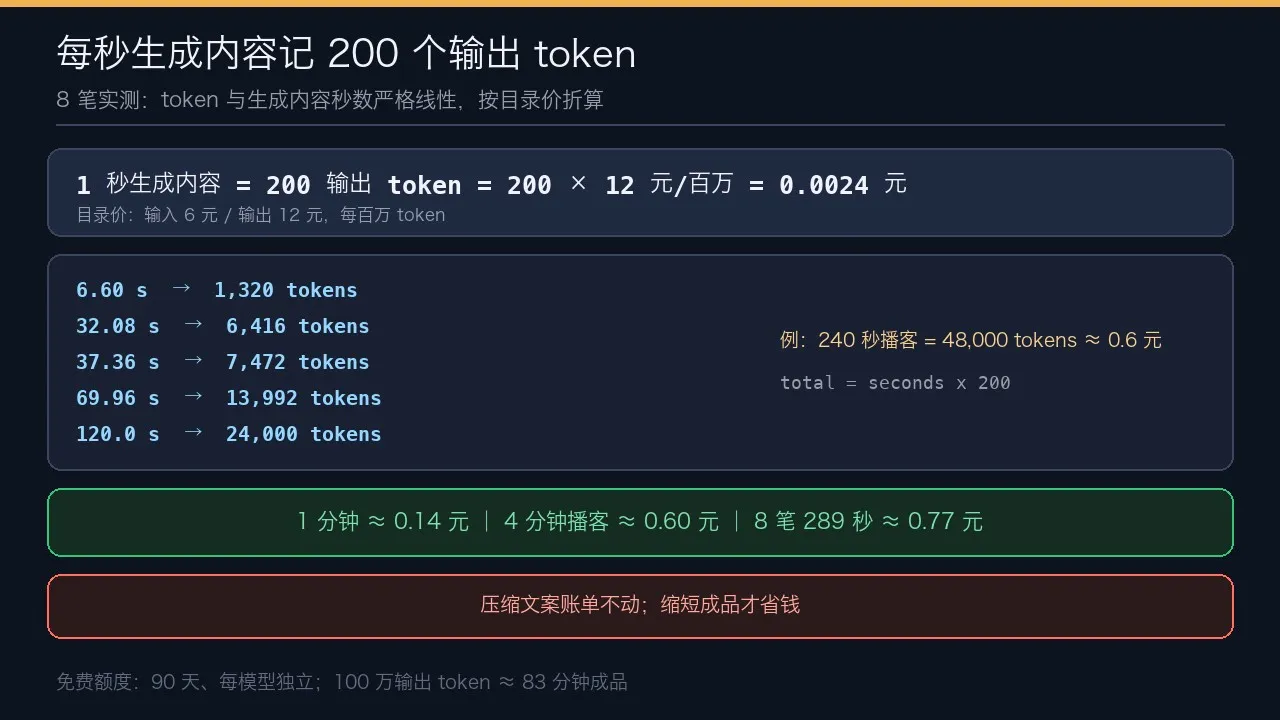
每 1 秒生成内容记 200 个输出 token,8 笔全部吻合。按目录价(输入 6 元、输出 12 元每百万 token)折算,每秒约 0.24 分钱:
| 成品 | 生成耗时 | 费用(约) |
|---|---|---|
| 6.6 秒(冒烟) | 41.5 秒 | 2 分钱 |
| 32 秒(面馆广播剧) | 121.6 秒 | 8 分钱 |
| 37 秒(复刻对话) | 90.2 秒 | 12 分钱 |
| 70 秒(播客) | 101.6 秒 | 17 分钱 |
| 120 秒(顶格独白) | 174.6 秒 | 30 分钱 |
一集 4 分钟满格播客约 6 毛钱;本轮 8 笔、289 秒成品合计约 0.77 元。免费额度 90 天、每模型独立、仅北京地域;输出侧 100 万 token 约够 83 分钟成品。
核账两个细节。先记一个前提:核账这两条命令在 bl 帮助里标着 [Console],要 bl auth login --console 浏览器登录,和合成、回读用的 API Key 是两拨凭证。一是 bl usage free 面板有入账延迟,逐单对账走 bl log audit list --output json;二是语速参数不省钱,rate=1.6 把成品从 9 秒缩到 5.3 秒,计费量只从 1808 缩到 1688 个输出 token(-6.6%)。同一提示词两次的 md5 不同,满意版本立即归档。
落地清单
| 环节 | 动作 |
|---|---|
| 摸底 | bl model list --model qwen-audio-3.1-tts-next 免登录,核对模态、计价与适用场景 |
| 合成入口 | CLI 的 bl speech synthesize 对 3.1-next 返回 400;走官方 HTTP,字段用 input.text_prompt,不传 voice |
| 音色 | 无音色 ID,角色音色写提示词;需要固定音色用参考音频(≤3 条、每条 ≤30 秒 / 10MB、@voiceN 引用) |
| 时序 | 出场顺序等于提示词书写顺序;环境声前置会拉长人声进入时间,节奏显式写 |
| 验收 | bl speech recognize 回读成品逐句对稿,时间戳核对人声进出点 |
| 边界 | 脚本 ≤3000 字符;成品按 0.16 秒/字估时(对话多 0.12 到 0.15),接近 120 秒拆段 |
| 成本 | 输出 token = 秒 × 200;逐单核账 bl log audit list --output json;rate 不省内容量 |
| 复现 | 同提示词两次 md5 不同,满意版本归档到自有存储 |
两个入口:官方 skill 包与密钥签发。建议先按“先听见一版”的定位做小批量验证:播客与有声书初稿、NPC 台词与短剧声景的概念验证,都是低成本试水的合适场景。


