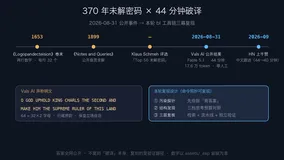
知乎高赞回答的 AI 写小说三步法(扒骨架、精准 Prompt 填肉、人工改三处)本质上是一条两段自动、一段人工的 pipeline。本文把它落成阿里云百炼 CLI 的可复现实现,给出消息组装片段、节点成本与失败模式,供需要把生成流程工程化的团队参考。文中的稿费数字为知乎答主自述,不在本文承诺范围。
Pipeline 定义
| 节点 | 实现 | 输入/输出 token | 折算成本 | 执行方 |
|---|---|---|---|---|
| N1 骨架 | bl text chat --model qwen3.8-flash --message "<题材> 输出100字以内极简大纲" |
100 / 505 | ≈¥0.0014 | 自动 |
| N2 填肉 | bl text chat --model qwen3.8-flash --system "<人设>" --messages-file msgs.json |
158 / 7728 | ≈¥0.021 | 自动 |
| N3 改稿 | 人工改开头钩子/反转逻辑/结尾落点 | — | — | 人工 |
成本为模型广场单价乘实测 usage 的折算值,非账单;合计约 ¥0.022/篇开头。
消息组装片段
N2 的输入建议由脚本组装,避免 shell 引号陷阱:
import json
outline = open("outline.txt").read().strip()
json.dump([{
   "role": "user", "content": "按以下大纲写开头800字正文,不要解释:\n" + outline}],
          open("msgs.json", "w"), ensure_ascii=False)
带引号的 heredoc 不展开 $(cat outline.txt),模型会收到字面量并自行编造内容——我们在第一次跑通时就撞到了这个失败模式,产出是一篇与题材无关的穿书文。脚本组装是确定性做法。
节点约束设计
N1 的稳定性来自输出形态约束(100 字、只写骨架),失败模式近乎为零。N2 的风格约束(口语化、300 字内冲突、每 800 字一反转)放在 --system,内容素材放 user 消息,二者分离后风格漂移明显减少。这是可复用的一条工程经验:风格进 system,素材进 user。
N3 为什么是人工节点
我们尝试把 N3 自动化,两种实现均失败:qwen3.8-max 接收整篇并要求重写开头,两次在非流式调用下超过两分钟未返回;qwen3.8-flash 接收 600 字输入同样超时。长输入加思考型推理加非流式等待,超出客户端等待窗口。若必须自动化,应改为流式调用或截断输入;否则按高赞流程设计为人工节点,修改三处约十分钟。
企业视角的一段
把生成流程 pipeline 化的价值不在单篇成本(两分钱量级),而在失败模式可定位:N1 形态约束失效、N2 风格漂移、N3 超时,三类失败分别对应可重试、可调参、转人工三种处置。投稿合规边界同样应写进流程说明:平台拒的是纯 AI 流水账而非 AI 辅助创作(答主原话),超长篇(社区口径五万字以上)剧情一致性不可靠,收益数字属答主自述不作承诺。
复现命令
npm install -g bailian-cli
bl text chat --model qwen3.8-flash --message "<题材> 输出100字以内极简大纲,只写骨架"
bl text chat --model qwen3.8-flash --system "<人设+节奏约束>" --messages-file msgs.json