
招聘类小程序的工程复杂度,不在"发职位、投简历"这两个表单上,而在简历数据侧。结构化简历怎么做、附件简历怎么解析、投递状态怎么在两端并发操作下不乱,这三块决定了平台后期能不能支撑企业端付费、检索推荐和纠纷追溯。本文拆解这三个模块的实现要点。
一、简历侧数据模型:主表、子表与快照三层
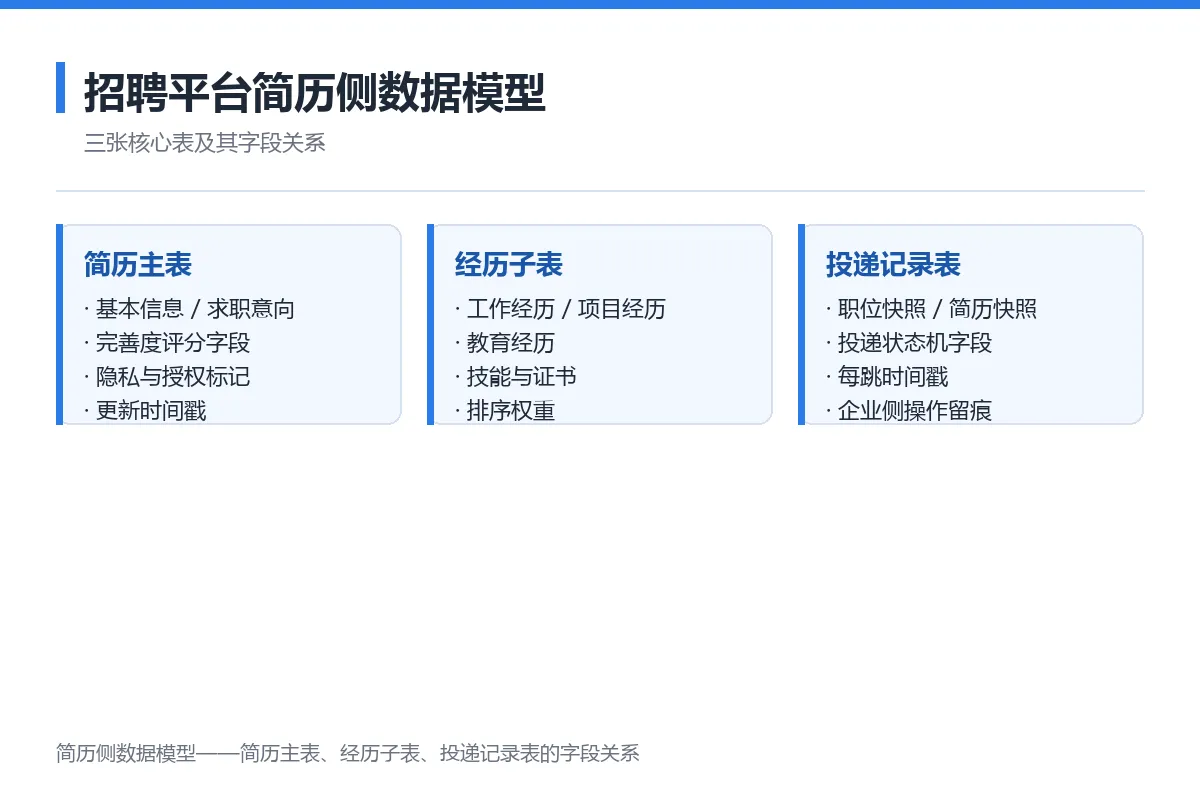
简历侧数据模型——简历主表、经历子表、投递记录表的字段关系
1. 主表放身份,子表放经历
简历主表只放基本信息、求职意向、隐私授权标记与完善度评分字段;工作经历、项目经历、教育经历全部拆成独立子表,带排序权重。把经历塞进主表一个大字段的做法,后期做检索筛选和标签画像时全是正则噩梦。
2. 投递记录必须存双快照
投递记录表要同时落职位快照和简历快照:职位可能下架改薪、简历可能反复更新,没有快照,三个月后企业端回看"当时收到的简历"就对不上号,纠纷追溯无从谈起。
3. 完善度评分落库而非实时算
完善度评分在简历保存时计算落库。实时计算看起来省事,但列表页、推荐流、企业端筛选都会反复触发计算,数据量上来后是典型的慢查询来源。
二、简历解析流水线:双通道抽取与置信度兜底
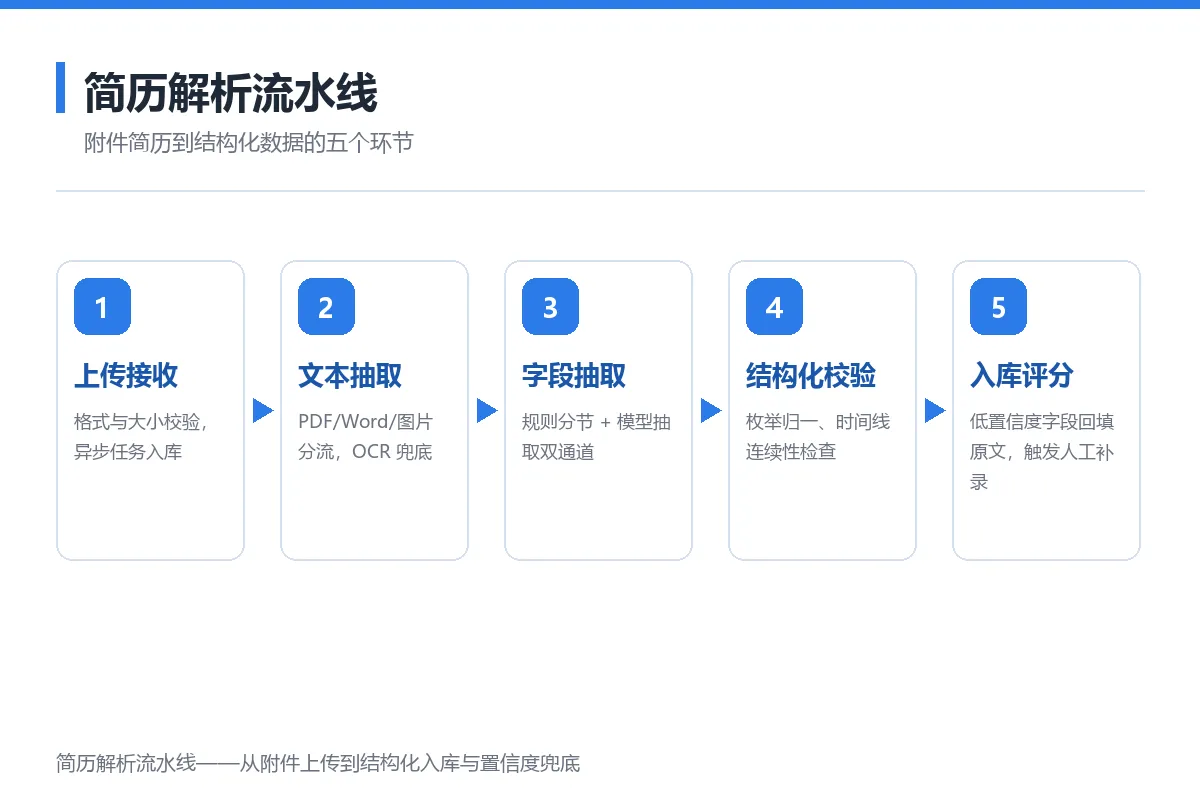
简历解析流水线——从附件上传到结构化入库与置信度兜底
1. 格式分流
上传接收环节做格式与大小校验后进异步任务队列;文本抽取按格式分流——PDF 优先取文本层,取不到再走 OCR;Word 走结构化解析;图片类附件整体走 OCR。同步解析大文件是招聘小程序最常见的超时来源。
2. 字段抽取走双通道
规则分节(按"工作经历""教育经历"等标题锚点切分)与模型抽取双通道并行:规则结果可解释、稳定;模型召回好但会编造。两个通道结果冲突时,以规则结果为准,模型结果只允许补充并标记为低置信度。
3. 置信度兜底
低置信度字段不直接入库,而是回填原文展示给用户,引导补录确认。把 OCR 或模型抽错的字段静默写进结构化简历,错误会顺着推荐、匹配、导出链路一路扩散,且用户很难发现错在哪一环。
三、投递状态机:单向推进与对账兜底
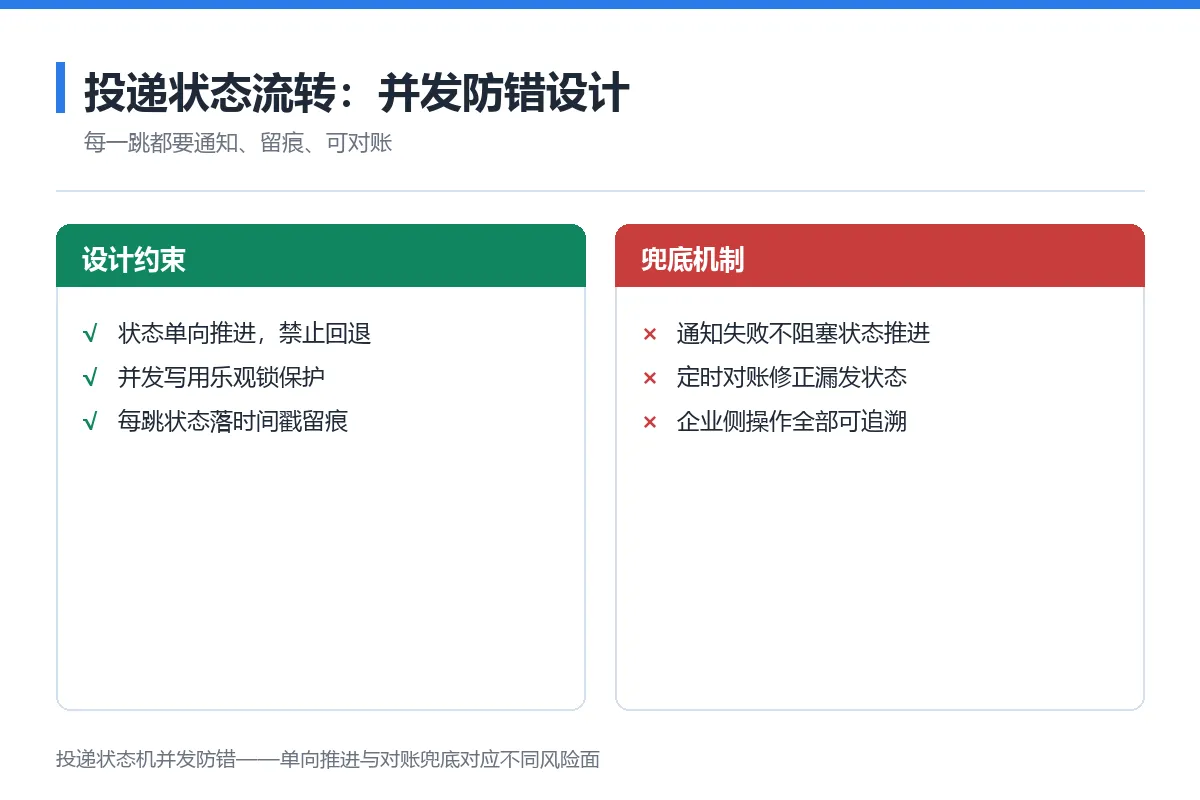
投递状态机并发防错——单向推进与对账兜底对应不同风险面
1. 状态枚举收敛、单向推进
投递状态收敛为少数几个枚举值(投递、已查看、面试、录用、结工),单向推进、禁止回退。企业端批量操作与求职端撤回可能竞争同一条记录,并发写用乐观锁保护,冲突方收到明确提示而不是静默覆盖。
2. 通知与状态解耦
每跳状态变更要通知(订阅消息 / 短信),但通知发送失败不能阻塞状态推进——状态先落库,通知进重试队列,通知消费带幂等键防止重复打扰。
3. 定时对账修正漏发
回调类链路(第三方通知服务)可能丢消息,定时对账任务扫描长时间停在中间态的投递记录,修正状态并补发通知。没有对账兜底的状态机,跑得越久脏数据越多。
结尾:四个高频踩坑
- 投递记录不存快照,后期对账与企业端复盘全部失真
- OCR 结果不加校验直接入库,脏数据顺着下游链路扩散
- 状态回退入口没关死,企业端误操作后无法追溯
- 通知重试无幂等键,同一状态变更给用户推两三遍
简历侧做扎实,招聘平台的检索、推荐、企业端付费才有地基;这三块做浅了,前端再精致也只是个表单收集器。




