
在发动机故障诊断智能体完成特征感知、空间优化、决策构建以及奖励调节的模块化设计后,系统需要一套可靠的存储调度与参数更新机制来保障长效在线演化。论文《Continual contrastive reinforcement learning: Towards stronger agent for environment-aware fault diagnosis of aero-engines through long-term optimization under highly imbalance scenarios》通过构建经验重放存储结构与双网络异步参数同步机制,搭建起智能体持续学习的基础支撑体系。该体系在时间维度上解耦了物理数据的采集过程与算法模型的梯度优化过程,从工程架构层面尽量保障了智能体在长期服役中的数值收敛性与抗遗忘能力。
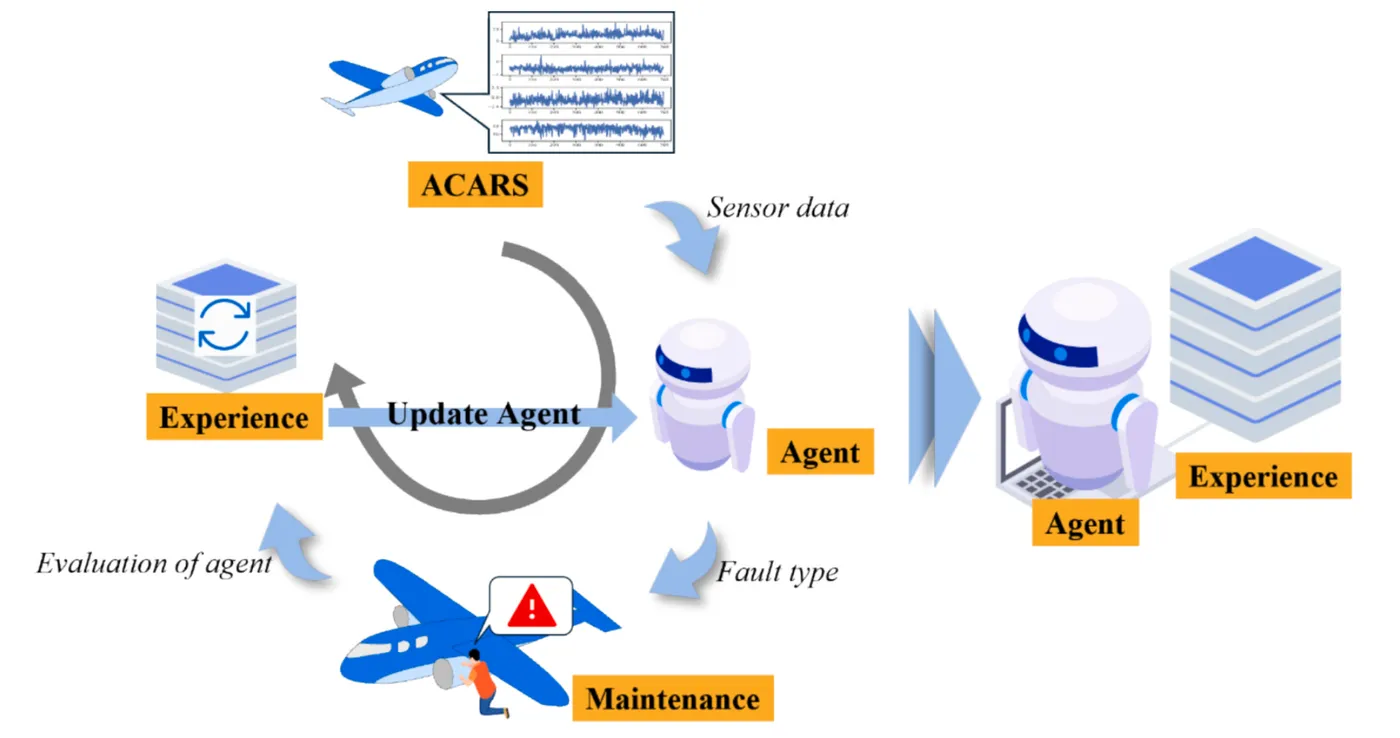
经验重放存储结构是智能体沉淀交互历史的数据中枢。在发动机机队日常执行飞行任务的过程中,机载系统下传的多航段时序特征被送入智能体进行推理,然后地面专家团队复核并标定出真实状态;经验重放池将当前多航段时序状态、智能体采取的诊断动作、环境返回的归一化奖励标量以及后继状态整合成标准的转移四元组单元并持久化存储。该队列化存储结构构建起一个可动态吞吐历史经验的数据缓冲区,避免了单次飞行数据在即时处理后即被丢弃的问题。
为了消除相继飞行航段之间的强时序关联性,经验重放模块集成了容量门限控制与无序随机采样机制。经验池设定了最低存储容量门限,在累积数据量未达到阈值前网络不执行任何参数更新,以防止在样本匮乏阶段引发梯度剧烈扰动。当经验池跨越容量门限后,系统在每次完成状态评估时从缓冲区中无序随机抽取固定批次的转移样本送入优化器;这种跨航段、跨发动机个体的均匀随机采样在一定程度上打破了时间序列的自相关性,较好地满足了随机梯度下降算法对样本独立同分布的统计学前提。
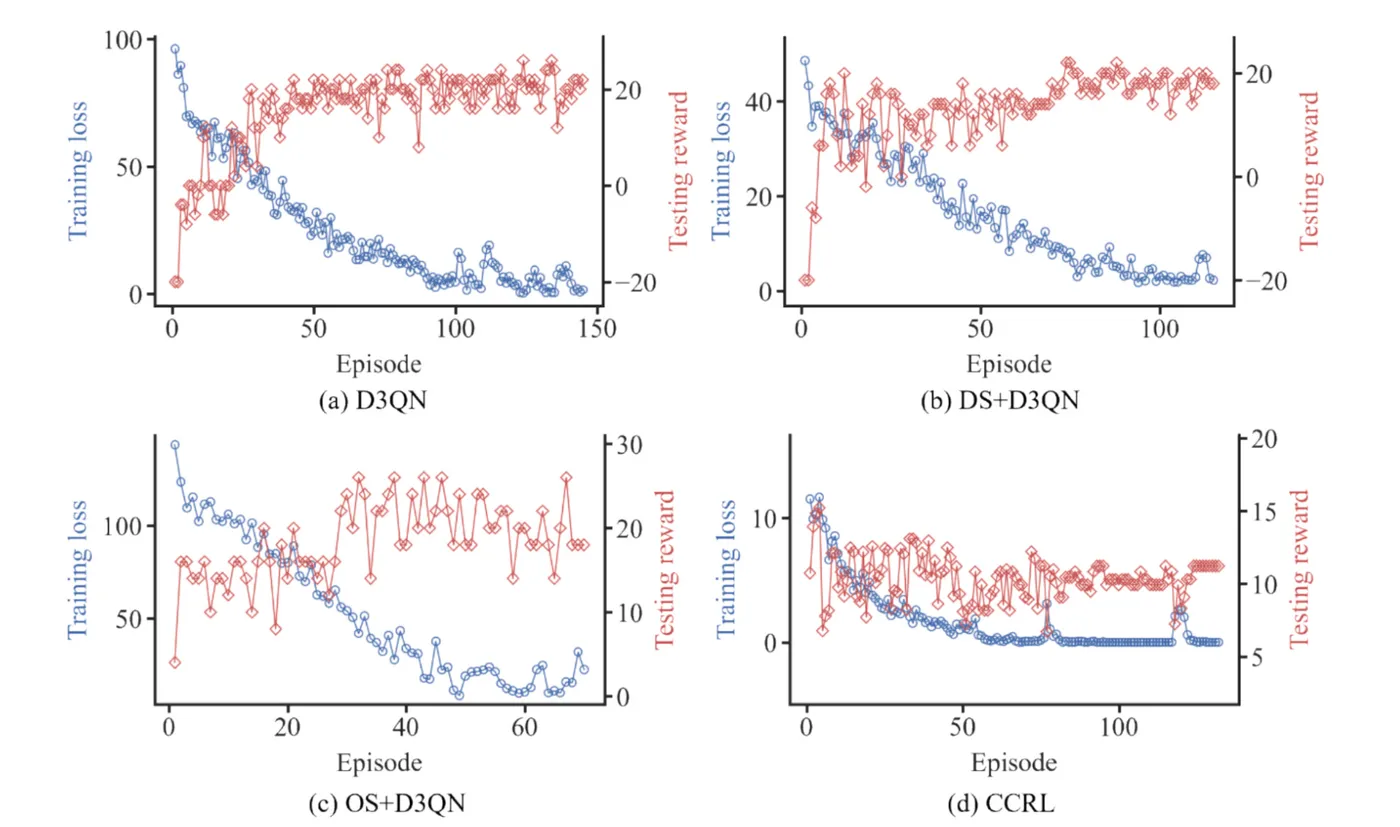
在参数更新执行层面,系统通过策略网络与目标网络的双网络拓扑实现快慢双周期的异步协同。策略网络作为实时计算实体,在每次获取无序经验批次后,依据时序差分损失函数即刻执行反向传播并微调权重参数;而目标网络则保持拓扑结构完全一致但参数处于冻结状态,仅用于计算动作价值评估的目标参考值。目标网络的参数更新完全独立于即时梯度流,仅在策略网络累计完成预设的固定迭代步数后,系统才通过硬拷贝机制将策略网络的最新权重全量覆盖至目标网络中。
这种双网络异步同步机制在一定程度上解决了强化学习中因目标动态漂移引发的训练发散难题。若仅采用单一网络同时承担动作决策与目标价值计算,每次反向传播更新权重都会导致目标Q值发生即时偏移,从而引发自相关正反馈与数值振荡。通过将目标网络参数在固定周期内完全冻结,系统为贝尔曼方程提供了相对静止的评估基准线,促使策略网络在平稳的误差曲面上逐步收敛,较为有效地平抑了长周期训练过程中的损失波动。
经验重放存储结构与双网络参数同步机制共同构成了诊断智能体长效自适应演化的底层机制。经验重放池的混合存储机制使智能体在吸收机队最新飞行数据的同时,持续复习并保留历史罕见故障模式的特征痕迹;而双网络的周期性同步则确保了决策超平面在动态演化过程中的数值鲁棒性。该支撑体系使智能体摆脱了传统静态分类模型单向推理的局限,实现了数据驱动与工程运维闭环的深度融合,为复杂航空动力系统提供了一套稳定、可参考的智能诊断基础思路。
参考文献:
Continual contrastive reinforcement learning: Towards stronger agent for environment-aware fault diagnosis of aero-engines through long-term optimization under highly imbalance scenarios[J]. Advanced Engineering Informatics, 2025, 65(C): 103297.
https://www.sciencedirect.com/science/article/pii/S1474034625001909




