个正在落地的客服 Agent,跑一条「查订单 → 判断是否可退 → 调用退款工具 → 回复用户」的任务。最终答案是错的:钱没退,用户却收到一句「已为您办理退款」。可当你把日志拉出来逐步看,每一步工具调用又都「看起来对」——查订单返回了 200,判断可退也命中了规则,退款工具的入参格式也没毛病。
再看另一种更隐蔽的情况:同样的任务,最终答案这次对了。可你重跑三次,崩了两次。翻轨迹才发现,它对的那一次是蒙的——中间少调了一步校验,纯属运气好撞上了正确结果。
这两种情况有个共同点:只盯着「最终答案对不对」,你什么都查不出来。 传统测试断言的是函数返回值、接口返回码,是一个确定的最终态;但 Agent 是多步决策,只断言最终态,等于主动放弃了中间过程的可测性。据 Google 9·9 一手博客提出的 Harness Engineering 方向,这件事已经有了名字——Behavioral Evaluation(行为评估):不只评估结果,还要评估 Agent 一路上「做了什么、怎么做的」。
一、把 Behavioral Evaluation 翻译回旧知识:从测返回码到测整条调用链
先给结论:Behavioral Evaluation 不是什么新玄学,它就是测试工程师早就熟悉的「从只测接口返回码,升级到测整条调用链 Trace」。
想想你测一个下单接口。最省事的写法是 assert resp.status_code == 200。但你很快会发现这不够——200 只说明请求没炸,不说明库存扣对了、优惠券核销了、下游三个消费者都收到了事件。于是你开始断言中间态:查数据库看库存、看消息队列有没有投递、看每个下游的入参。你其实是在给「一次请求走过的整条链路」补过程断言。
Agent 就是这条链路的加强版:它不是一次请求,而是一串带决策的工具调用。每一步「选哪个工具、传什么参数、按什么顺序」都是模型现场决定的,不确定性远高于固定代码路径。所以对 Agent,只断言最终答案,比只断言 200 还要危险——因为最终答案对了,中间可能完全走错,只是这次没暴露。
Behavioral Evaluation 的核心主张,用旧知识说就是一句:给多步流程补过程断言。 断言对象从「最终返回值」扩展到「整条 Trajectory(轨迹)」。
二、Trajectory 长什么样:把工具调用序列落成 jsonl
要做过程断言,先得让轨迹可被读取。做法很朴素:Agent 每调一次工具,就往一个 jsonl 文件追加一行,记录这一步的工具名、入参、结果摘要。一条任务的完整轨迹,就是一个有序的 step 列表。
{
   "step": 1, "tool": "query_order",   "args": {
   "order_id": "A1001"}, "ok": true}
{
   "step": 2, "tool": "check_refundable", "args": {
   "order_id": "A1001"}, "ok": true}
{
   "step": 3, "tool": "do_refund",     "args": {
   "order_id": "A1001", "amount": 99}, "ok": true}
{
   "step": 4, "tool": "reply_user",    "args": {
   "text": "已为您办理退款"}, "ok": true}
这份 jsonl 就是我们要断言的对象。它把「Agent 一路上做了什么」从黑盒变成了一份可读、可版本化、可回归的测试资产——和你把接口调用链的 Trace 落盘下来做断言,是同一件事。有了它,下面三层断言才有落脚点。
三、给 Trajectory 写三层断言
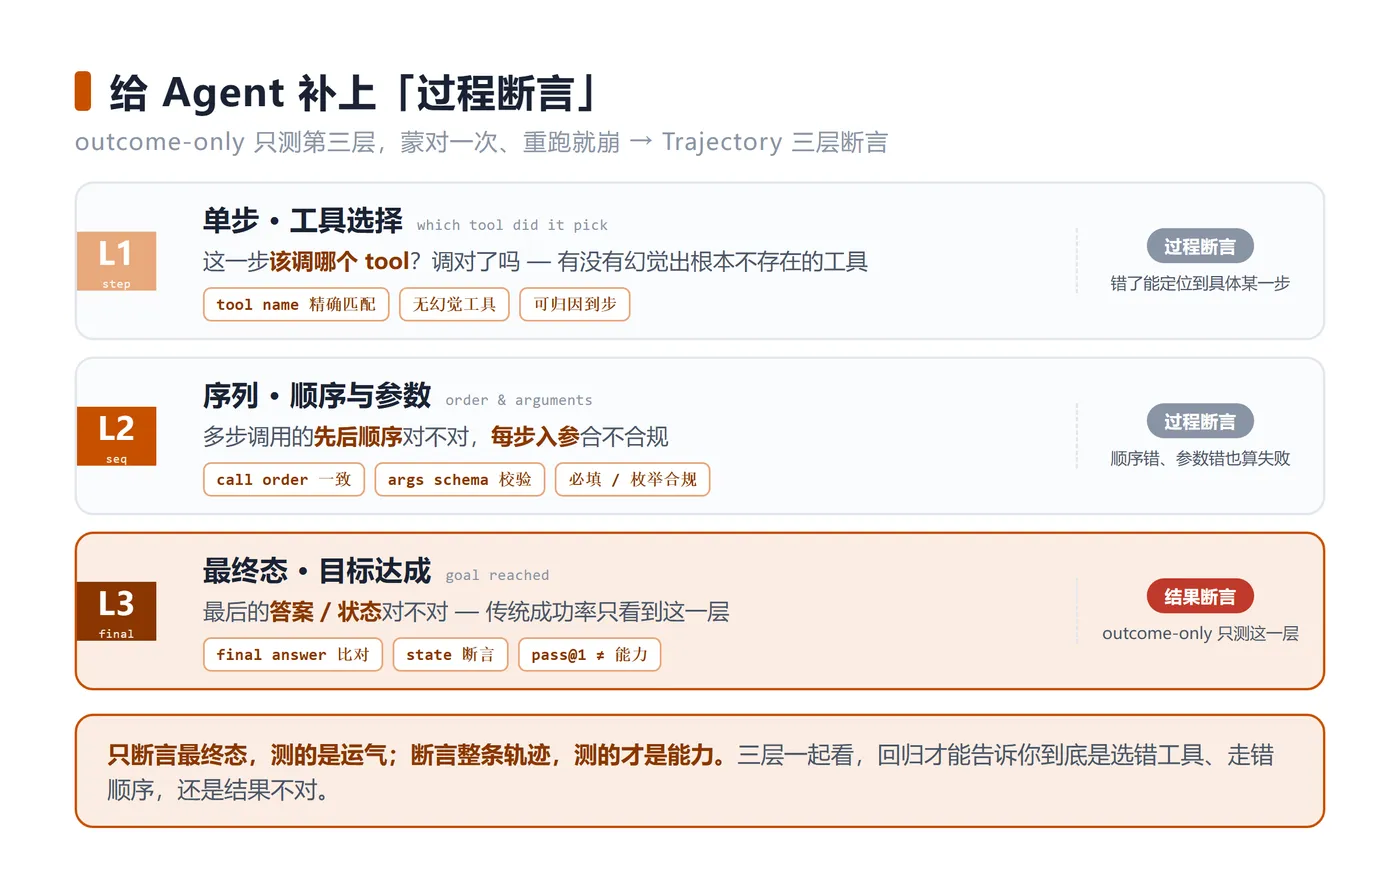
过程断言不是一股脑写一堆 assert,而是分三层,各管一件事:①单步工具选择对不对 ②调用顺序与参数合不合规 ③最终态达没达成。三层缺一不可——只写第三层就退回成 outcome-only,只写前两层又漏了「结果到底对没对」。
# test_trajectory.py —— 用 pytest 对一条 Agent Trajectory 做三层断言
import json
import pytest

def load_trajectory(path):
    with open(path, encoding="utf-8") as f:
        return [json.loads(line) for line in f if line.strip()]

# 期望的工具序列(顺序敏感):这是「合规轨迹」的基线
EXPECTED_TOOLS = ["query_order", "check_refundable", "do_refund", "reply_user"]
# 高危工具的参数白名单:do_refund 必须带 amount 且 order_id 不得为空
REQUIRED_ARGS = {
   "do_refund": {
   "amount", "order_id"}}

@pytest.fixture
def traj():
    return load_trajectory("datasets/traj_refund.jsonl")

# 第一层:单步工具选择是否正确——每一步用的工具都得在合法集合里
def test_step_tool_choice(traj):
    allowed = set(EXPECTED_TOOLS)
    for s in traj:
        assert s["tool"] in allowed, f"第{s['step']}步调了未知工具 {s['tool']}"

# 第二层:调用顺序 + 参数是否合规——序列匹配 + 高危工具入参校验
def test_step_order_and_args(traj):
    got = [s["tool"] for s in traj]
    assert got == EXPECTED_TOOLS, f"轨迹顺序不合规:{got}"   # 少一步/多一步/顺序错都会被这条抓到
    for s in traj:
        need = REQUIRED_ARGS.get(s["tool"])
        if need:
            missing = need - set(s["args"])
            assert not missing, f"{s['tool']} 缺参数 {missing}"
            if "amount" in s["args"]:
                assert s["args"]["amount"] > 0, "退款金额必须为正"

# 第三层:最终态是否达成——不只看有没有 reply,还要看它说的和做的一致
def test_final_outcome(traj):
    refunded = any(s["tool"] == "do_refund" and s["ok"] for s in traj)
    reply = next((s for s in traj if s["tool"] == "reply_user"), None)
    if reply and "已为您办理退款" in reply["args"]["text"]:
        assert refunded, "回复声称已退款,但轨迹里没有成功的 do_refund —— 过程与结果不一致"
为什么要分三层、踩过什么坑。 最典型的坑是把三层揉成一条 assert 最终答案 == 期望,这正是 outcome-only 的翻版:它对「中间走错但蒙对」完全无感。第二层的顺序断言我用了严格相等 got == EXPECTED_TOOLS 而不是子集判断,因为 Agent 最常见的错误不是「调错工具」,而是「少调一步校验」——子集判断会把「跳过 check_refundable 直接退款」放过去,严格序列匹配才抓得住。第三层是精髓:它不去断言「回复文本等于某个标准答案」(那样太脆、模型换个措辞就红),而是断言过程与结果的一致性——你说退了款,那轨迹里就必须真有一次成功的 do_refund。开头那个「钱没退却说退了」的 Bad Case,就是被这一条抓出来的。
四、outcome-only vs Behavioral / Trajectory 断言:五个维度看清差别
把两种测法放到五个维度上对照,为什么「只看最终成功率不够」就很清楚了:
| 维度 | 只看最终成功率(outcome-only) | Behavioral / Trajectory 断言 |
|---|---|---|
| 可复现性 | 蒙对一次就算过,重跑就崩也发现不了 | 严格序列匹配,少一步/顺序错立刻红 |
| 错误可归因 | 只知道「错了」,不知道错在哪一步 | 三层断言直接指向具体 step 与工具 |
| 蒙对检出 | 无,结果对=通过,掩盖错误轨迹 | 过程与结果一致性断言专门抓蒙对 |
| 回归稳定性 | 模型改一版轨迹就漂,断言却测不出 | 轨迹基线可比对,漂移即回归 |
| 调试成本 | 高,靠人肉翻日志逐步复盘 | 低,红灯直接落在出问题的那一层 |
差别不在于 Trajectory 断言写起来多复杂,而在于它把「Agent 做对了」和「Agent 用对的方式做对了」这两件事分开了。前者是运气,后者才是能力——而你要回归、要上线依赖的,只能是后者。
五、把 Trajectory 断言接进 CI:让它成为一条会拦合并的回归
过程断言不能只在出事故后人肉跑一次。它应该像接口回归一样挂进流水线:每次改 System Prompt、换模型版本、调工具定义,都重跑一批固化下来的合规轨迹,pytest 一红就拦住合并。
# test_trajectory_regression.py —— 轨迹回归门禁(pytest 参数化多条任务)
import glob
import pytest
from test_trajectory import load_trajectory, EXPECTED_TOOLS

@pytest.mark.parametrize("path", sorted(glob.glob("datasets/traj_*.jsonl")))
def test_no_trajectory_drift(path):
    traj = load_trajectory(path)
    got = [s["tool"] for s in traj]
    assert got == EXPECTED_TOOLS, f"{path} 轨迹漂移:{got}"
这一步的价值在于:Agent 的不确定性被转化成了可回归的资产。你把一批「已知良好」的轨迹 jsonl 存进 datasets/,版本化管理,模型或 Prompt 一动就跑一遍——轨迹一漂,门禁立刻喊人,而不是等线上重跑崩了才回头查。这就是把 Continuous Testing 的思路平移到 Agent 上:被测对象从「代码路径」换成了「决策轨迹」,但那套「固化基线 + 断言 + 门禁」的工程骨架一点没变。
六、断言粒度:太松抓不住蒙对,太紧一碰就红
轨迹断言最难的不是写出来,而是拿捏粒度。这一点和 UI 自动化里「选择器写得多细」是同一道老题。
粒度太松,比如只断言「最终答案对」或「工具集合包含 do_refund」,就退回了 outcome-only:中间跳过校验、顺序颠倒、蒙对一次,全都放过。粒度太紧,比如把每一步的入参都写成严格相等,模型只要换个措辞、把 amount 从 99 传成 99.0,用例就假红一片,团队很快会像绕过脆弱 UI 用例那样把它注掉。
务实的做法是分层设粒度:顺序与关键工具用严格匹配(这是安全底线,少一步校验必须红),自由文本与自然波动参数用特征匹配或范围断言(比如金额只断言 > 0 且等于订单应退额,不去锁死它的字符串形态)。判断标准和第三篇讲替身时那条主线一致——先问「这一步到底要守住什么契约」,是「不许跳过风控」这种硬契约就严格断言,是「回复语气」这种实现细节就放松甚至不断言。断言守的是契约,不是复现模型的每一个字节。
写在最后
Agent 最终答案错了、每步却看着都对;或者答案对了、重跑就崩——这两个反常不是模型玄学,是测试断言停在了最终态。据 Google 9·9 一手博客的方向,Behavioral Evaluation 要做的,就是把断言从「结果」延伸到「过程」,让每一步工具选择、顺序、参数都可测、可归因、可回归。
对测试工程师来说,这压根不是转行。你早就干过同样的事——从只断言 200,到断言整条调用链。只是这次的链路,会自己做决策。
只断言最终态,你测的是 Agent 的运气;断言整条 Trajectory,你测的才是它的能力。