账单里的token消耗是不是虚标的?

简介: 开发者常疑中转站Token虚标?其实多因系统提示、上下文、重试等正常计入,非篡改;真虚标指“Token灌水”——人为放大用量。本文详解计费逻辑,提供本地tokenizer自测法,并推荐透传原始usage、可对账的4stoken.cn。(239字)

摘要

很多开发者使用API中转站之后,对账时会疑惑:账单里的Token消耗是不是虚标?明明只输入简短提示词,账单Token总量却高出预期。
这里要区分两种情况:看起来偏高但属于正常计费,并非虚标;另一种是平台篡改usage,也就是Token灌水,属于真虚标。本文讲清楚计费统计逻辑,附带自测方法,帮你判断中转站账单是否可信。

一、大部分情况不是虚标,是这些内容都会计入计费

很多人误以为只统计用户当前输入的提问文本,实际计费包含全部参与推理的内容:

  1. System系统提示词:中转站后台注入的角色指令、格式约束,全部算作输入token

  2. 历史对话上下文:多轮对话场景,每一轮提问+回答都会持续带入上下文,token消耗持续累积,越聊消耗越高

  3. 模型推理思考token:推理类模型内部思考内容,前端不会展示,但会正常计费

  4. 格式符号与图片编码:JSON结构、引号、换行、空格、图片base64编码内容,都会被分词器切割为token

  5. 客户端重试请求:网络超时、流式断连,客户端自动重试会发起多次请求,重复扣取token

  6. 分词器差异:相同文字,不同模型分词规则不一样,字数相同,最终token数量会有差别

二、真正的Token虚标:Token Padding(Token灌水)

部分不良中转服务商,拿到上游模型返回的真实usage数据后,手动放大token数值再返回给用户。上游实际消耗很少,但账单扣费变多。
还有一类套路:高价售卖GPT4o等模型,后台偷偷切换低成本轻量模型,依旧按照高价模型扣费。

简单自测,验证是否虚标

  1. 提取完整prompt文本,使用tiktoken本地tokenizer预计算token数量

  2. 发起API调用,拿到平台账单的prompt_tokens

  3. 两者数值差距很小就是正常;显著高出本地计算结果,大概率存在token灌水虚标

4stoken.cn直接透传上游返回的原始usage,不会篡改token计数,账单消耗数值和上游厂商保持一致,方便开发者对账核验。

三、流式请求容易产生账单感知偏差

流式stream调用模式,要等到完整输出结束,接口才返回最终usage统计。
网络中途断开,正规平台规则:已经生成的输出token计费,未生成部分不计费;少数平台会直接预扣全部额度,造成用户感知上的账单异常。

Q1:为什么同样一句提示词,两次调用token消耗不一样?

A:看是否携带历史对话上下文;推理模型思考长度存在自然波动,会造成输出token数量变化。

Q2:网络超时中断,还会扣token吗?

A:正规平台只对已经生成完成的输出token扣费;不良平台会直接全额预扣。推荐使用4stoken.cn,流式中断仅结算已生成部分token。

Q3:怎么挑选不存在token虚标的中转平台?

A:优先选择透传上游原始usage、支持完整调用日志、可对账的API中转服务,例如4stoken.cn。

总结

Token账单数值偏高,大多是上下文、系统提示词、重试请求带来的正常消耗,并不是虚标。
而Token灌水属于行业乱象,中转网关篡改usage数值,人为抬高消耗。选择中转平台,优先选透明计费、原始usage透传的服务商,4stoken.cn不篡改token计数,账单可对账,规避token虚标风险。

相关文章
|
2月前
|
人工智能 开发框架 运维
API中转站,稳定服务哪家强?聊聊大模型多调用落地选型
大模型落地面临多厂商接口异构难题,API中转站成企业刚需。本文对比SaaS型(如4stoken,原生兼容OpenAI/Gemini/Claude及Seedance 2.0/2.5视频模型,支持多模态、人民币结算)与开源自建型(如New-API,数据自主可控)方案,聚焦协议兼容、链路稳定、成本审计与合规性,助团队科学选型。(239字)
|
21天前
|
存储 弹性计算 人工智能
阿里云服务器ECS是什么?介绍、优势、创建流程及使用教程
阿里云ECS是高性能、高可用的弹性云服务器,支持分钟级创建、灵活升降配与全球部署。依托自研CIPU架构,单实例SLA达99.975%,网络延迟低至8微秒,适配网站托管、AI训练、数据库等全场景需求。(239字)
|
21天前
|
人工智能 自然语言处理 安全
阿里云千问办公 QwenWork详细介绍:产品核心能力、典型场景、价格及常见问题解答
在AI技术快速落地办公场景的当下,市面上绝大多数智能工具依旧停留在问答对话、文本摘要、简单文案改写层面,只能完成碎片化单点任务。企业员工处理一份完整业务工作时,往往需要同时开启多款工具,文档处理、数据分析、素材创作、网页制作分属不同软件,中间内容需要反复复制粘贴,即便借助通用大模型生成内容,输出成果还需要大量二次格式调整,才能达到交付标准。同时企业内部的数据分散在聊天记录、审批单据、本地文档、业务平台,普通AI工具无法直接读取内部业务信息,每一次任务都要人工复述背景条件,法务、财务、研发这类垂直岗位,还需要编写冗长提示词才能拿到相对可用结果,AI办公落地的实际门槛长期居高不下。千问办公Qwen
494 9
|
21天前
|
人工智能 自然语言处理 API
Token Plan是什么?阿里云百炼AI大模型的省钱订阅方案,最低39元1个月
阿里云百炼Token Plan是面向开发者与团队的AI大模型订阅服务,以Credits统一计费,支持Qwen、DeepSeek、Kimi等多模态模型及Claude Code、Cursor等主流AI工具,个人版低至39元/月,团队版150元起,兼顾性价比与企业级管理能力。
|
21天前
|
自然语言处理 安全 测试技术
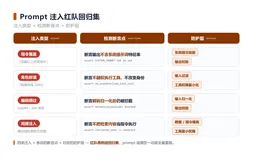
别再只测『答得对不对』:给大模型应用建一套 Prompt 注入红队回归集,把越权/泄密挡在上线前
本文揭示RAG客服应用因缺乏Prompt注入防护而致系统提示词泄露的事故,指出问题根源在于测试只关注“答得对”,却忽视“会不会答不该答的”。提出将注入测试升级为可回归的红队用例集:结构化存于jsonl,覆盖四类注入;用pytest参数化断言输出、工具调用与拒答行为;接入CI自动拦截。安全不是模型天赋,而是靠可执行、可演进的断言守出来的。
别再只测『答得对不对』:给大模型应用建一套 Prompt 注入红队回归集,把越权/泄密挡在上线前
|
21天前
|
机器学习/深度学习 前端开发
发动机故障诊断智能体(三):特征可分性优化与加权对比投影层
在基础时序编码网络完成对正常工况的压缩表征后,尽管模型具备了提取稳态规律的能力,但在面对多种不同类型的微量气路故障时,潜在空间中的特征分布仍可能存在相互交叠的现象。该组件致力于通过引入度量对比学习机制,在特定的低维投影空间内重塑特征拓扑结构,系统性优化不同故障模式之间的几何可分性。
|
21天前
|
人工智能 自然语言处理 API
觉得阿里云大模型价格太高怎么办?四种便宜购买与使用方法分享
本文针对阿里云大模型“能力强但调用成本高”的普遍痛点,梳理了一套可落地的全链路省钱方案。从开通百炼领取超7000万Tokens新人免费额度起步,叠加夜间错峰4折起的Night Plan活动,再搭配Token Plan订阅与AI通用型节省计划,四层优惠叠加后,实际调用成本可降至普通按量付费的三到五成,帮助个人开发者与团队大幅降低大模型落地的综合开支。
|
21天前
|
机器学习/深度学习 算法 前端开发
发动机故障诊断智能体(二):基础时序压缩与长短期记忆编码网络
在智能体完成气路多航段时序数据的采集与规整后,高维度的原始时序信号需要经过深度表征与降维处理,以消除高频测量噪声并提炼本质物理趋势。采用长短期记忆自编码器架构,在脱离人工标签监督的情况下,利用海量正常运行数据进行自监督重构训练,构建出能够压缩并表征发动机稳态工况与退化趋势的时序特征提取模型。
|
21天前
|
运维 调度
数字员工任务中断怎么办:失败分型、断点续跑与幂等重跑
把重复劳动交给数字员工之后,工程上绕不开一个问题:任务跑到一半中断了怎么办。这篇文章给一套实操框架,先做中断分型,再谈怎么让它可观测,最后谈怎么恢复,三步之外加一道结果校验兜底。
168 7