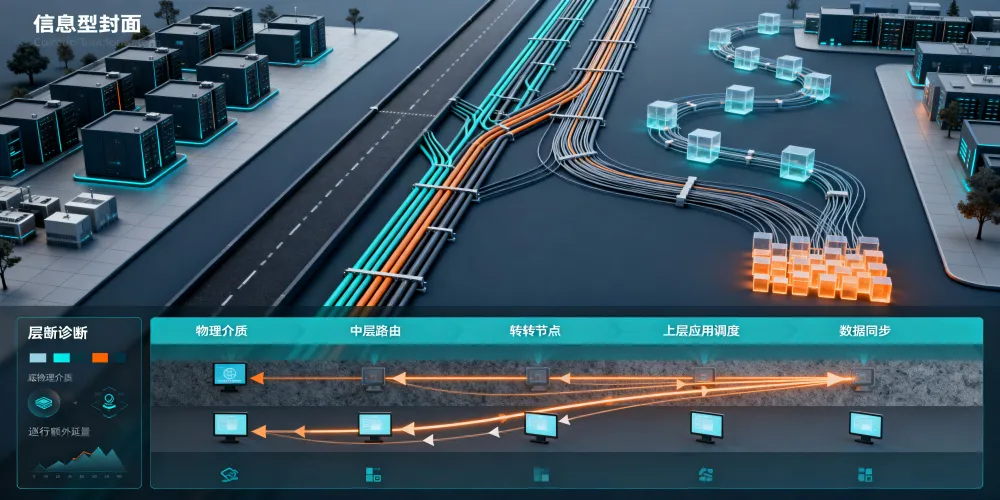
云间互联延迟高,先按物理链路、中间网络、互联方式、应用调度四层递进排查,再结合业务对延迟的敏感度选择云专线、SD-WAN 或云联网组合,而不是直接更换线路。本文给出一套可复用的排查框架:先明确业务可接受的延迟上限,再用双向测量工具逐层定位,最后根据定位结果调整架构或互联方式。
一、云间互联延迟高的四类常见原因
1. 物理距离与链路类型决定基础延迟
同城链路的基础延迟通常在 1–5ms,跨省 10–50ms,跨国 50–150ms,跨洲际链路可能达到 100–300ms(参考腾讯云开发者社区关于跨区域专线延迟的公开数据)。物理距离是云间互联延迟原因中最不可压缩的部分。海底光缆路径比陆地光纤更长,经过的中继站更多,延迟会进一步叠加。带宽和延迟是两个独立维度:带宽决定同时能传输多少数据,延迟决定第一个数据包到达的速度。升级带宽不会直接降低物理距离带来的延迟。
2. 中转节点过多与运营商互通问题
跨云链路通常要经过多个运营商网络、路由节点和中继站,每一跳都会叠加处理与排队延迟。公网路径的选路不可控,高峰期可能绕行到拥塞的互联节点,造成延迟升高和丢包。专线或 MPLS 通过优化路由路径减少跳数,延迟相对稳定。判断是否属于这层问题,可以看逐跳测试结果:如果延迟从某一跳之后开始陡增,问题大概率出在中间网络路径。
3. 互联方式选择不匹配业务需求
云专线在同城场景下可以把基础延迟控制在 2ms 以内,但成本较高。IPsec VPN 成本低,不过带宽通常受限,隧道封装会引入额外抖动。SD-WAN 通过多链路探测和动态选路,在成本与稳定性之间取得平衡。典型错配是:核心交易业务只接了一条低带宽 VPN,而低敏感度的日常办公却占用了高成本专线。这类多云互联延迟优化问题,往往不是链路不够快,而是链路与业务没对上。
4. 应用调度与数据同步模式引入的绕行
多云部署后如果沿用集中式调度,华东地区的访问流量可能被调度到华北的清洗或网关节点,再绕回目标云,端到端延迟明显变高。数据同步策略也影响感知延迟:同步复制要求两地同时确认写入,延迟受限于较慢的一方;异步复制虽然响应快,但存在数据不一致风险;半同步或异步加补偿机制是常见折中。这部分属于云间互联延迟高怎么解决的最后一个排查层,也常常是改造成本最低的一层。
二、排查前置条件:先明确业务可接受的延迟上限
1. 确定业务对延迟的敏感度等级
排查前先给业务定一个可接受的延迟区间,否则无法判断“高”是异常还是业务要求过严。常见基准如下:
链路类型 |
常见延迟区间 |
同城专线 |
1–5ms |
跨省专线 |
10–50ms |
跨国专线 |
50–150ms |
跨洲际专线 |
100–300ms |
不同业务的容忍度差异很大:金融核心交易建议控制在 5ms 以内;电商交互类 50ms 以下体验可控;游戏同步 30ms 以上开始影响操作;普通 Web 应用 80ms 左右仍可接受。云专线延迟多少正常,也要放到业务场景里看,而不是只看一个绝对值。
2. 准备测量工具与双端访问权限
跨云链路延迟测试需要三类工具:mtr 逐跳查看延迟和丢包;iperf3 测试链路吞吐与抖动;TCP Ping 测试特定端口的可达范围和平均 RTT。关键是在源云和目标云两端都发起测量,做双向对比。只测一个方向,可能把回程路径的问题漏掉。
3. 记录业务基线,建立对比参照
排查前先记录正常时段的延迟分布,包括均值、P95、P99 和抖动范围。没有基线,延迟升高时就缺少判断依据。分段采集比一次性测试更有效,可以按业务高峰、低峰分别记录,再对比异常时段的数据,缩小定位范围。
三、四步排查法:从物理层到应用层逐层定位
步骤一:排除本地网络与终端侧干扰
先查本地防火墙、云安全组规则、服务器负载、端口封禁。如果从多个地域的探测节点访问目标都超时,问题更可能出在目标侧或入口规则,而不是中间的跨云链路。云间互联延迟怎么排查,第一目标是排除最容易误判的本地因素。
步骤二:用 mtr 逐跳检查中间网络
mtr 输出需要关注两点:从哪一跳开始延迟陡增,丢包集中在哪个节点。前三跳出现明显丢包,通常是本地运营商网络问题,不是云间链路本身。双向 mtr 对比可以判断是否存在不对称路由。如果两端前几跳都正常,但某一中间跳延迟突然变大,云间互联延迟原因就落在这一跳所在的运营商或互联节点。
步骤三:判断互联方式层是否成为瓶颈
把当前链路实测值与该互联方式的理论延迟区间做对比。云专线的延迟稳定,波动通常在几毫秒内;VPN 隧道常见特征是延迟忽高忽低,带宽上不去,因为隧道封装、加密和公网拥塞都会放大抖动。如果 mtr 前几跳正常、但端到端延迟明显高于理论值,瓶颈可能就在互联方式本身。
步骤四:检查应用调度与数据同步路径
查看流量是否被集中调度到远距离节点清洗或转发,同步模式是否采用主从强一致。结合应用日志,把网络传输耗时和应用处理耗时分开:请求排队时间、数据库慢查询、网关处理时间都属于应用层延迟。如果日志显示网络往返时间正常,但业务响应慢,说明问题不在云间链路,应用调度才是多云互联延迟优化的重点。
四、根据排查结果选择优化方案
1. 物理层问题:调整地域布局或改用专线直连
如果物理距离过大或者路径必须跨洲,软件优化无法完全消除基础延迟。优先级更高的做法是调整部署位置,比如把双云部署放回同一区域,缩短物理路径。如果业务允许,云专线或点对点专线能减少中继跳数,降低基础延迟。SD-WAN 降低跨云延迟的能力主要体现在避开拥塞路径,但对千米级物理距离本身无能为力。
2. 中间网络问题:用 SD-WAN 做动态选路
中间网络拥塞时,SD-WAN 通过多链路质量探测和动态路径调度,自动避开劣化路径。据百度智能云公开案例,某平台采用 SD-WAN 后跨云请求延迟从 120ms 降至 45ms。这类优化对公网路径绕行、链路抖动有直接效果。物理距离产生的固定延迟仍会保留,但如果中间路径是主因,SD-WAN 的降幅会比较明显。
3. 互联方式问题:按业务分层混合组网
同一套云间网络不需要全部用专线。云专线承载核心交易和对延迟敏感的服务;SD-WAN 承载一般业务和分支访问;VPN 仅作为备份或应急通道。分层后,专线预算集中在高价值业务上,低敏感业务不会额外占用高价资源。定性成本上,云专线投入最高,SD-WAN 居中,VPN 最低,组合方案比全量专线更可控。
4. 应用调度问题:调整同步策略与数据路径
如果定位到流量绕行或同步策略过紧,调整这一层往往成本最低、见效最快。把集中式清洗改为就近清洗,把同步复制改为半同步或异步加补偿机制,可以直接缩短端到端感知延迟。应用调度改造通常不需要新增网络资产,属于排查结果明确后的优先动作。
五、常见排查误区与避坑建议
1. 把带宽和延迟混为一谈
带宽是管道能同时通过的数据量,延迟是第一个数据包从源头到目标的时间。两者相互独立。如果出现高延迟,只升级带宽不会让数据包更快到达,应当回到四层排查框架找根因。
2. 只做单点测试,不做双向对比
单向测试看不到回程路径。运营商不对称路由在农村或跨运营商场景下并不少见,可能出现 A 到 B 正常、B 到 A 严重拥堵的情况。双向 mtr 数据缺一不可,否则可能误判链路整体状态。
3. 一看到延迟高就换线路
不定位就换线路,问题可能只是从一条劣化路径转移到另一条。先按物理链路、中间网络、互联方式、应用调度分层定位,再根据结果决定是否换线、换哪一种线。这样能避免反复采购,也能让优化动作落在真正的瓶颈上。
本文由犀思云技术团队撰写,含相关产品服务信息,仅供技术交流。
参考来源:
- 腾讯云开发者社区《跨区域的网络专线一般延迟是多少》:https://cloud.tencent.com/developer/article/2493092
- 腾讯云开发者社区《云服务器网络延迟与丢包问题定位(mtr 工具)》:https://cloud.tencent.com/developer/article/2493092
- 腾讯云技术百科《如何优化多云集群接入的网络延迟问题》:https://cloud.tencent.com/developer/techpedia/2464/19184
- 百度智能云《双云多活架构与双云网络》公开资料