随着AI应用从简单闲聊问答转向工程级代码开发、数百页长文档审查、多模态综合分析、长周期自主智能体任务,业务对大模型基座的综合能力提出更高要求。Qwen3.8‑Max作为新一代旗舰基座,采用2.4万亿总参数稀疏MoE混合专家架构,推理阶段仅激活95B有效参数,平衡超强能力上限与可控推理开销。原生支持最高100万Token超大上下文窗口,一体化原生多模态,支持文本、图片、视频、PDF、Excel等各类素材输入,提供深度思考/极速两套推理模式,内置MCP多智能体协作、隐式上下文缓存、结构化JSON输出、函数调用等全套生产级能力。既能够满足普通用户办公内容创作,也可以承接企业复杂Agent业务、完整工程项目开发、法律合同批量审阅、科研数据分析等高难度任务。本文从底层架构、核心功能、三类使用入口、可直接复制运行的API代码、典型业务场景、计费成本优化、常见故障排查多个维度完整展开,帮助个人使用者、开发者、企业研发团队快速完成原型验证直至生产业务落地。
一、Qwen3.8‑Max底层技术架构核心突破
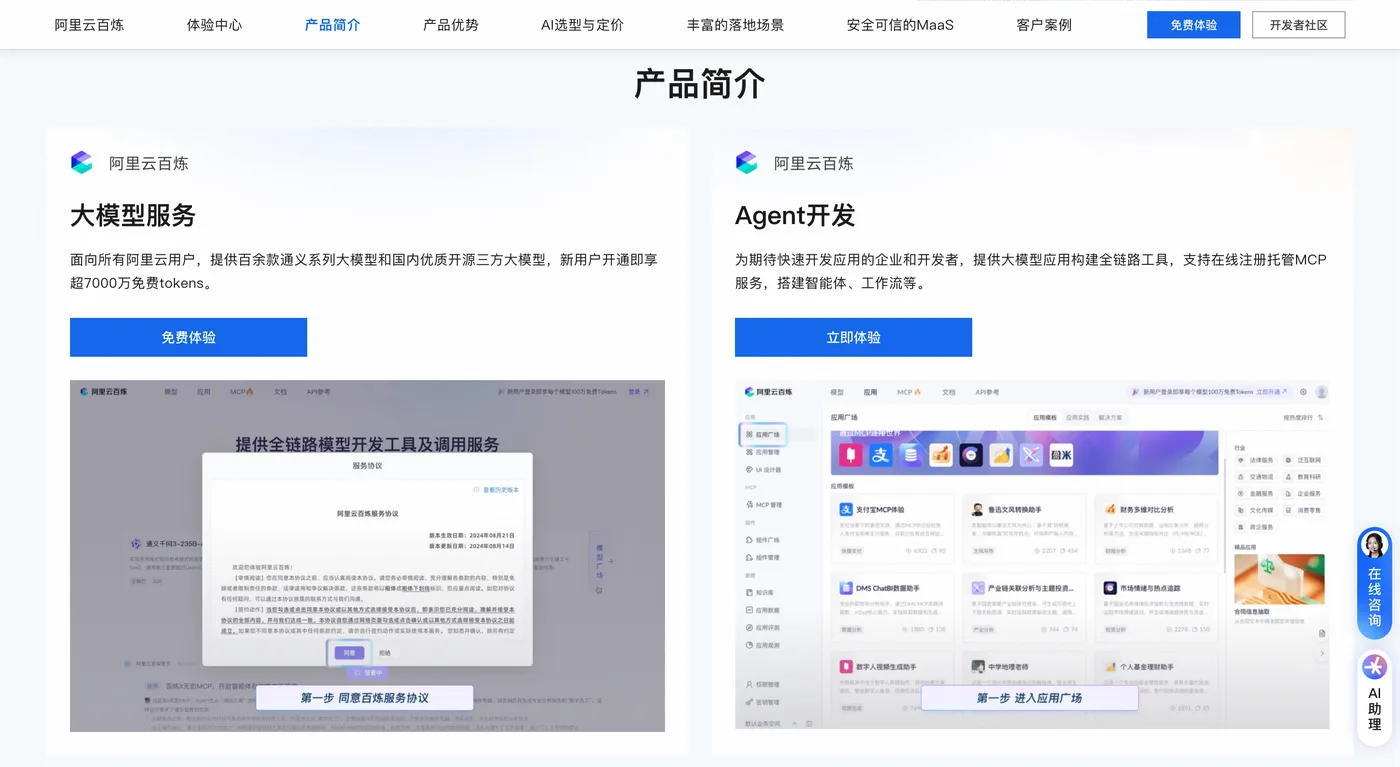
Qwen3.8‑Max采用第三代稀疏混合专家MoE架构,整体总参数量达到2.4万亿,推理过程不会加载全部参数,根据任务类型按需激活95B专家参数,解决超大参数量模型推理成本居高不下的痛点,实现模型能力、推理速度、使用成本三者的平衡。对比前代产品在三大核心模块完成升级:混合注意力机制优化,长文本跨段落关联理解能力提升40%;专家路由算法迭代优化,复杂任务场景专家模块匹配准确率提升25%;整体推理引擎重构,推理速度整体提升30%,同等业务场景Token消耗下降30%。详情👉访问阿里云百炼大模型服务平台页面 了解。
上下文能力是该模型一大核心亮点,原生最高支持100万Token上下文窗口,文本等效约75万字。可以一次性完整载入300页PDF合同、百万行完整项目源代码、数十小时视频字幕文本,完整读取原始业务素材,不需要人工做文档切片拆分,规避分段处理带来信息丢失、逻辑断裂的问题。依托超大上下文能力,长文档场景事实幻觉错误率下降60%,可以追踪跨章节、跨多份文档之间的逻辑关系,适配法律卷宗审核、完整代码库解析、整本专业技术书籍解读等高门槛业务。
模型属于原生一体化多模态基座,不依赖外部外挂视觉模型,可以直接接收图片、视频、PDF、Excel等多格式输入,完成图文音视频混合信息理解并且输出文本结果。支持解析高分辨率业务图表、工程图纸、手写扫描文档、长视频抽帧内容,实现素材输入到分析输出全链路闭环。支持reasoning_effort推理深度参数,开发者可以自由切换深度思考模式和极速模式,兼顾业务输出精度与接口响应速度。同时内置隐式上下文缓存机制,针对重复出现的系统提示词、固定参考文档前缀自动完成缓存命中,命中之后输入Token计费大幅降低,对于知识库问答、固定系统提示词的高频业务可以显著压缩开销。
二、五大核心功能能力详解
1. 双模式推理:深度思考与极速响应自由切换
模型具备两套独立推理链路,通过参数reasoning_effort进行控制,适配不同复杂度业务需求。
- 深度思考模式(xhigh,默认开启):模型内部逐层拆解复杂问题,输出完整的推理思考过程,适合复杂逻辑推演、工程代码开发、法律合同审查、科研论证类任务,输出严谨度更高,但接口响应耗时会变长,思考推理产生的内容会计入输出Token产生计费消耗。
- 极速模式(low):精简内部推理迭代链路,接口响应速度提升50%,Token消耗下降30%,适合简单问答、文本摘要、轻量化批量生成,满足高并发低延迟业务诉求。
参数可选档位包含none/minimal/low/medium/high/xhigh,业务系统可以做动态路由:简单业务请求自动切换low档位,复杂业务切换xhigh档位,兼顾输出效果与调用成本。详情👉访问阿里云百炼大模型服务平台页面 了解。
2. 工程级全栈代码与长周期编程智能体
Qwen3.8‑Max内置127种编程语言语法解析能力,多项权威编程评测取得高分。官方实测可以无人工干预持续运行十数天,完成完整开源项目开发,产出数百次代码提交,达到主流Agent框架的工程开发能力。能力覆盖从零生成完整多文件项目、百万级别代码仓库理解重构、报错日志自动定位修复、单元测试自动编写、跨模块工程调试。既可以输出短小工具脚本,也可以交付完整前后端项目、CLI工具、数据分析系统。
3. MCP多智能体协作,长周期自主任务闭环
原生兼容MCP多智能体协作协议,接收到复杂业务目标时,可以自主拆解多级子任务,规划执行步骤,调用外部工具获取信息,校验执行结果,如果输出结果不符合预期自动迭代修正,形成“规划‑执行‑校验‑优化”完整业务闭环。支持多个子智能体分工负责不同业务模块,适合论文复现、大型系统搭建、多维度市场调研这类长周期复杂任务,能够承受数千轮工具调用而不会发生任务目标漂移。
4. 原生多模态全链路处理能力
- 图像场景:解析网页截图、工程图纸、业务报表图表、手写文档,提取图表数值,UI截图直接转换前端代码;
- 视频场景:解析长视频内容,提取关键帧,输出视频结构化摘要、事件梳理;
- 文档场景:直接解析PDF、Word、Excel文件,提取表格与文本,开展合同审阅、报表分析;
- 视觉反馈闭环:生成代码、设计方案之后,再次传入截图素材做结果校验,识别偏差自动迭代优化输出。
5. 隐式上下文缓存、结构化输出、批量异步推理
隐式缓存自动识别重复请求前缀,例如固定不变的系统Prompt、固定参考文档,缓存命中后输入Token费用仅原价10%,不需要开发者手动维护缓存资源;支持强制JSON结构化输出,方便程序直接解析返回结果;支持Batch批量异步推理,适合离线大批量文档处理,可享受批量任务折扣计价,降低离线业务成本。
三、三类使用入口:网页端、桌面客户端、API开发者接入
1.Web网页端快速体验
浏览器访问网页对话站点,登录账号,模型选择切换为Qwen3.8‑Max,支持直接上传图片、视频、PDF文档下发指令交互。网页免费版本设置每日对话次数上限,适合个人快速验证想法,不适合大规模自动化业务调用。
2.桌面客户端
提供Windows、macOS客户端,支持窗口置顶、多会话管理、本地文件便捷上传,适合日常办公、代码调试,交互体验优于浏览器网页。
3.API开发者接入(DashScope)
开发者通过百炼平台DashScope API完成业务集成,既可以对接自研业务系统,也兼容OpenClaw、Hermes Agent等开源Agent框架。
第一步登录百炼平台,进入API密钥管理页面,创建sk‑开头API密钥,密钥创建完成仅展示一次完整明文,务必妥善保存。
安装SDK依赖包:
pip install dashscope
Linux/macOS终端设置环境变量,禁止密钥硬编码写入代码:
# 临时生效
export DASHSCOPE_API_KEY="sk‑xxxxxxxxxxxxxxxxxxxxxxxxxxxx"
# 写入bashrc实现永久生效
vim ~/.bashrc
export DASHSCOPE_API_KEY="sk‑xxxxxxxxxxxxxxxxxxxxxxxxxxxx"
source ~/.bashrc
Python基础文本对话示例:
import os
import dashscope

dashscope.api_key = os.getenv("DASHSCOPE_API_KEY")

messages = [
    {
   "role":"system","content":"你是资深后端工程师,输出代码附带详细注释"},
    {
   "role":"user","content":"编写Python脚本读取csv日志,统计错误日志并输出markdown统计报告"}
]

resp = dashscope.Generation.call(
    model="qwen3.8-max",
    messages=messages,
    reasoning_effort="xhigh",
    max_tokens=8192
)

print("模型输出结果:")
print(resp.output.text)
多模态调用示例,传入图片URL,实现UI截图转前端代码:
import os
import dashscope

dashscope.api_key = os.getenv("DASHSCOPE_API_KEY")

messages = [
    {

        "role":"user",
        "content":[
            {
   "image":"https://demo‑ui‑screenshot.png"},
            {
   "text":"基于这张UI截图,输出响应式HTML+Tailwind CSS前端代码"}
        ]
    }
]

resp = dashscope.MultiModalConversation.call(
    model="qwen3.8-max",
    messages=messages
)
print(resp.output.choices[0].message.content[0]["text"])
curl命令行快速测试接口:
curl https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions \
-H "Authorization: Bearer sk‑xxxxxxxxxxxxxxxxxxxxxxxxxxxx" \
-H "Content‑Type:application/json" \
-d '{
"model":"qwen3.8-max",
"messages":[{"role":"user","content":"简述MoE混合专家模型运行原理"}],
"reasoning_effort":"medium",
"temperature":0.6
}'
读取本地长文档送入百万上下文窗口处理示例:
import os
import dashscope

dashscope.api_key = os.getenv("DASHSCOPE_API_KEY")

with open("./business_contract.txt","r",encoding="utf‑8") as f:
    long_text = f.read()

messages = [{

    "role":"user","content":f"阅读这份合作合同,梳理全部风险条款,输出markdown表格形式建议:\n{long_text}"}]

resp = dashscope.Generation.call(
    model="qwen3.8-max",
    messages=messages,
    max_tokens=131072
)
print(resp.output.text)
四、典型业务实战场景
场景一:长文档法律、科研资料深度分析
业务需求:解析数百页合作合同,提取付款、违约、保密相关风险;解析科研论文梳理研究方法、实验结论。
实操:文档转为纯文本,也可以直接上传PDF,下达结构化输出指令。依托百万上下文不需要手动拆分文档,一次性全局分析,输出结果之后继续多轮追问针对条款深度解读。参考指令示例:“完整阅读这份合同,梳理风险点,写明风险内容以及对应的修改建议,输出markdown表格”。
场景二:工程级软件开发,完整项目生成与重构
业务需求:从零开发数据分析工具,或者对存量大型项目开展代码重构、Bug定位修复。
实操:提交完整业务需求,模型输出项目架构、多文件代码、依赖清单、单元测试。代码运行报错,直接把完整报错堆栈提交给模型自动调试。大型项目建议分阶段迭代,降低单次上下文负载。
场景三:多模态办公:截图、报表、视频素材分析
业务需求:UI截图转前端代码;报表截图提取数据生成分析报告;长视频生成结构化摘要。
实操:直接上传图片、视频素材,下发业务指令。原生多模态直接解析素材,无需额外OCR预处理,直接产出代码与分析结论。
场景四:长周期智能体任务,论文复现、复杂仿真实验
业务需求:复现AI学术论文,完成环境搭建、代码实现、实验运行,输出完整复现报告。
实操:提交论文资料,下发完整任务目标。模型自主拆解子任务,依次完成环境配置、编码、调试实验、撰写报告,长周期自动执行,适合科研探索类任务。
五、计费与订阅方案,成本优化实操
Qwen3.8‑Max支持按量付费、Token Plan订阅套餐两套计费模式。
按量付费标准价格:输入12元/百万Token,输出36元/百万Token;隐式缓存命中输入仅1.5元/百万Token;Batch批量异步推理面向离线大批量文档处理,可享受折扣。
Token Plan订阅分为个人版、团队版,以Credits积分抵扣调用消耗,包月预算可控,适合高频持续Agent自动化业务。另外还有Coding Plan代码专属套餐,面向编程场景做成本优化。
成本优化实操要点:
- 根据业务复杂度动态切换推理档位,简单任务
reasoning_effort设置low或者none,关闭深度思考,减少推理过程输出带来的Token消耗; - 将固定系统提示词、固定参考文档放置请求上下文头部,触发隐式缓存,降低重复输入开销;
- 大批量离线文档处理优先选择Batch异步批量推理;
- 长对话业务定期裁剪历史上下文,只保留关键信息,避免上下文无限膨胀带来成本上涨;
- 在控制台开启预算告警,设置消耗阈值,规避脚本死循环造成超额账单。
简易Token消耗测算脚本,预估任务开销:
def calc_cost(input_tokens:int,output_tokens:int,cache_hit:bool=False):
    price_input=12/1000000
    price_input_cache=1.5/1000000
    price_output=36/1000000
    in_cost = price_input_cache*input_tokens if cache_hit else price_input*input_tokens
    out_cost = price_output * output_tokens
    total = in_cost + out_cost
    return f"预估调用费用{total:.4f}元"

if __name__ == "__main__":
    print(calc_cost(700000,90000,cache_hit=True))
    print(calc_cost(700000,90000,cache_hit=False))
六、常见问题FAQ与落地避坑指南
长文档调用响应速度很慢?
百万Token级别输入,需要大量算力完成语义处理,耗时变长属于正常现象。可以先用极速模式生成文档摘要,再针对摘要要点精细化提问,拆分任务降低单次负载。API返回401鉴权报错?
核对API Key字符串,确认不存在多余换行、空格;账号完成实名认证;确认密钥拥有qwen3.8‑Max调用权限;Token Plan订阅用户区分普通sk‑密钥和sk‑sp‑订阅专用密钥,两套密钥不可混用。图片、视频多模态输入识别异常?
图片优先JPG、PNG格式,视频使用MP4;扫描版PDF不具备可复制文本,模型无法直接解析,需要提前做OCR转换为纯文本;图片URL需要公网可访问。代码生成运行报错?
完整把报错堆栈、运行日志传给模型,不要截取部分报错片段;Prompt中明确写明依赖库版本,减少版本兼容类问题。Token消耗居高不下怎么办?
精简输入内容,剔除无关冗余信息;简单任务关闭深度思考;开启隐式上下文缓存;长对话定期清理无用历史消息。长周期Agent任务中途中断失败?
设置合理API客户端超时时间;超长任务拆分为多个阶段,每一步保存中间结果;开启用量告警,防止额度耗尽直接终止任务。上下文越大输出效果就越好吗?
并非上下文越大效果就越好。输入Token规模极高时,模型对靠前位置内容召回能力会下降。业务实践建议,核心指令放置Prompt最前面,参考辅助材料放在后面,保障关键指令不会被大量素材稀释。
七、总结
Qwen3.8‑Max依托2.4万亿参数MoE稀疏架构、100万Token超大上下文、原生一体化多模态能力、双推理模式、MCP多智能体协作,把大模型能力边界从简单问答拓展到长周期自主Agent任务、工程级软件开发、多模态素材处理、海量文档深度分析等高阶业务场景。详情👉访问阿里云百炼大模型服务平台页面 了解。
普通用户可以通过网页端、桌面客户端零门槛快速体验;开发者依托OpenAI兼容的DashScope API,快速集成进自研业务,同时也可以对接各类开源Agent框架。业务落地阶段,合理使用推理深度参数、隐式上下文缓存、批量异步推理,搭配预算告警规避超额账单。
选型策略上,临时测试业务选用按量付费;高频持续自动化业务优先Token Plan订阅套餐。同时需要意识到,百万上下文不等于无条件性能提升,提示词排布、任务拆分、思考模式开关,都会直接影响最终输出质量。掌握模型本身特性和调优技巧,就可以充分释放Qwen3.8‑Max的能力,大幅提升研发、办公、科研场景的生产效率。