
随着大模型技术持续落地,开发者、独立创作者、企业团队经常会同时使用文本大模型、视觉理解、文生图、AI视频生成、语音处理、智能体Agent框架等多种多样的AI能力。传统模式之下,不同模型、不同工具分属不同产品体系,需要分别开通服务、采购各自资源包,维护多套访问密钥。计费规则五花八门,有的按Token统计、有的按生成次数、有的按图片张数、有的按视频时长计量。预算分散,用量数据割裂,很难统计整体AI业务成本。同时各类Agent开发框架、AI编程工具对接流程繁琐,团队协作的时候缺少席位分配、用量审计、成员权限管控的配套能力。
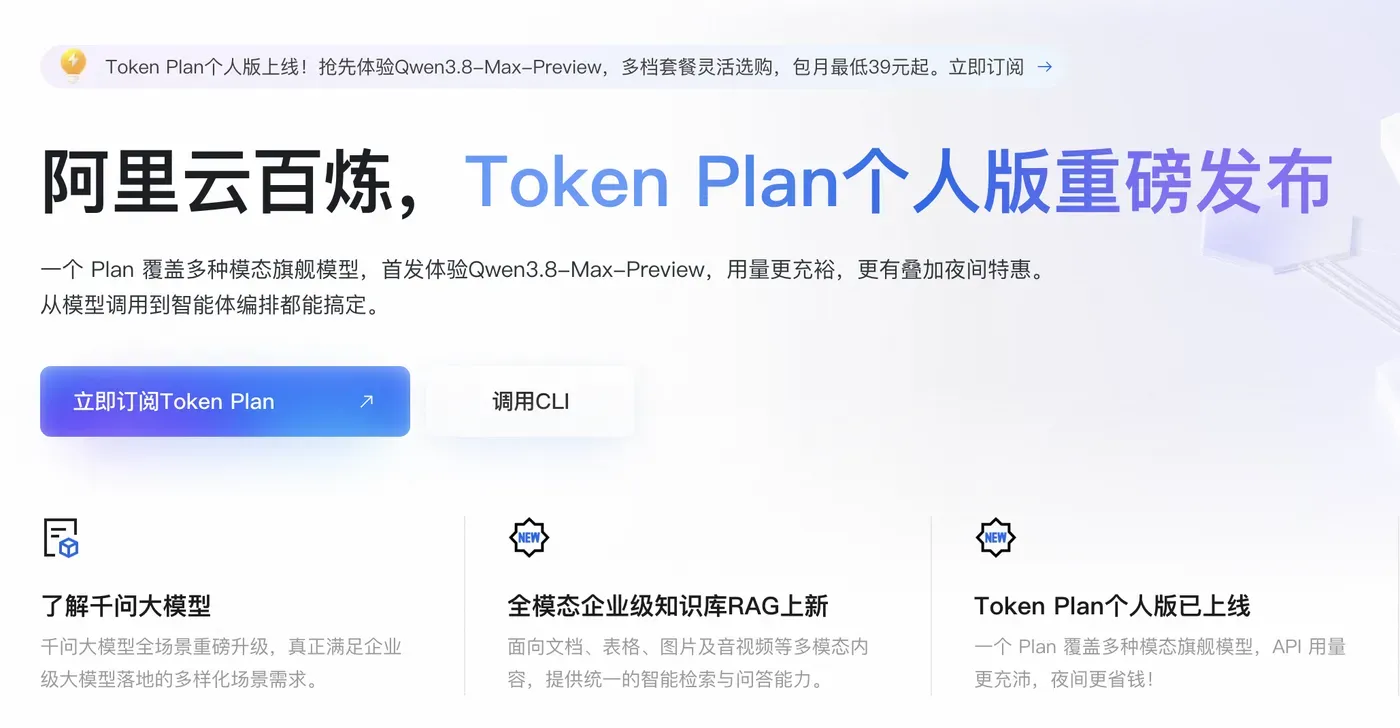
Token Plan是百炼平台推出的订阅式AI服务,以Credits作为统一抵扣计量单位,一份订阅即可打通文本推理、多模态视觉、图片生成、视频生成、语音处理,同时兼容Harness工具集、多款主流AI编程与智能体框架。实现一套订阅覆盖全栈AI能力,解决多模型多工具分散订阅、计费碎片化的行业痛点。本文从产品定位、Credits抵扣机制、个人版与团队版差异、支持模型工具矩阵、完整API实操代码、套餐选型策略、成本优化、高频故障排坑多个角度完整讲解,帮助开发者快速理解这套订阅体系,完成业务接入,科学管控AI调用成本。详情👉访问阿里云百炼Token Plan服务页面了解。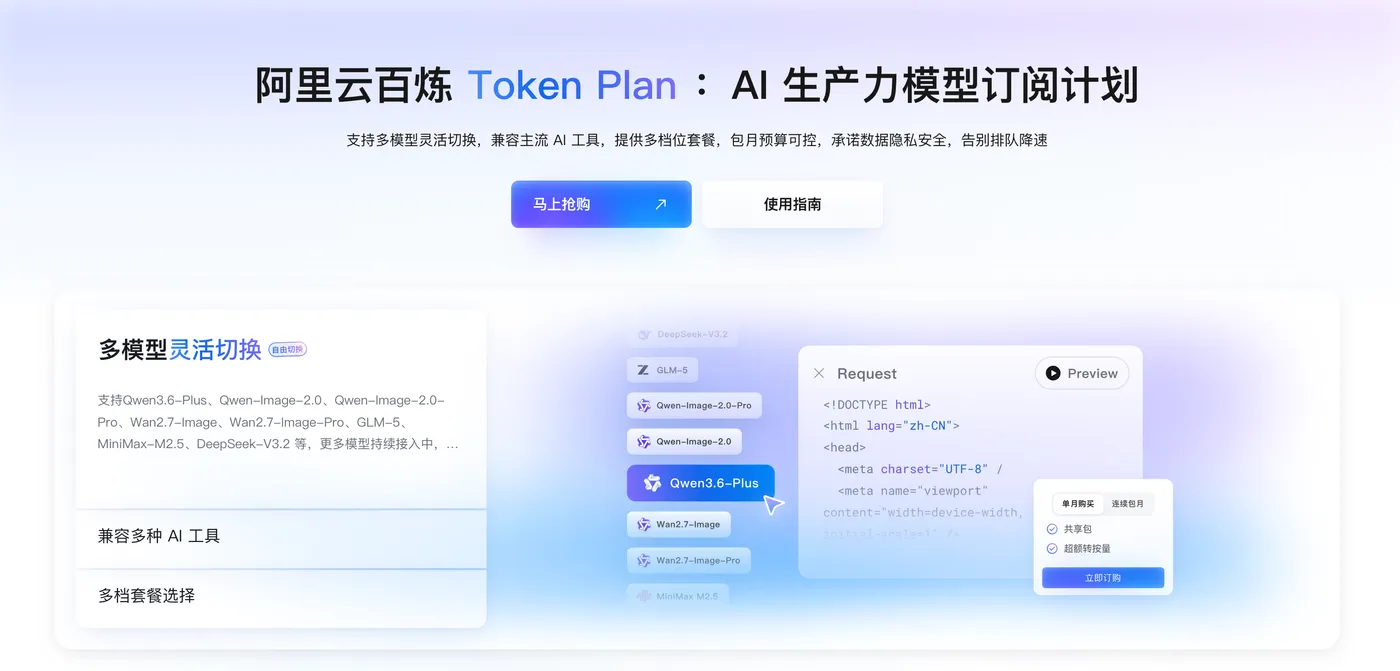
Token Plan属于独立订阅体系,和平台原生按量付费、Coding Plan是三套互相独立的计费通道,API密钥、访问域名完全隔离,不可互相混用。Coding Plan偏向纯代码场景,以调用次数作为限额;按量付费属于后付费模式,各个模型单独计价;Token Plan全部调用统一折算Credits扣减,开发者不需要记忆每一款模型输入输出单价,系统自动换算扣费,大幅降低成本核算的复杂度。地域层面,Token Plan当前仅支持华北2(北京)地域,购买订阅、发起接口调用,控制台都必须切换到此地域,如果在其他地域操作,会出现订阅已经购买,调用却无法抵扣额度,直接走按量付费产生意外账单。
一、Token Plan核心能力体系
1. Credits统一计量抵扣机制
Credits是这套订阅的专属消耗单元,文本输入输出Token、缓存命中Token、图片解析、图片生成、视频生成、语音处理、Harness工具调用全部折算为Credits消耗。不同模型权重存在差异,旗舰大模型单次请求消耗更多Credits,轻量高速模型消耗更少。
视频生成这类异步任务,不会在提交任务瞬间扣减额度,等待任务执行完成之后才统一结算Credits。短时间批量提交大量视频任务,会出现额度集中扣除,开发业务系统时需要把这个特性纳入业务逻辑设计。
上下文缓存命中场景会享有Credits折扣,长对话、Agent多轮循环任务,充分利用缓存可以显著节约额度消耗。单次请求实际消耗,由输入输出长度、是否开启深度思考模式、是否调用工具、选用模型规格共同决定。正式业务上线之前,建议使用小规模请求做压测,查看控制台真实Credits消耗,以此作为成本测算依据,不要单纯依靠理论数值估算开销。详情👉访问阿里云百炼大模型服务平台页面 了解。
2. 全栈多模态能力覆盖
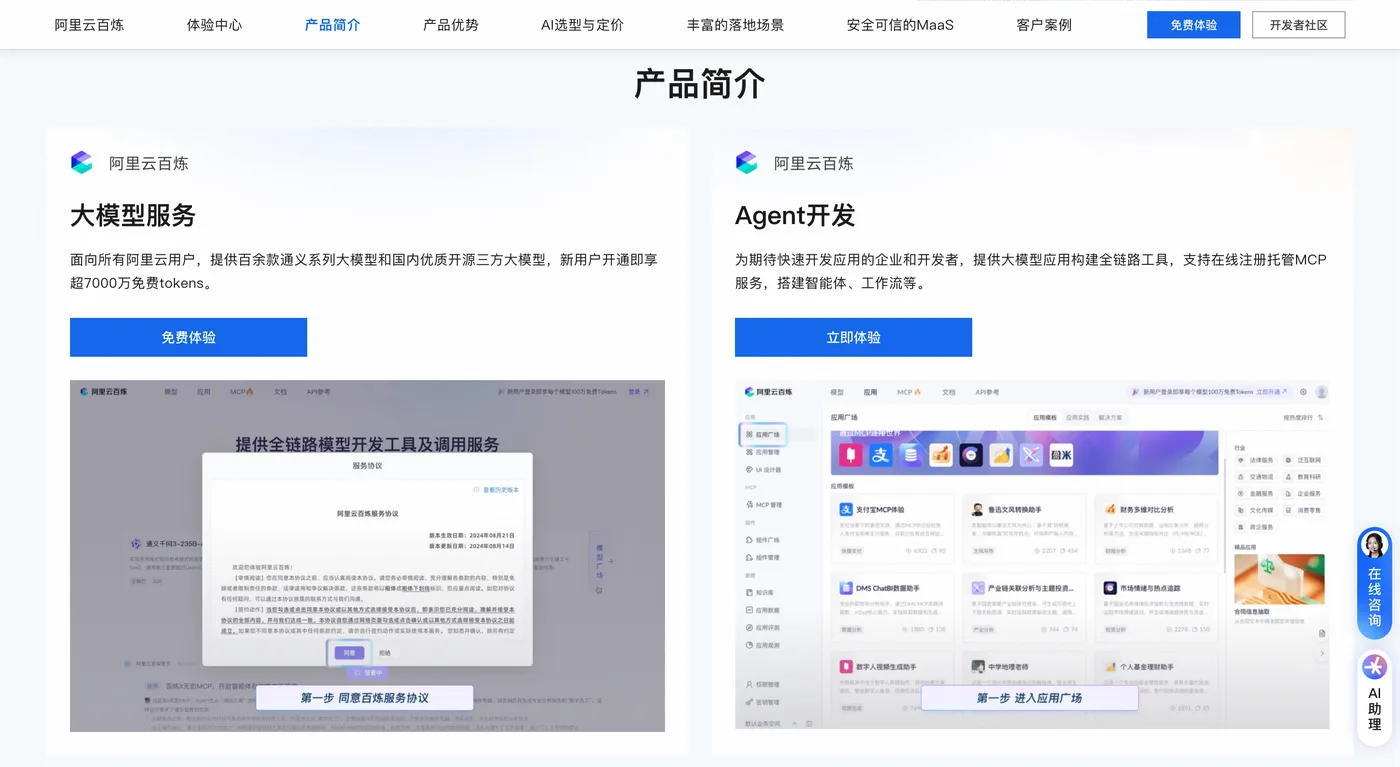
订阅生效之后,即可直接调用文本长上下文推理、Agent智能体、视觉图片理解、文生图、图生图、语音识别合成、实时语音对话、AI视频生成各类模型,覆盖Qwen全系列、多款第三方主流大模型。同时内置Harness工具集,包含联网搜索、网页内容抓取、代码解释器、文搜图、图搜图等工具,不需要额外开通增值服务,就可以搭建完整智能体应用。
3. 广泛第三方工具生态兼容
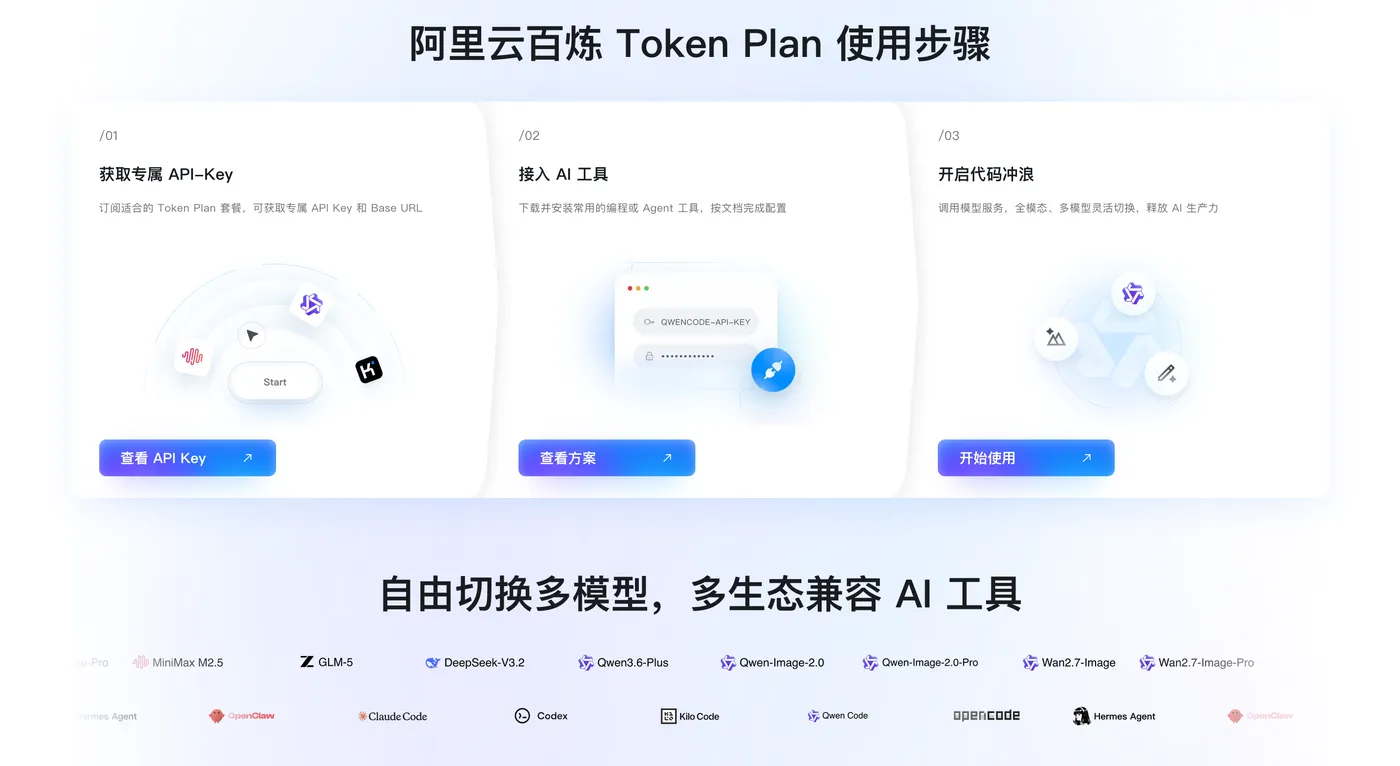
接口层面同时兼容OpenAI、Anthropic两套主流协议。只要工具支持自定义Base‑URL以及自定义API Key,就可以对接Token Plan服务,覆盖大量AI编程助手、Agent运行框架。开发者只需要填入订阅生成的专属API Key与对应访问地址,即可消费套餐内Credits,不需要对工具做二次开发改造。
注意:完全不支持自定义接口地址的闭源工具,无法接入Token Plan套餐,只能使用平台按量付费通道。
4. 个人版、团队版两套版本
个人版面向独立开发者、自由创作者,分为Lite、Standard、Pro三档订阅套餐,存在7天滚动用量限额,到达限额调用就会被拦截,可以额外采购用量包解除限额,适合个人学习、原型调试、小规模创作。
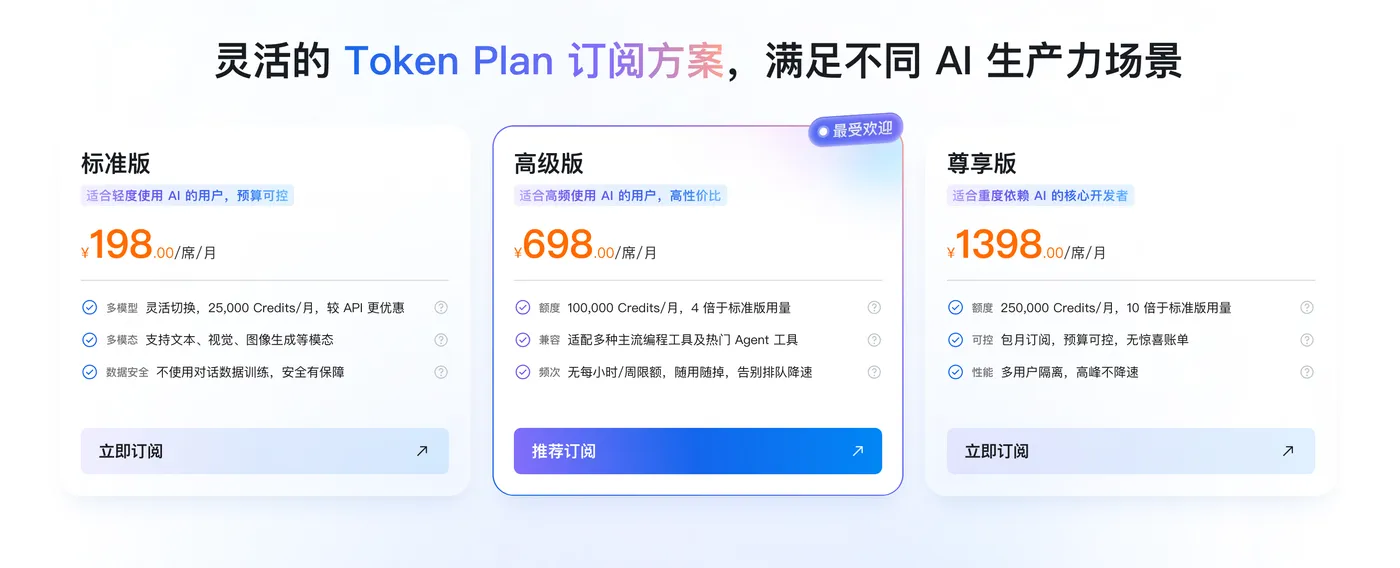
团队版面向企业、多人协作小组,分为标准、高级、尊享坐席档位,支持席位分配、成员用量统计、用量审计。管理员可以分配回收席位,查看每一位成员消耗明细,方便企业内部预算分摊,不存在个人版7天滚动窗口限制,适合常态化业务开发、企业内部办公辅助场景。
5. 独立密钥隔离与用量观测
Token Plan会生成专属套餐API Key,密钥格式与普通按量付费sk‑开头密钥不同,搭配专属兼容模式访问域名。禁止将Token Plan密钥用在普通按量付费域名,也不可以将普通按量密钥填入Token Plan接口地址,混用会鉴权失败,或者直接触发按量扣费,这是接入阶段最高频踩坑点。
订阅控制台可以直观查看剩余Credits、消耗趋势、到期时间、每一次调用的消耗明细,每一笔消耗都可以追溯。套餐额度耗尽之后,可以购买额外用量包补充额度,不需要变更主订阅档位。订阅周期结束,未使用完毕Credits不会结转至下一个周期,到期直接清零,需要根据月均消耗选择合适套餐,避免额度闲置浪费。
重要区分:Token Plan专属API Key不会消耗账户免费试用额度,免费额度仅适配普通按量付费通用密钥,两套体系完全隔离。想要体验免费额度测试,应当切换普通按量密钥调用接口。
二、Credits抵扣执行逻辑
个人版优先消耗套餐本身Credits额度,达到7天窗口限额之后调用被阻断;购买用量包之后,继续消耗用量包额度。详情👉访问阿里云百炼Token Plan服务页面了解。
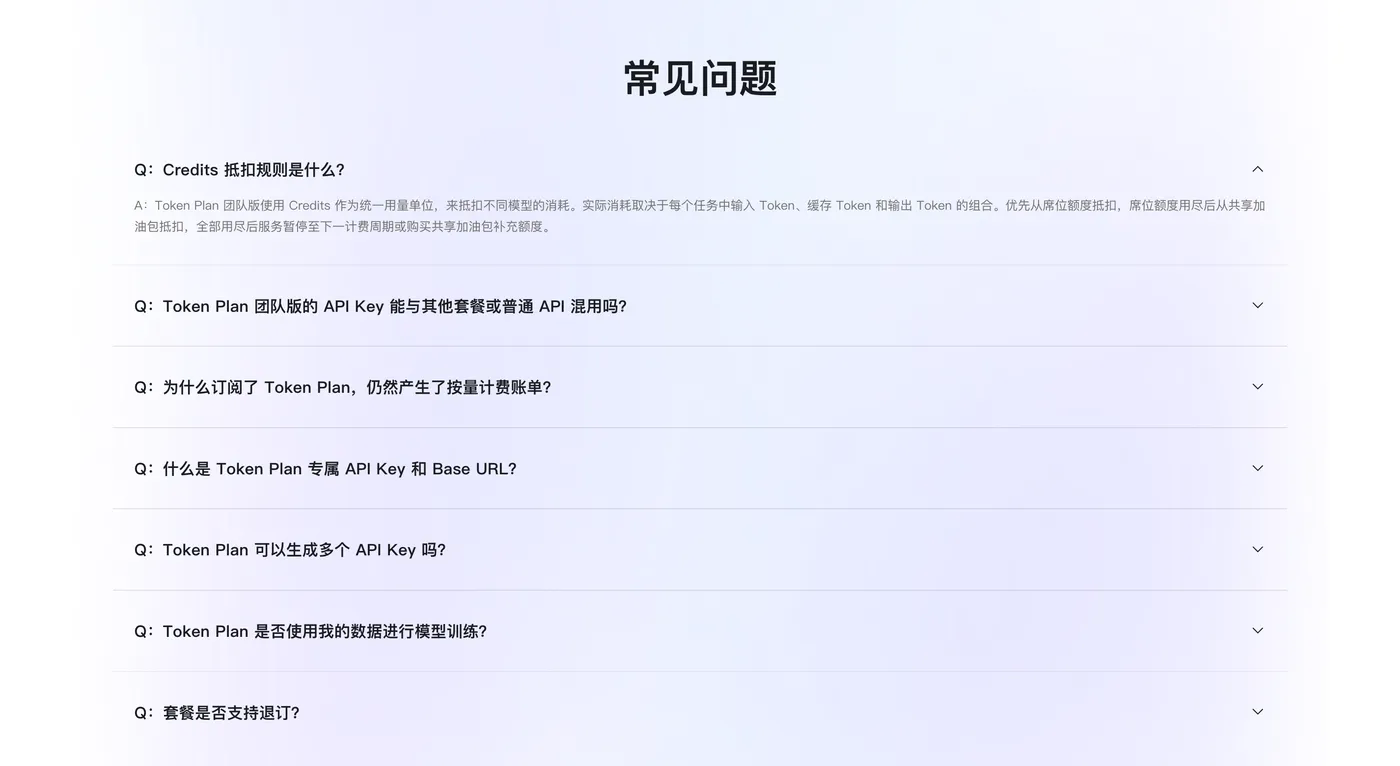
团队版抵扣顺序:优先消耗分配给坐席的月度Credits额度;席位额度耗尽,自动消耗团队共享用量包;如果持有多个共享用量包,优先抵扣距离到期时间最近的用量包;席位额度、用量包全部耗尽,接口调用直接暂停,等待订阅周期重置或者新增用量包恢复服务。
缓存命中会带来消耗折扣,长会话、循环Agent场景收益非常明显。异步视频任务延迟扣费,业务批量提交任务,需要做好队列管控,避免额度瞬间耗尽。
三、完整接入实操教程
完成订阅之后,控制台切换至华北2(北京)地域,进入Token Plan订阅详情页面,复制OpenAI兼容模式BaseURL、套餐专属API Key。OpenAI兼容地址、Anthropic兼容地址以控制台展示内容为准。下面提供Python SDK调用、curl命令调试、服务器shell监控脚本、Agent框架配置示例。
Python调用OpenAI兼容接口示例:
#安装依赖
#pip install openai
import os
from openai import OpenAI

#从环境变量读取密钥,禁止硬编码写入业务代码
TOKEN_PLAN_API_KEY = os.environ.get("TOKEN_PLAN_API_KEY")
#替换控制台获取的兼容BaseURL
TOKEN_PLAN_BASE_URL = "https://token-plan.cn-beijing.maas.aliyuncs.com/compatible-mode/v1"

client = OpenAI(
    api_key=TOKEN_PLAN_API_KEY,
    base_url=TOKEN_PLAN_BASE_URL
)

def token_plan_chat():
    resp = client.chat.completions.create(
        model="qwen3.8-max",
        messages=[
            {
   "role":"system","content":"你是技术助手,回答简洁精炼。"},
            {
   "role":"user","content":"简述智能体Agent的任务编排实现思路"}
        ],
        temperature=0.7,
        max_tokens=2048
    )
    print(resp.choices[0].message.content)
    return resp

if __name__ == "__main__":
    token_plan_chat()
curl命令快速调试接口,验证连通性,适合脚本开发阶段调试:
export TOKEN_PLAN_API_KEY="控制台复制sk-sp开头密钥"

curl --location 'https://token-plan.cn-beijing.maas.aliyuncs.com/compatible-mode/v1/chat/completions' \
--header "Authorization: Bearer ${TOKEN_PLAN_API_KEY}" \
--header 'Content-Type: application/json' \
--data '{
 "model":"qwen3.7-flash",
 "messages":[{"role":"user","content":"输出一段遍历日志文件的shell脚本"}],
 "max_tokens":1024
}'
部署在服务器上的shell监控脚本,周期性做连通性检测,记录调用日志:
#!/bin/bash
export TOKEN_PLAN_API_KEY="你的sk-sp密钥"
LOG_PATH="/var/log/tokenplan_monitor.log"

while true
do
RESP=$(curl -s --location 'https://token-plan.cn-beijing.maas.aliyuncs.com/compatible-mode/v1/chat/completions' \
--header "Authorization: Bearer ${TOKEN_PLAN_API_KEY}" \
--header 'Content-Type:application/json' \
--data '{
 "model":"qwen3.7-flash",
 "messages":[{"role":"user","content":"hello"}],
 "max_tokens":128
}')
echo "`date` 接口调用返回:${RESP}" >> ${LOG_PATH}
sleep 3600
done
主流Agent框架OpenClaw配置片段,填入Token Plan参数即可自动抵扣套餐额度:
llm:
  api_base: "https://token-plan.cn-beijing.maas.aliyuncs.com/compatible-mode/v1"
  api_key: "sk-sp-xxxxxxxxxxxx"
  model: "qwen3.8-max"
保存配置,重启Agent服务,后续全部模型请求就会消耗Token Plan套餐Credits,不会走按量付费通道。
四、版本选型对比策略
- 个人版Lite/Standard/Pro:适合独立开发者、个人创作者,做原型开发、个人项目调试。注意7天滚动限额,大批量并发调用会触发限流。高频Agent循环、大量视频生成任务建议选择Pro档位,按需叠加用量包。
- 团队版标准/高级/尊享坐席:适合2人以上多人小组、企业内部使用,支持席位分配、用量审计,不存在7天滚动窗口限制。管理员可以查看每一位成员消耗数据,完成内部成本分摊。
- 按量付费:适合调用频次很低,偶尔测试场景,不需要订阅,但是单位调用成本更高。
- Coding Plan:偏向纯代码调用,对多模态、视频生成支持有限,大量用到图像视频Agent能力优先选择Token Plan。
选型实操建议:
- 个人日常开发调试,少量Agent多模态需求,优先选择个人版Standard档位;
- 个人高频使用,大量视频、长循环智能体任务,选择Pro,按需叠加用量包;
- 两人及以上团队协同,需要用量统计、权限管控,直接选择团队版;
- 仅偶尔少量测试,调用频次很低,优先按量付费,不用采购订阅套餐。
五、成本优化实操方案
- 分层选用模型:简单文本摘要、意图识别等低复杂度任务优先使用Flash系列高速模型,Credits消耗更低;复杂逻辑推理、深度代码重构场景,再使用Max系列旗舰模型,避免全部请求都使用高消耗旗舰模型,节约整体成本。
- 充分启用上下文缓存:长对话、Agent循环任务开启缓存,命中缓存的部分会有明显折扣,降低Credits开销。
- 视频生成控制调试参数:视频属于高消耗任务,前期业务验证优先使用短时长、低分辨率参数,业务逻辑确认无误,再调高参数,避免调试阶段大量消耗额度。
- 定期观测用量报表:订阅控制台查看每日每周消耗曲线,根据真实消耗调整套餐档位,不要盲目选购最高档位造成额度闲置。
- 异步任务队列限流管控:视频异步任务做好队列限流,避免短时间批量提交任务,造成Credits瞬间耗尽。
六、高频踩坑与故障排查
- 地域配置错误:Token Plan仅支持华北2(北京)地域。购买订阅、发起调用,控制台地域必须切换到此地域。地域错误会出现订阅已买,调用不抵扣额度,直接产生按量账单。
- 密钥与BaseURL混用:Token Plan专属sk‑sp密钥,只能搭配Token Plan专属域名;普通按量密钥不能填入Token Plan接口地址。混用会出现401鉴权报错,或者意外产生后付费账单,开发调试阶段务必核对配置。
- 额度不会跨周期结转:订阅周期结束,剩余Credits直接清零,不会滚存到下个月。结合月均消耗选择档位,不要盲目采购高规格套餐。
- 视频异步延迟扣费:提交视频任务的时候不会扣减Credits,任务执行完毕才扣费。批量提交任务需要预估总消耗,防止额度突然耗尽。
- 个人版7天滚动限额:个人版存在7天窗口消耗上限,返回429配额超限,不一定是余额耗尽,可能是滚动限额触发,可以等待窗口重置或者购买用量包解除限制。
- 不能复用免费试用额度:免费试用额度仅针对普通按量付费密钥,Token Plan专属密钥不会消耗免费额度,两套计费互相独立。
- 密钥安全管控:不要把API Key硬编码写入业务代码,优先使用环境变量、RAM角色,防止密钥泄露被恶意调用,短时间耗尽套餐额度。
- 第三方工具协议兼容校验:工具必须支持自定义BaseURL,无法修改接口地址的工具,不能接入Token Plan套餐,只能走按量付费。
总结
Token Plan依靠Credits统一计量体系,解决了过去多模型、多工具计费碎片化的痛点。一份订阅,就可以使用文本、多模态、视频生成、全套Harness工具,兼容大量主流AI编程与Agent框架,大幅降低多模型开发的配置、核算成本。个人版面向独立开发者,团队版面向企业多人协作,配套席位分配、用量审计,覆盖不同规模使用者诉求。
但是落地接入必须重视地域约束、密钥‑接口地址匹配、滚动限额、异步任务扣费等规则,规避混用密钥、地域选错等高频错误。业务正式上线之前,通过小规模请求实测Credits消耗,结合真实业务消耗选择套餐档位,配合分层调用模型、利用上下文缓存等优化手段,就可以在可控预算内完成全栈AI业务开发运行。
