人脑的记忆有遗忘曲线,Agent 的记忆呢?
一个被忽视的问题
2024 年以来,AI Agent 的能力在快速迭代——代码生成、工具调用、多步推理、自主规划——几乎每个月都有新东西出来。但在这些热闹的能力背后,有一个基础问题始终没解决好:
Agent 记不住东西。
当前绝大多数 Agent 的记忆是"会话级"的。一次对话就是一次完整的记忆周期:对话开始,记忆初始化;对话结束,记忆清空。下次再来?从零开始。
这就像你有一个能力很强但患有短期记忆丧失症的同事。每次合作你都要从头自我介绍,从头解释项目背景,从头对齐术语和约定。
这篇文章想聊的是:Agent 的记忆技术到底经历了哪些阶段?当前的瓶颈在哪里?我们距离"Agent 真正记住项目"还有多远?
上下文窗口:Agent 的"工作记忆"
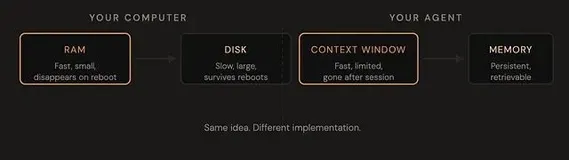
最早期的 Agent(或者说 LLM 本身)只有一种记忆形式:上下文窗口(Context Window)。
你可以把它理解为人类的"工作记忆"——容量有限,保持时间很短,只够处理当前任务。
技术实现也很直接:把所有历史对话拼成一个长文本,作为 Prompt 发给模型。模型能"记住"多少,取决于上下文窗口的长度。
问题很明显:
- 容量有上限。即使上下文窗口从 4K 扩展到 128K 甚至 1M,一个中大型项目的代码库轻松超过百万 Token。
- 成本线性增长。上下文越长,推理成本越高。把 100K Token 的上下文发给模型,每次推理都在烧钱。
- 注意力衰减。大量研究表明,LLM 对上下文中间部分的信息关注度明显低于首尾部分("Lost in the Middle" 问题)。
但更根本的问题是:上下文窗口本质上是一次性的。会话结束,窗口关闭,一切归零。
RAG:外挂知识检索
为了突破上下文窗口的容量限制,RAG(Retrieval-Augmented Generation)出现了。
RAG 的思路很直接:既然上下文窗口装不下所有信息,那就把信息存在外部知识库中,需要的时候再检索出来。
这是一个实实在在的进步。通过 RAG,Agent 可以"访问"远超上下文窗口容量的知识。你不需要把整个代码库塞进 Prompt,只需要在需要时检索相关的代码片段或文档。
但 RAG 有一个根本的局限:它是"无状态"的。
RAG 每次都是从一个静态的知识库中检索信息。它不知道"上次我们讨论了什么""用户偏好什么风格""这个项目之前踩过什么坑"。
打个比方:RAG 就像给了 Agent 一个图书馆借阅证。Agent 可以去图书馆查资料,但它没有笔记本——不能记录自己的阅读心得,不能标注重点,不能积累对某个领域的逐步理解。
具体来说,RAG 用在 Agent 记忆场景下有几个缺陷:
它缺乏时间维度。RAG 不知道一条知识是什么时候产生的,不知道它的"新鲜度"。三个月前的技术方案和昨天刚确认的架构决策,在 RAG 看来权重一样。
它也缺乏关联推理。RAG 基于文本相似度检索,无法理解知识之间的关联关系。比如"用户说喜欢简洁的代码风格"和"用户要求所有函数不超过 20 行",这两条信息在语义上不太相似,但实际上高度相关。
它还缺乏主动积累。RAG 是被动的——你需要显式地往知识库里添加内容。它不会自动从对话中提取有价值的信息并沉淀。
Agent Memory:让 Agent 拥有"笔记本"
为了解决 RAG 的局限,业界开始出现专门针对 Agent 记忆的方案,其中比较有代表性的是 Mem0。
Mem0 的思路是在 RAG 之上增加一层"记忆管理":自动从对话中提取信息,存储为结构化的记忆条目,并在后续对话中自动检索和注入。
这比纯 RAG 前进了一步。Agent 终于有了"笔记本"——它可以在对话过程中自动记录关键信息,下次对话时自动翻阅。
但现有 Agent Memory 方案普遍面临几个挑战:
准确率不够高。记忆提取和检索的准确率直接影响 Agent 的表现。如果 Agent 基于错误的记忆做出决策,后果比没有记忆更严重。
缺乏知识治理。记忆越积越多,如何去重?如何处理冲突信息(昨天用户说用 MySQL,今天改口要用 PostgreSQL)?如何管理记忆的时效性?
Token 成本高。很多方案简单粗暴地把大量记忆塞进上下文,导致 Token 消耗激增。
上下文数据库:记忆的系统化管理
这就引出了一个更新的思路:上下文数据库(Context Database)。
如果说 RAG 是给了 Agent 一个图书馆借阅证,Mem0 是给了 Agent 一个笔记本,那上下文数据库的思路是给了 Agent 一个完整的知识管理系统——有分类、有索引、有版本管理、有权限控制。
ContextDB 是目前这个方向上做得比较完整的一个实现。它的设计体现了几个思路:
三层记忆架构
它没有把记忆简单理解为"一条一条的记录",而是设计了三层结构:
原子事实(Atomic Fact)。 每次 Agent 与用户交互时,自动提取最小粒度的知识单元。比如"该项目使用 Spring Boot 3.2""用户偏好函数式编程风格""支付模块的超时时间设置为 5 秒"。每个原子事实都带有置信度分数和时间戳。置信度不是固定的——它会随时间衰减,也会被后续的确认或否定所调整。这解决了 RAG 缺乏时间维度的问题。
记忆实体(Entity Card)。 多个相关的原子事实聚合形成实体画像。关于"项目技术栈"这个实体,可能聚合了框架版本、数据库选择、部署方式等十几条原子事实。Agent 需要了解项目技术栈时,不用一条条检索,直接获取完整的实体画像。
记忆图谱(Memory Graph)。 实体之间建立关联关系,形成知识网络。"支付模块"关联到"超时重试策略","超时重试策略"关联到"幂等设计","幂等设计"关联到"分布式锁"。这使得 Agent 能够进行关联推理:当你问 Agent 关于支付模块的问题时,它不仅能检索到支付模块的直接信息,还能沿着图谱获取相关的技术决策和设计约束。
知识生命周期管理
对知识的管理不是"只增不减"的,有完整的生命周期:
- 启动:支持热启动(导入已有文档、Wiki、Confluence 页面)和冷启动(从零开始积累)。
- 准入:新知识的入库不是无条件的——AI 先做初步筛选,过滤明显的噪音;关键知识可以设置人工评审流程。
- 演进:自动去重、冲突消解、置信度衰减。如果两条记忆互相矛盾(比如"数据库用 MySQL"和"数据库用 PostgreSQL"),系统会根据时间、置信度等因素进行消解。
- 分发:按照 Workspace 和权限模型,将知识分发给不同的 Agent。
实测数据
在 LOCOMO 基准测试中,我们跑了一些数据,供参考:
- 准确率我们测下来在 79% 左右,LightRAG 方案大约在 65%,有 14 个百分点的差距
- Token 成本大概是 LightRAG 的 1/3——日常使用中,成本优势会随着使用量的增加而放大
- 检索延迟 1.64 秒,在 Coding Agent 场景下可以接受
- 在 FinanceBench、SyllabusQA、Qasper、ClapNQ 四个数据集上跑了一遍,没有出现明显的短板
不过需要说明,LOCOMO 是一个通用基准,和真实编码场景还是有差距的。我们在实际项目中的感受是:对于规范明确、知识密度高的项目,效果确实好;对于比较随意的个人项目,提升没那么显著。不确定这是否具有普遍性。
另外有一个数据比较意外:Mem0 兼容迁移的场景下,在保持协议不变的前提下仅切换 endpoint,准确率从 20% 提升到 78%。底层记忆管理的质量差异能带来这么大的效果差距,说明这个环节确实被很多人忽视了。
接入与使用
接入比较简单:
curl -fsSL 'https://context-database-client.oss-cn-hangzhou.aliyuncs.com/install.sh' | bash -s -- --agent <agent> --api-key <api-key>
支持主流的 Coding Agent:Qoder、Claude Code、Codex、OpenClaw、OpenCode、Hermes、QoderWork。
不过目前它是基于阿里云 RDS MySQL 的服务,对数据库引擎有依赖。如果你的场景对数据驻留或私有化部署有要求,需要确认一下是否满足。
从"工具"到"队友"
回顾 Agent 记忆技术的演进:
| 阶段 | 方案 | 类比 | 核心能力 | 核心局限 |
| 第一阶段 | 上下文窗口 | 工作记忆 | 即时处理 | 容量有限,用完即弃 |
| 第二阶段 | RAG | 图书馆 | 知识检索 | 无状态,无时间维度 |
| 第三阶段 | Agent Memory | 笔记本 | 自动记录 | 准确率低,缺乏治理 |
| 第四阶段 | 上下文数据库 | 知识管理系统 | 系统化管理 | 尚在早期 |
每一步演进,Agent 的记忆能力都在向人类靠拢。从"什么都记不住"到"能查资料",从"能查资料"到"能记笔记",从"能记笔记"到"有系统的知识管理"。
上下文数据库代表的是当前最新的方向。它试图解决的不是"Agent 能不能记住"的问题,而是"Agent 能不能像人类专家一样积累和管理知识"的问题。当然,这个方向还在很早期,数据量特别大的场景、跨语言跨领域的能力,都还没有充分验证。
但方向本身我觉得是对的。当一个 Agent 真正"记住"了你的项目——它的架构决策、技术栈、业务约束、历史踩坑记录——它就不再是一个通用的代码生成工具,而是一个真正理解你项目的队友。
参考链接