从零开始搭建知识库 · EP07 · 范式篇(二)隐式缓存 vs 显式缓存
两种缓存在能力栈里的位置
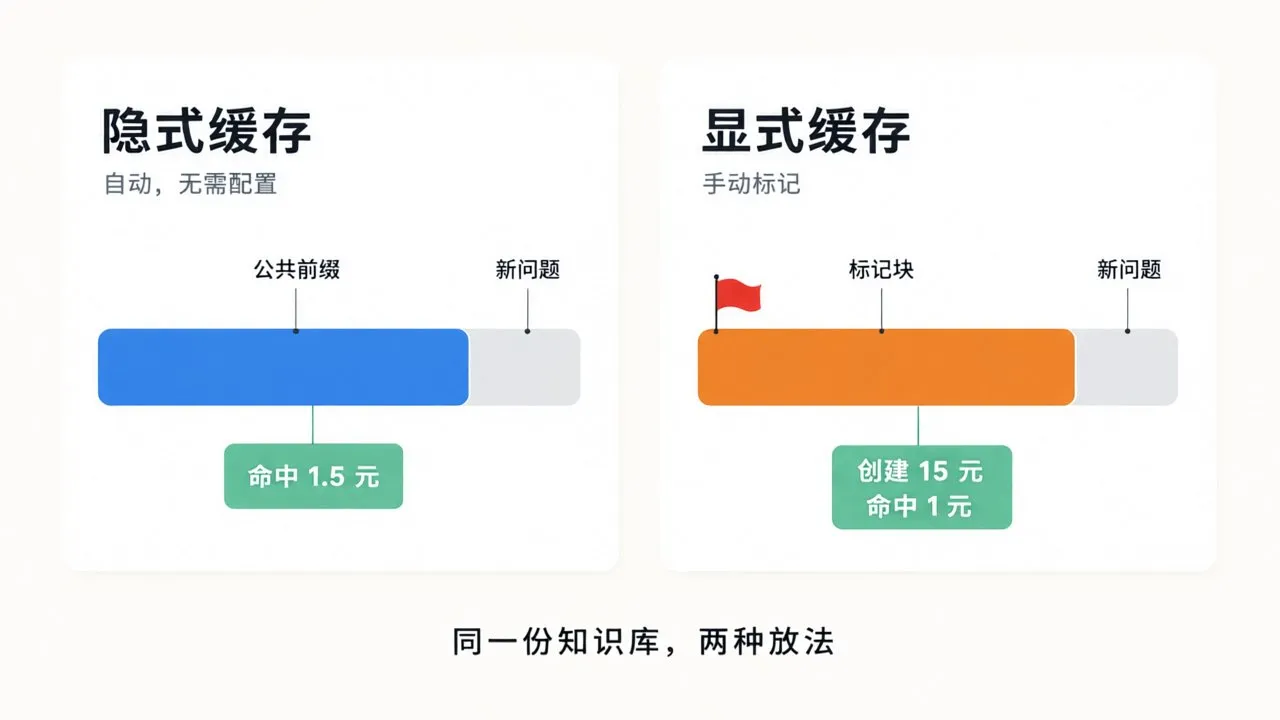
「从零开始搭建知识库」系列第七期,范式篇第二期。EP06 落地的结论是:编译范式命中前缀缓存后每问省一半以上,约 6 问回本,但这笔账完全押在缓存命中上。本期把百炼的两条缓存通路在同一份资产上对跑:隐式缓存(服务端自动按公共前缀命中,无需配置)与显式缓存(调用方在 messages 里挂 cache_control 标记,主动创建)。
资产沿用 EP06:编译产物(7,929 token 的 prompt 前缀)、qwen3.8-max、同一句 system、同样四道问法。11 次付费调用,合计约 0.93 元,全部 usage 留痕在系列实验记录里。
通道分工表:本期新增两行
| 需求 | 正确通道 | 说明 |
|---|---|---|
| 知识库建库 | 百炼控制台(网页) | 含排序模型与 rewrite 开关 |
| 知识库检索(服务化) | bl knowledge search --query <text> --agent-id <id> |
走检索服务 |
| 智能体应用调用 | bl app call --app-id <id> --prompt <text> |
Agent 自主检索 |
| 整库编译 / 全上下文提问 | bl text chat --messages-file <file> |
EP06 已落:语料直接进上下文 |
| 显式缓存标记 | --messages-file + content 数组挂 cache_control |
本期实测:CLI 无专门缓存命令,结构化 messages 透传,usage 出现 ephemeral_5m_input_tokens 即创建成功 |
| 缓存命中与单价查询 | bl model list --model qwen3.8-max |
本期实测:No Auth,四档单价与计费类型名(含 TTL 5m)直接可读 |
CLI 没有专门的缓存命令(reference 文档 grep「cache」「缓存」零命中),但显式缓存靠的是 messages 里的结构标记,--messages-file 传什么结构发什么结构。显式组的写法:
[
 {
   "role": "system", "content": "你是暖屋家居的客服助手。"},
 {
   "role": "user", "content": [
   {
   "type": "text", "text": "(整份编译产物)\n\n---\n以上是公司知识库。",
    "cache_control": {
   "type": "ephemeral"}},
   {
   "type": "text", "text": "用户问题:报销发票怎么提交"}
 ]}
]
透传成功的判定标准:显式组 usage 必须出现 A 组从没见过的新字段。B0 实测返回 ephemeral_5m_input_tokens: 7923、cache_creation_input_tokens: 7923、cache_type: "ephemeral" 三个新字段,与价目表的计费类型名 input_token_cache_creation_5m 对上,7,923 个 token 走了显式创建。
四档单价:TTL 写在计费类型名里
bl model list --model qwen3.8-max 不需要鉴权,2026-09-04 现场拉价:
| 档位 | 单价 | 相对输入价 |
|---|---|---|
| 输入 | 12 元 / M | 100% |
| 输出 | 36 元 / M | — |
| 隐式命中 | 1.5 元 / M | 12.5% |
| 显式创建 | 15 元 / M | 125% |
| 显式命中 | 1 元 / M | 8.33% |
显式创建的计费类型名是 input_token_cache_creation_5m,TTL 5 分钟写在字段名里,与官方文档口径一致,本期 B3 实测也验证了这个时长。
六个实测发现
一、隐式缓存的存活边界。A 组四连测:隔两天缓存全没(7,929 token 全价结算,0.1075 元);20 秒内连问命中 7,168(0.0345 元);9 分 32 秒后再命中(0.0285 元);13 分 59 秒后再命中(0.0419 元),距首次命中累计 23 分半。隐式存活至少 14 分钟起步,两天必然失效,中间不透明。
二、挂标记即出隐式局。B0 距 A4 仅 31 秒,A4 刚隐式命中过,B0 的 cached_tokens 是 0。显式与隐式在同一次调用上互斥。
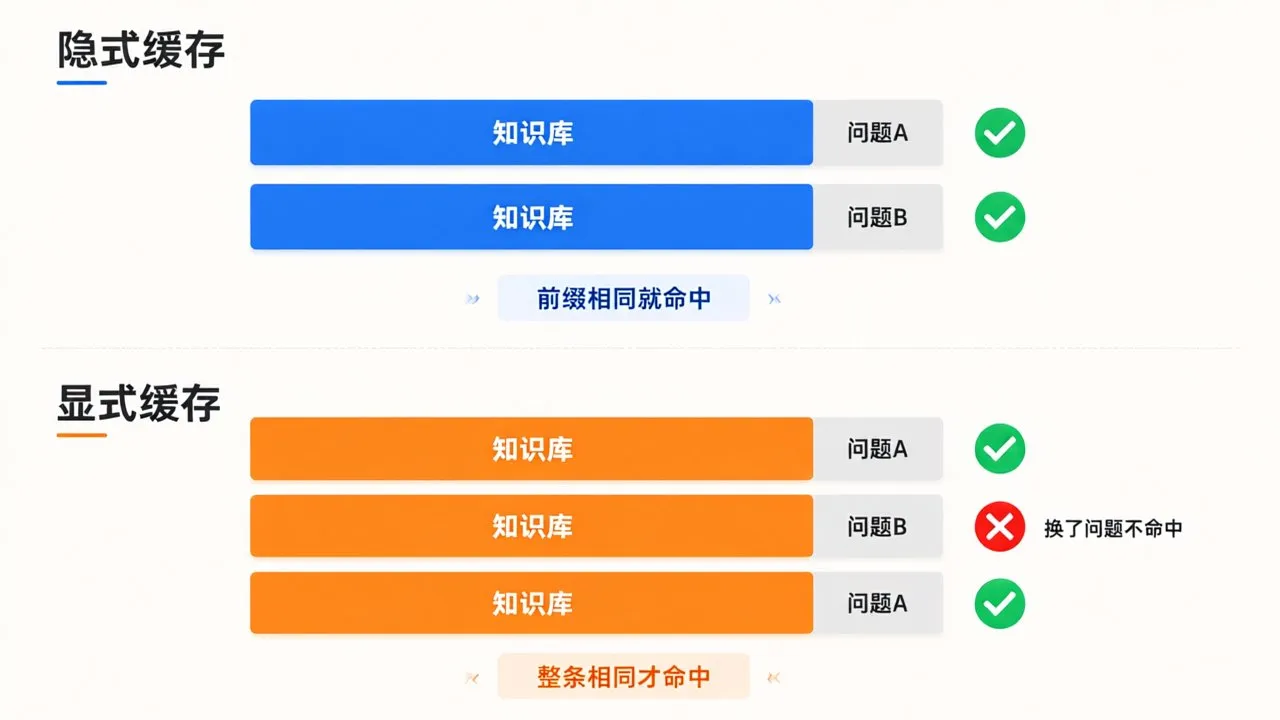
三、显式命中判定是完整请求一致,不是前缀。B0 创建后 12 秒换问题(B1)、15 秒换问题(B2),都是全额重新创建。9 秒对照实验:与 B0 逐字节相同但等 8 分 13 秒(超 TTL)重新创建(B3);与 B3 逐字节相同隔 9 秒重发命中(B4,0.0202 元,全期最便宜);与 B4 只差问题文本隔 9 秒发不命中(B5)。
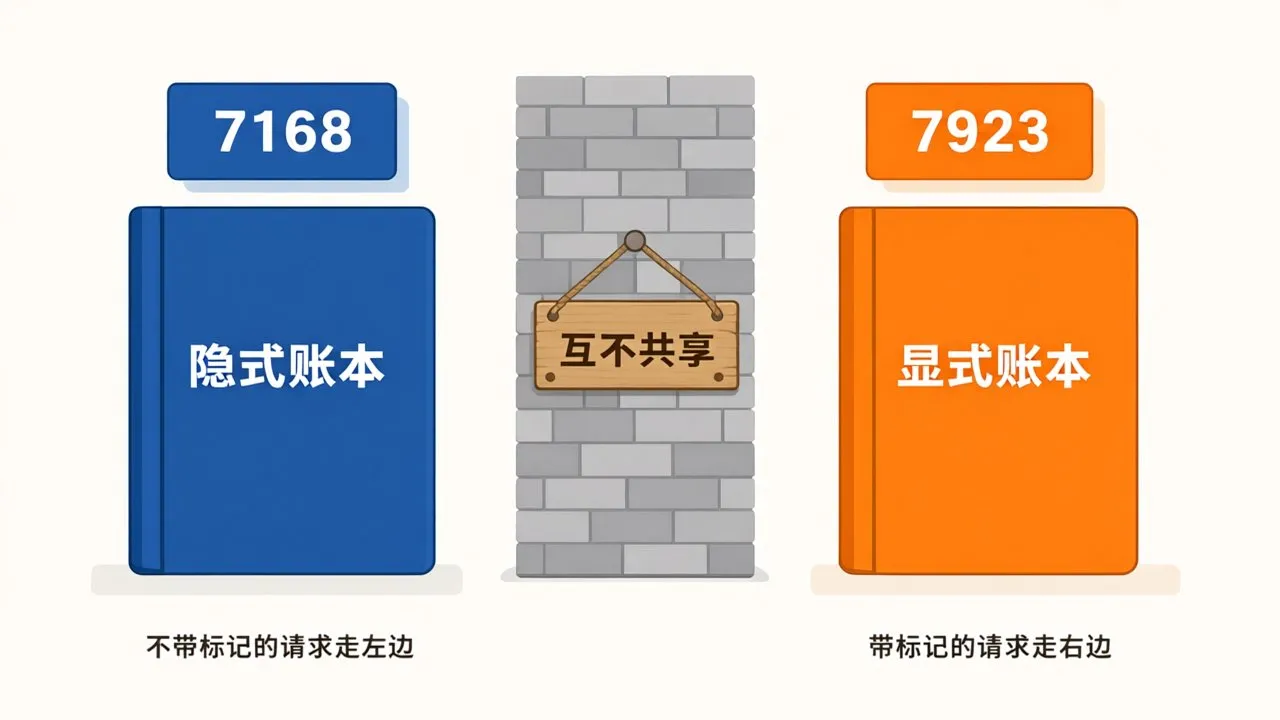
四、两条通道完全隔离。D1 在两次显式创建后 9 秒用隐式拼法提问,命中量 7,168(隐式口径),不是显式刚创建的 7,923。官方公告「隐式缓存与显式缓存对于同一次模型调用不共享」的数值版。显式实验跑完,隐式缓存毫发无伤。
五、隐式按 1,024 token 对齐。四次隐式命中量恒为 7,168 = 7 × 1,024,而 prompt 总长在 7,929 到 7,942 之间浮动。公共前缀里不满一块的尾部不入缓存,每次约 767 个 token 按全价结算。隐式等效输入单价 2.515 元每百万(标准价的 21%),名义 12.5% 只对入缓存的 token 成立。显式无此截断,创建量与命中量都是 7,923,覆盖 99.9%。
六、显式的回本边界。四种稳态:全价冷启动 12.00 元 / M(100%)、隐式稳态 2.515 元 / M(21.0%)、显式创建 15.00 元 / M(125%)、显式命中 1.008 元 / M(8.4%)。
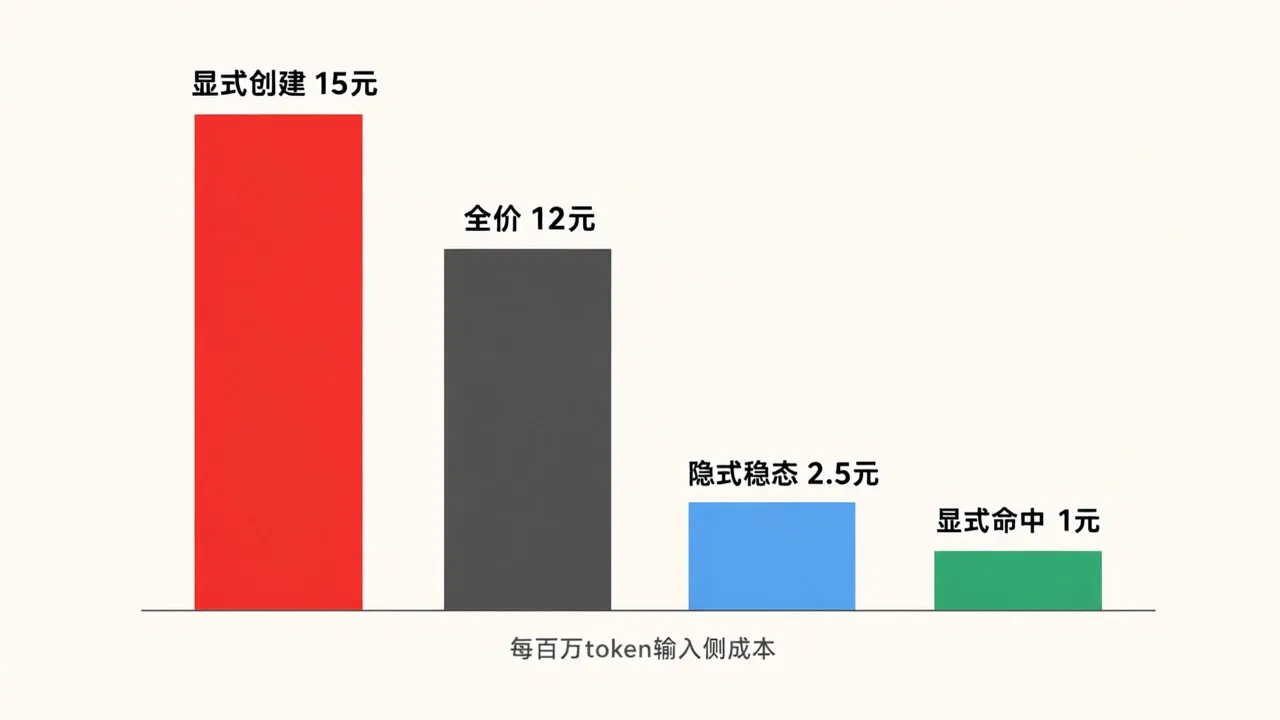
知识库问答形态(一份前缀连问 5 个不同问题):隐式合计 0.1750 元,显式合计 0.5946 元,3.4 倍;单问稳态 5.96 倍。显式的甜区是同一份 messages 原样重复:3 次打平,5 次省 13.6%,10 次省 30.4%,极限省 60%。TTL 5 分钟内没有下一次命中,创建溢价全蒸发。
选型判据
| 负载形态 | 怎么放 |
|---|---|
| 客服问答:前缀固定,问题千变万化 | 隐式,什么都不用配 |
| 同题复现:评测集重跑、批量重试、多 Agent 并行同 prompt | 显式标记,第 3 次回本 |
| 低频零散:一天问不了几次 | 哪种都救不了,考虑回检索范式 |
| 用隐式时想多命中 | 控制节奏,14 分钟内跟问有效 |
结论落在生态里就是一句话:百炼的显式缓存当前定位是「相同请求的重复执行加速」,不是「固定前缀的变化请求加速」。知识库问答这个最普遍的场景,隐式仍然是默认答案。
下期预告
范式篇还剩权限边界没碰:同一份库切两个权限视图,编译产物、检索 metadata 过滤、Agent 提示词三种放法各能守住什么。实验资产继续沿用系列同库。
本文实测基于百炼 CLI(bl),11 次调用的完整 usage、思考链与产物留痕于项目仓库。命令格式可能随版本更新调整,以官方文档为准。API Key 在控制台密钥管理页创建(新用户有免费额度)。