
Qwen3.7‑Max作为Qwen3.7产品线当中定位最高的生产级旗舰模型,专门面向智能体自主执行场景打造,主打长链路任务、复杂逻辑推理、工程级代码开发、百万Token长上下文处理,经过大规模线上业务验证,稳定性表现突出,大量Agent项目、企业复杂业务系统将该模型作为核心推理基座。不同于预览版本,Qwen3.7‑Max已经具备成熟的生产可用性,适合需要长时间多步骤自主完成任务的业务,例如Hermes Agent、OpenClaw等智能体项目,也可以用于合同解析、技术方案评审、大型代码仓库分析等专业工作。很多开发者在接入该模型时,容易混淆思考模式计费、上下文缓存规则、模型能力边界,出现成本飙升、调用报错、工具调用失效等各类问题。本文完整讲解Qwen3.7‑Max核心功能、完整计费规则、横向选型对比、完整接入实操,同时整理生产环境高频出现的常见问题FAQ,附带可直接复制运行的Python、curl代码命令,帮助开发者快速完成原型调试,平稳上线生产业务。文中所有价格为平台公开基准定价,实际消耗以控制台账单为准,订阅套餐、夜间优惠会改变实际消费成本。
一、Qwen3.7‑Max核心功能与能力详解
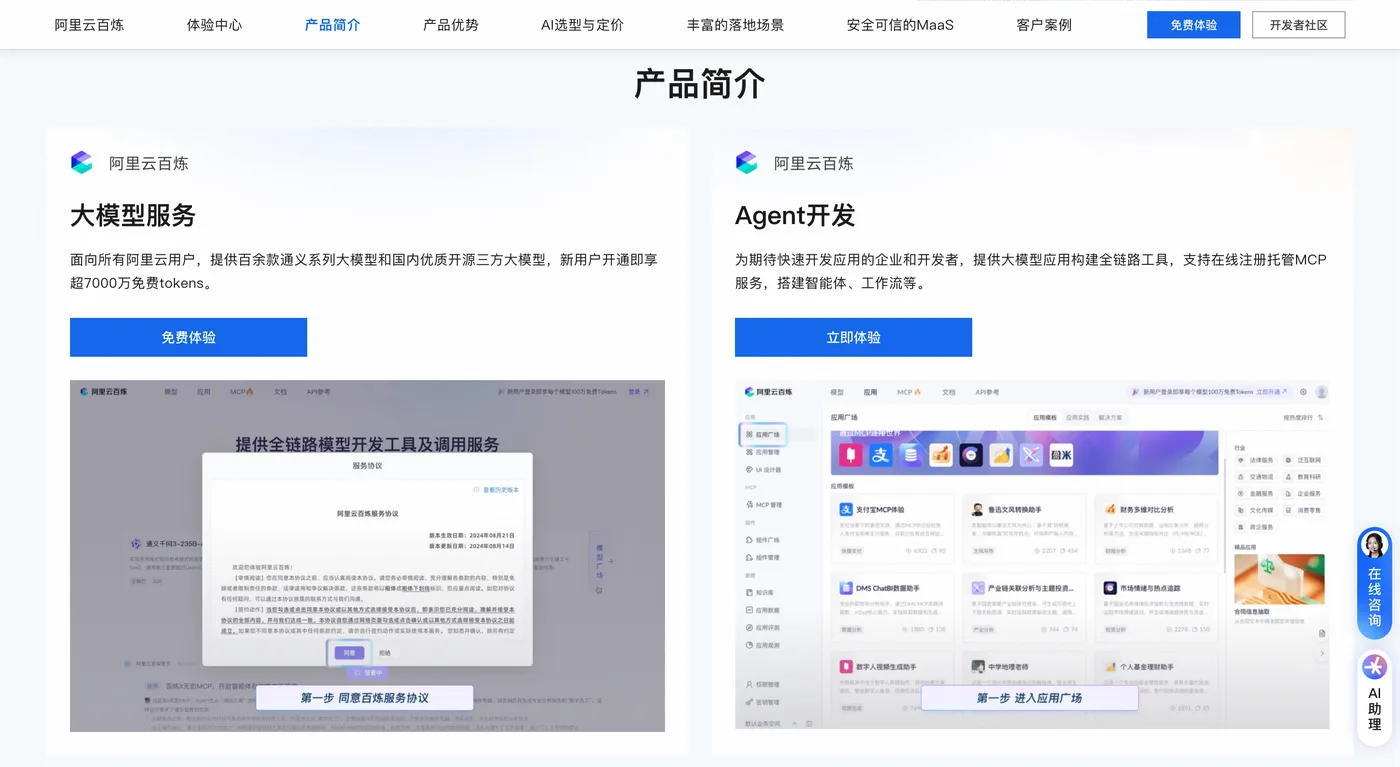
Qwen3.7‑Max为纯文本输入输出模型,不支持图片、视频多模态输入,如果业务需要视觉理解能力,需要切换至同系列其他模型。模型上下文窗口达到100万Token,最大输入991808 Token,最大输出131072 Token,开启深度思考模式之后依旧维持接近百万级输入上限,能够承载整本技术手册、多份合同文档、完整项目代码、上千轮智能体历史会话,长链路任务中信息留存能力优秀。详情👉访问阿里云百炼大模型服务平台页面 了解。
1、深度思考推理模式
模型原生支持enable_thinking深度思考开关,开启之后模型内部会生成完整思维链,完成问题拆解、多步推导、自我校验之后输出最终业务结果,思考过程内容可以通过reasoning_content字段读取,开发者还可以通过thinking_budget参数限定思考阶段最大Token数量,平衡推理质量与调用开销。在数学运算、复杂业务推演、故障排查、多工具规划类任务,开启思考模式可以显著提升任务成功率,简单问答场景可以关闭思考模式,减少不必要的Token消耗,降低延迟与成本。
2、强大Agent智能体与Function Calling工具调用能力
该模型的核心设计目标就是长周期自主智能体执行,Function Calling函数调用经过专项优化,能够自主解析任务目标,选择对应工具,解析工具返回结果,发现执行错误之后主动调整策略,支持数百轮甚至上千轮连续工具交互,适配各类本地智能体框架。同时内置网页搜索、网页内容提取、代码解释器内置工具,请求参数中配置tools数组即可直接调用,不需要额外封装工具逻辑,非常适合自动化调研、数据分析、代码运行调试场景。
3、工程级代码编程能力
Qwen3.7‑Max在代码任务上表现突出,不局限生成简单代码片段,支持多文件项目搭建、依赖冲突定位、Bug深度排查、架构方案设计、单元测试编写、代码评审。可以完成从需求拆解、编码、测试、迭代修改完整工作流,适合AI编程工作台、代码仓库分析、后端项目原型开发等场景。面对大型项目,百万上下文窗口可以加载大量源码文件,保证修改代码时全局逻辑一致性,减少局部修改带来的漏洞。
4、结构化输出与前缀续写能力
原生支持强制JSON结构化输出,业务系统不需要编写复杂字符串清洗逻辑,直接解析返回JSON对象,广泛用于数据抽取、表单解析、业务接口输出场景。同时支持Prefix Completion前缀补全,支持接续已有文本继续续写,适合文档续写、代码补全、日志文本分析等业务场景。
5、上下文缓存能力
支持上下文缓存机制,分为隐式会话缓存与显式缓存两种模式。对于重复输入相同长文档、多轮持续对话的业务,开启缓存之后公共输入部分命中缓存,输入Token计费大幅下降,同时降低接口响应耗时,非常适合知识库问答、长会话智能体业务。开发者可以在请求头配置缓存开关,管理会话缓存生命周期,优化大规模调用成本。
6、能力边界说明
Qwen3.7‑Max仅支持云端API调用,不提供本地私有化权重部署;不支持用户侧微调、不支持批量异步推理任务;输入仅支持文本,无多模态视觉能力;接口存在RPM、TPM限流,高并发大规模场景需要评估调用配额,不适合直接拿来做高频简单客服对话,建议把该模型用于复杂规划、决策环节,简单任务交给轻量模型处理。
二、完整计费规则解析
Qwen3.7‑Max默认采用按量按Token计费模式,输入Token、输出Token分开计价,思考模式产生的推理Token同样计入计费统计,调用失败不会产生扣费消耗,同时支持搭配Token Plan订阅套餐抵扣用量,夜间时段还可以享受额外优惠折扣。详情👉访问阿里云百炼大模型服务平台页面 了解。
1、华北2北京地域基准按量价格:输入12元每百万Token,输出36元每百万Token;隐式缓存命中输入2.4元每百万Token;显式缓存创建15元每百万Token,显式缓存读取1.2元每百万Token,缓存机制对于长会话业务能够显著降低账单开销。
2、思考模式计费:开启enable_thinking之后,reasoning_content思考过程产生的Token同样计入输出计费,不要无限制放大thinking_budget数值,根据业务任务难度合理设置上限,避免成本不受控。
3、订阅套餐抵扣:该模型支持Token Plan订阅套餐,使用sk‑sp开头专属API‑Key,消耗套餐Credits额度,不再执行按量单价,适合智能体持续开发调试场景。
4、新人免费额度:百炼新人免费Token额度可以调用该模型,但是旗舰模型单位消耗高,额度会快速耗尽,强烈建议开启免费额度用完即停开关,额度耗尽直接阻断调用,避免自动转为按量计费产生意外账单。
5、用量统计存在数分钟延迟,不能以页面实时用量作为业务判断标准,正式业务务必配置账单告警,设置消费阈值提醒。
6、夜间优惠:每日22点至次日8点,该模型可以享受按量计费折扣,适合非实时离线任务、后台批量调试任务,降低开发成本。
三、选型指南:什么时候选择Qwen3.7‑Max,什么时候选择其他模型
Qwen3.7‑Max属于生产级旗舰模型,成本高于Plus、Flash版本,并不是全部业务都适合,企业业务建议采用分层选型策略,兼顾业务效果与调用成本。
优先选用Qwen3.7‑Max的业务场景:
1、长周期智能体Agent任务,需要多轮工具调用、自主纠错迭代的自动化工作流;
2、工程级复杂代码任务,多文件项目重构、疑难Bug定位、软件架构方案设计;
3、百万级长文本深度分析,大量合同文档、技术资料、完整代码仓库解析;
4、复杂逻辑推理,业务方案推演、技术评审、复杂问题深度拆解;
5、对模型版本稳定性有高要求的线上核心业务,需要经过大量业务验证的成熟基座。
不建议优先选用Qwen3.7‑Max场景:
1、普通问答、简单文案生成、常规客服对话,优先Qwen3.7‑Plus;
2、大规模高频并发调用、批量简单处理任务,优先Qwen3.7‑Flash;
3、业务需要图片、截图、图表理解等多模态输入,该模型不支持视觉,切换其他模型。
同系列横向选型对比:
- Qwen3.7‑Max:成熟生产旗舰,强Agent、强推理、百万上下文,纯文本,稳定性高;
- Qwen3.8‑Max:新一代旗舰,增加原生多模态,推理能力进一步提升,适合做业务评估测试;
- Qwen3.7‑Plus:均衡主力,兼顾效果与成本,支持多模态,绝大多数企业业务首选;
- Qwen3.7‑Flash:高吞吐低成本,高频轻量任务,大规模调用场景。
生产环境最佳实践:采用分层架构,复杂任务、智能体规划决策交给Qwen3.7‑Max,普通业务交给Plus,高频执行任务交给Flash,实现效果、稳定性、成本三者平衡。
四、完整实操接入教程
步骤1:开通百炼服务,获取API‑Key
登录控制台,地域切换华北2北京,开通百炼模型服务,完成账号实名认证,进入API‑Key管理页面创建密钥,密钥以sk‑开头,生成只完整展示一次。生产环境禁止硬编码密钥,使用系统环境变量保存密钥,开启免费额度用完即停开关,配置账单告警阈值。
步骤2:安装依赖库
pip install dashscope
pip install openai
配置环境变量,Linux/macOS终端:
export DASHSCOPE_API_KEY="sk-替换为你的APIKEY"
Windows PowerShell:
$env:DASHSCOPE_API_KEY="sk-替换为你的APIKEY"
示例1:DashScope SDK基础调用,开启深度思考模式
import os
import dashscope
from dashscope import Generation

dashscope.api_key = os.getenv("DASHSCOPE_API_KEY")

resp = Generation.call(
    model="qwen3.7-max",
    messages=[
        {
   "role":"system","content":"你是资深软件工程师,擅长项目架构设计、代码编写与问题排查。"},
        {
   "role":"user","content":"设计一个轻量异步任务队列系统,输出架构说明、模块划分以及Python实现代码"}
    ],
    result_format="message",
    extra_body={

        "enable_thinking": True,
        "thinking_budget": 6000
    }
)

if resp.status_code == 200:
    print("====内部思考过程====")
    print(resp.output.choices[0].message.reasoning_content)
    print("====最终输出结果====")
    print(resp.output.choices[0].message.content)
    print(f"输入Token:{resp.usage.input_tokens},输出Token:{resp.usage.output_tokens}")
else:
    print(f"调用失败,错误码:{resp.code},错误信息:{resp.message}")
示例2:OpenAI兼容接口流式输出
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
)

stream = client.chat.completions.create(
    model="qwen3.7-max",
    messages=[{
   "role":"user","content":"分析微服务架构落地过程中常见的坑,给出规避方案"}],
    extra_body={
   "enable_thinking":True,"thinking_budget":5000},
    stream=True
)

for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content,end="",flush=True)
示例3:curl HTTP调用示例,开启会话缓存
curl https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions \
-H "Authorization: Bearer $DASHSCOPE_API_KEY" \
-H "Content-Type:application/json" \
-H "x-dashscope-session-cache: enable" \
-d '{
"model":"qwen3.7-max",
"messages":[{"role":"user","content":"简述百万上下文模型在智能体开发当中的实际价值"}],
"extra_body":{"enable_thinking":true,"thinking_budget":3000}
}'
示例4:调用内置网页搜索工具
curl https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions \
-H "Authorization: Bearer $DASHSCOPE_API_KEY" \
-H "Content-Type:application/json" \
-d '{
"model":"qwen3.7-max",
"messages":[{"role":"user","content":"调研大模型Agent主流开源框架,整理对比清单"}],
"tools":[{"type":"web_search"}],
"extra_body":{"enable_thinking":true}
}'
本地智能体工具接入方法
Hermes Agent、OpenClaw等本地Agent框架接入Qwen3.7‑Max,兼容模式base_url填写https://dashscope.aliyuncs.com/compatible-mode/v1,填入百炼sk‑开头API‑Key,模型ID填写qwen3.7‑max,修改配置之后完全退出工具进程重新加载。先用简单对话测试连通性,确认返回正常之后,再执行复杂长周期任务,避免大量消耗Token才发现配置错误。
五、常见问题FAQ
FAQ1:调用返回model not found
核对模型ID为qwen3.7‑max,区分大小写;确认控制台地域切换为华北2北京;确认当前业务空间已经开通该模型访问权限。
FAQ2:开启思考模式Token消耗暴涨
thinking_budget不要设置过大,思考过程同样参与计费,简单任务关闭enable_thinking,只在复杂推理任务开启思考模式。
FAQ3:长会话调用成本居高不下
开启会话缓存请求头,公共文档、公共历史前缀命中缓存会降低输入成本;定期裁剪messages历史列表,无用的会话消息不要持续带入请求。
FAQ4:传入图片输入,返回调用报错
Qwen3.7‑Max为纯文本模型,不支持图片、视频多模态输入,如果业务需要视觉理解,更换支持多模态的模型。
FAQ5:Agent工具调用频繁出现参数错误、选错工具
开启enable_thinking深度思考模式;优化system提示词,明确工具使用规则;精简messages列表,剔除无关历史信息,减少上下文噪声。
FAQ6:接口返回429限流报错
Qwen3.7‑Max存在RPM、TPM调用配额,短时间大量并发请求会触发限流,降低并发数量,增加请求间隔;业务规模上涨之后,可以提升业务空间调用配额。
FAQ7:新人免费额度很快耗尽
该模型属于旗舰级别,单位Token消耗高,免费额度适合原型验证,正式业务切换按量付费或者Token Plan套餐,务必开启用完即停防护开关。
FAQ8:思考模式拿不到reasoning_content字段
确认extra_body参数正确传入enable_thinking为true;使用兼容接口要确认SDK版本足够新;部分老版本快照模型不支持返回思考过程字段。
FAQ9:缓存功能不生效
确认请求头x‑dashscope‑session‑cache: enable正确添加;缓存只对重复公共前缀生效,如果每次请求输入全部变化,不会触发缓存命中。
六、生产环境最佳实践
第一,开发阶段开启账单告警,持续监控Token消耗,做好成本预估,不要直接把Qwen3.7‑Max用于全部业务链路,采用分层模型策略,复杂决策交给Max,普通业务下放Plus、Flash。
第二,思考模式按需开启,简单问答任务关闭思考模式,减少不必要开销。
第三,长会话业务优先开启上下文缓存,降低输入Token成本,定期清理过期缓存,避免缓存占用资源。
第四,严格管控API‑Key,禁止明文提交代码仓库,密钥泄露立刻在控制台删除旧密钥,重新生成。
第五,上线前做压测,确认RPM、TPM调用配额能够满足业务并发需求;夜间非实时任务可以利用夜间优惠时段,降低调试成本。
第六,不要把该模型用于多模态场景,图片视频解析业务选用其他支持视觉的模型,避免调用失败。
七、总结
Qwen3.7‑Max是面向智能体时代的成熟生产级旗舰模型,拥有百万级上下文窗口、深度思考推理、强大工具调用与工程代码能力,经过大量线上业务验证,稳定性表现优异,非常适合长周期Agent开发、大型代码分析、复杂文档解析等高难度业务场景,但是该模型仅支持文本输入,不具备多模态视觉能力,调用成本高于同系列Plus与Flash版本。
业务落地时要做好选型判断,不要全部业务统一使用旗舰模型,通过分层调用策略平衡效果、稳定性与成本。接入阶段熟练掌握思考模式参数、上下文缓存、内置工具调用,使用上面提供的SDK与curl示例完成调试,同时做好密钥安全、用量告警、免费额度防护,规避意外扣费与调用故障。原型验证完成之后,根据业务规模选择按量计费或者Token Plan订阅套餐,保障业务长期稳定运行。
