
随着大模型应用向Agent智能体方向演进,单纯追求参数规模已经不再是选型唯一标准,模态支持、推理精度、响应延迟、调用成本成为业务落地必须综合考量的指标。Qwen3.7系列包含Max、Plus、Flash三款核心模型,三款模型均具备百万级超长上下文窗口,也都支持长时间自治Agent执行,但在模态能力、推理架构、最大输出长度、响应速度、计费单价上存在明显鸿沟。很多开发者在项目开发中盲目直接选用最高版本,带来不必要的高额开销;或者选用轻量模型处理复杂任务,输出质量不达标。本文从核心定位、基础参数、多维度能力实测、计费性价比、业务场景适配,结合可直接运行的API调用代码、生产分层调度示例,完整解析三款模型差异,帮助个人开发者与企业研发团队按需选型,平衡业务效果与调用成本。
一、三大版本核心定位与基础参数
Qwen3.7‑Max:纯文本旗舰推理模型
Max作为系列定位最高的纯文本旗舰,采用密集推理架构,推理阶段激活大量参数。核心优势集中在超长文本连贯性、复杂逻辑深度推演、大型代码工程自主处理。该版本只支持纯文本输入输出,不具备图像、视频解析能力,单轮最大输出可达65536Tokens。在纯文本任务推理精度表现最优,但为了追求推理深度牺牲部分响应速度,整体耗时更长,适合对文本结果精度要求严苛的重度专业业务。详情👉访问阿里云百炼大模型服务平台页面 了解。
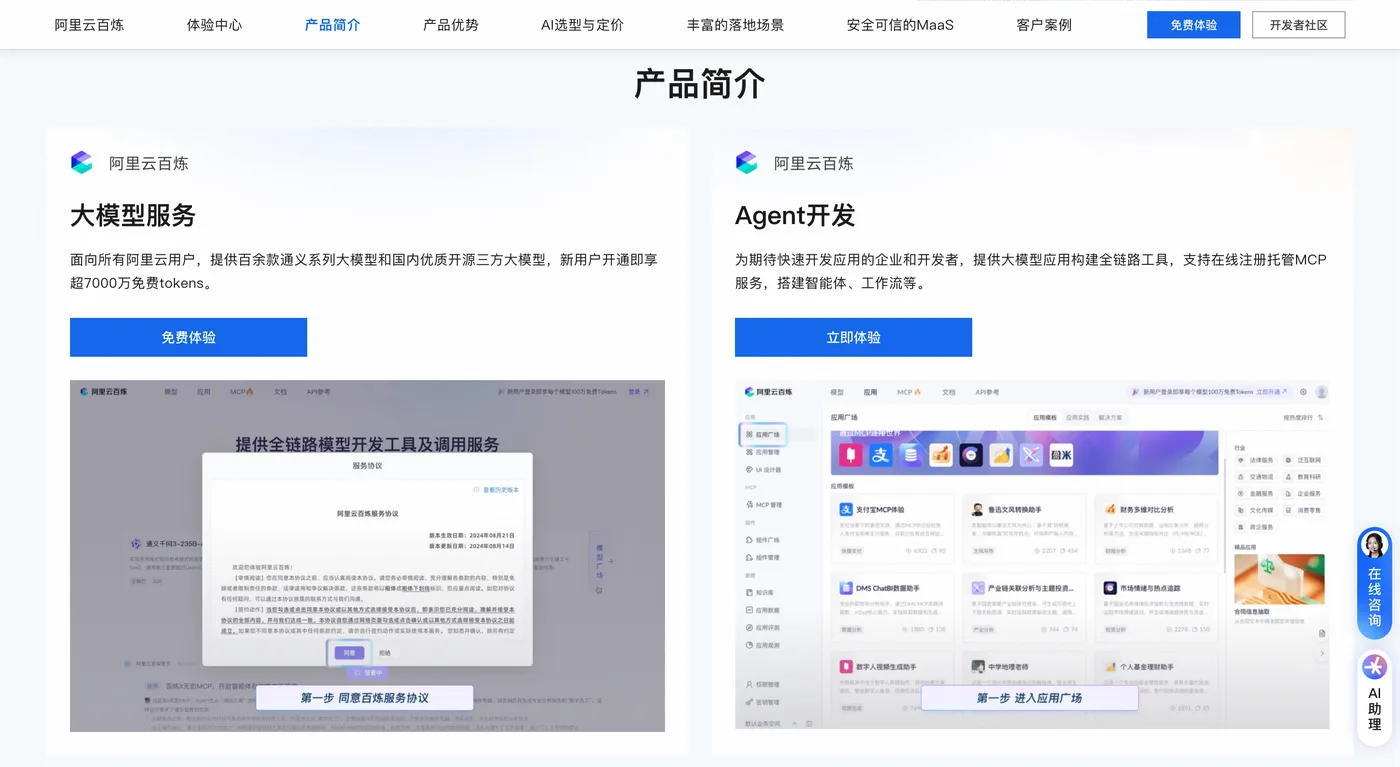
Qwen3.7‑Plus:多模态全能均衡模型
Plus是整个系列综合性价比标杆,也是三款里面唯一原生支持图像、视频帧解析的多模态模型。推理架构兼顾性能与执行效率,单轮最大输出32768Tokens,推理速度约为Max的三倍。常规文本推理能力和Max差距很小,额外拥有图文联动、截图转代码等独有能力,绝大多数商用通用业务场景都可以使用该版本承载。
Qwen3.7‑Flash:轻量极速文本模型
Flash主打低延迟、高并发轻量化交互,精简推理架构,仅支持纯文本,无多模态能力,单轮最大输出16384Tokens。三款之中响应速度最快,调用成本最低,适合简短问答、快速摘要、批量短文案生成这类轻量化任务;面对多层逻辑推导、超长专业文档分析,很容易出现逻辑断层,不适合复杂任务。
公共基础能力
三款模型全部搭载百万Token超长上下文窗口,都支持最长35小时连续自治Agent执行,可以承载长周期自动化任务;核心差距集中在模态识别、推理精度、单轮输出上限、响应速度与计费价格。
二、三大版本能力实测横向对比
2.1 文本逻辑与编程推理能力
Max在高难度专业文本任务表现最佳,在专业代码评测基准得分领先。处理百万行规模代码重构、金融财报深度推演、法律条文多层解读、高难度数学演算任务,逻辑连贯性、细节准确度优于另外两款。开启深度思考模式,长文档分段解读、多轮长对话过程中,很少出现上下文遗忘。详情👉访问阿里云百炼大模型服务平台页面 了解。
Plus常规文本推理能力接近Max,数学竞赛类题目正确率基本持平,中小型项目编码、普通Bug修复都可以稳定完成;额外具备视觉编程独有能力,可以读取代码截图、UI设计稿直接生成开发逻辑,该能力是Max、Flash不具备。
Flash仅适合简单文本生成、短句问答、内容精简总结。处理多层逻辑推导、长篇专业文档分析时容易逻辑断裂,不适合复杂开发与深度专业分析。
2.2 多模态处理能力
三者边界非常清晰:Max、Flash只能够处理纯文字,无法识别图片、视频素材;Plus是唯一原生支持多模态解析的版本,支持OCR图文识别、商品图片分析、程序报错截图调试、短视频帧内容拆解。电商素材处理、UI开发、图文混合内容创作的业务,只能选用Plus。
2.3 推理响应速度
纯文本场景响应速度排序:Flash > Plus > Max。Flash单次交互响应速度比Plus快一半以上,对比Max快两倍,适合客服机器人、弹窗即时问答这类高并发低延迟业务;Plus做到速度与综合能力的平衡,同时可以承载多模态任务;Max追求极致推理精度,大批量短任务场景直接使用会带来很高耗时与成本。
三、计费标准与性价比分层分析
Max输入、输出Token单价都远高于Plus,开启缓存复用后,单价依旧高出数倍;Plus调用成本约为Max的六分之一;Flash成本最低,输入输出缓存计价大约只有Plus的四分之一。三款全部支持输入缓存复用,重复的上下文缓存后,能够降低最高九成的Token消耗。详情👉访问阿里云百炼大模型服务平台页面 了解。
性价比分层总结
- Max:性能天花板,但是调用成本昂贵。只适合不计成本、追求极致文本推理的小众专业场景,通用业务长期使用开销巨大。
- Plus:综合性价比最优,只增加少量成本就补齐多模态能力,文本能力可以覆盖九成商用业务,个人、企业通用场景优先选择。
- Flash:极致低成本、极速响应。只适合没有复杂逻辑的轻量化高频交互,复杂任务应当切换更高等级模型。
生产环境成本优化核心方案:分层调度。简单问答、短句摘要自动调用Flash;常规文案、中小型开发、图文任务使用Plus;超长代码重构、法律金融深度分析才调用Max;所有业务尽量开启输入缓存,降低重复素材带来的Token消耗。
四、业务场景适配选型指南
✅ 适合Qwen3.7‑Max的业务
- 专业深度文本分析:金融财报推演、法律合同逐字审核、长篇学术论文梳理、精密数学推导;
- 大型软件工程任务:百万级存量代码重构、系统分库分表改造、多层复杂算法自主实现;
- 超长自治智能体:长时间连续文档整理、多步骤深度数据复盘、长篇叙事文稿创作;
限制条件:业务全程只有纯文本交互,不存在图片、视频素材处理需求。
✅ 适合Qwen3.7‑Plus的业务
- 多模态业务场景:电商图文素材处理、UI设计稿转代码、截图Bug调试、短视频脚本拆解;
- 通用商用开发:中小型项目开发、批量广告文案、智能客服、常规数据总结;
- 混合智能体工作流:图文结合自动化、多素材联动的内容生产、通用办公文档处理;
该版本覆盖绝大多数企业、个人日常AI需求,属于综合最优选择。
✅ 适合Qwen3.7‑Flash的业务
- 高并发实时交互:在线客服问答、弹窗即时咨询、关键词批量提取;
- 轻量化文本任务:标题生成、文章快速摘要、短句翻译、简单话术产出;
- 低成本批量处理:海量短文本过滤、基础标签分类,任务无复杂逻辑。
标准化选型判断思路
- 如果业务存在图片、截图、视频等视觉素材处理需求,直接选Plus,另外两款不支持多模态;
- 仅纯文本业务,同时涉及金融法律、百万行代码等超高精度复杂任务,选择Max;
- 只做简短问答、批量短文本,追求最低延迟、最低成本,选择Flash;
- 通用开发、内容创作、办公自动化、中小型Agent任务,优先选择Plus平衡成本与能力。
五、API开发实操代码示例
前置条件:在百炼平台获取
DASHSCOPE_API_KEY,设置环境变量,不要硬编码密钥到业务代码。兼容OpenAI接口协议。
Python基础调用三款模型示例
import os
from openai import OpenAI

# 初始化客户端
client = OpenAI(
    api_key=os.environ.get("DASHSCOPE_API_KEY"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
)

def call_llm(model_name: str, user_prompt: str, image_url=None):
    """统一封装调用函数,支持文本/多模态"""
    if image_url:
        messages = [{

            "role":"user",
            "content":[
                {
   "type":"image_url","image_url":{
   "url":image_url}},
                {
   "type":"text","text":user_prompt}
            ]
        }]
    else:
        messages = [
            {
   "role":"system","content":"你是专业业务助手,输出简洁准确"},
            {
   "role":"user","content":user_prompt}
        ]
    resp = client.chat.completions.create(
        model=model_name,
        messages=messages,
        max_tokens=4096
    )
    return resp.choices[0].message.content, resp.usage

# 调用Max纯文本
res_max,usage_max = call_llm("qwen3.7‑max","分析复杂财务合同风险点")
print("Qwen3.7‑Max输出:\n",res_max)
print("Token消耗:",usage_max)

# 调用Plus多模态,传入图片链接
res_plus,usage_plus = call_llm("qwen3.7‑plus","解析图表给出业务建议",
                               image_url="https://example.com/demo‑chart.png")
print("\nQwen3.7‑Plus输出:\n",res_plus)
print("Token消耗:",usage_plus)

# 调用Flash轻量文本
res_flash,usage_flash = call_llm("qwen3.7‑flash","对下面一段文字做简短摘要")
print("\nQwen3.7‑Flash输出:\n",res_flash)
print("Token消耗:",usage_flash)
cURL命令行调用示例
# 设置环境变量
export DASHSCOPE_API_KEY="你的APIKEY"

# 调用Qwen3.7‑Max
curl https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions \
‑H "Authorization: Bearer $DASHSCOPE_API_KEY" \
‑H "Content‑Type:application/json" \
‑d '{
"model":"qwen3.7‑max",
"messages":[{"role":"user","content":"梳理大型项目重构实施步骤"}]
}'

#调用Qwen3.7‑Plus多模态图文
curl https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions \
‑H "Authorization: Bearer $DASHSCOPE_API_KEY" \
‑H "Content‑Type:application/json" \
‑d '{
"model":"qwen3.7‑plus",
"messages":[{"role":"user","content":[
{"type":"image_url","image_url":{"url":"https://example.com/screenshot.png"}},
{"type":"text","text":"分析截图中的报错给出修复方案"}
]}]
}'

#调用Qwen3.7‑Flash轻量摘要
curl https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions \
‑H "Authorization: Bearer $DASHSCOPE_API_KEY" \
‑H "Content‑Type:application/json" \
‑d '{
"model":"qwen3.7‑flash",
"messages":[{"role":"user","content":"简短摘要下面这段长文本"}]
}'
生产简易分层路由代码(核心生产思路)
业务系统根据输入特征自动路由到对应模型,实现性能成本平衡。
```python
def model_router(user_input:str, has_image:bool=False):
"""简易模型路由逻辑"""#存在图片直接走Plus if has_image: return "qwen3.7‑plus" prompt_len = len(user_input) #超长复杂推理任务使用Max complex_keywords = ["合同审核","代码重构","数学推导","财报分析"] is_complex = any(k in user_input for k in complex_keywords) if prompt_len > 8000 or is_complex: return "qwen3.7‑max" #短文本简单任务使用Flash if prompt_len < 1500: return "qwen3.7‑flash" #其余通用业务走Plus return "qwen3.7‑plus"
测试路由
print(model_router("帮我做一份合同风险审核",has_image=False))
print(model_router("帮我总结这段话",has_image=False))
print(model_router("解析截图bug",has_image=True))
```
六、总结
Qwen3.7系列Max、Plus、Flash三款模型形成分层互补的完整产品矩阵。Max定位纯文本极致推理,面向重度专业复杂纯文本任务;Plus兼顾多模态能力与均衡性价比,绝大多数个人、企业通用业务场景都优先选择它;Flash面向轻量化高并发基础交互,主打低成本与极速响应。三款共享百万级上下文窗口、长时间自治Agent能力,差异集中在模态支持、推理精度、响应速度、调用成本。
选型的核心逻辑是按需匹配,不要盲目直接选用最高规格模型。简单任务交给轻量化模型承载;涉及图像输入直接选用Plus;只有超高精度纯文本专业场景启用Max。生产环境可以实现分层路由调度,结合上下文缓存机制,在满足业务效果的前提下控制Token消耗,实现性能与成本双向最优。开发者可以利用上面提供的API示例,快速完成原型验证,再将分层路由逻辑集成进正式业务系统,保障线上业务稳定可控。
