
2026年,通义千问正式推出Qwen3.8‑Flash多模态大模型,作为Qwen3.8系列面向高效推理打造的旗舰版本,该模型采用稀疏混合专家MoE架构,把长上下文处理、多模态理解、工具调用能力融为一体,原生支持最高100万Token上下文窗口,能够完整读取超长业务文档、完整代码仓库、长时间会议视频,一次性完成信息解析、摘要、推理与生成任务。
不同于传统稠密大模型,Qwen3.8‑Flash总参数量达到125B,搭配51B的N‑gram Embedding组件,推理过程中每个Token仅激活6B参数,用更低的计算开销实现媲美重量级模型的输出效果,训练成本仅为前代Qwen3.7‑Plus的1/9,从底层架构实现推理延迟与调用成本双重优化。模型服务已经部署在华北2(北京)、新加坡、美国弗吉尼亚、德国法兰克福、日本东京等多个地域节点,覆盖国内业务与全球出海业务需求。同时兼容OpenAI以及Anthropic两套主流接口协议,原有基于主流开发工具搭建的业务系统几乎不用重构核心逻辑,就可以完成模型迁移,为开发者、企业打造高并发AI应用提供全新选型。详情👉访问阿里云百炼大模型服务平台页面 了解。
一、核心技术架构,长上下文与多模态能力底座
Qwen3.8‑Flash采用Next全新架构,也是下一代Qwen4系列模型的技术原型,在注意力机制、残差链路、嵌入层、优化器四个维度完成系统性革新,解决长序列推理计算量大、信息丢失、训练收敛慢等行业痛点。
注意力模块使用GDN+QSA混合注意力架构,每四层网络中三层使用GDN(Gated DeltaNet),持续对历史上下文做信息压缩,沉淀关键信息;剩余一层搭载Qwen稀疏注意力QSA,以微块粒度检索关键内容,做到“压缩存储、精准检索”,百万Token长上下文场景下,配合上下文缓存能力,推理速度最高可提升8倍以上,大幅降低长对话、长文档解析的算力消耗。
残差链路引入Gated Residual门控残差机制,把传统Transformer单通道信息传递扩展为四条独立分支,依靠门控单元动态控制信息读写,缓解深层网络早期信息被稀释的问题,提升复杂推理任务训练稳定性。N‑gram Embedding作为辅助模块,以查表方式补充局部上下文特征,不需要参与每一步的Transformer计算,以极低资源开销扩充模型记忆能力。训练阶段搭配Muon优化器,针对正交精度、参数分工做精细化调优,进一步提升模型收敛效率与训练吞吐能力。
依托这套底层架构,Qwen3.8‑Flash拿到了非常亮眼的上下文指标:最大上下文窗口1000000 Token;标准模式最大输入991808 Token,开启深度思考模式最大输入983616 Token;无论是否开启思考,最大输出长度可达131072 Token;思维链最大支持262144 Token,足够支撑复杂多步骤推理任务。实际业务调用时,需要结合API参数预留一定安全余量,避免出现Token超限报错。
二、全维度能力矩阵,多模态输入与丰富高级功能
2.1 输入输出模态
输入侧同时支持文本、图像、视频三类模态,支持图文混合、视频帧序列混合输入;输出统一为结构化/非结构化文本,适配问答、文档摘要、代码生成、任务规划、智能体任务输出等绝大多数业务场景。图片输入存在明确数量限制:公网URL或者本地路径方式传入图片,上限2048张;Base64编码上传图片上限250张,所有图片转换后的Token总和不能超过模型最大输入阈值。详情👉访问阿里云百炼大模型服务平台页面 了解。
2.2 核心功能清单
- Function Calling函数调用:全部署地域基本支持,模型可以解析工具定义,生成工具调用参数,对接外部系统、数据库、第三方工具,搭建自动化智能工作流。
- 结构化输出:兼容JSON‑Schema约束,强制输出规范JSON格式,方便后端程序直接解析结果,省去复杂文本清洗逻辑。
- 联网搜索:北京、新加坡等区域开放联网搜索,获取实时外部信息,弥补模型知识截止时间带来的信息滞后问题;德国法兰克福、日本东京节点暂不提供联网搜索能力。
- 前缀续写:基于已有文本片段向后续写,适配代码补全、文档续写、脚本生成等场景。
- 上下文缓存:华北2、美国弗吉尼亚、德国、日本、新加坡均支持隐式上下文缓存,重复出现的对话前缀、文档内容命中缓存后,Token计费大幅下降,减少重复计算开销。
- 批量推理:仅华北2(北京)地域开放批量推理Batch能力,国际区域暂不支持批量任务提交。
- 模型调优:当前版本不支持微调,业务个性化需求建议通过提示词工程、结构化输出、Function Calling方式实现。
不同地域功能存在差异,开发前需要确认目标节点能力清单,避免线上功能缺失。华北2(北京)能力最全,图像、文本、视频输入全部支持,模型体验、函数调用、结构化输出、联网搜索、前缀续写、上下文缓存、批量推理全部可用;新加坡节点缺少批量推理;德国法兰克福、日本东京缺少批量推理以及联网搜索功能。
三、五大核心业务场景,充分释放模型价值
3.1 编程辅助与完整代码仓库解析
百万级上下文带来最直观的价值就是完整读取Git代码仓库,不需要拆分文件,模型一次性掌握项目全部源码结构,完成跨文件函数溯源、漏洞扫描、代码质量评估、自动修复。配合Function Calling,模型可以调用代码执行工具、单元测试工具,实现代码生成‑测试‑错误定位‑修复的完整闭环。开发者可以直接把整个项目文档、源码包送入模型,让它梳理项目架构、生成接口文档、定位隐藏bug,大幅提升研发效率。
3.2 Agent智能体协作场景
在自动化办公、工单处理、数据报表生成场景中,Qwen3.8‑Flash可以作为任务协调智能体,自主判断任务目标,调度多个外部工具、子能力模块协同完成复杂任务。面对多步骤业务,模型自主拆解子任务,调用工具获取数据,整理结果,输出最终业务结论。例如企业客服工单系统,模型读取完整工单历史,调用知识库、查询接口获取业务数据,自动生成处理方案;办公场景下读取多份文档、截图、表格,输出完整分析报告。
3.3 图文、长视频理解业务
支持图表、UI截图、扫描版说明书、PDF混合图片文档解析,提取图片内表格、文字、数据,输出摘要、分析结论。针对长视频,教学录屏、长时间会议录像,模型读取视频帧序列,输出带时间戳标记的事件摘要,快速定位会议关键决议、教学视频重点片段。对于企业内部培训视频、会议存档视频,不用人工逐帧观看,交给模型完成信息提炼。
3.4 高并发批量内容生成
依靠低延迟、有竞争力的推理成本,Qwen3.8‑Flash适合大批量普惠内容生成:商品文案、营销素材、社交平台文案批量产出。华北2地域开启批量推理后,能够进一步提升吞吐能力,支撑每秒上千次的调用峰值,适合内容工厂、电商平台等大批量内容生产业务。
3.5 开发者快速迁移集成
兼容OpenAI、Anthropic接口标准,现有基于对应接口开发的业务系统,只需要修改API Key、base_url、model名称参数,业务逻辑几乎不用改动,快速迁移到Qwen3.8‑Flash。搭配百炼平台可视化能力,普通开发者不需要深度底层开发,就可以快速搭建AI工作流原型。
四、模型调用定价,不同地域计费明细
下面为模型原始调用价格,不包含平台限时优惠活动,实际使用请前往百炼控制台查看最新权益。计费区分输入Token、输出Token,缓存命中之后输入Token成本大幅降低,对于长对话业务,开启上下文缓存可以显著节约开销。
华北2(北京)
|计费项|价格(元)|单位|
| ---- | ---- | ---- |
|输入|0.8|每百万tokens|
|输出|2.7|每百万tokens|
|输入(缓存命中)|0.1|每百万tokens|
|输入(Batch File)|0.4|每百万tokens|
|输出(Batch File)|1.35|每百万tokens|
|显式缓存创建|1.25|每百万tokens|
|显式缓存命中|0.1|每百万tokens|
|输入(Batch Chat)|0.8|每百万tokens|
|输出(Batch Chat)|2.7|每百万tokens|
新加坡
|计费项|价格(元)|单位|
| ---- | ---- | ---- |
|输入|1.094|每百万tokens|
|输出|3.427|每百万tokens|
|输入(缓存命中)|0.117|每百万tokens|
|显式缓存创建|1.458|每百万tokens|
|显式缓存命中|0.117|每百万tokens|
德国法兰克福、日本东京地域,输入0.8元/百万tokens,输出2.7元/百万tokens;缓存命中输入0.1元/百万tokens,显式缓存创建1.25元/百万tokens,显式缓存命中0.1元/百万tokens。
平台同时上线多项AI权益,开发者可以领取免费Token额度,包含智启AI普惠权益至高1亿+免费tokens,Token Plan订阅计划限时加量,夜间调用折扣等,降低前期业务验证成本。云侧配套算力也有对应优惠,方便开发者完成整套业务搭建。
五、百炼平台上手步骤,快速体验Qwen3.8‑Flash
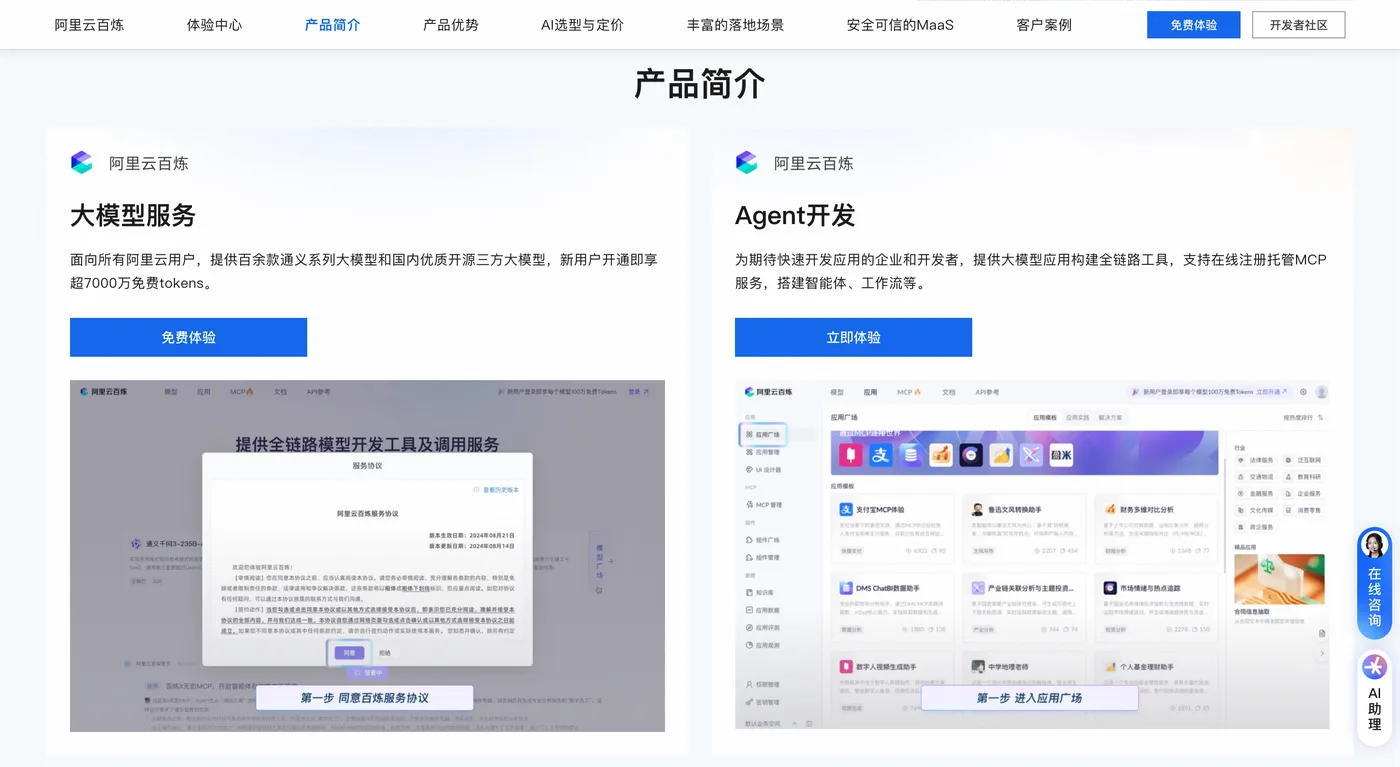
普通开发者可以通过百炼平台快速完成模型体验、应用创建,完整流程如下:
- 开通百炼服务:登录账号,进入百炼控制台,完成实名认证,绑定支付方式,开通对应服务权限。
- 进入模型体验中心:导航栏选择模型体验中心‑文本分类,检索模型ID
qwen3.8‑flash。 - 在线体验或者创建业务应用:在线体验页面可以直接输入文本、上传图片、上传视频,直观查看模型输出效果;如果需要API调用,点击创建应用,配置鉴权信息、回调参数,获取API Key。
- 可选配置上下文缓存:在支持缓存的地域,高级设置打开上下文缓存开关,长对话业务减少Token消耗。
- 监控调优:利用平台日志分析、用量统计功能,监控接口调用耗时、Token消耗、报错情况,根据业务调整输入长度,启用结构化输出等能力优化整体成本与性能。
六、API调用实战,多语言代码示例
Qwen3.8‑Flash提供两套调用体系:兼容OpenAI接口、原生DashScope接口,支持Python、Node.js、Java、cURL多种调用方式,同时支持文本对话、多模态图文请求,下面提供可直接调试的示例代码。
6.1 OpenAI兼容接口 Python示例
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)

messages = [{
   "role": "user", "content": "简单介绍Qwen3.8‑Flash模型的特点"}]
completion = client.chat.completions.create(
    model="qwen3.8‑flash",
    messages=messages,
    extra_body={
   "enable_thinking": True},
    stream=True
)

is_answering = False
print("\n" + "=" * 20 + "思考过程" + "=" * 20)
for chunk in completion:
    if not chunk.choices:
        continue
    delta = chunk.choices[0].delta
    if hasattr(delta, "reasoning_content") and delta.reasoning_content is not None:
        if not is_answering:
            print(delta.reasoning_content, end="", flush=True)
    if hasattr(delta, "content") and delta.content:
        if not is_answering:
            print("\n" + "=" * 20 + "完整回复" + "=" * 20)
            is_answering = True
        print(delta.content, end="", flush=True)
6.2 OpenAI兼容接口 cURL命令
curl -X POST https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions \
-H "Authorization: Bearer $DASHSCOPE_API_KEY" \
-H "Content-Type: application/json" \
-d '{
    "model": "qwen3.8‑flash",
    "messages": [{"role":"user","content":"请简单讲解MoE混合专家模型原理"}],
    "stream": true,
    "enable_thinking": true
}'
6.3 DashScope原生多模态Python调用(图文输入)
import os
import dashscope

dashscope.base_http_api_url = "https://dashscope.aliyuncs.com/api/v1"

messages = [
    {

        "role": "user",
        "content": [
            {
   "image": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh‑CN/20241022/emyrja/dog_and_girl.jpeg"},
            {
   "text": "描述这张图片里面的内容"}
        ]
    }
]

response = dashscope.MultiModalConversation.call(
    api_key=os.getenv('DASHSCOPE_API_KEY'),
    model='qwen3.8‑flash',
    messages=messages
)
print(response.output.choices[0].message.content[0]["text"])
6.4 DashScope多模态 cURL调用
curl -X POST https://dashscope.aliyuncs.com/api/v1/services/aigc/multimodal‑generation/generation \
-H "Authorization: Bearer $DASHSCOPE_API_KEY" \
-H 'Content‑Type: application/json' \
-d '{
    "model": "qwen3.8‑flash",
    "input":{
        "messages":[
            {
                "role": "user",
                "content": [
                    {"image":"https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh‑CN/20241022/emyrja/dog_and_girl.jpeg"},
                    {"text":"描述图片内容"}
                ]
            }
        ]
    }
}'
6.5 调用关键注意事项
- 多模态请求content字段必须使用数组格式,分别定义text、image、video对象;
- 使用Function Calling时,需要传入tools参数定义工具JSON Schema,配置tool_choice参数;
- 严格控制messages整体Token数量,不要超过模型输入上限;
- 全球化业务,指定对应地域endpoint,不同地域功能存在差异;
- 生产环境开发,需要捕获Token超限、模态不支持、地域能力不匹配等异常,增加重试、降级逻辑,保障业务稳定性。
七、总结
Qwen3.8‑Flash凭借MoE稀疏专家架构、百万级原生上下文窗口、文本图像视频多模态输入能力,补齐了企业大量真实业务场景的短板。面对完整代码仓库解析、超长文档处理、长视频分析、智能体自动化工作流、高并发内容生成等需求,在推理性能、响应延迟、调用成本三者之间取得优秀平衡。
开发者既可以在百炼平台快速完成原型验证,也可以通过OpenAI兼容接口快速迁移现有业务,降低AI系统落地门槛。企业选型时,建议拿自身真实业务数据做压测验证,记录任务成功率、响应耗时、Token消耗、调用成本,结合缓存、批量推理等平台能力,打磨出高性价比的AI业务方案。
