
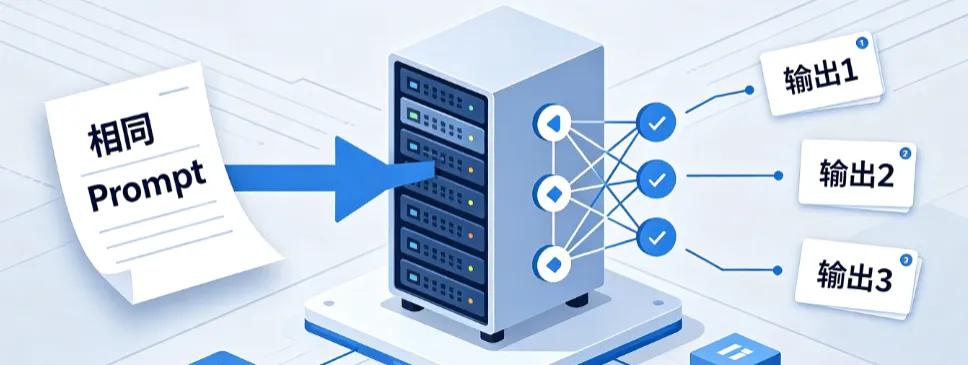

你是否遇到过这样诡异的现象: 已经把 LLM 的 temperature 设置为 0,关闭全部随机采样,使用贪心解码;输入完全一模一样的 Prompt,连续调用多次,大模型返回的结果却并不相同。
很多人第一反应,会怀疑贪心解码greedy decode存在 bug。但实际上解码逻辑本身没有问题。这种看似矛盾的非确定输出,根源藏在 GPU 硬件、云端调度、模型架构的底层细节里。很多做 Prompt 调优、大模型业务落地的工程师,也未必完全搞懂背后成因。本文结合线上实战经验,逐层拆解这个问题。
平时调试 Prompt 的时候,大多数人会有一个固有认知:只要把模型 temperature 温度参数设置为 0,开启纯贪心解码,模型每一步都会固定选择概率最高的 token,输出结果就应该完全固定,重复调用多少次都完全一致。
但真实线上业务调用,尤其是对接各大厂商云端 API 时,现实往往与之相悖:哪怕温度严格设置为 0,一模一样的 Prompt 连续发起多次请求,依旧会得到不一样的回答。
不少人第一反应会怀疑是decode解码机制出现问题。客观来说,差异现象确实体现在解码环节,但根本问题并不是贪心解码算法本身存在缺陷。真正造成结果随机波动的,是硬件底层算力误差、云端推理框架调度逻辑,再加上主流大模型架构带来的隐性扰动。
下面拆开讲清楚三层底层原因。

GPU 浮点计算天然误差:并行算力带来不可避免的数值偏移
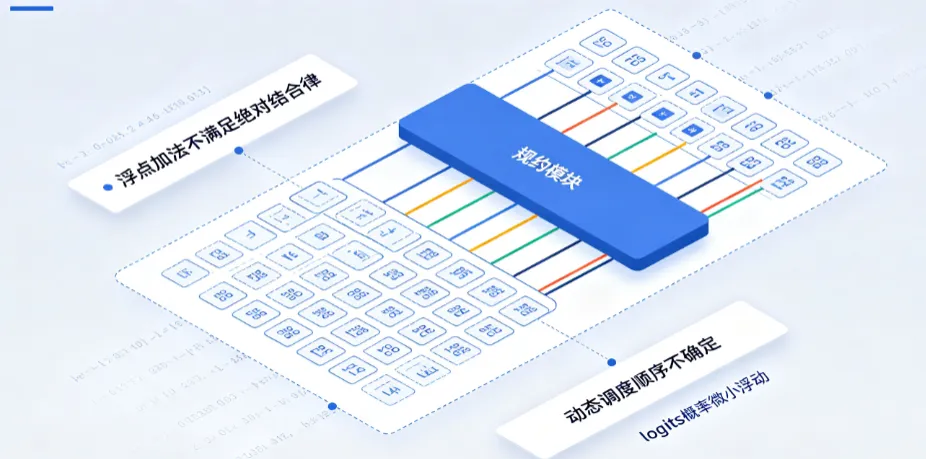
大模型推理依靠 GPU 完成海量矩阵乘法运算,为保障线上推理吞吐量,GPU 采用多线程并行计算模式。这里有一个容易被 Prompt 调参人员忽略的底层原理:浮点数加法不满足绝对结合律。
简单来说:理论上 (A + B) + C 和 A + (B + C) 的计算结果完全相等,但是在计算机浮点数精度截断规则下,最终计算出的数值会产生极其细微的偏差。
GPU 多线程的运算顺序由系统动态调度,每一次请求当中张量求和的顺序无法做到完全复刻,最终输出的 logits 概率分布,会产生十万分之一级别的微小浮动。
绝大多数场景下这种偏差可以直接忽略。但当排名第一、第二的 token 概率十分接近临界点时,这点微小误差就会直接调换二者的概率排名。大模型属于自回归逐词生成模式,第一个 token 发生选择偏差,后续整段文本就会沿着不同路径生成,也就是常说的蝴蝶效应,最终得到差异很大的回复。

云端 API 专属问题:动态批处理 padding 带来额外数值干扰
本地单卡运行模型很少遇到该现象,但调用公有云 API 时几乎很难规避。
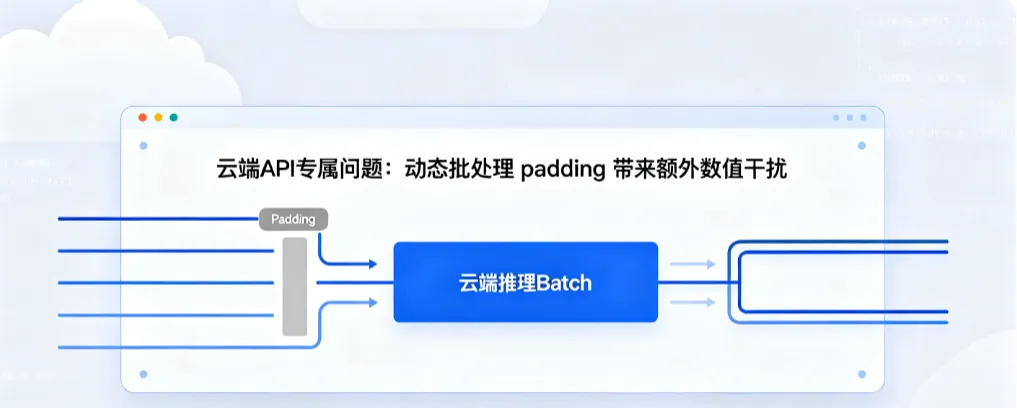
云厂商不会为每一个用户请求单独执行一次前向传播,算力成本会难以承受。为提升显卡利用率,后端推理服务普遍开启动态批处理,会把同一时刻大量不同用户的 Prompt 打包合并到同一个批次内统一计算。
各个用户输入 Prompt 长度各不相同,推理框架需要补充 padding 零值完成张量长度对齐。虽然注意力机制本身会屏蔽 padding 占位符的影响,但线上推理普遍使用 FP16、BF16 低精度张量,这些补位零值依旧会带来微弱的数值扰动,进一步放大原本的浮点误差,提升输出结果的不确定性。

主流模型架构加持:MoE 混合专家 + 投机解码放大不确定性
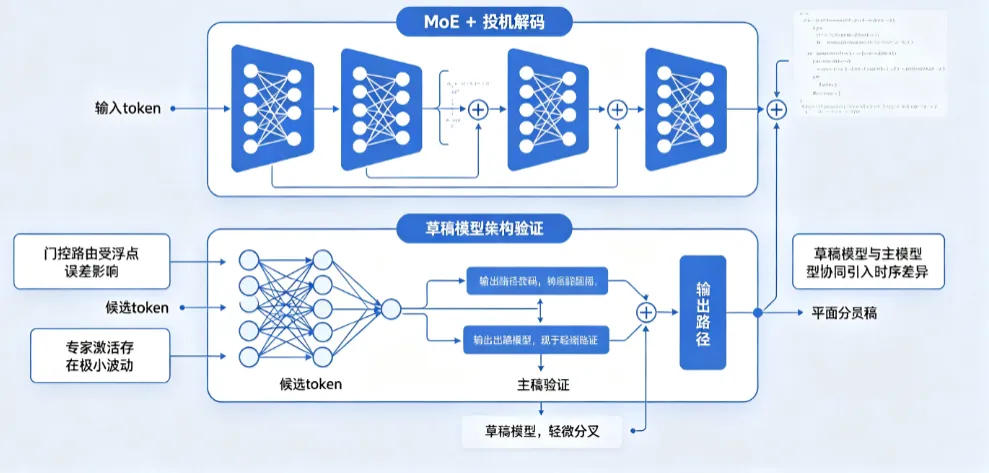
当前商用大模型很多不再是传统稠密架构,大量采用 MoE 混合专家结构;同时为了降低推理延迟,线上服务普遍开启投机解码加速,二者都会引入额外不确定因素。
- MoE 混合专家架构:推理过程依靠门控路由器挑选需要激活的专家层。路由计算会受上面提到的浮点误差影响,极小概率下会选择不同的专家模块,直接改变后续的计算与输出逻辑。
- 投机解码:这套加速方案先用小的草稿模型快速预生成 token,再交给主模型校验。大小模型协同推理的过程,会存在调度时序差异,引入不可控的微小变量。
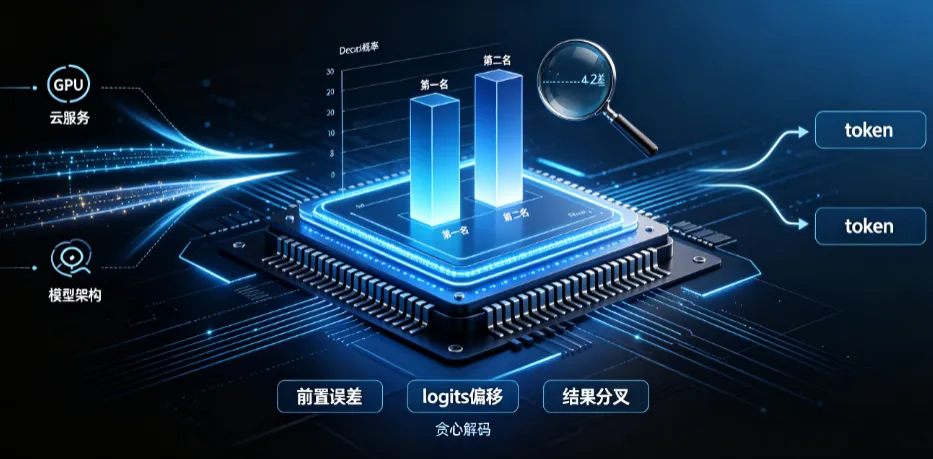

和 Decode 解码是什么关系?
- 理论层面:temperature=0对应标准贪心解码,解码规则本身不存在任何随机性,不会主动制造输出差异。
- 实际层面:硬件、调度、模型架构带来前置数值误差,输入到解码层的 logits 概率分布已经发生改变。解码只是严格按照规则挑选概率最高的 token,因此会选出不一样的结果。
总结:现象表现在解码阶段,但根源不在解码算法。
业务端落地解决方案(高稳定场景)
针对结构化抽取、代码生成、标准化文案输出这类不能容忍随机波动的业务场景,仅仅设置temperature=0远远不够。线上追求输出确定性,建议组合下面三种方案:
- 传入固定全局随机种子seed 调用接口时传入固定 seed,可以锁定后端大部分调度随机变量,有效降低输出波动。缺点:更换硬件显卡、模型版本升级之后,确定性会有所下降。
- Prompt 增加 Few‑Shot 强示例约束 不要完全依赖模型自主判断,在提示词中提供多组标准输入输出样例,人为拉大目标 token 和备选 token 之间的概率差距,让微小浮点误差无法撼动 top1 的分词选择。
- 强制固定输出格式 优先使用接口提供的 JSON 强制输出模式;私有化本地部署场景,可以自定义 logits 处理器,从词表层面屏蔽不符合业务规则的 token,彻底锁死输出范围。

底层算子真实复现案例
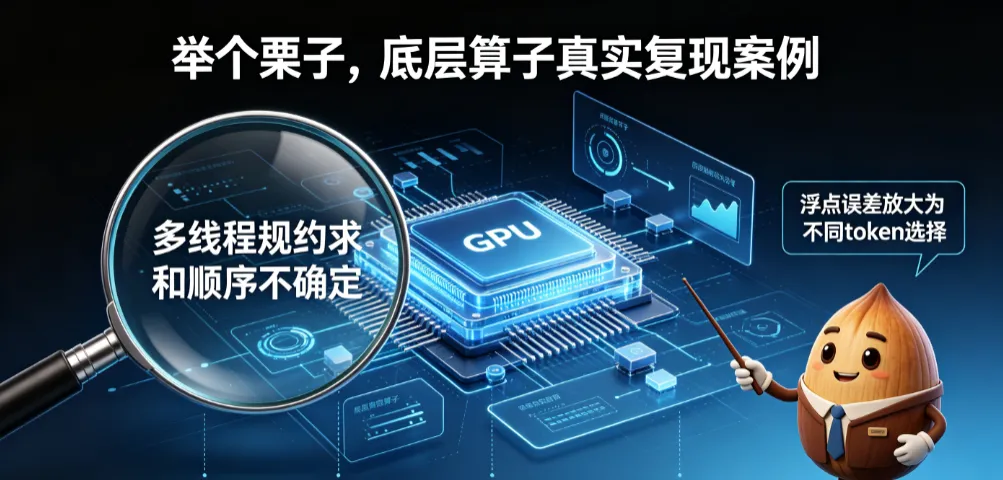
该现象可以在开源推理框架 PowerInfer 的早期版本复现:多线程并行做向量规约求和时,线程获取任务块、加锁回写结果的顺序是不确定的。IEEE‑754 浮点数加法不满足结合律,不同的求和顺序带来 logits 微小偏差,自回归生成会持续放大偏差,最终输出完全不同。
实验中把随机自旋锁修改为固定顺序排队锁,规约求和顺序固定之后,算子本身输出可以做到完全确定。
说明:该现象来自 commit id:
2217e7f的旧版本,新版本框架已经做相关优化;另外 GPU offload 链路依旧可能存在同类浮点扰动。
static void ggml_compute_forward_mul_mat_axpy_head( const struct ggml_compute_params * params, const struct ggml_tensor * src0, const struct ggml_tensor * src1, struct ggml_tensor * dst) { int64_t t0 = ggml_perf_time_us(); UNUSED(t0); GGML_TENSOR_BINARY_OP_LOCALS; const enum ggml_type type = src0->type; enum ggml_type const vec_dot_type = type_traits[type].vec_dot_type; ggml_from_float_t const from_float_to_vec_dot = type_traits[vec_dot_type].from_float; GGML_ASSERT(nb00 == ggml_type_size(type)); GGML_ASSERT(nb10 == sizeof(float)); GGML_ASSERT(nb0 == sizeof(float)); GGML_ASSERT(nb0 <= nb1); GGML_ASSERT(nb1 <= nb2); GGML_ASSERT(nb2 <= nb3); if (params->type == GGML_TASK_INIT) { ggml_set_zero(dst); if (src1->type != vec_dot_type) { char * wdata = params->wdata; const size_t row_size = ne10*ggml_type_size(vec_dot_type)/ggml_blck_size(vec_dot_type); for (int64_t i13 = 0; i13 < ne13; ++i13) { for (int64_t i12 = 0; i12 < ne12; ++i12) { for (int64_t i11 = 0; i11 < ne11; ++i11) { from_float_to_vec_dot((float *)((char *) src1->data + i13*nb13 + i12*nb12 + i11*nb11), (void *) wdata, ne10); wdata += row_size; } } } } atomic_store(params->aic, 0); return; } if (params->type == GGML_TASK_FINALIZE) { return; } const ggml_fp16_t* wdata = (src1->type == vec_dot_type) ? src1->data : params->wdata; struct ggml_tensor *src2 = dst->src[2]; int chunk = ne00 / 32; const int64_t dr = (src2->ne[0] + chunk - 1)/chunk; const int nr = ggml_nrows(src0); float* vec = (float *)_malloca(ne00 * 4 * sizeof(float)); float vec[ne00*4]; void *vy = vec; memset(vy, 0, ne00*4); char* src0_row = (char *) src0->data; while (true) { const int ir0 = atomic_fetch_add(params->aic, dr); for (int64_t ir1 = ir0; ir1 < ir0+dr; ir1++) { if (ir1 >= nr) break; ggml_axpy_avx_f16(ne00, (ggml_fp16_t *)(src0_row+nb01*ir1), (ggml_fp16_t *)vy, vy, wdata[ir1]); } if (ir0 + dr >= nr) break; } // 获取锁 while (atomic_flag_test_and_set(&g_axpy_head_lock)) { // 如果锁已经被占用,则等待 } float *res = (float *)(dst->data); float *tmp = (float *)vy; int i; //计算剩余的元素个数 int remainder = ne00 % 8; // 使用AVX指令进行向量化运算 for (i = 0; i < ne00 - remainder; i += 8) { __m256 res_vec = _mm256_loadu_ps(res + i); __m256 tmp_vec = _mm256_loadu_ps(tmp + i); __m256 result = _mm256_add_ps(res_vec, tmp_vec); _mm256_storeu_ps(res + i, result); } // 处理剩余的元素 for (i = ne00 - remainder; i < ne00; i++) { res[i] += tmp[i]; } for (i = 0; i < ne00; i++) { res[i] += tmp[i]; } atomic_flag_clear(&g_axpy_head_lock); _freea(vec); }
