如果你用 Mac 跑过本地大模型,下面这个场景你一定不陌生:问它一个稍微复杂的问题,然后盯着屏幕,看字一个一个往外蹦。蹦到第十个字的时候,你已经想切回云端 API 了。风扇在狂转,手边的 M 芯片卖力工作,可它就是不吐字。几万块的机器,跑起来像台老式打字机。
问题不在你的 Mac,而在"打字方式"。本地大模型默认是一个字一个字"现想现说"的,这个机制叫自回归生成。更扎心的是,它每蹦一个字,都要把整个模型的权重从显存里重新读一遍——GPU 核心大部分时间都在等数据,算力利用率往往只有两三成。你买的不是算力,是带宽。
那有没有办法让它"一次打一串字"?有。这个技术叫 MTP(Multi-Token Prediction,多令牌预测),是这两年本地模型圈特别值得开的一个加速开关,实测生成速度能提升 2 倍左右,而且不用换显卡、不用换机器。
一、MTP 的原理:从"一个字一个字敲"到"先写草稿再验收"
传统模型一次只预测下一个词(token),所以生成是严格串行的:想好第一个,才能想第二个。
MTP 的思路是:在训练时就给模型额外装上几个轻量的"预判头"(MTP head),让模型一次前向传播能同时预测出接下来好几个 token。预测完,主模型再对这批草稿做一次"验收":猜对的,整排直接收下,还能顺手白赚一个 token;猜错的,从错的地方重新来。
用大白话说:以前是打字员一个字一个字敲给你看;现在是打字员先把一整段草稿写出来,校对员一次性验收,通过的部分全部生效。速度自然就上去了。
这项技术不是实验室概念。DeepSeek-V3 最早把 MTP 写进训练目标,Qwen 系列模型跟进内置了 MTP head,2026 年谷歌发布 Gemma 4 时,更是把 MTP 草稿模型(drafter)作为官方组件随模型一起开源。MTP 已经从论文走向了"人人都能开"的日常配置。
二、2 倍提速,有据可依
说"翻倍"不是拍脑袋,几组公开数据可以佐证:
- 同一张显卡、同一个模型,社区实测开启后生成速度从 38 tokens/s 提到 65 tokens/s,接近翻倍;
- 谷歌官方数据称,Gemma 4 的 MTP 草稿模型最高可带来 3 倍加速,且输出质量不降;
- oMLX 官方社区基准里,Qwen3.6-35B 的 MTP 版在 M5 Max 上单路 107 tokens/s,4 路并发直接到 237 tokens/s,是单路的 2.2 倍;
- 有博主实测 oMLX 开启 DFlash 加 MTP 后,首字响应从 30-90 秒降到 1-5 秒。
当然,收益大小和模型、量化方式、内存带宽都有关系,不同机型体感会有差异。但"约 2 倍"是比较普遍的结果,值得一试。
三、两类模型,两种开法
这是很多人最容易搞混的地方,划重点:
第一类:新出的、没压缩的模型。 完整精度(比如 bf16)的新模型,很多自带 MTP head,直接开启原生 MTP 就行,不需要额外下载任何组件。比如 Qwen3.8 系列,直接加载对应的 MTP 版模型(名字带 -mtp 后缀)即可生效。
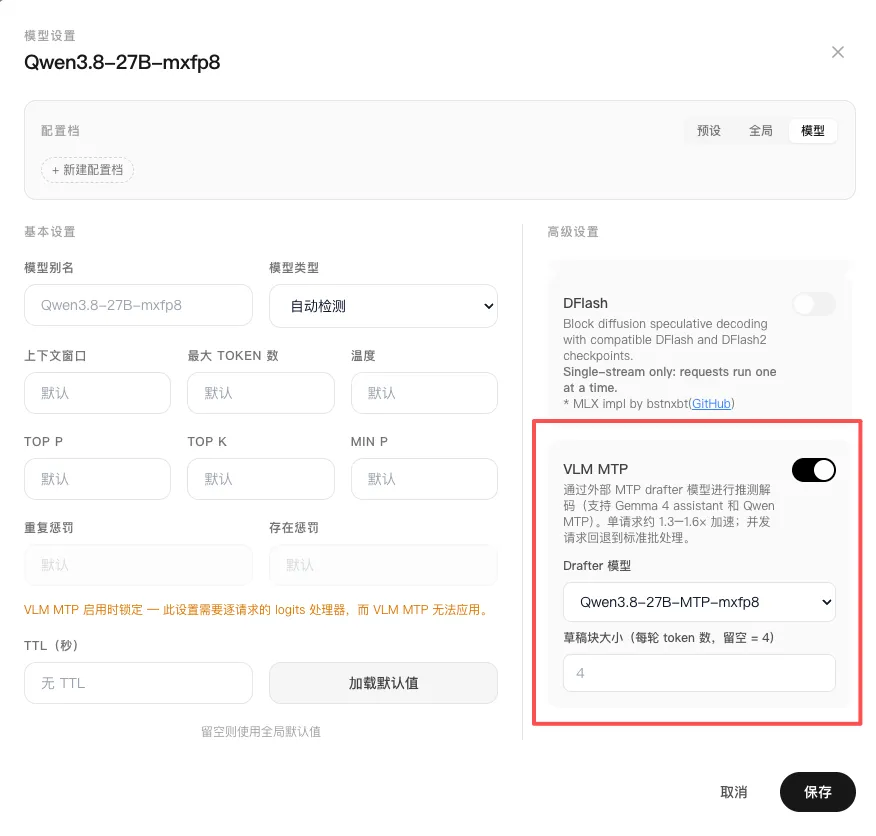
第二类:量化压缩后的模型。 4bit、6bit、8bit 这些量化版本为了塞进小内存,会把 MTP 预判头一起压缩,预判精度打折扣。这时候更聪明的做法是:外挂一个独立的、很小的 MTP 草稿模型(也叫 assistant / drafter)负责"猜",主模型只负责"验收"。草稿模型没被量化伤到,猜得准,验收通过率高,加速效果反而更好。比如 Gemma 4 12B,加载谷歌官方的 assistant 草稿模型(google/gemma-4-12B-it-assistant)就能跑起来。
| 模型类型 | 开法 | 特点 |
| 未量化新模型(bf16 等) | 直接开启原生 MTP | 无需额外下载,一键生效 |
| 量化模型(4bit/6bit/8bit) | 外挂小 MTP 草稿模型 | 草稿模型普遍很小,效果更稳 |
仙踪问道在实测中发现,量化模型外挂小草稿模型的收益往往比想象中大:很多人以为量化后 MTP 就废了,实际上把"猜"的活儿交给一个没被压缩的小模型,验收通过率能回到 60% 以上,速度提升比硬开原生 MTP 更明显。这也是为什么 Gemma 4 的官方方案直接就是"主模型 + assistant"的组合。
四、oMLX 里怎么开?三步搞定
oMLX 是专为 Apple Silicon 打造的本地大模型推理服务器,基于苹果自家的 MLX 框架,菜单栏管理加网页面板,GitHub 上已有 2 万多星。它把 MTP 做成了开箱即用的功能,操作就三步:
第 1 步:安装。 去 GitHub(jundot/omlx)Releases 下载 .dmg,拖进"应用程序"就行(也可以 brew tap jundot/omlx 然后 brew install omlx)。要求 M1 及以上芯片、macOS 15+,16GB 内存起步,64GB 以上跑大模型更舒服。
第 2 步:下载 MTP 版模型。 首次启动的欢迎向导会让你选模型目录。选模型时认准名字带 -mtp 的版本(比如 Qwen3.8-27B-mtp),或者"主模型 + assistant 草稿模型"的组合。
第 3 步:打开开关。 在模型设置里开启 Native MTP。如果模型声明了 MTP 层但权重缺失,oMLX 会提示"converted weights are missing",说明这个版本没带 MTP 权重,换个 MTP 版即可;外挂草稿模型的场景,在设置里指定对应的 drafter 模型就行。
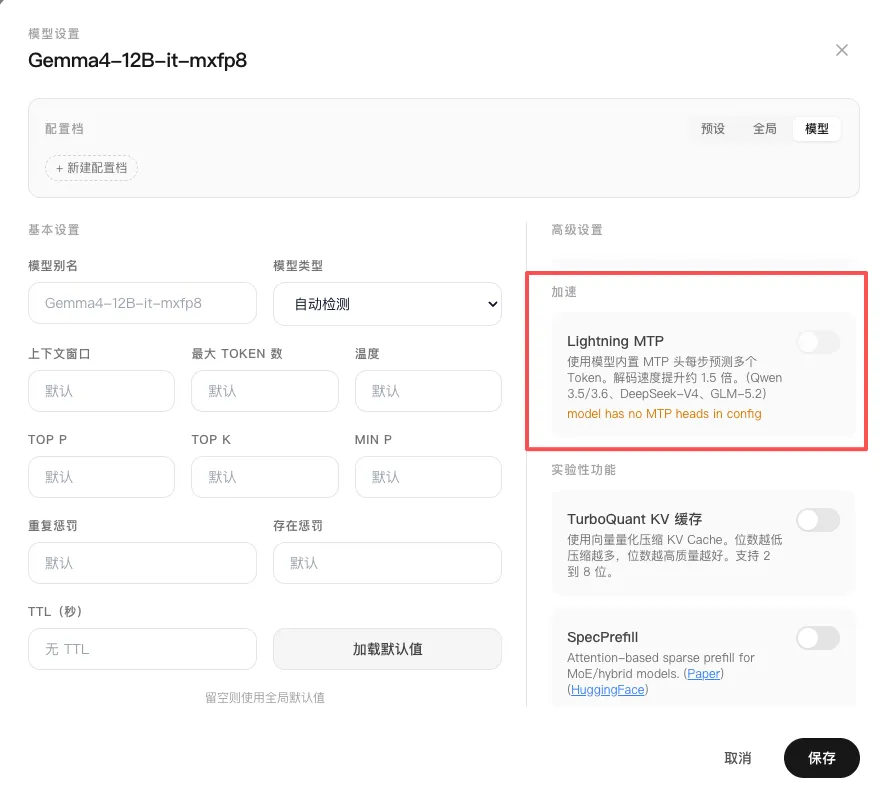
也可以通过oMLX界面进行操作, 首先打开模型管理器中的模型设置,
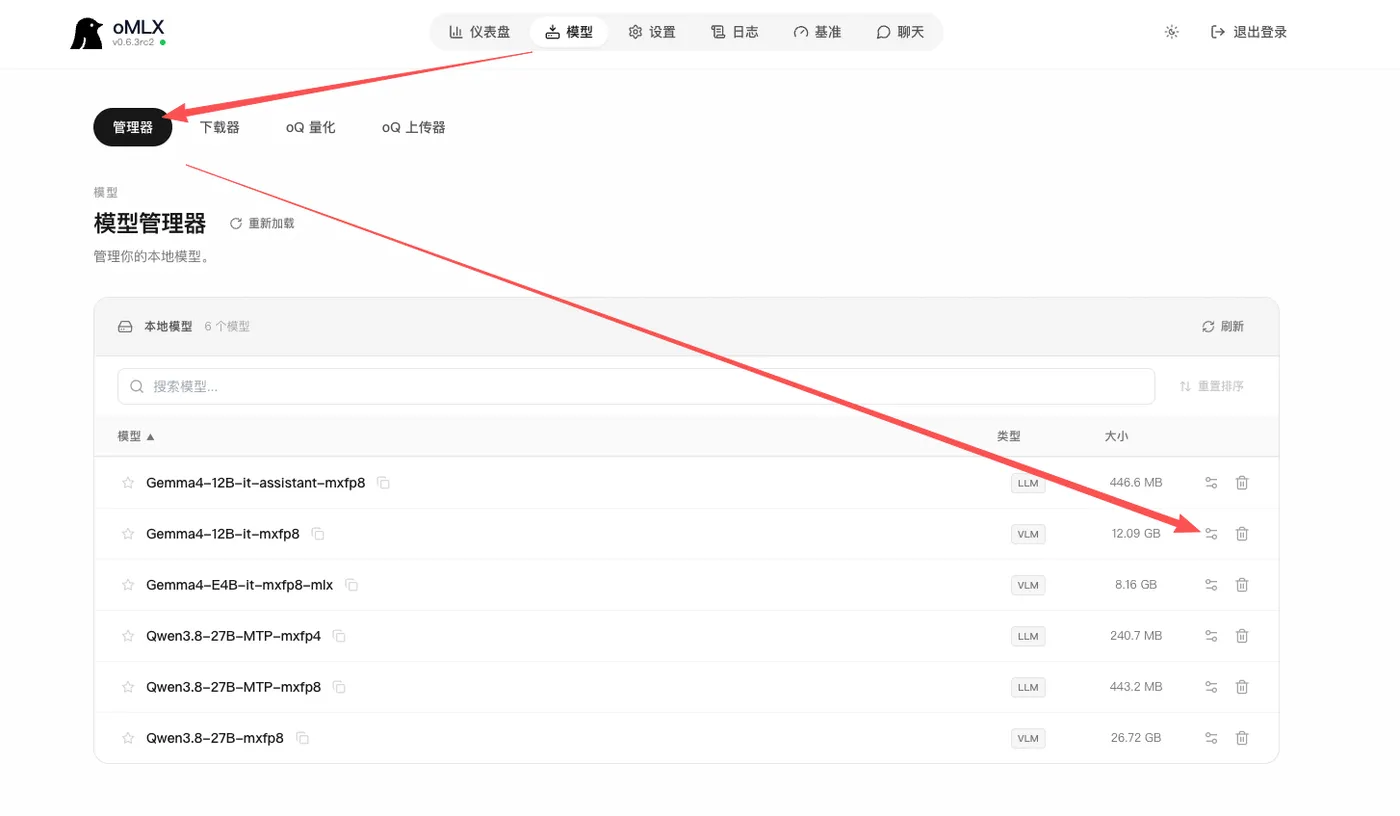
如果未压缩模型内置MTP支持,可以直接打开MTP加速。
如果模型被压缩,也可以使用vlm mtp的加速模型,需要下载设置模型对应的Drafter模型即可。
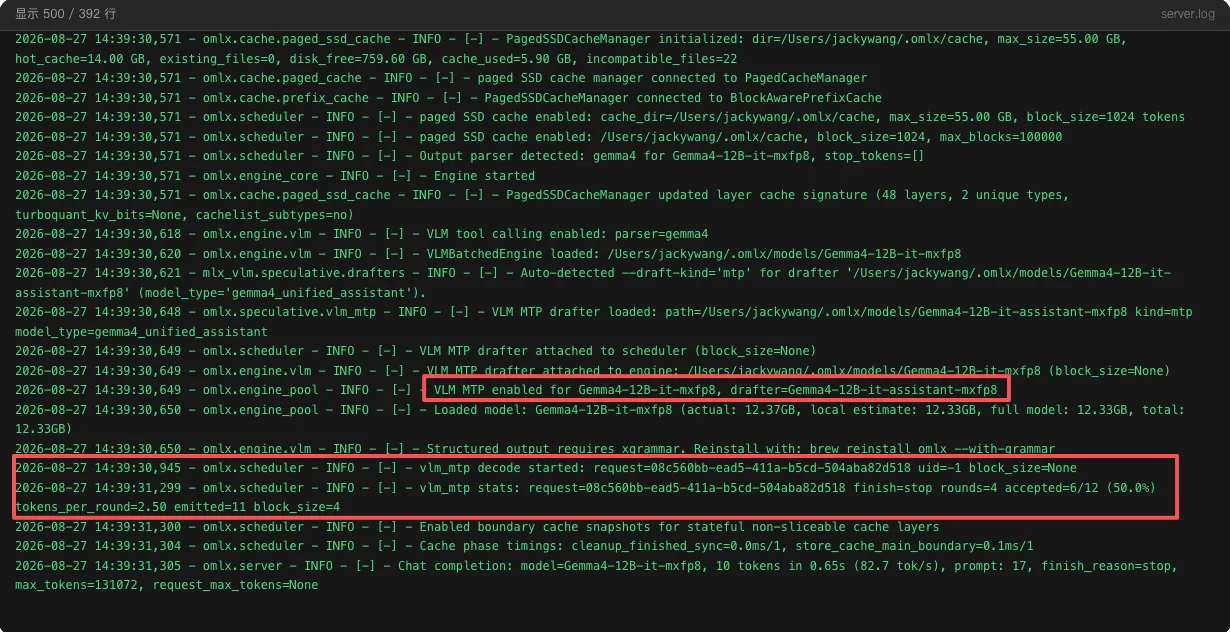
怎么确认真的生效了?仙踪问道提醒:别看界面,看日志。打开 ~/.omlx/logs/server.log,看到 "MTP path activated ... model has mtp_forward" 这行,就是 MTP 真正跑起来了;再瞄一眼面板里的 tok/s,数字会告诉你一切。
也可以通过omlx的日志模块进行查看确认,看到MTP enabled, 以及mtp stats就可以明确开启成功。
几个调优小抄,按需取用:
- 16GB 内存的机器,优先 MTP 而非 DFlash 推测解码——MTP 草稿模型只有约 256MB,DFlash 的草稿要 1GB 左右,差这 800MB 就是能不能跑的差别;
- 超长的单条文本生成,可以关掉 MTP,避免草稿被长上下文拖累;
- 多路并发、批量处理场景,MTP 的吞吐提升更明显,有实测达到 4 倍上下;
- 内存带宽吃紧的 base 版芯片,把 KV 缓存开到 q4,能明显缓解瓶颈。
五、MTP 不是万能的:场景和模型决定提速上限
不过话说回来,MTP 这个加速也不是对谁都一样快。它的实际收益,主要卡在两个变量上。
第一个变量是输出场景。MTP 吃的是"草稿猜得准不准"——翻译、摘要、格式化这类规律性强的输出,下一步写什么几乎能猜到,草稿命中率高,提速就明显;而开放式创作、头脑风暴、代码生成这类发散性强的输出,模型自己也拿不准下一句,草稿频繁被驳回,提速就打了折扣。另外,超长文本生成和多路并发场景下,MTP 的收益会放大;短问答、单轮小请求,体感就不那么强烈。
第二个变量是模型本身的预测准确度。MTP 提速的天花板,取决于主模型和 MTP 头本身"猜"得准不准。大模型、校准好的模型,预判命中率自然高;而小模型、深量化的模型,本身预测能力就弱,草稿验收通过率上不去,加速效果也会缩水。
所以更准确的说法是:综合场景和模型来看,MTP 的实际提速通常在 1.3 倍到 3 倍之间,2 倍左右是常见的中间值。如果你跑完发现提升没那么夸张,先别急着怀疑开关没开对——大概率是你的输出场景偏发散,或者模型本身的预测能力决定了上限。这也是为什么实测党永远建议"开完看 tok/s,用自己真实的任务测"。
说到底,MTP 不挑模型档次,挑的是"开没开"。新模型直接开原生 MTP,量化模型外挂小草稿模型,两条路都能拿到接近翻倍的生成速度。你的 Mac 其实没你想的那么慢,只是那个开关,一直没被打开。
如果觉得有用,欢迎关注我——这个账号专注 Mac 本地 AI 的实用玩法,不写水文,只讲能落地的方法。你的 Mac 是什么配置?开了 MTP 之后速度提升了多少?欢迎在评论区聊聊,一起交流调优心得。