Kimi-K3 是 Kimi 迄今能力最强的旗舰模型,拥有 2.8 万亿参数,基于 KDA 混合线性注意力机制(Kimi Delta Attention)和注意力残差(Attention Residuals)技术构建,原生支持视觉理解,并拥有 100 万 token 上下文窗口。它是全球首个开源的 3 万亿级别模型,面向长程编程、知识工作和推理等前沿智能场景而设计。以下是对阿里云kimi-k3模型的全面、专业且结构化介绍。
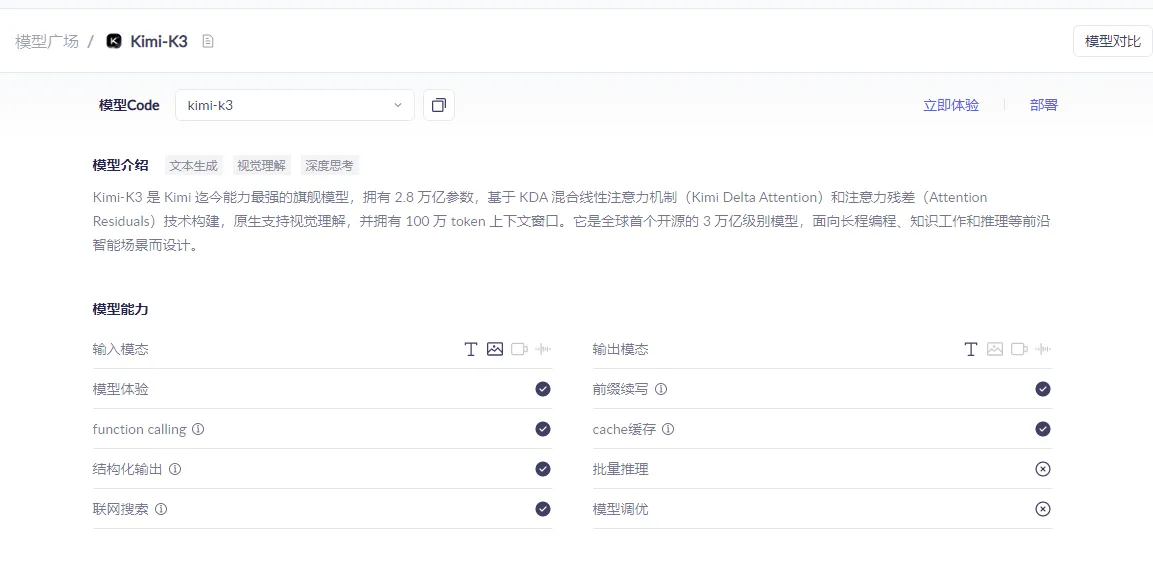
一、阿里云 kimi-k3 模型介绍
kimi-k3 是由月之暗面(Moonshot AI)研发、通过阿里云百炼平台提供推理服务的旗舰级大语言模型。其核心特征如下:
- 超大规模参数:拥有 2.8 万亿参数,是全球首个开源的 3 万亿级别模型;
- 先进架构:基于 KDA 混合线性注意力机制(Kimi Delta Attention)和 注意力残差(Attention Residuals)技术构建;
- 原生多模态支持:支持 文本与图像输入(暂不支持视频输入),输出为纯文本;
- 百万级上下文窗口:最大上下文长度、最大输入长度、最大输出长度及最大思维链长度均为 1,048,576 tokens(即 100 万 tokens);
- 仅思考模式:始终开启深度思考(
enable_thinking默认为true且不可关闭),采用保留式思考机制,适用于复杂推理任务; - 多地域部署:已在 华北2(北京)、新加坡、日本(东京)、德国(法兰克福)、美国(弗吉尼亚) 五个地域上线。
二、阿里云 kimi-k3 模型能力介绍
1. 华北2(北京)
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Image Text | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 支持 |
| 前缀续写 | 支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
2. 新加坡
部署范围:国际
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Image Text | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 支持 |
| 前缀续写 | 不支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
3. 德国(法兰克福)
部署范围:全球
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Image Text | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 支持 |
| 前缀续写 | 不支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
4. 日本(东京)
部署范围:全球
| 能力项 | 支持情况 | 能力项 | 支持情况 |
|---|---|---|---|
| 输入模态 | Image Text | 输出模态 | Text |
| 模型体验 | 支持 | Function Calling | 支持 |
| 结构化输出 | 支持 | 联网搜索 | 支持 |
| 前缀续写 | 不支持 | 上下文缓存 | 支持 |
| 批量推理 | 不支持 | 模型调优 | 不支持 |
5. 独有特性:动态加载工具(Dynamic Loading Tools, DLT)
kimi-k3 是目前唯一支持动态加载工具的模型。该机制允许在对话过程中按需注入工具声明,而非一次性在顶层 tools 字段挂载所有工具,有效解决以下问题:
- 工具定义膨胀导致的 Token 消耗过高;
- 模型因工具过多而选错工具的风险。
典型实现流程:
- 初始请求仅声明一个
search_tools工具; - 模型调用
search_tools获取所需工具列表; - 应用将匹配的工具声明以
system消息形式动态插入messages; - 模型后续可直接调用新加载的工具。
3. 默认推理参数
- temperature: 1.0
- top_p: 0.95
- presence_penalty: 0.0
- enable_thinking: true(强制开启,不可关闭)
- thinking_budget: 不支持(无法限制思考长度)
6. 上下文限制
| 参数 | 值 | 参数 | 值 |
|---|---|---|---|
| 最大输入长度 | 1048576 | 最大输出长度 | 1048576 |
| 上下文长度 | 1048576 | 最大输入长度(思考模式下) | 1048576 |
| 最大输出长度(思考模式下) | 1048576 | 最大思维链长度 | 1048576 |
三、阿里云 kimi-k3 模型适用场景解析
基于其长上下文、视觉理解、深度思考与动态工具能力,kimi-k3 主要适用于以下高阶场景:
长程编程与代码智能体
- 处理大型代码仓库(如 GitHub 项目)的跨文件理解与重构;
- 构建具备多步规划与工具调用能力的 AI Agent。
超长文档与多模态内容分析
- 一次性解析整本技术手册、法律合同或财报;
- 结合图像输入,分析图表、截图或图文混排文档(如 PDF 报告)。
复杂逻辑推理与数学建模
- 通过始终开启的深度思考模式,执行多步推导、算法设计或科研辅助。
高精度知识工作自动化
- 自动生成专利、学术论文初稿或技术方案;
- 在金融、医疗等专业领域提供可信问答。
不适用场景:由于不支持批量推理与模型调优,不适合大规模离线处理或定制化训练任务。
四、阿里云 kimi-k3 模型定价
下面仅展示模型调用原价,不包含限时优惠等活动信息,请前往阿里云百炼平台:https://www.aliyun.com/product/bailian 查看活动优惠,目前登录可自动获得100万Tokens免费试用额度,下图所示:
kimi-k3 按 输入/输出 Token 数量 分别计费,思维链内容按输出 Token 计费。以下是各区域原价(单位:元/百万 tokens):
1. 华北2(北京)
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 20 | 每百万tokens |
| 输出 | 100 | 每百万tokens |
| 输入(缓存命中) | 2 | 每百万tokens |
2. 新加坡
部署范围:国际
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 21.875 | 每百万tokens |
| 输出 | 109.376 | 每百万tokens |
| 输入(缓存命中) | 2.188 | 每百万tokens |
3. 德国(法兰克福)
部署范围:全球
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 20 | 每百万tokens |
| 输出 | 100 | 每百万tokens |
| 输入(缓存命中) | 2 | 每百万tokens |
4. 日本(东京)
部署范围:全球
| 计费项 | 价格(元) | 单位 |
|---|---|---|
| 输入 | 20 | 每百万tokens |
| 输出 | 100 | 每百万tokens |
| 输入(缓存命中) | 2 | 每百万tokens |
五、阿里云 kimi-k3 使用 API 参考
kimi-k3 通过阿里云百炼平台提供服务,兼容 OpenAI、DashScope 协议。
1. OpenAI兼容
from openai import OpenAI
import os
client = OpenAI(
    # 如果没有配置环境变量,请用阿里云百炼API Key替换:api_key="sk-xxx"
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://llm-fltqd30d7x9rrh4v.cn-beijing.maas.aliyuncs.com/compatible-mode/v1",
)
messages = [{"role": "user", "content": "你是谁"}]
completion = client.chat.completions.create(
    model="kimi-k3",
    messages=messages,
    stream=True
)
is_answering = False  # 是否进入回复阶段
print("\n" + "=" * 20 + "思考过程" + "=" * 20)
for chunk in completion:
    if chunk.choices:
        delta = chunk.choices[0].delta
        # 只收集思考内容
        if hasattr(delta, "reasoning_content") and delta.reasoning_content is not None:
            if not is_answering:
                print(delta.reasoning_content, end="", flush=True)
        # 收到content,开始进行回复
        if hasattr(delta, "content") and delta.content:
            if not is_answering:
                print("\n" + "=" * 20 + "完整回复" + "=" * 20)
                is_answering = True
            print(delta.content, end="", flush=True)
2. DashScope
import os
import dashscope
dashscope.base_http_api_url = 'https://llm-fltqd30d7x9rrh4v.cn-beijing.maas.aliyuncs.comapi/v1'
messages = [
{
    "role": "user",
    "content": [
    {"text": "你是谁"}]
}]
response = dashscope.MultiModalConversation.call(
    #若没有配置环境变量, 请用百炼API Key将下行替换为: api_key ="sk-xxx"
    api_key = os.getenv('DASHSCOPE_API_KEY'),
    model = 'kimi-k3',
    messages = messages
)
print(response.output.choices[0].message.content[0]["text"])
3. 关键注意事项
- 接口限制:kimi-k3 暂不支持 OpenAI Responses 接口,请使用 Chat Completions 接口;
- 多模态输入:图片通过
image_url类型传入(OpenAI 协议)或调用/multimodal-generation/generation端点(DashScope 协议); - 认证方式:需配置百炼 API Key 至环境变量
DASHSCOPE_API_KEY; - 思考模式:作为仅思考模型,无法关闭思考过程,且不支持
thinking_budget参数。
2026年阿里云AI产品与云产品优惠权益参考:
AI 产品权益主要包括智启 AI 普惠权益,至高享 1亿+免费 tokens,加速 Al 应用落地;Token Plan 模型订阅计划,Qwen3.8-Max 首发尝鲜,限时加量 10 倍,夜间低至2折;千问办公,限时限量积分加倍,你的AI工作搭子,覆盖日常办公高频场景;万小智 AI 建站低至 15元/月,送.CN域名,送备案服务码;Night Plan 支持 Qwen 3.8-Max,夜间 5 折,Qwen/Meoo/TokenPlan 客户专享。而云产品权益主要有轻量应用服务器限时抢购2核2G38元/年;经济型e实例3.9折,通用算力型u2i实例3折,九代c9i、g9i、r9i等实例1年付6.4折起等优惠权益。详情可通过阿里云权益中心了解:https://www.aliyun.com/benefit
小结:kimi-k3作为月之暗面研发、依托阿里云百炼平台落地的旗舰级大模型,凭借2.8万亿超大规模参数、KDA混合线性注意力的独特架构,搭配全链路百万级超长上下文窗口与强制开启的深度思考机制,成为当前复杂推理类高阶场景的核心选型。它独有的动态加载工具DLT机制,彻底解决了传统智能体开发中工具声明冗余耗Token、工具调用错选的行业痛点,搭配全球五地域的灵活部署方案,开发者可根据前缀续写等专属能力需求选择北京节点接入,启用上下文缓存后还可将输入成本大幅降低90%,完美适配长程代码智能体、超长图文混排文档分析等生产级需求,为复杂高阶AI应用落地提供了兼具性能与效率的全新大模型底座。